Гонка передовых моделей в Китае вступает в эру триллионов параметров. Модель Qwen3.8-Max от Alibaba уже достигла 2,4 триллиона параметров, а...
Гонка передовых моделей Китая вступает в эру триллионов параметров.
Модель Qwen3.8-Max от Alibaba уже достигла 2,4 триллиона параметров, а Kimi K3 от Moonshot AI увеличила публично раскрытый масштаб до 2,8 триллиона параметров.
ByteDance, возможно, готовится к следующему скачку.
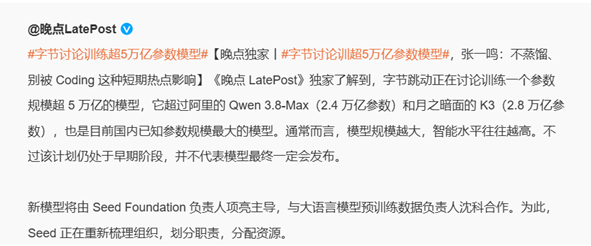
AIBase со ссылкой на LatePost сообщает, что ByteDance по состоянию на 7 августа 2026 года обсуждает обучение базовой модели с более чем 5 триллионами параметров. Согласно этому сообщению, проект всё ещё находится на ранней стадии, и нет гарантий, что итоговая модель будет выпущена.
Только по масштабу этот проект станет одним из крупнейших проектов ИИ-моделей в публичных сообщениях Китая.
Однако в тот же день появилось ещё одно важное обновление.
Вечером 7 августа Reuters со ссылкой на британскую Financial Times и осведомлённые источники сообщило, что ByteDance обучает модель с до 10 триллионов параметров, и модель уже находится на этапе предобучения. На тот момент ByteDance не дала публичных комментариев по этому сообщению.
Эти два сообщения не обязательно противоречат друг другу. Проект, изначально обсуждавшийся как «более 5 триллионов», в итоге может быть нацелен на более крупную конфигурацию. Но поскольку ByteDance официально не раскрыла архитектуру модели или количество параметров, все цифры в этой статье следует рассматривать как планы из сообщений, а не как подтверждённые характеристики модели.
В оригинальном репортаже LatePost говорится, что ByteDance обсуждает модель с более чем 5 триллионами параметров.
Это значительно превысит масштабы, уже раскрытые несколькими передовыми китайскими моделями.
| Модель | Публично раскрытые суммарные параметры | Статус |
|---|---|---|
| Qwen3.8-Max | 2,4 триллиона | Выпущена Alibaba |
| Kimi K3 | 2,8 триллиона | Выпущена Moonshot AI |
| Сообщаемая модель ByteDance | Более 5 триллионов | Сообщаемый план |
| Последующие данные FT/Reuters | До 10 триллионов | Сообщается, официально не подтверждено |
Moonshot AI официально описывает Kimi K3 как модель смеси экспертов с 2,8 триллиона параметров, с активацией 104 миллиардов параметров на каждый токен.
Reuters сообщало 3 августа, что Qwen3.8-Max от Alibaba содержит 2,4 триллиона суммарных параметров.
Если ByteDance в итоге обучит и развернёт модель с 5–10 триллионами параметров, это будет означать значительное увеличение общего масштаба моделей.
Но это не автоматически означает, что возможности модели будут в два-три раза выше.
Источники AIBase описывают модель с 5 триллионами параметров как находящуюся в том же классе величин, что и ведущие американские передовые системы, такие как GPT-5.6 или новейшие высококлассные модели Anthropic.
Это сравнение требует важной оговорки.
OpenAI и Anthropic не раскрывают публично точное количество параметров GPT-5.6, Claude Fable 5 или Claude Mythos 5.
Reuters в своём сообщении от 7 августа также высказала эту точку зрения: прямое сравнение масштабов с ведущими американскими системами затруднено, поскольку эти лаборатории не публикуют количество параметров своих моделей.
Количество параметров — лишь одно из измерений возможностей модели.
Производительность также зависит от:
Это особенно важно для моделей смеси экспертов.
Разрежённая модель MoE может содержать триллионы суммарных параметров, но активировать лишь небольшую их часть на каждый токен.
Kimi K3 — хороший пример.
В её официальных спецификациях указано:
Таким образом, общее количество весов — не то же самое, что объём вычислений, используемых на каждом шаге инференса.
ByteDance публично не раскрывала, использует ли сообщаемая модель аналогичную разрежённую архитектуру, а также сколько параметров будет активироваться на каждый токен.
В оригинальном репортаже в качестве примера масштаба использовались GPU NVIDIA H100.
Согласно оценкам, для обучения модели с 5 триллионами параметров потребуется примерно:
Оба сценария дают примерно одинаковый порядок величины суммарного времени ускорителей:
| Сценарий | Количество GPU | Длительность | Примерно GPU-дней |
|---|---|---|---|
| Долгосрочный кластер | 100 000 | 347 дней | 34,7 миллиона |
| Крупномасштабный краткосрочный кластер | 1 000 000 | 35 дней | 35 миллионов |
Эти цифры следует понимать как приблизительные сценарные оценки от источников, а не как универсальную инженерную формулу.
Фактические потребности в обучении в значительной степени зависят от:
Официальные спецификации NVIDIA H100 показывают, что TDP версии SXM может достигать 700 Вт и поддерживает крупномасштабное обучение трансформеров благодаря Transformer Engine архитектуры Hopper и инфраструктуре NVLink.
В масштабе сотен тысяч ускорителей только GPU-кластер достигает уровня, где электроэнергия, сеть, охлаждение и ёмкость центров обработки данных становятся первостепенными ограничениями.
Источники AIBase справедливо отмечают, что одновременный запуск 1 миллиона ускорителей уровня H100 был бы экстремальной инфраструктурной конфигурацией.
Более реалистичный проект, вероятно, распределит обучение на меньший, но всё равно огромный кластер.
Источники предполагают более близкий вариант:
Это всё равно будет один из крупнейших тренировочных кластеров.
Один из самых амбициозных инженерных проектов по обучению моделей в истории человечества.
А предобучение — лишь один из этапов.
Передовой модели также потребуется время и вычислительные мощности для следующих шагов:
Поэтому в оригинальной статье AIBase оценивается, что весь процесс займёт не менее полугода, а до появления зрелой модели общее время может приблизиться к году.
Позднее сообщение Financial Times (в изложении Reuters) сообщило, что модель уже находится на этапе предобучения, и отметило, что этот этап обычно занимает около трёх-шести месяцев, прежде чем последуют этапы тонкой настройки и выпуска.
Оба описания приводят к одному практическому выводу: проект такого масштаба — это долгосрочная инфраструктурная работа, а не модель, которая появится сразу после запуска первого тренировочного кластера.
Обучение такого масштаба — не только исследовательская задача.
Это также задача инфраструктуры и капитала.
ByteDance — одна из немногих китайских технологических компаний, обладающих достаточными финансовыми ресурсами, потребительскими каналами распространения, облачной инфраструктурой, ёмкостью центров обработки данных и командой ИИ-инженеров, чтобы серьёзно попытаться реализовать проект такого масштаба.
Официальная организация Seed этой компании охватывает следующие направления:
Инфраструктурная команда ByteDance прямо описывает свою работу как охватывающую распределённое обучение, системы обучения с подкреплением, высокопроизводительный инференс и компиляторные технологии для базовых моделей.
В их рекрутинговых материалах также прямо упоминаются следующие направления работы:
Именно эти проблемы системной инженерии становятся критически важными при обучении моделей с триллионами параметров.
AIBase также приводит сторонние оценки масштабов доступных AI-вычислительных мощностей нескольких ведущих лабораторий.
Приблизительные цифры, упомянутые в статье:
Эти числа не следует воспринимать как проверенные данные о запасах оборудования.
OpenAI и Anthropic не публикуют в открытом доступе актуальное количество всех доступных ускорителей в собственных мощностях, у облачных партнёров и в резервных мощностях.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Оценка DeepSeek примерно в 60 тысяч ускорителей изначально появилась в расчётах SemiAnalysis и с тех пор широко цитировалась в различных отчётах. Эти оценки включают смесь различных ускорителей — A100, H100, H800 и H20, а не однородный парк оборудования.
Более надёжным, чем любые точные цифры запасов, является более общий ключевой момент:
Разработка передовых моделей всё больше зависит от доступа к сверхмасштабным вычислительным мощностям, и по мере роста масштабов моделей разрыв между компаниями, обладающими сверхмасштабной инфраструктурой, и более мелкими лабораториями может стать очень значительным.
Речь идёт о росте до триллионов параметров.
Использование эквивалента H100 упрощает обсуждение вычислений, но ByteDance вовсе не обязана полагаться на один тип ускорителей.
Крупные AI-компании могут использовать комбинацию:
Более новые ускорители могут изменить количество физических GPU, необходимое для выполнения того же объёма обучающих вычислений.
Программное обеспечение не менее важно.
Улучшения в следующих областях:
Могут существенно изменить соотношение между общим масштабом модели и затратами на обучение.
Поэтому утверждение «модели X требуется ровно Y GPU» всегда следует рассматривать как сценарное допущение, а не как неизменное правило.
Источник в основном описывает этот проект как попытку вывести уровень интеллекта Doubao на мировые передовые позиции.
Вероятно, это лишь часть мотивации.
Более крупная базовая модель может обеспечивать работу нескольких частей AI-экосистемы ByteDance.
Doubao — один из основных потребительских AI-продуктов ByteDance на китайском рынке.
Более сильная базовая модель может улучшить:
Сверхмасштабная модель также предоставит команде Seed новую исследовательскую платформу для изучения:
ByteDance также может монетизировать возможности модели через корпоративные и облачные сервисы.
Таким образом, передовая модель имеет потенциальную ценность и помимо потребительского чат-бота.
Последний вопрос в статье AIBase — самый важный.
Сможет ли модель с крайне высокой стоимостью обучения обеспечить соответствующую отдачу?
Ведущие лаборатории должны оплачивать не только финальный обучающий прогон.
Общие расходы могут включать:
Затем модель должна создавать ценность через некоторую комбинацию:
Количество параметров имеет экономический смысл только тогда, когда оно преобразуется в полезные возможности при приемлемой стоимости инференса.
Вот почему в текущем поколении передовых моделей всё больше внимания уделяется эффективности масштабирования, а не просто общему числу параметров.
Например, общее число параметров Kimi K3 составляет 2,8 триллиона, но на каждый токен активируется лишь 104 миллиарда параметров. Moonshot AI заявляет, что их архитектура демонстрирует улучшенную эффективность масштабирования по сравнению с предыдущим поколением.
Таким образом, настоящая конкуренция — это не:
У кого больше параметров?
А скорее:
Кто сможет преобразовать наибольшую силу при наименьших ресурсах?

Преобразовать в наиболее полезный интеллект при устойчивых затратах на обучение и инференс?
AIBase ссылается на сообщение LatePost о том, что ByteDance обсуждает модель с более чем 5 триллионами параметров. Позже в тот же день Reuters со ссылкой на Financial Times сообщило, что ByteDance уже предобучает модель, которая может достигать 10 триллионов параметров. ByteDance официально не подтвердила точные цифры.
Источник предполагает, что модель усилит экосистему Doubao от ByteDance, но ByteDance официально не объявляла, как будет развёрнута модель из сообщения. Передовая модель также может поддерживать корпоративные API, агентов, исследования и другие продукты ByteDance.
Не обязательно. Общее количество параметров напрямую не определяет качество модели. Архитектура, активируемые параметры, обучающие данные, пост-обучение, обучение с подкреплением, рассуждения во время инференса и использование инструментов могут быть не менее важны.
Moonshot AI официально объявила, что общее число параметров Kimi K3 составляет 2,8 триллиона, а активируемых параметров — 104 миллиарда. Она использует разрежённую архитектуру смеси экспертов (MoE).
Согласно сообщениям Alibaba и Reuters, общее число параметров Qwen3.8-Max составляет 2,4 триллиона. Она также основана на разрежённой модели, а не на активации всех параметров для каждого токена.
Источник приводит приблизительный сценарий, эквивалентный примерно 35 миллионам GPU-дней H100, например, 100 тысяч H100 в течение 347 дней или 1 миллион H100 примерно за 35 дней. Фактические потребности могут сильно различаться в зависимости от архитектуры, точности, коэффициента использования, количества токенов, оборудования и эффективности обучения.
OpenAI не раскрывает публично количество параметров GPT-5.6. Любое утверждение о параметрах GPT-5.6
Прямое числовое сравнение с той или иной моделью
По сообщениям, модель компании ByteDance пока остаётся предметом предположений.
На данный момент официальная дата выпуска не объявлена. Reuters, ссылаясь на публикацию Financial Times, сообщает, что модель находится на этапе предварительного обучения, который может занять несколько месяцев, после чего потребуются дополнительная настройка, оценка и развёртывание.
По сообщениям, ByteDance готовит сверхмасштабную фундаментальную модель, которая превысит по масштабу все публично раскрытые китайские модели. AIBase и 晚点LatePost первоначально описывали этот проект как модель с более чем 5 триллионами параметров, а более поздние сообщения Reuters/Financial Times в тот же день указывали, что модель может достичь 10 триллионов параметров и уже находится на стадии предварительного обучения.
Проект такого масштаба потребует огромных вычислительных ресурсов. Приведённый в источниках пример с H100 соответствует примерно 35 миллионам GPU-дней, однако фактические потребности в обучении зависят от архитектуры, активных параметров, поколения оборудования, коэффициента использования и эффективности обучения.
Более важный вопрос не в том, сможет ли ByteDance построить самую большую модель. Общее количество параметров — неполный показатель интеллекта, особенно для разреженных систем смеси экспертов.
Настоящее испытание заключается в том,
сможет ли ByteDance превратить вычислительные мощности триллионного масштаба в модель, которая будет значительно лучше по производительности, достаточно эффективна для обслуживания и достаточно ценна, чтобы оправдать стоящую за ней инфраструктуру.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



