Одинаковая на первый взгляд проблема «ссылка неверная» имеет разные причины, и подход к устранению тоже разный. Сначала нужно разделить причины, иначе усилия уйдут на бесполезные действия.
Остатки в обучающих данных. Модель видела в корпусе ваш старый домен, старое название бренда или страницы до переименования. Когда она не запускает поиск и отвечает по памяти, то выдаёт уже недействующий адрес. Признак — стабильное воспроизведение: меняете формулировку вопроса, а ссылка остаётся той же.
При поиске попадаются вторичные страницы. Ответы с подключением к сети забирают публичный контент, и часто это отраслевые каталоги, магазины на B2B-платформах, флагманские магазины на маркетплейсах, перепечатки пресс-релизов, страницы вакансий и даже поддельные сайты. Чтобы их находили, в заголовки таких страниц набивают название бренда, и семантически они «выглядят более официальными, чем сам официальный сайт».
Название указывает на несколько субъектов. Если название бренда сильно пересекается с общеупотребительным словом, названием продукта или чужой торговой маркой и под одним именем существует несколько компаний, клиенту вполне могут вернуть сайт другой компании.
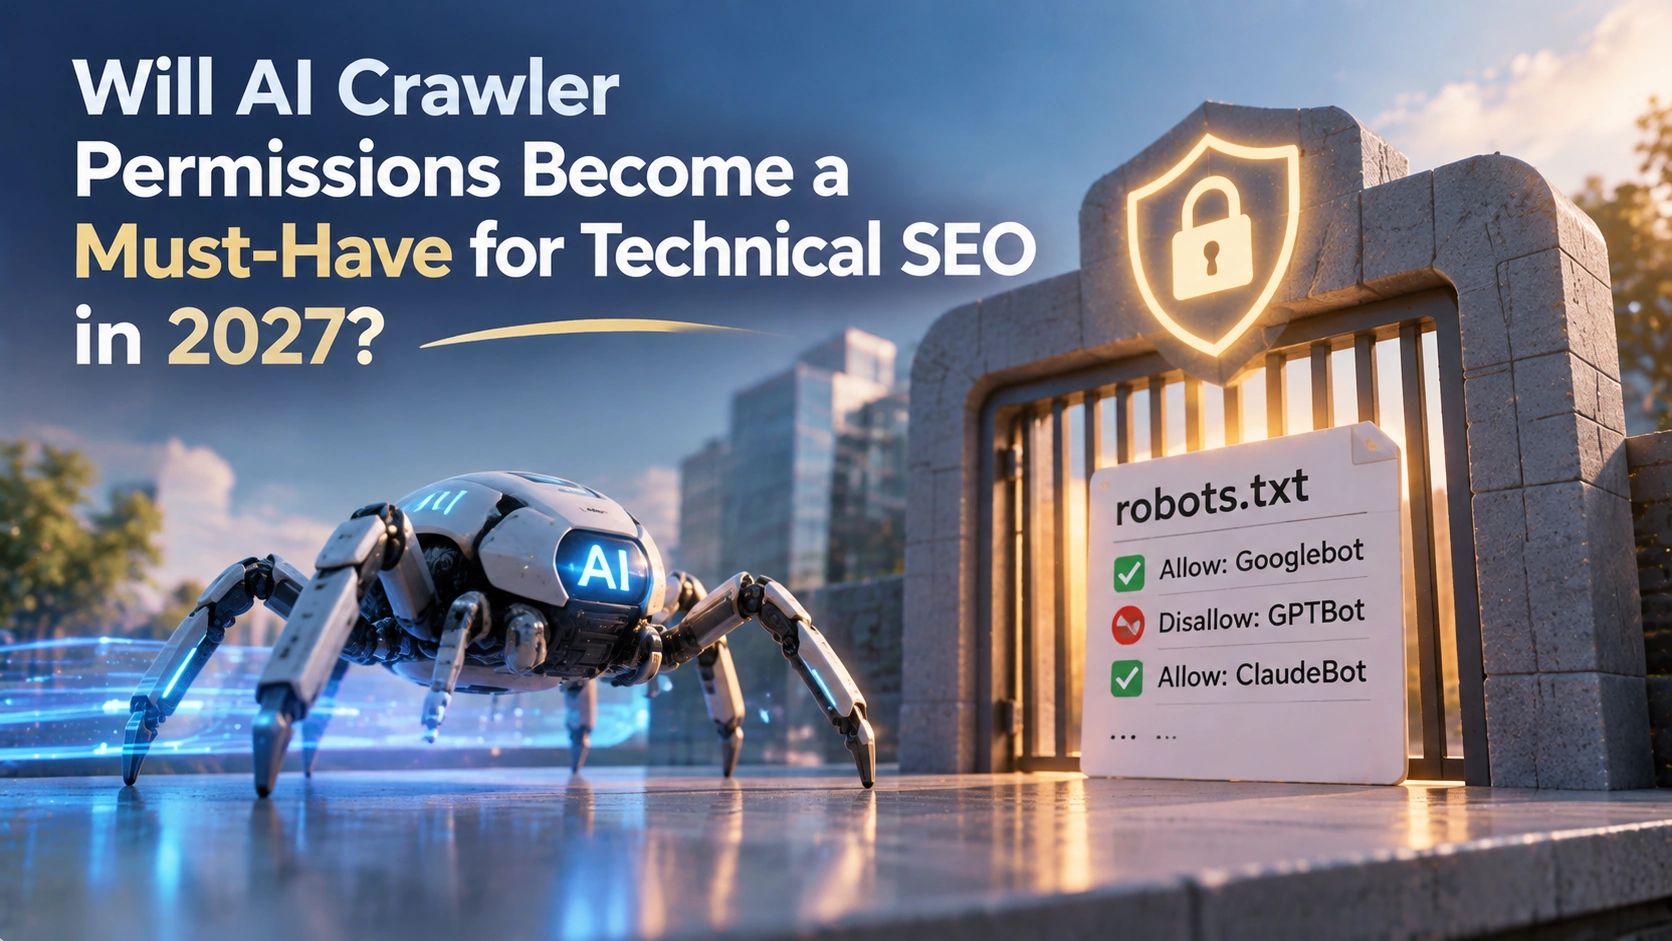
Сам источник цитирования проблемный. Официальный сайт давно не обновляется, в нём нет определений, он закрыт в robots.txt — сканер не получает цитируемых фраз и вынужден ссылаться на сторонний пересказ; если в пересказе домен и контакты один раз указаны неверно, их будут повторять снова и снова.
По сообщению The Verge, тест, проведённый Podqi с использованием собственного набора вопросов, показал, что часть ответов ChatGPT, Gemini и Perplexity рекомендовала пользователям в качестве каналов покупки поддельные официальные сайты, неработающие домены и розничные площадки, торгующие контрафактом (The Verge). Этот тест измеряет поведение AI-ответов на конкретные вопросы и не может напрямую приравниваться к вероятности того, что все реальные пользователи столкнутся с рискованными ссылками; но он показывает вполне практичную вещь: суждение ИИ о том, «какая ссылка официальная», зависит от доступных публичных доказательств, а не от вашего субъективного заявления.
II. Почему небольшие бренды чаще путают
Вероятность ошибки для крупных брендов ниже не потому, что модель предвзята, а потому что у них высокая избыточность публичной информации: одно и то же название компании, домен, адрес и название продукта повторяются в десятках авторитетных источников, и система легко сходится к единственному выводу. Малому и среднему бизнесу как раз не хватает такой избыточности.
- Название бренда совпадает с общеупотребительным словом. Если в названии есть слова вроде «облако», «умный», «создание сайтов» или «технологии», при поиске оно неизбежно смешивается с множеством несвязанных субъектов.
- Контент официального сайта слишком скудный. Только один экран со слоганом и несколько изображений, без полных предложений вроде «кто мы, что делаем, кому служим, где находимся», которые можно напрямую извлечь.
- Домен или бренд менялись. Старый домен не перенаправлен через 301, страницы со старым названием бренда всё ещё индексируются, и одна и та же компания существует в сети в двух наборах информации.
- Сторонняя информация новее официального сайта. Официальный сайт полгода не менялся, а в отраслевом каталоге кто-то обновил описание за вас — более «свежая» версия естественно вызывает больше доверия.
- Не хватает сигналов идентичности сущности. Нет структурированных данных, нет ссылок sameAs на внешние профили, и соответствие между сайтом и компанией имеет меньше проверяемых подсказок.
III. Блоки брендовой информации, которые обязательно добавить на сайт
Критерий прост: закройте изображения на главной странице и странице «О компании», смотрите только на текст — можете ли вы ответить на следующие вопросы. Если ответить полностью не получается, вы передали право судить другим.
| Информационный блок | Зачем он нужен | Где размещать |
|---|---|---|
| Полное название бренда, английское название, общепринятое сокращение, прежние названия | Устраняет путаницу из-за нескольких названий одной сущности | Подвал, первый абзац страницы «О компании», поля name и alternateName в структурированных данных |
| Определение в одном предложении: что делаем, для кого, где | Даёт ответную фразу, которую можно напрямую цитировать | Первый абзац основного текста под первым экраном главной страницы |
| Заявление об официальном домене | Явно указывает «единственный официальный сайт», исключает зеркала и старые домены | Страница «О компании», страница контактов, строка копирайта в подвале |
| Список продуктов и услуг и сценарии применения | Поддерживает упоминание бренда в вопросах о категории | Страницы продуктов, страница тарифов и решений |
| Контакты (email, телефон, адрес) | Поддерживает разметку Organization и LocalBusiness | Отдельная страница контактов, написанная обычным текстом |
| Юридическое лицо, место регистрации, год основания | Согласуется с данными госреестров и рекрутинговых платформ | Страница «О компании» |
| Дата обновления контента и ответственный субъект | Основание для оценки свежести информации | Страницы статей и ключевые страницы |
После написания нужно соблюдать согласованность: если на официальном сайте указано «Название Technology (Shenzhen) Co., Ltd.», то в магазине на B2B-платформе, описании официального аккаунта и на странице вакансий нельзя указывать другое юридическое лицо. Несогласованность формулировок на разных платформах равносильна намеренному созданию путаницы.
IV. Как организовать официальный домен, страницы продуктов и контакты
Домен и структура страниц — каркас сигналов сущности; затраты на перестройку невысоки, а эффект прямой.
- Определите единственный канонический домен. Выберите один основной домен и ссылайтесь на него по всему сайту; все остальные варианты (www/без www, старый домен, домен в пиньине) перенаправьте через 301 на основной домен и не создавайте зеркала контента.
- Закрепите стабильные URL ключевых страниц. Для страниц «О компании», продуктов, тарифов, контактов и часто задаваемых вопросов используйте неизменные пути, например /about, /product, /pricing, /contact, /faq. Частые изменения путей делают исторические цитаты недействительными.
- В заголовке каждой страницы указывайте полное название бренда. Сделайте «название бренда + тема страницы» стандартной формулировкой, а не ограничивайтесь только ключевыми словами.
- На странице контактов давайте машиночитаемую информацию. Название организации, адрес, email и телефон должны быть написаны обычным текстом, а не только изображением или внутри формы.
- Сопоставьте старые названия бренда и старые домены. Сохраните пояснительную страницу или 301-редирект с указанием «старый домен X перенесён на новый домен», чтобы старый сайт не продолжали считать официальным.
- Для многоязычных сайтов свяжите версии через hreflang. Обозначьте языковые версии друг для друга, чтобы многоязычные сайты одного бренда не конкурировали в поиске и не воспринимались как разные субъекты.
V. Как добиться правильного цитирования со сторонних сайтов
Сторонние цитаты не выпрашивают, а «подкармливают». Компания может контролировать, «какие материалы дать другой стороне» и «как разрешить другой стороне сканировать».
Сначала разрешите краулеры. В документации Alibaba Cloud по диагностике бренда в GEO указано: если на сайте включена строгая защита от сканирования, ИИ не сможет сканировать и понимать ключевой контент, что напрямую повлияет на результаты диагностики; рекомендуется явно разрешить основных AI-краулеров (Справочный центр Alibaba Cloud). Формулировка — явное разрешение, а не блокировка всего сайта:
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /
Идентификаторы краулеров разных платформ должны соответствовать официальной документации соответствующего провайдера; при добавлении или переименовании обновляйте их синхронно и не отключайте весь AI-краулинг одной строкой Disallow: /.
Создайте сайт-витрину и привлекайте лиды за минуты
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Затем внедрите структурированные данные. Отраслевая практика в целом рекомендует использовать разметку Organization для свойств name, url, logo, sameAs, contactPoint и других, разметку FAQPage для вопросов и ответов, а через sameAs связывать авторитетные профили для усиления достоверности сущности (Hashmeta). Минимальная рабочая версия:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Полное название бренда",
  "alternateName": ["Английское название", "Общепринятое сокращение"],
  "url": "https://example.com/",
  "logo": "https://example.com/logo.png",
  "email": "[email protected]",
  "telephone": "+86-xxx-xxxxxxx",
  "sameAs": ["https://www.linkedin.com/company/your-brand"]
}
В конце унифицируйте внешний информационный пакет. Подготовьте две версии краткого описания бренда — на 50 и 200 знаков, — а также стандартный логотип, официальный домен и контакты и разместите всё это на публично доступной странице для СМИ. Медиа, отраслевые каталоги и партнёры смогут брать материалы напрямую. Компании не нужно контролировать каждый материал, достаточно гарантировать, что во всех материалах название бренда, домен и написание юридического лица полностью совпадают. В одной отраслевой публикации, перепечатанной The Beijing News, эта способность названа «правом на цитирование в ИИ» — способностью бренда быть распознанным большой моделью, понятым и включённым в ответ как достоверная информация; там же подчёркивается, что авторитетные источники и кросс-платформенная согласованность являются её основой (The Beijing News).
VI. Как отслеживать неверные описания вашей компании в ИИ
Мониторинг — это не пара случайных вопросов в день, а повторяющиеся тесты с фиксированным набором вопросов, фиксированными платформами и полями.
- Соберите набор вопросов. Делите их на два типа: отраслевые вопросы без названия бренда (например, «Какие AI-конструкторы сайтов есть на местном рынке»), чтобы проверить, упоминают ли вас по собственной инициативе; вопросы с названием бренда (например, «Какой сайт у компании X и можно ли ему доверять»), чтобы увидеть, какую ссылку дают и как оценивают. В документации Alibaba Cloud по диагностике бренда в GEO эта логика разделена на тесты «видимость в ИИ» и «репутация бренда в ИИ»; требуется, чтобы брендовые ключевые слова покрывали сокращение, английское название и частые ошибки написания, а также были заданы три-пять брендов конкурентов для сравнения (Справочный центр Alibaba Cloud).
- Фиксируйте поля записи. При каждом повторном тесте записывайте как минимум: дату, платформу, исходный вопрос, упомянут ли бренд, выданную ссылку, домены источников цитирования, тональность оценки.
- Сначала устраняйте ошибки «на уровне ссылки». Прямой ущерб клиенту наносит именно переход по неверной ссылке, формулировки и оценки можно отложить. Порядок действий: сначала исправьте недостающие информационные блоки на официальном сайте, затем свяжитесь с высокоавторитетными сторонними страницами, где указан неверный домен, и попросите исправить, и наконец опубликуйте на официальном сайте авторитетную страницу «официальные каналы» как основание для цитирования.
- Смотрите на распределение источников, прежде чем решать, где размещать контент. Если цитаты сосредоточены на нескольких платформах, синхронизируйте туда разъяснения и информацию со страниц продуктов, а не говорите только у себя на сайте.
VII. Создайте единый официальный вход для брендовой информации
Когда информация разбросана по десяткам мест, исправление ошибок превращается в бесконечную игру в «Убей крота». Более экономный подход — создать единый источник истины: публичную, доступную для сканирования страницу фактов о бренде с датой обновления, включающую полное название и псевдонимы, позиционирование в одном предложении, официальный домен, список продуктов, контакты, юридическое лицо и контакты для СМИ. Все внешние материалы копируются с этой страницы, а не создаются заново.
Эта страница обслуживает три типа читателей: клиенты используют её для подтверждения подлинности официального сайта, продажи и поддержка — для единой формулировки, ИИ после сканирования — для формирования представления о сущности. Её ценность не в красоте, а в «единственности и стабильности».
Если создавать и поддерживать официальный сайт с помощью we0, организация информации, структурированные данные, многоязычные версии и последующие обновления контента могут выполняться в одной цепочке: генерация страниц, поддержка контента в CMS, развертывание домена и настройки SEO/GEO — в одном рабочем пространстве (we0.ai). Страница фактов о бренде, страницы продуктов и FAQ обновляются один раз и действуют на всём сайте, что сокращает временное окно, когда «на официальном сайте указан старый домен, а третьи стороны всё ещё цитируют старый домен». Инструмент может сократить цикл согласования информации, но предпосылка остаётся прежней: компания сначала должна ясно определить факты о бренде.
VIII. План действий на 30 дней
- Неделя 1: инвентаризация. По очереди спросите в ChatGPT, Gemini и Perplexity «какой официальный сайт» с использованием полного названия бренда, английского названия и частых ошибок написания,记录 каждый возвращённый ссылку; проверьте все недействующие старые домены и страницы со старым брендом.
- Неделя 2: дополните сайт. По таблице из раздела III добавьте информационные блоки, запустите страницу фактов о бренде и текстовую информацию на странице контактов, внедрите структурированные данные Organization и FAQPage, проверьте ошибки валидатором.
- Неделя 3: управляйте цитированием. Настройте robots.txt, чтобы разрешить основных AI-краулеров, подготовьте внешний брендовый пакет материалов, по очереди свяжитесь с высокоавторитетными сторонними страницами с неверным доменом, все старые домены перенаправьте через 301.
- Неделя 4: создайте базовую линию. Зафиксируйте набор вопросов и таблицу записей, проведите одно полное повторное тестирование на всех платформах как базовую линию, затем повторяйте еженедельно и используйте количество ошибок со ссылками как основной показатель.
FAQ
ИИ выдаёт неверную ссылку на официальный сайт — можно ли напрямую пожаловаться платформе и добиться исправления?
У основных AI-ассистентов нет универсального «входа для исправлений» для брендов; неверная ссылка обычно происходит из публичного контента, который система просканировала или запомнила. Эффективный путь — исправить источник: дополнить цитируемую информацию на официальном сайте, разрешить краулеры и унифицировать формулировки на сторонних сайтах.
Изменится ли ответ ИИ сразу после правок на официальном сайте?
Мгновенной синхронизации не будет. Ответы с поиском зависят от цикла сканирования и индексации, ответы по памяти — от ритма обновления модели. Рекомендуется повторять тесты раз в неделю и наблюдать тенденцию изменения ссылок по одному и тому же набору вопросов, а не цепляться за один конкретный диалог.
Нужно ли это небольшой компании без известности?
Чем меньше бренд, тем меньше публичной информации и тем выше вероятность путаницы, а стоимость ошибки наоборот больше. Можно начать с трёх вещей: страница фактов о бренде, разметка Organization, текстовая информация на странице контактов. Затраты очень низкие.
Не приведёт ли разрешение AI-краулерам к утечке данных или падению органического трафика?
Разрешается сканирование публичных страниц, это не равно разрешению использовать клиентские данные или доступ к административной части. Если есть опасения открывать весь сайт, можно разрешить только публичные страницы и отдельно ограничить административные и API-пути, сохранив при этом отправку sitemap традиционным поисковым системам.
Related Tools
- Google Search Console: проверьте индексацию официального сайта и ошибки структурированных данных, убедитесь, не индексируются ли ещё страницы старого домена.
- Bing Webmaster Tools: здесь можно сверить часть сигналов сканирования для AI-поиска и экосистемы Copilot.
- Инструмент проверки структурированных данных: проверьте, правильно ли разбирается разметка Organization и FAQPage.
- we0.ai: генерация страниц, поддержка контента в CMS, развертывание домена и настройки SEO/GEO в одном рабочем пространстве — удобно централизованно поддерживать факты о бренде.
Related Links
- The Verge: исследование показало, что ИИ-чат-боты рекомендуют фальшивые розничные сайты
- Справочный центр Alibaba Cloud: диагностика бренда в GEO
- Hashmeta: лучшие практики GEO-оптимизации на 2026 год
- The Beijing News: от борьбы за трафик к борьбе за цитирование в ИИ
- Официальный сайт we0.ai
Summary
Когда клиент находит в ChatGPT неверную ссылку на официальный сайт, это результат недостатка и несогласованности публичной информации, а не случайная ошибка. Суждение ИИ о том, «что является официальным», опирается на доступную для сканирования полную информацию, ясные и уникальные сигналы сущности и согласованные внешние цитаты. Действия, которые может предпринять компания, вполне конкретны: указать название бренда, определение, домен и контакты в тексте сайта и разметить их структурированными данными, разрешить основных AI-краулеров, унифицировать формулировки на сторонних сайтах, создать долгосрочно поддерживаемую страницу фактов о бренде и затем еженедельно перепроверять по фиксированному набору вопросов. Эта работа одновременно является основой GEO-оптимизации и напрямую определяет, куда ведёт первый переход клиента в AI-поиске — на ваш официальный сайт или на незнакомую страницу, которая выглядит как ваша.