For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropic сообщает, что новые меры защиты сократили объём рассуждений Claude, собираемых дистилляторами на собственной платформе, примерно н...
Anthropic сообщает, что новые меры защиты сократили объём рассуждений Claude, собираемых дистилляторами на собственной платформе, примерно на 90–99%. В обновлении от 12 октября описаны три уровня защиты: ограничения на повторное использование защищённых рассуждений, более сильные классификаторы извлечения и средства контроля аккаунтов, которые повышают стоимость повторных попыток.
Практические последствия есть и для обычных разработчиков. Некоторым интеграциям потребуется изменить способ повторной передачи истории диалога, а часть запросов, заблокированных до ответа Claude, теперь может тарифицироваться. Чтобы понять эти издержки, необходимо отделить результаты компании в борьбе со злоупотреблениями от правил API, с которыми приложения действительно сталкиваются.
Дистилляция обучает модель на выходных данных другой модели. Это также легитимный метод: разработчики могут дистиллировать собственные модели или использовать данные, на которые у них есть разрешение. Отчёт Anthropic посвящён несанкционированным кампаниям извлечения, часто связанным с мошенническими аккаунтами, а не рассматривает любую дистилляцию как злоупотребление.
В этом контексте итоговые ответы являются полезными обучающими данными, однако подробные рассуждения могут быть ещё ценнее. Транскрипт рассуждений раскрывает промежуточные решения, испробованные подходы и исправления, которые обучаемой модели иначе пришлось бы выводить самостоятельно.
Anthropic иллюстрирует различие экспериментом, в котором предварительно обученную модель Claude обучали на транскриптах Claude Opus 4.8. Полученные показатели SWE-bench Verified были следующими:
| Обучающий материал | Заявленный результат SWE-bench Verified |
|---|---|
| Транскрипты с полными рассуждениями | 80,4% |
| Транскрипты с суммированными рассуждениями | 71,8% |
Это разница в 8,6 процентного пункта в рамках данного эксперимента. Она подтверждает ценность транскриптов рассуждений для этой схемы обучения, но не устанавливает универсальное преимущество такого же масштаба для разных моделей или задач.
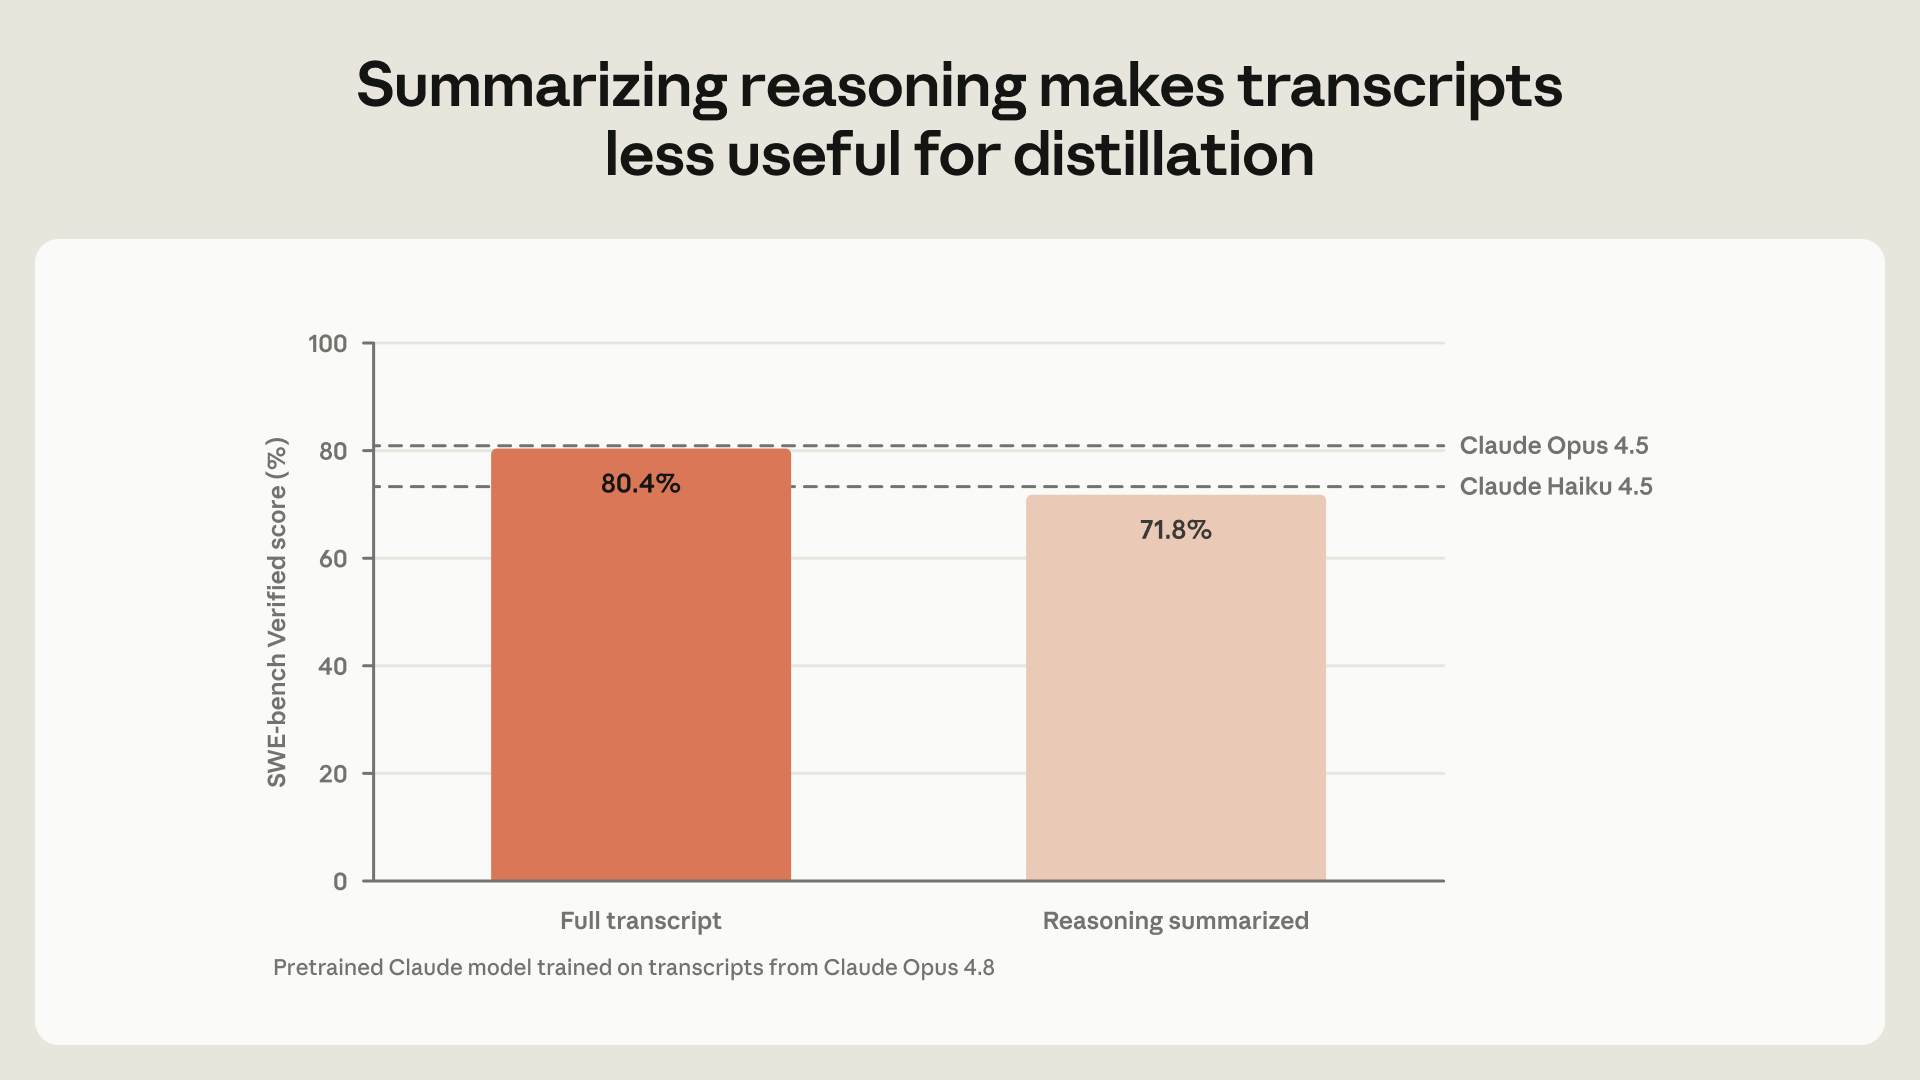
Источник: Anthropic. Столбцы описывают обучаемую модель, обученную на транскриптах Opus 4.8, а не прямое сравнение производительности указанных в качестве ориентиров производственных моделей.
Показ суммарных версий уменьшает пассивный сбор, однако создаёт стимул выманивать скрытые рассуждения через последующие запросы. Anthropic сообщает, что одна лаборатория протестировала 12 000 различных запросов на извлечение. Компания также описывает прокси-сети, которые распределяют активность между большим числом аккаунтов, включая ранее описанную сеть, одновременно управлявшую более чем 20 000 мошеннических аккаунтов.
При выполнении длительных задач модели может потребоваться продолжить рассуждение, созданное на предыдущем ходе. API может сохранять защищённые блоки мышления для этой цели, не раскрывая базовые рассуждения как обычный текст, доступный пользователю.
Это создаёт проблему контроля доступа. По данным Anthropic, злоумышленники пытались перемещать рассуждения между диалогами, моделями или аккаунтами, чтобы найти контекст, в котором их можно раскрыть. Поэтому защита блока требует контроля его повторного использования, а не только его отображения.
Anthropic представила сохранённое мышление вместе с Claude Fable 5.1 и Claude Opus 5.5. В текущей документации описаны две ключевые проверки:
Проверка префикса по умолчанию применяется к аккаунтам, созданным 31 августа 2026 года в 00:00 UTC или позднее. Более старые аккаунты могут включить принудительное применение через документированные средства управления. Проверка совместимости моделей применяется ко всем аккаунтам.
В исследовательском анонсе также описаны организационные ограничения для рассуждений Sonnet 5.5. Текущая документация API приводит более точное правило: блоки мышления Sonnet 5.5 и Haiku 5.5 работают только в аккаунте, который их создал, или в связанном аккаунте, в котором применяется документированное принудительное правило. При реализации маршрутизации или смены аккаунтов разработчикам следует опираться на документацию по совместимости.
Обычное поведение приложения может изменить защищённый префикс: повторная сборка системного промпта с новой временной меткой, редактирование старого вывода инструмента, изменение описаний инструментов или суммирование предыдущих ходов при сохранении более поздних блоков мышления.
По умолчанию недействительный префикс может привести к 400 invalid_request_error. Документированные бета-настройки также позволяют задать для thinking.block_binding.prefix_mismatch_behavior значение drop_block; тогда недействительные блоки мышления и все последующие блоки мышления отбрасываются для данного запроса. Это позволяет запросу продолжить выполнение, но не исправляет изменение истории.
Сохраняйте повторно передаваемую историю неизменной и добавляйте новую информацию с помощью поддерживаемых шаблонов. Менять видимый текст диалога и при этом продолжать повторно использовать все его старые защищённые рассуждения больше нельзя считать безопасным допущением.
Второй уровень Anthropic использует двухэтапную систему классификаторов, основанную на исследованиях Constitutional Classifiers. Компания тестирует попытки извлечения с участием внутренних и внешних красных команд, а затем обновляет защиту, когда какая-либо техника оказывается успешной.
Компания сообщает, что в её оценке получившиеся меры защиты от дистилляции имеют уровень ложноположительных срабатываний ниже 0,1%. Она сравнивает их устойчивость со своими механизмами защиты от содействия в создании биологического оружия. Это оценка компании в её условиях тестирования, а не гарантия того, что легитимный запрос конкретного пользователя никогда не будет отклонён.
Система также меняется со временем. Anthropic описывает исправление техник, направленных на раскрытие защищённых рассуждений через перевод или специальное форматирование вывода. Опубликованное утверждение состоит в том, что классификатор выявляет техники извлечения, описанные в сентябрьском отчёте компании, для моделей, охваченных системой.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Третий уровень реагирует на повторяющееся поведение. Аккаунты, которые настойчиво пытаются извлекать данные, могут получить более строгие лимиты использования, а связанные с ними аккаунты могут быть заблокированы. Anthropic сообщает о блокировке десятков тысяч аккаунтов, иногда в течение двух часов после начала кампании.
С 24 сентября Anthropic также возобновила взимание платы за запросы, заблокированные до ответа модели, в отдельных категориях защитных мер с заявленным уровнем ложноположительных срабатываний ниже 0,1%, включая дистилляцию. Источник дополнительно называет категории биологических злоупотреблений и разработки передовых моделей. Это правило не следует обобщать на каждый отклонённый запрос или любой тип фильтра безопасности.
Anthropic оценивает, что после внедрения классификатора количество токенов извлечённых рассуждений на собственной платформе сократилось в 10–100 раз наряду с изменениями в сохранённом мышлении. В некоторые дни извлечённых токенов было слишком мало, чтобы компания могла провести измерение.
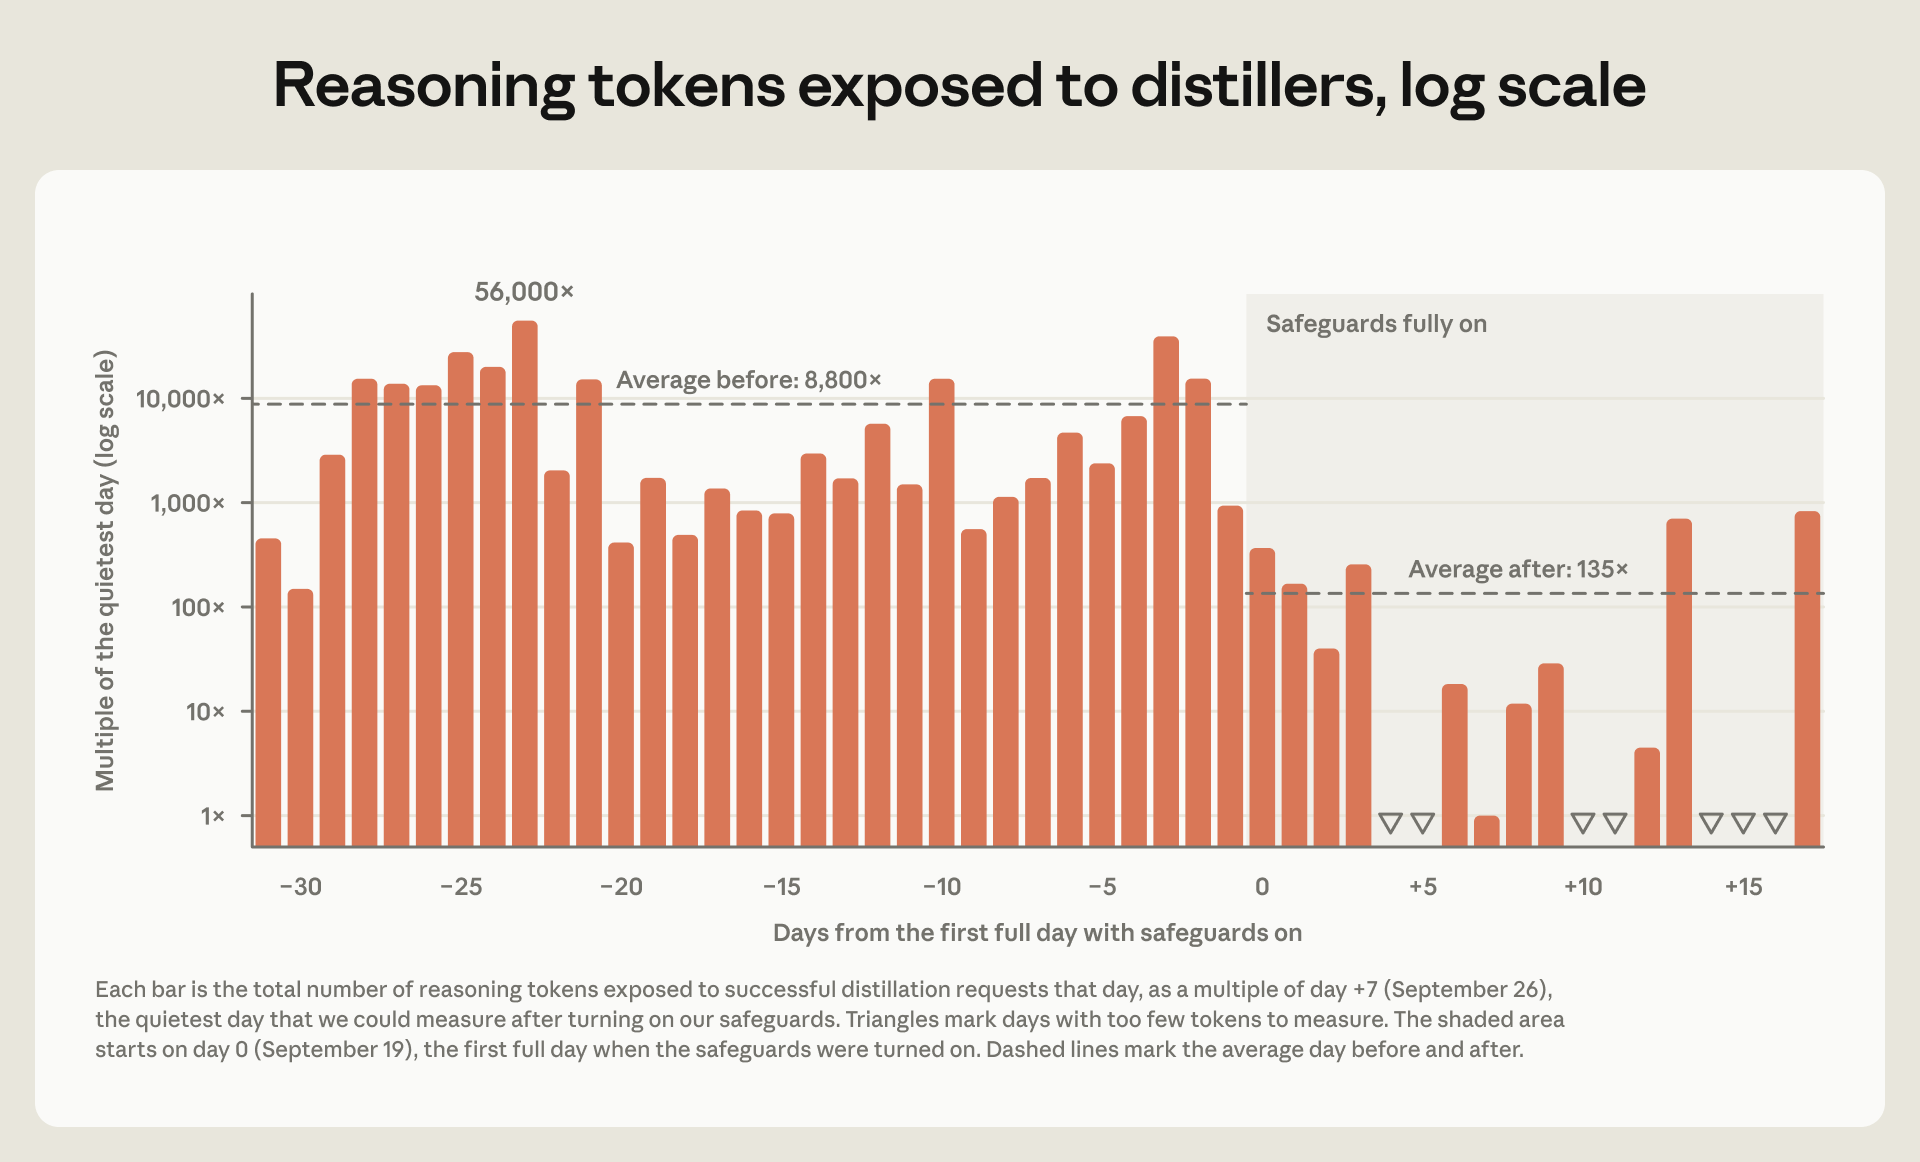
Источник: Anthropic. Вертикальная ось логарифмическая и нормирована относительно дня с низким уровнем извлечения, а не показывает абсолютное число токенов. Треугольники, направленные вниз, обозначают дни, в которые токенов было слишком мало для измерения.
Важно учитывать рамки этих данных. Эти показатели отражают оценку Anthropic для её собственной платформы; они не измеряют всю деятельность по дистилляции у сторонних провайдеров инференса. Компания также заявляет, что пока не наблюдала высокосложной и устойчивой попытки обойти полностью внедрённые меры защиты и не знает, как долго сохранится достигнутый эффект.
Anthropic признаёт, что изменения не были полностью прозрачны для обычных пользователей. Интеграциям могут потребоваться обновления, добросовестные запросы могут быть ошибочно классифицированы, а такие ошибочные блокировки теперь могут повлечь оплату в затронутых категориях.
Потеря возможности повторно использовать мышление несёт и другую цену: модели может понадобиться заново восстановить выполненную работу. В описанном в документации API многоходовом бенчмарке программирования отбрасывание мышления один раз за сессию увеличивало количество выходных токенов на 20,1% при максимальном усилии. Это оценка для конкретной рабочей нагрузки с широкими доверительными интервалами, а не стандартная надбавка и не прогноз для каждого приложения.
Для разработчика полезно различать нечитаемый или отброшенный входной блок и вновь генерируемый вывод. Сам отброшенный блок не тарифицируется, тогда как повторное восстановление рассуждений может создать дополнительные выходные токены. Отслеживание несоответствий префикса и тестирование собственных рабочих нагрузок приложения информативнее, чем допущение, что успешная повторная попытка не имеет стоимости.
В терминологии Anthropic это несанкционированная кампания по сбору выходных данных Claude или защищённых рассуждений для обучения другой модели. Дистилляция сама по себе является стандартной техникой машинного обучения и может быть легитимной, если разработчик обладает необходимыми правами и разрешениями.
Нет. Anthropic сообщает об оценочном сокращении собранных рассуждений на 90–99% на собственной платформе после внедрения защитных мер. Этот показатель не охватывает каждого провайдера, каждую атаку или любой будущий метод извлечения.
Нет, если приложение соблюдает документированные правила повторной передачи мышления и сохранения префикса диалога. Проблемы возникают, когда ранний контекст изменяется, но приложение продолжает отправлять блоки мышления, привязанные к исходному контексту.
Только если это разрешено документированными правилами совместимости моделей. Модель, которая не может прочитать блок, работает без него, поэтому переход на более дешёвую модель не обязательно сохраняет рассуждения предыдущей модели.
Да. Anthropic сообщает, что отдельные категории защитных мер вновь стали тарифицироваться с 24 сентября, даже если запрос заблокирован до ответа Claude. В отчёте прямо признаётся, что ложноположительное срабатывание в этих категориях может затронуть легитимного клиента.
Нет. Это был заявленный рост при отбрасывании мышления один раз за сессию с максимальным усилием в определённом многоходовом тесте программирования. Эффект зависит от уровня усилия, истории диалога, задачи и частоты, с которой интеграция отбрасывает блоки.
Новые меры защиты Anthropic сочетают ограничения на защищённые рассуждения, классификаторы извлечения и меры против повторяющихся злоупотреблений. Компания сообщает о существенном сокращении объёма собранных рассуждений на собственной платформе, одновременно признавая, что злоумышленники могут адаптироваться.
Для разработчиков Claude API первоочередная задача — поддерживать корректную историю диалога и понимать стоимость заблокированных запросов или отброшенного мышления. Заявленные улучшения безопасности существенны, но стабильность интеграций и тестирование для конкретных рабочих нагрузок по-прежнему важны.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



