Новая схема промптов для Claude Opus 5 стремительно распространяется в сообществе AI-программистов: разработчики используют её для создания ...
Новый паттерн промптов для Claude Opus 5 стремительно распространяется в сообществе ИИ-разработчиков, поскольку разработчики используют его для создания удивительно качественных прототипов браузерных игр из коротких начальных инструкций.
Этот метод теперь называют «Петля испытаний» (Gauntlet Loop).
Его основная идея проста: не позволяйте одному и тому же агенту создать что-то один раз, оценить свою работу и остановиться на этом. Дайте ведущему агенту высокоуровневую цель, поручите ему разбить проект на более мелкие части, назначьте профессиональных исполнителей и используйте независимых агентов-рецензентов для сравнения фактического результата с конкретными стандартами качества.
Если сгенерированный результат не проходит сравнение — вернитесь на новый цикл итерации.
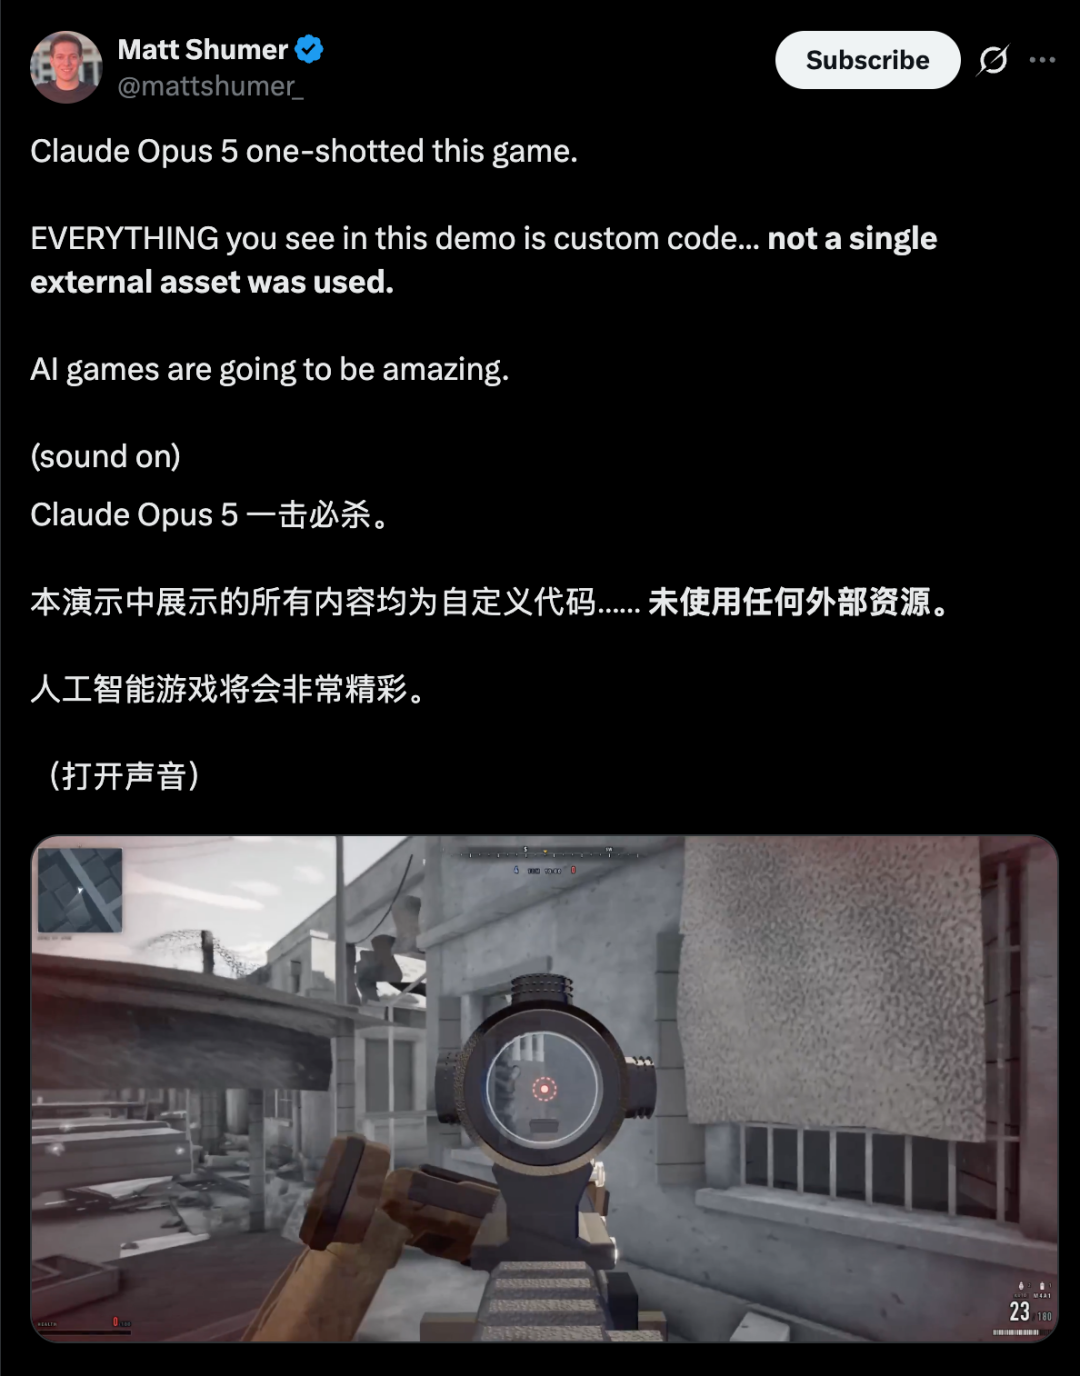
Мэтт Шумер популяризировал этот метод после того, как создал браузерный шутер от первого лица, вдохновлённый современными играми серии Call of Duty, с помощью Claude Code и Opus 5. Впоследствии он опубликовал промпты, исходный код и описание рабочего процесса.
Другой разработчик, Аншу Чимала, применил аналогичный рабочий процесс для создания «Долгой тишины» (The Long Silence), процедурной космической игры-исследования, работающей в браузере.
Эти проекты следует описывать точно. Они не означают, что один промпт может мгновенно создать коммерческую игру уровня AAA. Они показывают, что мощный кодирующий агент, наделённый инструментами, субагентами, длительным временем выполнения, измеримыми порогами качества и повторной проверкой, может продвинуть прототип значительно дальше, чем традиционный одноразовый промпт.
Первоначальная задача Шумера ставила намеренно экстремальную цель: создать шутер от первого лица с визуальными амбициями, сопоставимыми с современными AAA-проектами.
Ключевая часть заключается не в жанре игры, а в структуре оценки.
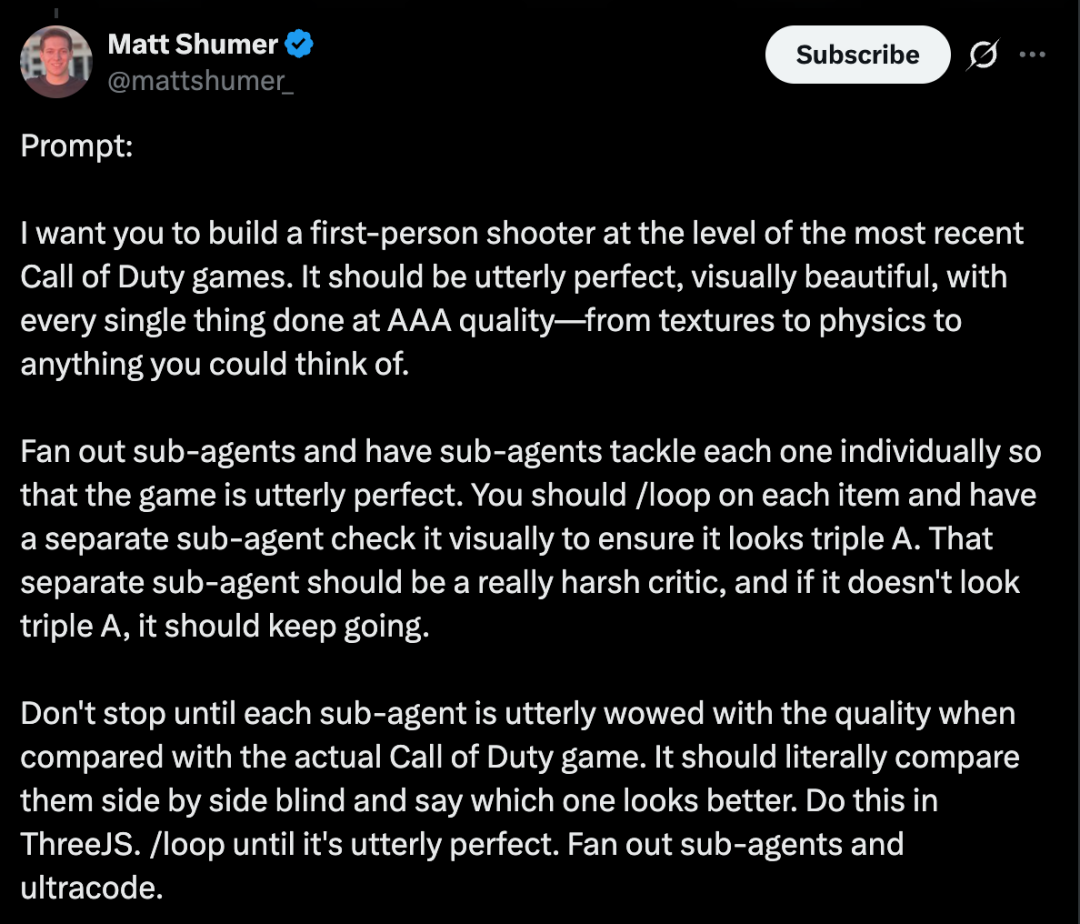
Рабочий процесс предписывал агенту:
Впоследствии Шумер формализовал этот подход как «Петлю испытаний» (Gauntlet Loop).
Упрощённая версия выглядит следующим образом:
Цель
  ↓
Ведущий агент
  ↓
Декомпозиция задач
  ↓
Агенты-исполнители
  ↓
Фактический результат
  ↓
Независимая оценка
  ↓
Сравнение с эталоном
  ↓
Пройдено? ── да → Интеграция
  │
  нет
  ↓
Объяснение наибольшего разрыва
  ↓
Улучшение исполнителем
  ↓
Повторение
Обратная связь вроде «сделай лучше» — слабая, потому что модель должна сама определить, что значит «лучше».
В «Петле испытаний» оценщику предоставляется внешний эталон.
Для игр это могут быть скриншоты из коммерческих проектов.
Для веб-сайтов — несколько ведущих сайтов в той же категории.
Для бэкенд-разработки это могут быть:
Цель не обязательно должна быть полностью достижимой. Её роль — помешать агенту преждевременно объявить об успехе.
Второе ключевое правило — независимость.
Исполнитель знает причины каждого своего решения и легко может оправдать свои результаты. А новый оценщик, получающий готовый артефакт, не знает контекста реализации.
Для визуальных работ оценщик может проверять отрендеренные пиксели.
Для программного обеспечения оценщик может проверять тесты и поведение во время выполнения.
Для задач производительности оценщик может проверять реальные измерения.
Более широкий принцип: генерация и оценка должны быть разделены.
Первоначальная демонстрация Шумера была публично выпущена под названием Claude of Duty.
В его репозитории на GitHub описан шутер от первого лица на основе Three.js и WebGL2, содержащий около 55 000 строк кода в ~11 подсистемах.
В описании репозитория указано, что игра не использует внешних художественных ресурсов. Текстуры, меши, анимации и звуки процедурно генерируются кодом.
Его системы включают:
Утверждение, что проект создан «с первого раза», не означает, что всё появилось в одном ответе. По словам Шумера, высокоуровневый промпт запустил длительную сессию Claude Code, которая затем порождала субагентов, записывала файлы, запускала инструменты, рендерила игру, проверяла результаты и постоянно вносила изменения.
Репозиторий включает следующие инструменты:
Файл README также более осторожен, чем некоторые вирусные публикации: в нём прямо указано, что итоговый проект не соответствует уровню современных игр Call of Duty.
Это делает эксперимент даже более ценным. Настоящий результат — не «ИИ уже заменил AAA-студии», а то, что намеренно высокая планка позволяет агенту продолжать работать значительно дольше, чем там, где остановился бы обычный промпт.
Затем Аншу Чимала применил аналогичный рабочий процесс для создания The Long Silence — процедурной браузерной космической игры-исследования, построенной с использованием Claude Opus 5.

В описании публичного репозитория указано, что игра использует WebGL2, браузерный рендеринг в стиле Three.js и пользовательский GLSL.
Также применяется процедурная генерация контента на основе сида вместо загрузки традиционных библиотек ассетов.
В исходной статье описан процесс разработки продолжительностью около 24 часов, разделённый на три основных этапа.
Первым запросом было создание космической игры-исследования с использованием Three.js.
Требования были намеренно сформулированы на высоком уровне:
Большая часть построения мира и технической архитектуры была оставлена на усмотрение агента.
Это следует ключевому принципу данного подхода:
Определяй конечную точку, а не маршрут.
В исходной статье также упоминается, что Claude Code в процессе работы подключался к инструментам, связанным с Blender. В публичном репозитории содержится каталог навыков Claude для моделирования твёрдотельных поверхностей в Blender, что подтверждает — переиспользуемые инструкции для Blender стали частью проекта.
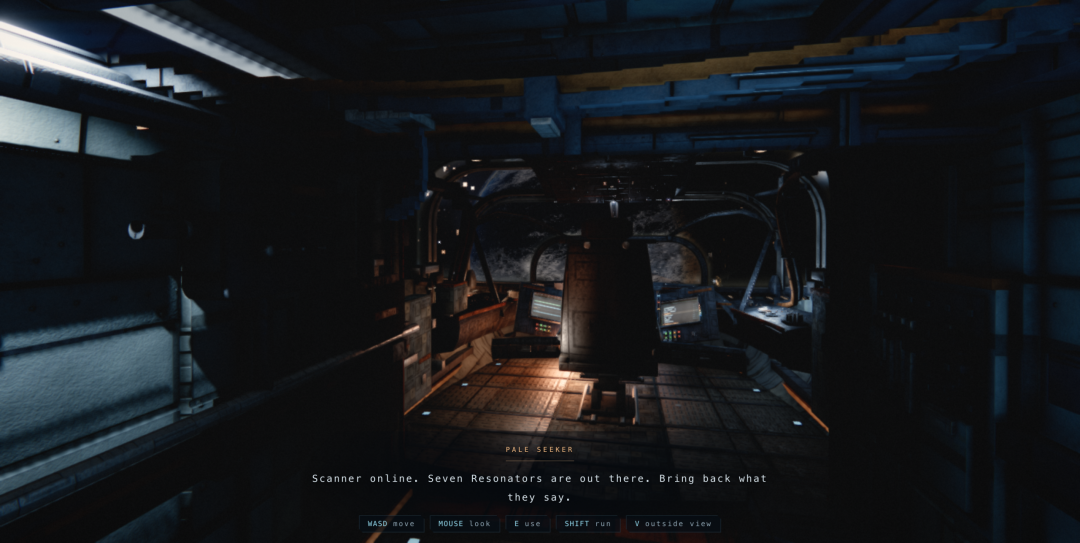
После завершения первой играбельной версии проект перешёл в длительную фазу визуальной доработки.
Несколько субагентов занимались разными областями, в то время как один агент-рецензент сравнивал скриншоты с эталонными изображениями качественных космических игр.
Суть заключалась не в том, чтобы просто сказать Opus 5 «сделай игру красивее». Агент-рецензент должен был выявлять видимые различия и отправлять слабые места на повторную итерацию.
В исходной статье упоминается, что такие работы, как Starfield, использовались в качестве ориентира качества.
Длинный цикл также требует условий остановки. Полезные точки остановки включают:
Цикл является механизмом давления, а не гарантией того, что результат в конечном итоге станет «идеальным».
Процесс не был полностью автоматическим.
Согласно исходной статье, Чимала удалённо контролировал прогресс и вмешивался, когда агент уделял слишком много внимания одной области.
После завершения длительного цикла были использованы дополнительные сеансы Claude для:
Затем модель попросили обобщить переиспользуемый опыт в виде навыка.
В публичном репозитории содержится:
.claude/skills/blender-hardsurface
Это полезный шаблон для длительных агентских задач. Проект может производить не только артефакты, но и накапливать переиспользуемые практические знания: какие инструменты работают, какие тесты важны, что не сработало и как следует структурировать будущие задачи.
Одной из самых заметных частей публичного репозитория является
набор инструментов валидации.
В README задокументированы следующие команды:
node tools/play.mjs
node tools/survey.mjs
node tools/probe.mjs "" --shot out.png
node tools/sheet.mjs a.png b.png --out s.png
node tools/levels.mjs shots/*.png
node tools/judgeset.mjs
Документированные назначения этих команд:
play.mjs: 17 интерактивных проверок, охватывающих полёт, сканирование, складывание и прыжки;survey.mjs: скриншоты основных сцен и отчёт о производительности;probe.mjs: однократное выполнение выражения в браузере и один скриншот;sheet.mjs: контактный лист миниатюр для визуального сравнения;levels.mjs: статистика по тону и экспозиции;judgeset.mjs: пересоздание набора для визуальной рецензии.
Ключевой момент: агент создал не только саму игру, но и механизмы для её оценки.
Именно поэтому долго работающий агент способен улучшать результат надёжнее, чем простой конвейер «сгенерировал — остановился».
В README задокументирован ряд практических графических решений:
В репозитории также указано, что проверка в браузере выполнялась на реальном экземпляре Chromium с включённой GPU-растеризацией.
Эти детали важны, поскольку они показывают, как модель справляется с привычными инженерными ограничениями: производительность, точность, воспроизводимость, поведение браузера и визуальное качество.
«The Long Silence» доступна для игры в браузере.
В репозитории представлены стандартные команды разработки:
npm install
npm run dev
npm run build
Игра включает космический полёт, сканирование, процедурные среды, навигацию, исследовательские цели и несколько интерфейсных систем.
Это делает её чем-то большим, чем статичная модель.
Но это всё ещё не коммерческая AAA-игра, над которой крупная студия работает годами.
Производство AAA-уровня обычно требует больших команд, отвечающих за:
Более обоснованный вывод: один разработчик сегодня может оркестрировать передовые кодирующие агенты и создавать визуально амбициозные, технически нетривиальные играбельные прототипы со скоростью, которая раньше не была практически возможна.
Сообщество разработчиков начало переиспользовать этот паттерн
После того как Shumer опубликовал промпт и код, этот рабочий процесс быстро распространился.
Райан Кэмпбелл применил схожий подход
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Циклически продвигая браузерный картинг-проект, постоянно итерируя рендеринг, управление, поведение камеры и производительность на мобильных устройствах.
Опубликованный Shumer каталог Gauntlet Loop позже продемонстрировал гоночный эксперимент, созданный этим методом и доступный для игры в браузере.
Дизайнер Йоги Сурия поделился проектом на Three.js в стиле киберпанк, вдохновлённым тем же промпт-паттерном.
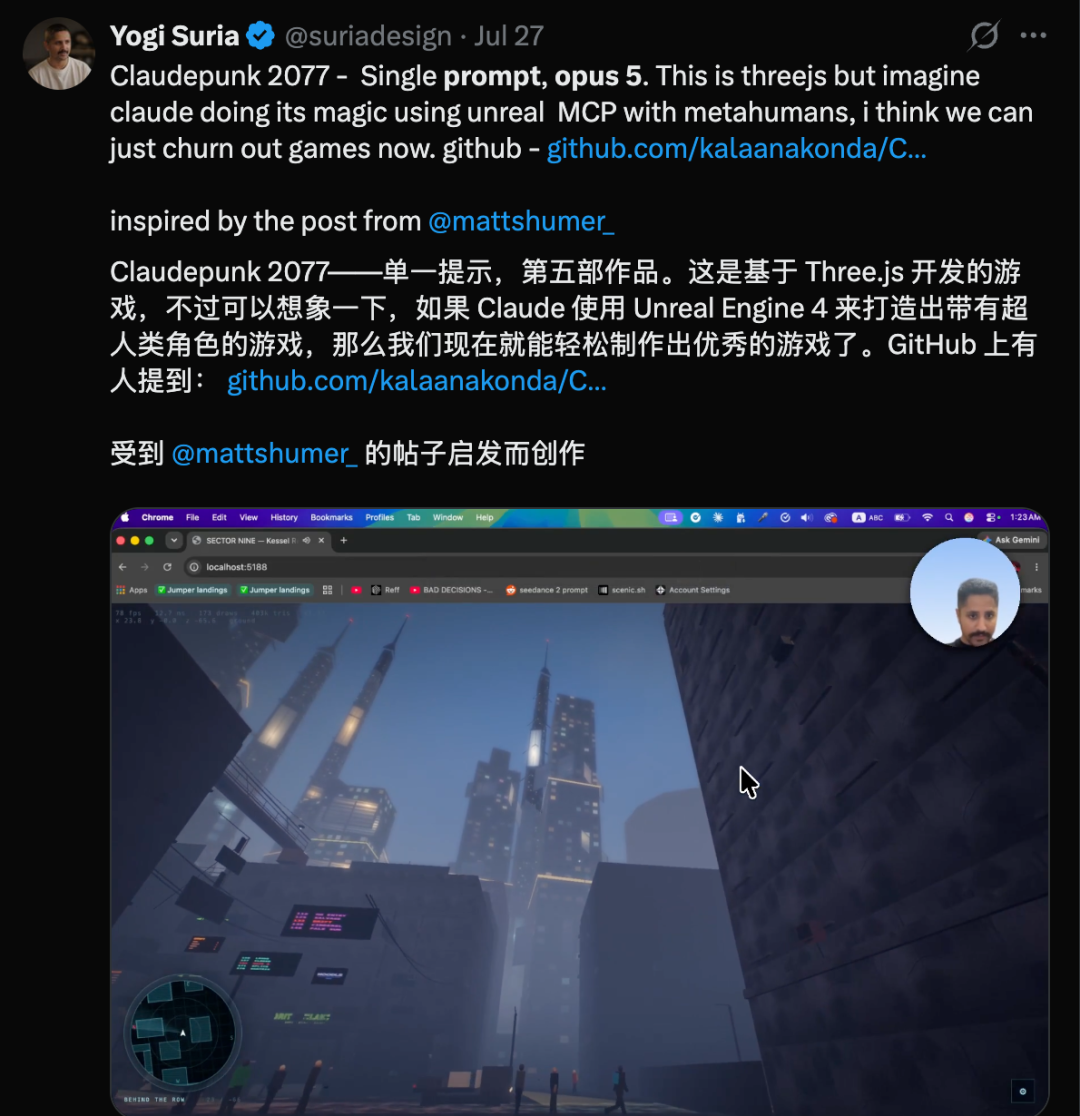
Этот пример показывает, что метод не ограничивается одним игровым жанром. Референтная цель, художественное направление и набор инструментов могут меняться, а структура «создавай — критикуй — повторяй» остаётся неизменной.
Источник также показал процесс, в котором разработчик использовал GPT-5.6 Sol в Codex для аналогичного промпта.
Разработчик сообщил, что время сборки составило около двух часов, и охарактеризовал результат как неплохой, но не такой отточенный, как демонстрация Shumer.
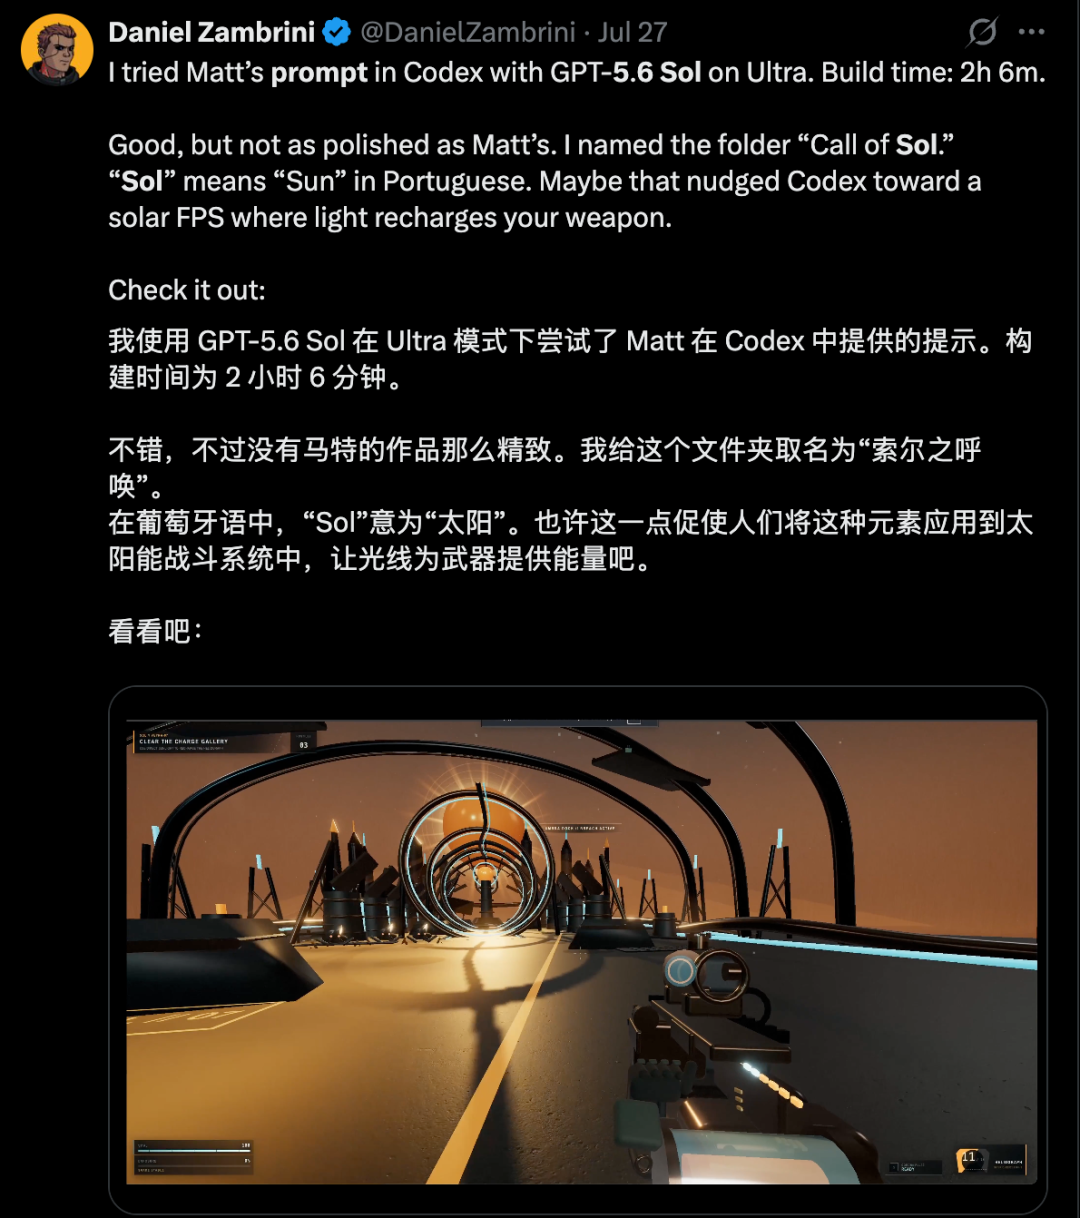
Это показывает, что Gauntlet Loop по своей сути не является эксклюзивным для Claude.
Паттерн опирается на агентную среду, способную:
Разные модели могут показывать разные результаты внутри цикла, но архитектура переносима.
Традиционный генеративный процесс обычно выглядит так:
Пользователь → Модель → Результат → Пользователь
Gauntlet Loop добавляет уровень оценки:
Пользователь
  ↓
Главный агент
  ↓
Строитель
  ↓
Артефакт
  ↓
Независимый критик
  ↓
Измерение разрыва
  ↓
Пересмотр строителем
  ↓
Новый артефакт
Это создаёт больше возможностей выявить некачественные результаты до их сдачи.
Слова «страница теперь должна быть адаптивной» менее убедительны, чем открыть страницу на мобильной ширине и действительно проверить.
«Игра должна быть быстрее» менее убедительно, чем измерить время кадра.
«Рендер стал лучше» менее убедительно, чем сравнить скриншоты.
Лучшие сигналы обратной связи укоренены в реальных артефактах.
Строитель помнит каждый компромисс, на который он пошёл.
Это может исказить оценку.
Независимый критик может задать более простой вопрос: действительно ли результат соответствует стандарту?
Это отражает человеческие рабочие процессы. Разработчики используют тесты и ревью кода. Дизайнеры используют визуальные ревью и пользовательское тестирование. Писатели используют редактуру.
ИИ-агенты могут воспроизводить это разделение с гораздо большей частотой.
Anthropic выпустила Claude Opus 5 24 июля 2026 года.
В официальных материалах
о выпуске подчёркивается более высокая производительность в кодинге, длительных многошаговых задачах, проверке и итерациях.
Anthropic особо отметила, что Opus 5 лучше справляется со следующими задачами:
Эти поведения идеально согласуются с Gauntlet Loop.
Этот промпт не наделяет модель новыми способностями. Он создаёт структуру, которая снова и снова заставляет модель использовать уже имеющиеся у неё возможности.
Anthropic также сообщила, что Opus 5 эффективнее Opus 4.8 при той же базовой цене: 5 долларов за миллион входных токенов и 25 долларов за миллион выходных токенов.
Длительно работающие агенты по-прежнему могут сталкиваться с такими проблемами, как:
Поэтому контрольные точки с участием человека остаются полезными.
Самый сильный рабочий процесс — это не «больше никогда не смотреть на агента», а «позволить агенту работать дольше между двумя ценными вмешательствами человека».
Этот метод можно распространить и на другие сферы, помимо игр.
Опишите желаемый результат, а не предписывайте каждую деталь реализации.
Создайте отточенную браузерную космическую игру-исследование с плавным управлением,
яркой визуальной атмосферой и стабильной производительностью.
Используйте то, что рецензент может проверить.
Для визуальных работ:
Сравните освещение, глубину, композицию и уровень проработки интерфейса с набором избранных качественных скриншотов коммерческих игр.
Для программного обеспечения используйте тесты, бенчмарки или эталонные реализации.
Агент может разделить задачу на компоненты, например:
Для важных компонентов используйте:
Критик должен указывать на самый большой устранимый разрыв, а не выдавать длинный список расплывчатых претензий.
Продолжайте итерации до тех пор, пока качество, бюджет или время не достигнут точки остановки.
Параллельные агенты могут создавать локально хорошие, но глобально несогласованные результаты.
Финальный интеграционный агент может проверять:
Сохраняйте полезные части процесса в виде:
Последующие запуски должны начинаться с учёта предыдущего опыта.
Gauntlet Loop наиболее эффективен, когда качество можно многократно измерять.
Хорошие кандидаты включают:
Но паттерн работает хуже, когда у критика нет надёжных сигналов.
Критик без скриншотов, тестов,
бенчмарков, референсных материалов или реальной пользовательской обратной связи может просто создать ещё одно «мнение» модели.
Многоагентные рабочие процессы, работающие в течение длительного времени, могут потреблять значительные вычислительные ресурсы.
Каждый раунд проверки может включать:
Практические средства контроля бюджета включают:
Строгий критик может повысить качество, но он также может заставить систему работать дольше, когда дальнейшие улучшения уже нецелесообразны.
Gauntlet Loop — это метод подсказок для мультиагентов, популяризированный Мэттом Шумером. Ведущий агент разбивает цель на более мелкие задачи, агент-конструктор отвечает за создание результатов, а независимый агент-критик сравнивает фактический вывод с конкретным эталоном; результаты, не соответствующие требованиям, отправляются на доработку.
По словам Шумера, проект начинался с подсказки высокого уровня, но он не был сгенерирован за один ответ модели. Затем Claude Code работал в течение нескольких часов, порождая субагентов, написав около 55 000 строк кода, используя инструменты, проверяя результаты и выполняя итерации.
Нет. Эти демонстрации — технически впечатляющие браузерные игры и прототипы, но они не эквивалентны коммерческим 3A-проектам. Сам репозиторий Claude of Duty указывает на то, что конечный результат несопоставим с современными играми Call of Duty, которые служили эталоном качества.
The Long Silence — это браузерная процедурно генерируемая космическая игра от Аншу Чималы. В её публичном репозитории указано, что она создана с использованием Claude Opus 5 и включает пользовательский рендеринг, процедурно генерируемый контент и инструменты проверки на основе браузера.
Новый критик вряд ли будет защищать решения по реализации, принятые конструктором. Он может изучить фактический результат и сравнить его с тестами, скриншотами, бенчмарками или эталонными примерами, прежде чем запросить повторную доработку.
Нет. Такая архитектура может применяться к другим кодирующим агентам, поддерживающим инструменты, редактирование файлов, выполнение кода, визуальную проверку и повторяющуюся работу. В исходном тексте приведён пример с GPT-5.6 Sol и Codex.
Полный рабочий процесс требует среды выполнения агента, а не обычного чат-интерфейса. Claude Code — один из вариантов, поскольку он может работать с файлами, запускать команды, подключать инструменты и координировать длительные задачи по написанию кода.
Когда стандарты качества размыты или неизмеримы, длительные циклы могут тратить время и вычислительные ресурсы. Человек-владелец по-прежнему должен устанавливать бюджет, проверять прогресс, при необходимости перенастраивать приоритеты и решать, когда дальнейшие итерации теряют смысл.
Описывает возможности Opus 5 в кодировании, проверке, итерациях и задачах с длинным циклом.
Громкие игровые эксперименты на Opus 5 следует понимать скорее как демонстрацию рабочего процесса, а не как волшебную «одну генерацию». Gauntlet Loop сочетает декомпозицию задач, экспертных конструкторов, независимых критиков, конкретные стандарты качества и повторяющиеся итерации.
The Long Silence показывает, чего эта модель может достичь в агентном проекте длительностью около одного дня. Его публичный репозиторий включает не только играбельную игру, но и скрипты проверки, инструменты создания скриншотов, интерактивные утверждения и переиспользуемые агентные инструкции.
Этот метод по-прежнему зависит от человеческого суждения, вычислительных бюджетов, качественных эталонов и агентной рабочей станции. Он не означает, что браузерные прототипы могут сравниться со студийными 3A-играми.
Настоящий сдвиг в том, что цель высокого уровня теперь может запустить долгосрочный цикл «создание — измерение — критика — улучшение», выполняя гораздо больше работы до того, как потребуется вмешательство человека.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



