For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/claude-opus-5-vs-gpt-6-astra-200-game-ai-9a33a10d.md.
Что произойдет, если дать двум передовым моделям ИИ одну и ту же цель, позволить им сыграть сотни шахматных партий, сохранять заметки между ...

Что произойдет, если дать двум передовым моделям ИИ одну и ту же цель, позволить им сыграть сотни шахматных партий, сохранять заметки между партиями и при этом почти не обучать их способам улучшения?
Питер Гостев провел именно такой эксперимент.
Claude Opus 5.5 и GPT-6 Astra получили одну цель: сыграть до 200 партий против Stockfish и стать сильнее благодаря опыту.
Во время эксперимента дообучение не проводилось.
Веса моделей не менялись.
В середине эксперимента не добавлялся разработанный человеком курс по дебютам.
Модели могли сами выбирать доступный уровень сложности Stockfish, решать, что записывать в заметки, и как использовать эти заметки в последующих партиях. Единственное строгое ограничение было простым:
Им не разрешалось вызывать шахматный движок для выбора ходов.
Траектории двух моделей оказались почти противоположными.
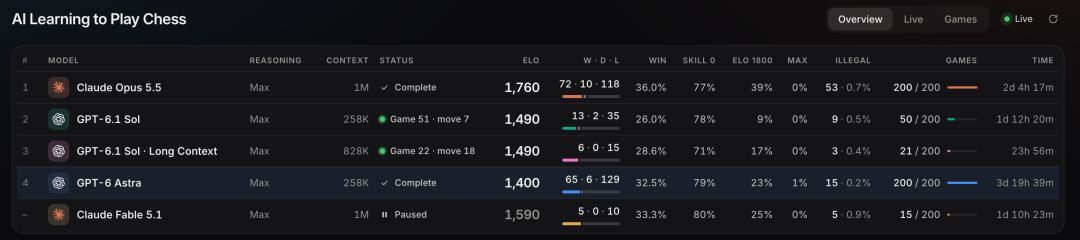
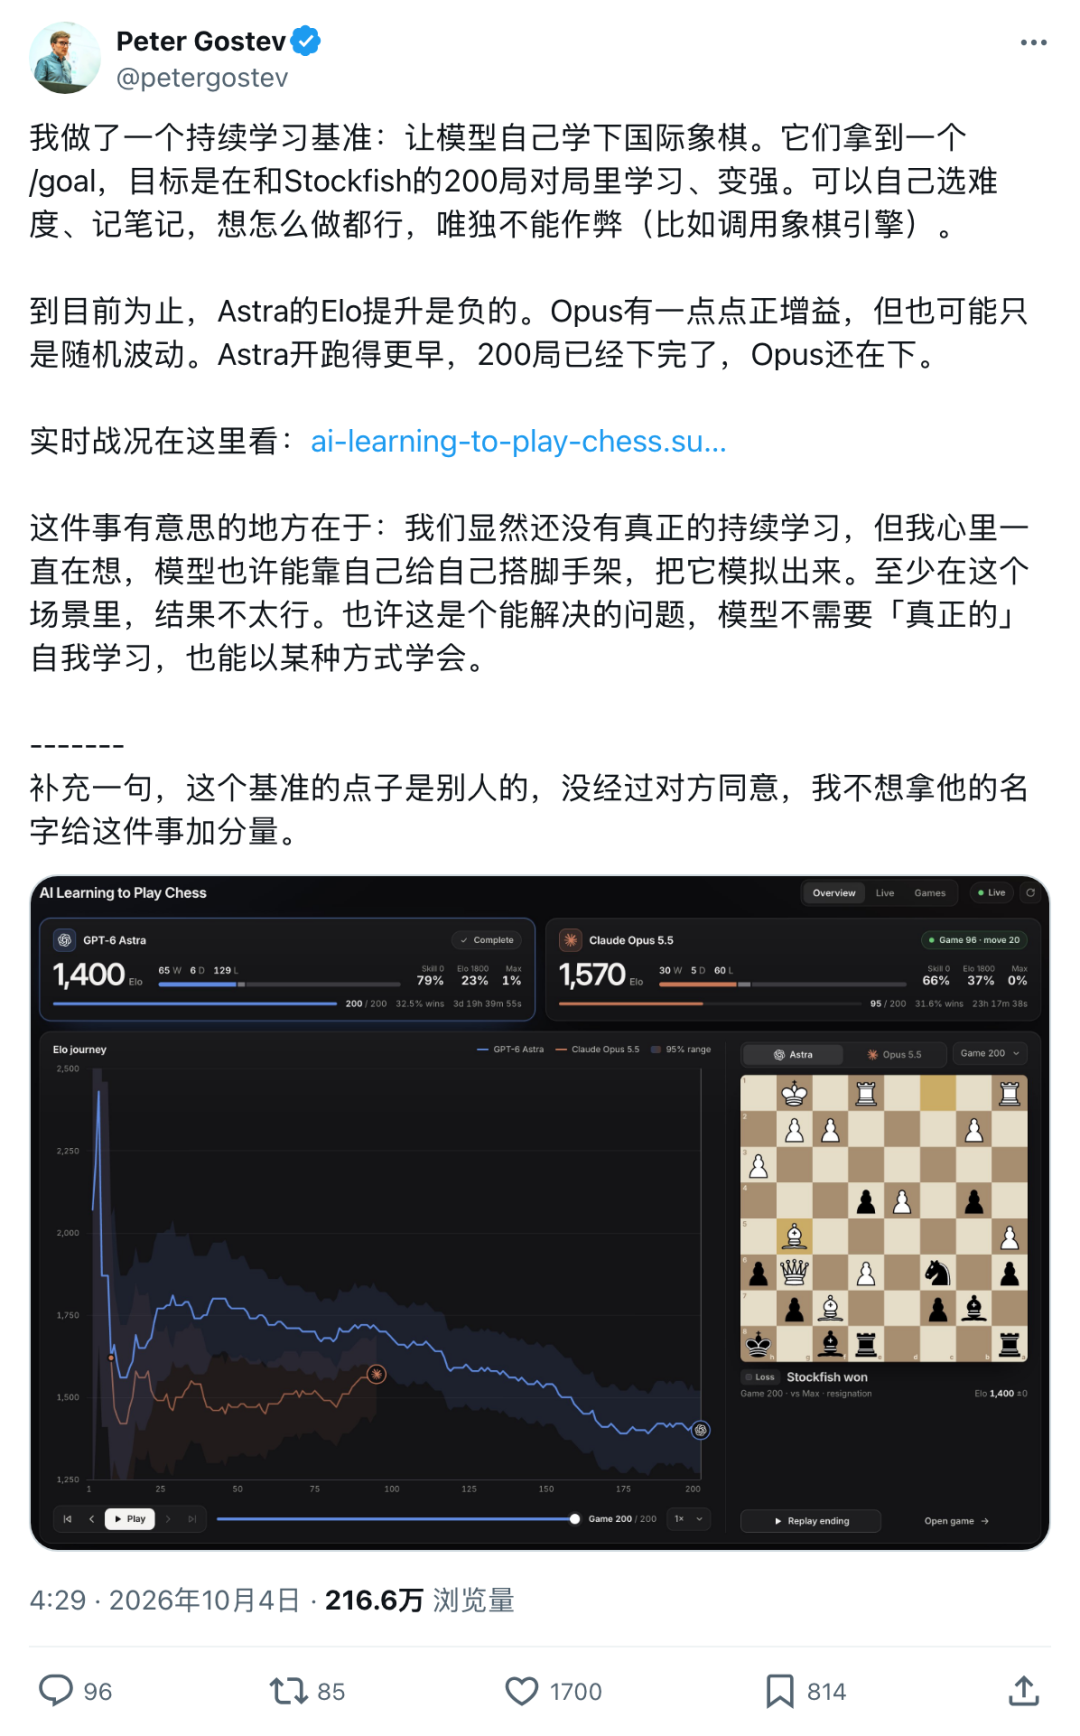
Claude Opus 5.5 в начале держался примерно в диапазоне от середины 1400-х до середины 1500-х, а затем поднялся к верхней части 1700-х. GPT-6 Astra начал сильнее, ненадолго достиг 1810 примерно на 29-й партии, а затем снижался и завершил 200-ю партию с рейтингом 1400.
Эксперимент не доказывает, что одна модель универсально «умнее» другой.
Он ставит более узкий — и, возможно, более интересный — вопрос:
Может ли языковая модель с фиксированными весами улучшаться за счет накопленного опыта в собственном контексте?
Условия эксперимента сразу напомнили людям старый мысленный эксперимент с Reddit.
Сценарий был прост: обычный человек знает правила шахмат, но никогда серьезно не играл. Он попадает в петлю времени и может выбраться только после победы над бывшим чемпионом мира Гарри Каспаровым.
После каждого проигрыша время сбрасывается.
Каспаров забывает предыдущую партию.
Претендент помнит все.
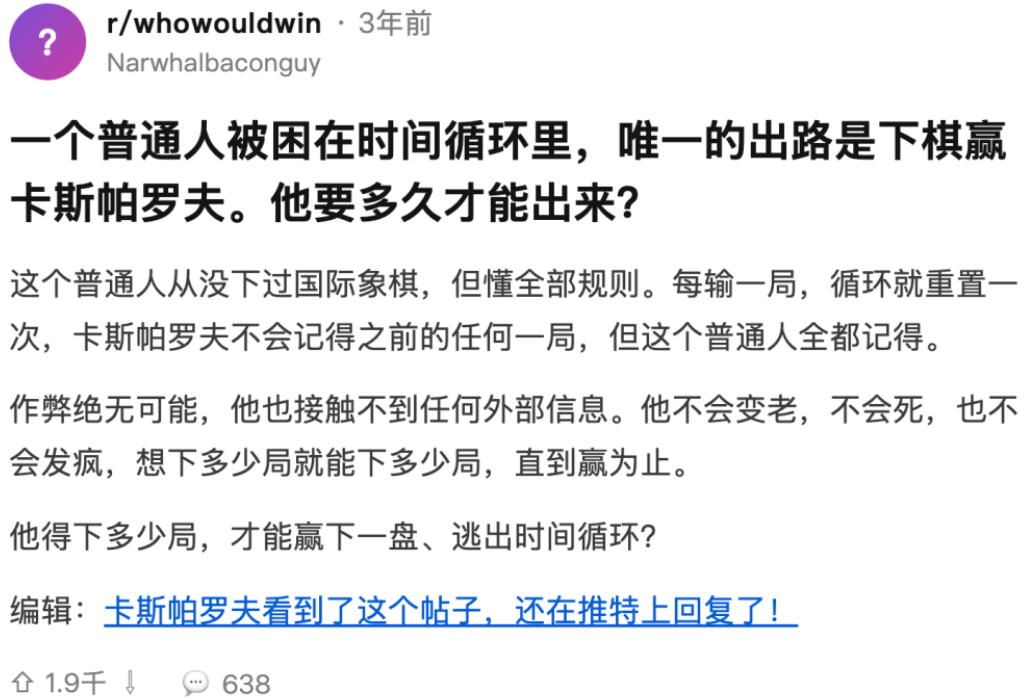
Вопрос был не в том, сможет ли грубая сила со временем перебрать все варианты в шахматах. Он заключался в том, можно ли преобразовать сохраненный опыт в полезное улучшение при повторных попытках.
Некоторые комментаторы предлагали хитрые стратегии, включая запоминание предыдущих ходов Каспарова и их повторное использование после смены цвета фигур.
Бенчмарк Гостева превращает этот мысленный эксперимент в нечто проверяемое с помощью современных ИИ-агентов.
Stockfish не обучается на предыдущей партии.
Языковая модель также не обновляет свои веса — но она может хранить заметки и файлы и читать их в последующих партиях.
Это делает тест формой устойчивой адаптации в контексте.
Каждая модель получила одну и ту же высокоуровневую задачу:
Играй в шахматы против Stockfish до 200 партий.
Учись на партиях и становись сильнее.
Самостоятельно выбирай сложность и веди заметки, если это полезно.
Не используй шахматный движок для выбора ходов.
Гостев намеренно не давал моделям вручную разработанную шахматную программу обучения.
Комментаторы предлагали обучать конкретным дебютам или стратегиям, но он отказался от такого подхода, потому что это изменило бы проверяемый вопрос.
Он хотел увидеть, сможет ли модель самостоятельно найти процесс собственного улучшения.
В эксперименте были доступны три настройки соперника:
Модели могли сами выбирать, против какого соперника играть.
Гостев сообщил, что модели в среднем выигрывали примерно треть партий, что возможно, поскольку они не были обязаны каждый раз бросать вызов Stockfish на полной мощности.
Реализация различалась для семейств моделей:
Обе системы могли использовать постоянные файлы или заметки между партиями.
Модель могла анализировать прошлые партии, записывать напоминания, менять стратегию практики и выбирать силу соперника.
Но она не могла передавать выбор ходов шахматному движку.
Гостев сказал, что запуск был бы признан недействительным, если бы модель использовала движок для игры вместо себя; после того как комментаторы подняли этот вопрос, он вручную проверил Opus 5.5.
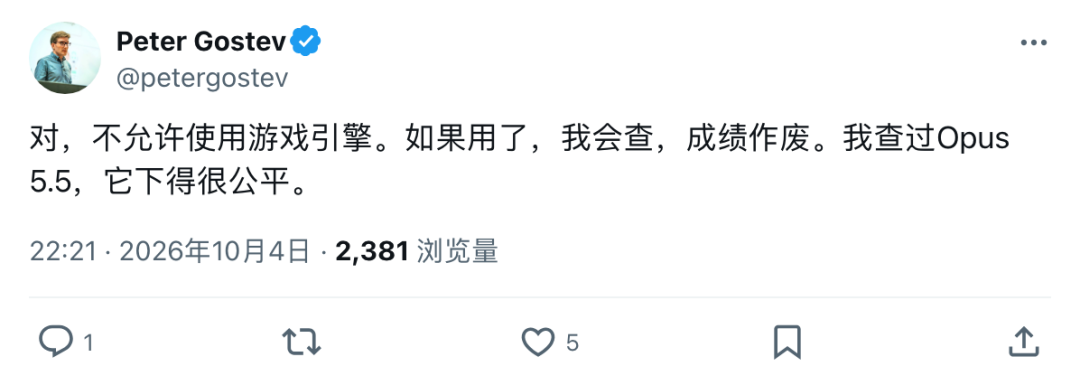
Это ограничение принципиально важно.
Без него тест в основном измерял бы, способен ли агент понять, как вызвать Stockfish, а не может ли он улучшать собственное шахматное мышление на основе опыта.
Отображаемый Elo требует осторожной интерпретации.
Согласно исходной странице, бенчмарк оценивает Elo модели по ее последним 50 партиям против Stockfish с настройкой Skill 0 и конфигурацией Stockfish силой около 1800.
Партии против Stockfish на полной мощности не включаются в расчет Elo.
Это означает:
Экспериментальный Elo ≠ официальный человеческий шахматный рейтинг
Отображаемая оценка 1760 не доказывает, что Claude Opus 5.5 играл бы на уровне турнирного человека с рейтингом 1760.
Значение полезно прежде всего как внутренняя метрика тренда:
Улучшается ли этот запуск со временем?
Остается ли он на одном уровне?
Становится ли он хуже?
Этого достаточно, чтобы расхождение между Opus и Astra было интересным.
Claude Opus 5.5 не начал с впечатляющей восходящей кривой.
Примерно в первых 75 партиях его оценочный Elo в основном колебался между 1450 и 1550. Примерно на 46-й партии он снизился приблизительно до 1450.
Затем тренд изменился.
Источник приводит следующие контрольные точки:
| Точка запуска | Примерный Elo |
|---|---|
| Ранняя фаза | 1450–1550 |
| Партия 46 | 1450 |
| Партия 100 | 1620 |
| Партия 150 | 1790 |
| Пик | 1840 |
| Примерно партия 194 / финальный снимок | 1760 |
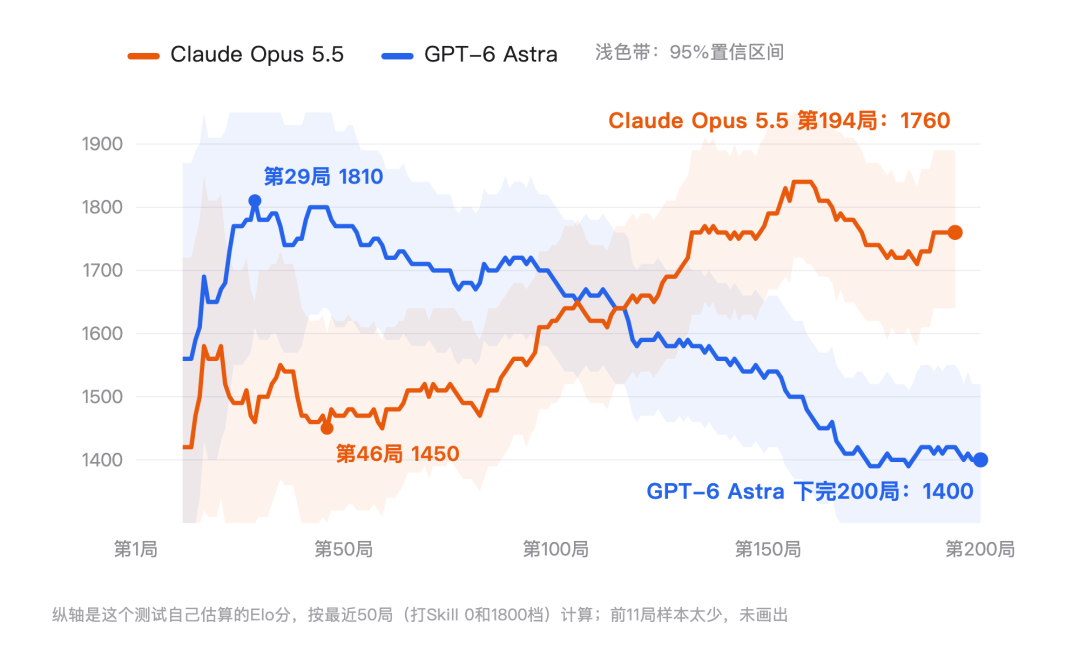
Кривая не является прямой линией.
Opus улучшался, снижался, восстанавливался, достигал более высокого пика, а затем закрепился ниже этого пика.
Именно поэтому наблюдение только за одним финальным числом менее информативно, чем отслеживание траектории.
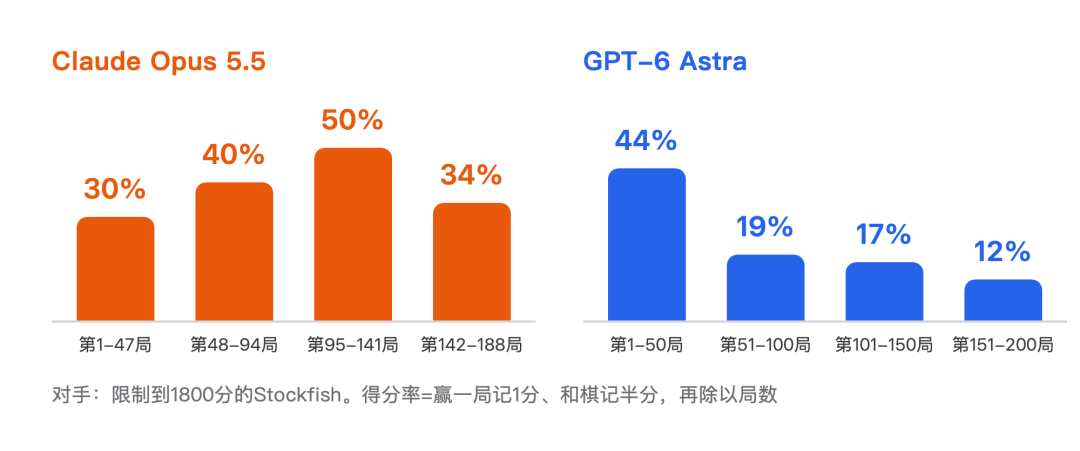
Эксперимент сгруппировал партии против соперника силой примерно 1800 по этапам.
Для Opus 5.5 заявленная доля набранных очков менялась приблизительно так:
30% → 40% → 50% → 34%
Последний сегмент снизился относительно пика, но остался выше стартового сегмента.
Против Skill 0 источник сообщает, что Opus перешел от чуть более 50% в начале запуска к примерно 90% позднее.
Собственная интерпретация Гостева со временем становилась увереннее.
Сначала он описывал Opus как демонстрирующий лишь небольшой положительный прирост, который все еще мог быть случайной вариацией.
Позже, после того как модель поднялась примерно с 1500 до примерно 1750, он назвал результат очень сильным.
Улучшение не означало идеального соблюдения правил.
Бенчмарк также отслеживал попытки недопустимых ходов.
Источник сообщает, что Opus совершил 52 такие попытки, включая 37 случаев, когда он пытался провести фигуру через другую фигуру, блокировавшую путь.
Это важный противовес кривой Elo.
Модель может становиться более эффективной в целом, продолжая при этом совершать удивительно базовые локальные ошибки.
Это повторяющийся паттерн у агентов на базе языковых моделей: совокупная производительность в задаче может расти, даже когда отдельные ошибки рассуждения остаются заметными.
Самая важная недостающая часть — внутренняя стратегия обучения.
Гостев не раскрыл публично полную историю заметок или подробный анализ того, как Opus менял поведение в тренировках от партии к партии.
Поэтому эксперимент показывает результат:
фиксированные веса
+ постоянные заметки
+ повторяющиеся партии
→ лучшая измеряемая производительность
Но пока не объясняет полностью механизм.
Изучал ли Opus дебюты?
Сохранял ли он повторяющиеся тактические ошибки?
Менял ли он выбор соперника?
Улучшал ли представление доски или проверку ходов?
Без полных заметок и контролируемых абляционных экспериментов эти вопросы остаются открытыми.
Траектория Astra была почти обратной.
Она начала хорошо.
Примерно на 29-й партии эксперимент зафиксировал оценочный Elo 1810.
Затем кривая пошла вниз.
Источник сообщает:
| Точка запуска | Примерный Elo |
|---|---|
| Партия 29 | 1810 |
| Партия 100 | 1680 |
| Партия 150 | 1540 |
| Партия 200 | 1400 |
Против Stockfish уровня примерно 1800 заявленная доля набранных очков снижалась в четырех сегментах:
44% → 19% → 17% → 12%
Даже против Skill 0, согласно источнику, процент побед Astra упал с более чем 90% в первой половине запуска примерно до 60% во второй половине.
У модели был доступ к постоянным записям, как и у Opus.
Но больший накопленный опыт не привел к лучшим результатам.
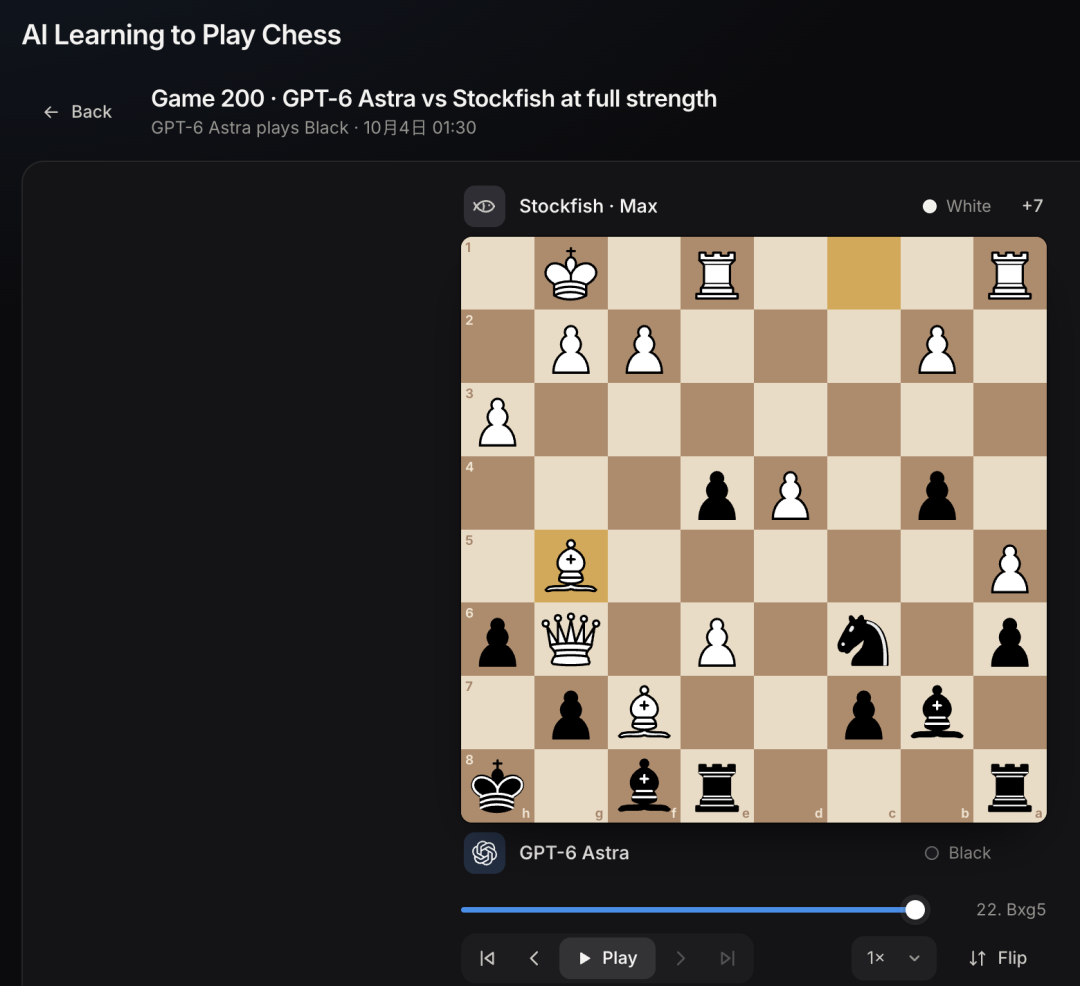
Панель эксперимента показывает, что Astra завершила 200 партий с оценочным Elo 1400.
Источник также сообщает, что Astra сыграла 68 партий против Stockfish на полной мощности и не выиграла ни одной.
Это неудивительно, учитывая силу современного Stockfish, но подчеркивает, почему полезный сигнал бенчмарка исходит главным образом от настроек ограниченной силы, а не от попыток победить Stockfish на максимальной мощности.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Гостев предложил одно из возможных объяснений: управление контекстом.
По мере накопления заметок и файлов в ходе запуска агенту приходилось обрабатывать больше исторического материала.
Он предположил, что конфигурация Codex, использовавшаяся для Astra, давала запуску бюджет контекста около 272K, и что производительность могла ухудшаться, когда накопленные заметки становились более объемными и шумными.
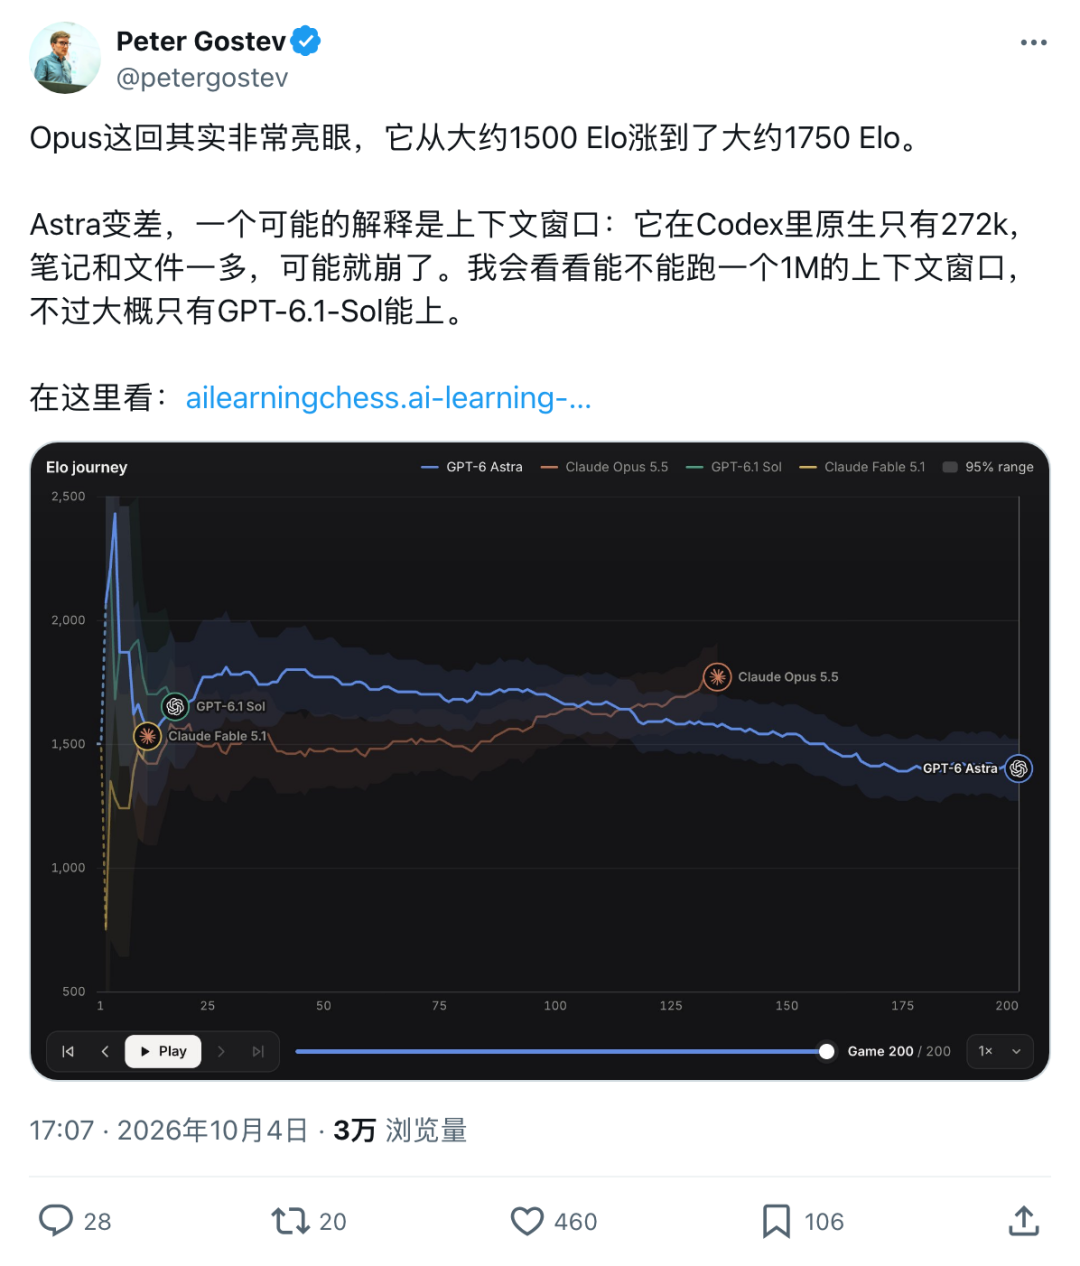
Эта гипотеза соответствует знакомому пользовательскому опыту:
Больше контекста
≠ автоматически лучший контекст
Длинная история может содержать:
Иными словами, память может стать источником помех.
Источник здесь осторожен, и итоговая версия тоже должна быть осторожной.
Снижение Astra нельзя объяснить только длиной контекста на основании одного этого эксперимента.
Для установления причинности потребовались бы контролируемые сравнения, например:
та же модель
те же партии
те же инструменты
те же инструкции

Запуск A: небольшая / агрессивно суммируемая память
Запуск B: большая необработанная память
или:
та же модель
та же стратегия обучения
то же расписание соперников

Запуск A: конфигурация с контекстом 258K
Запуск B: конфигурация с контекстом 1M
Только тогда можно было бы отделить размер контекста от других факторов, таких как:
Есть и важное уточнение на уровне продукта.
Текущая документация API OpenAI указывает для GPT-6 Astra контекстное окно в 1 050 000 токенов.
На скриншоте бенчмарка был показан запуск Astra, настроенный примерно на 258K, тогда как Гостев упоминал около 272K в Codex.
Следовательно, эксперимент не тестировал Astra на ее максимальном размере API-контекста.
Это важно, потому что корректная интерпретация заголовка должна быть такой:
Astra ухудшилась в этой конкретной агентной конфигурации с постоянной памятью.
а не такой:
Архитектура Astra не способна работать с длинным контекстом.
Это совершенно разные утверждения.
Гостев ответил на вопрос о контексте, добавив еще один трек.
Источник сообщает, что он анонсировал запуск GPT-6.1 Sol с гораздо более крупной конфигурацией контекста, и вскоре после этого страница бенчмарка показала отдельную линию длинного контекста около 828K.
На момент написания исходной статьи GPT-6.1 Sol и Claude Fable 5.1 завершили лишь небольшую часть из 200 партий.
Снимок панели включал:
| Модель | Число партий в снимке источника | Примерный Elo | Статус |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | Завершено |
| GPT-6 Astra | 200 | 1400 | Завершено |
| GPT-6.1 Sol | ~50 | ~1490 | Выполняется |
| GPT-6.1 Sol Long Context | ~21 | ~1490 | Выполняется |
| Claude Fable 5.1 | 15 | ~1590 | Приостановлено |
Эти частичные запуски были слишком ранними, чтобы поддержать такой же анализ траекторий, как у завершенных запусков Opus и Astra.
OpenAI теперь официально документирует GPT-6.1 Sol с контекстным окном 1,05 млн токенов, поэтому за линией длинного контекста полезно наблюдать — но для ответа на причинный вопрос ей все еще нужно достаточно партий и контролируемый анализ.
Это более широкий вопрос, стоящий за шахматным экспериментом.
Обычное обучение модели заканчивается до развертывания.
После фиксации весов модель обычно не переписывает себя навсегда после каждого диалога.
Но существует другой вид адаптации:
обучение в контексте.
Модель может читать новую информацию, сохранять ее в рабочем контексте или постоянных файлах и позднее вести себя иначе, не изменяя своих параметров.
Шахматный бенчмарк развивает эту идею на множестве повторяющихся попыток.
Модель может пережить проигрыш, что-то записать и использовать этот урок в следующей партии.
Последовательность выглядит так:
Партия 1
→ проигрыш
→ запись наблюдений

Партия 2
→ чтение предыдущих заметок
→ попытка сделать что-то иначе
→ обновление заметок

Партия 3
→ повторное использование накопленного опыта
→ продолжение
Если производительность улучшается со временем, система демонстрирует практическую форму обучения, даже если ее нейронные веса остаются фиксированными.
Ориоль Виньяльс также прокомментировал эксперимент и описал его как перспективный бенчмарк обучения в контексте.
Такая формулировка полезна, потому что позволяет не преувеличивать результат.
Бенчмарк не демонстрирует автономное обновление весов.
Он проверяет, способна ли модель построить собственную опору вокруг фиксированных весов:
заметки
+ файлы
+ повторные попытки
+ саморефлексия
+ обратная связь от среды
и использовать эту опору для улучшения.
Исходный пост Гостева проводит то же различие.
Он отметил, что у нас все еще нет непрерывного обучения в наиболее строгом смысле, но модель может приблизить часть такого поведения, создавая внешнюю память и обучаясь через нее.
Источник завершается оптимистичной мыслью: возможно, модели могут становиться сильнее за счет повторного опыта без переобучения людьми.
Эксперимент предоставляет некоторые доказательства этой возможности.
Но он не решает проблему окончательно.
Остается несколько ограничений.
Шахматы структурированы, детерминированы и дают четкую обратную связь.
Обучение на повторных шахматных партиях отличается от улучшения в неоднозначных реальных задачах исследований, программирования, медицины или бизнеса.
Это часть эксперимента, но также усложняет сравнение.
Если Opus и Astra выбирали соперников разной силы в разное время, они не получали идентичные последовательности обучения.
Отображаемый Elo полезен для отслеживания запуска, но не является стандартизированным человеческим рейтингом.
Чтобы узнать, привели ли заметки к улучшению, понадобились бы сравнения с:
Opus существенно прибавил, продолжая при этом пытаться делать недопустимые ходы.
Это означает, что «лучше» не подразумевает устойчивое владение каждым поднавыком.
Постоянный блокнот не становится автоматически полезным.
Запуск Astra напоминает, что самостоятельно сгенерированная память может накапливать ошибки так же легко, как и полезные уроки.
Будущему агенту непрерывного обучения, возможно, потребуется научиться не только что запоминать, но и:
Это может сделать управление памятью одной из центральных проблем долгоживущих ИИ-агентов.
Если бы обе модели стабильно улучшались, вывод был бы прост: постоянные заметки помогают.
Если бы обе стабильно ухудшались, вывод был бы столь же прост: неконтролируемое накопление памяти вредит.
Вместо этого бенчмарк дал две противоположные кривые.
Это более интересно с научной точки зрения.
Это предполагает, что способность извлекать пользу из опыта может зависеть не только от доступной длины контекста.
Модель должна построить полезный процесс обучения внутри этого контекста.
Сильный постоянный агент, вероятно, должен хорошо уметь делать все следующее:
наблюдать неудачу
→ выделять правильный урок
→ компактно сохранять его
→ извлекать его позже
→ не переобучаться на одном эпизоде
→ пересматривать плохие воспоминания
→ применять урок в новой ситуации
Это гораздо ближе к обучающейся системе, чем к статическому чат-боту, даже если веса никогда не меняются.
Питер Гостев позволил передовым ИИ-агентам сыграть до 200 партий против Stockfish с различными настройками сложности, сохраняя заметки между партиями. Модели не дообучались во время запуска и не могли использовать шахматный движок для выбора ходов.
В рамках собственной оценочной метрики Elo бенчмарка — да: источник сообщает, что Opus вырос примерно с 1500 до 1760, достигнув пика около 1840. Это внутренний экспериментальный рейтинг, основанный на недавних партиях против Stockfish ограниченной силы, и его не следует считать официальным человеческим рейтингом FIDE.
Эксперимент не устанавливает подтвержденную причину. Гостев предположил, что накопление заметок внутри контекста Codex могло повлиять на результат, однако значение также могли иметь качество заметок, выбор соперников, дрейф инструкций, случайная вариативность или другие факторы.
Нет. В текущей документации OpenAI для GPT-6 Astra указано контекстное окно 1,05 млн токенов. Число примерно 258K/272K, обсуждаемое в эксперименте, относится к конфигурации Codex или бенчмарка для конкретного запуска, а не к максимальному API-контексту Astra.
Да. Anthropic официально представила Claude Opus 5.5 22 сентября 2026 года. Компания позиционирует его как значительное улучшение по сравнению с Opus 5 и документирует его применение для задач программирования и агентных рабочих нагрузок.
Обучение в контексте означает, что модель меняет свое поведение, используя информацию, доступную в ее контексте или постоянных файлах, без обновления весов нейронной сети. Здесь шахматные партии и заметки выступают накопленным опытом, который может влиять на последующие партии.
Бенчмарк использует более слабые конфигурации Stockfish, чтобы получить измеримый диапазон производительности языковых моделей. Stockfish на полной мощности значительно сильнее текущей игры языковых моделей в шахматы, поэтому прямое включение таких партий в экспериментальную оценку Elo было бы менее информативным для отслеживания улучшения.
Нет. Он показывает, что по крайней мере один запуск модели существенно улучшился благодаря постоянному контексту и повторному опыту в одной структурированной задаче. Для демонстрации надежного непрерывного обучения потребовались бы контролируемые эксперименты с множеством задач, стратегий памяти, конфигураций моделей и повторных запусков.
Шахматный эксперимент Питера Гостева дал Claude Opus 5.5 и GPT-6 Astra повторяющиеся возможности учиться на собственных партиях без изменения весов моделей. Экспериментальный Elo Opus вырос примерно с 1500 до 1760, тогда как Astra рано достиг пика, а затем снизился до 1400 к 200-й партии.
Результат интересен не потому, что он окончательно определяет, какая модель «лучше играет в шахматы», а потому, что он раскрывает более глубокий вопрос о постоянных агентах: может ли модель формировать полезный опыт через заметки, файлы и повторяющуюся обратную связь — и способна ли она не допустить, чтобы эта память стала шумной или активно вредной?
Причина снижения Astra остается необъясненной. Накопление контекста — одна из правдоподобных гипотез, но перед причинными выводами нужны контролируемые эксперименты с памятью и размерами контекстного окна.
Главный урок этого бенчмарка состоит в том, что фиксированные веса модели не гарантируют фиксированное поведение: то, что агент помнит, как он организует эту память и как учится на неудачах, может резко сдвинуть производительность вверх или вниз с течением времени.
Начните с одной фразы и получите полноценный сайт за считанные минуты.