Anthropic заявила, что Claude Sonnet 5.5 и Haiku 5.5 последуют за Opus 5.5 «в ближайшие недели».
Новая модель Claude среднего уровня появилась всего через шесть дней.
Новая модель Claude среднего уровня — это не просто уменьшенная версия Opus 5.5. На некоторых тестах программирования она фактически набирает более высокие результаты.
Самый заметный пример — Terminal-Bench 4.0:
Claude Sonnet 5.5: 70.6%
Claude Opus 5.5:   66.4%
Claude Sonnet 5:   10.3%
Однако в более широких профессиональных задачах Opus 5.5 по-прежнему сохраняет небольшое преимущество.
Anthropic сообщает:
GDPval-AA v2.1
Opus 5.5:   1846 Elo
Sonnet 5.5: 1844 Elo

OSWorld 2.1
Opus 5.5:   81.8%
Sonnet 5.5: 80.1%
Это делает Sonnet 5.5 необычно близкой к флагманской модели Anthropic в нескольких измеримых задачах, при этом для нее сохраняется более доступный ценовой уровень Sonnet.
Но различия между моделями по-прежнему важны.
Anthropic заявляет, что Opus 5.5 остается явно более сильной моделью для сложной, открытой работы, требующей длительного и последовательного суждения. Sonnet 5.5 в большей степени предназначена для четко определенных повседневных задач, таких как:
- Программирование
- Исправление ошибок
- Проверка кода
- Документы
- Презентации
- Электронные таблицы
- Структурированные задачи агентов
- Быстрые итерационные рабочие процессы
Поэтому полезный вывод заключается не в том, что Sonnet 5.5 «заменила» Opus.
Скорее, разрыв в производительности стал намного меньше для многих типовых задач и рабочих процессов с высокой долей программирования.
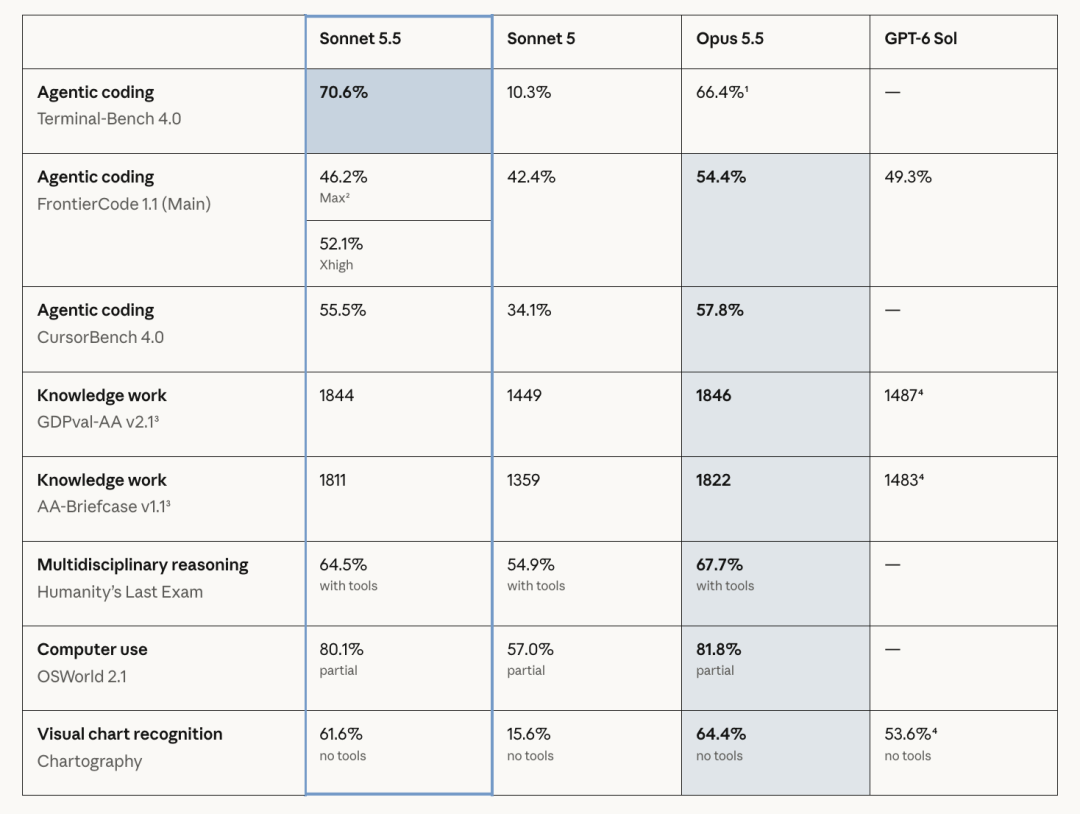
В исходной статье Sonnet 5.5 описывается как «средний стакан», который догоняет «большой стакан».
Эта метафора неожиданно хорошо соответствует таблице результатов.
| Оценка | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% | 10.3% | — |
| FrontierCode 1.1 Main | 52.1% при Xhigh | 54.4% | 42.4% | до 52.1% |
| CursorBench 4.0 | 55.5% | 57.8% | 34.1% | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity's Last Exam | 64.5% | 67.7% | 54.9% | — |
| OSWorld 2.1 | 80.1% | 81.8% | 57.0% | — |
| Chartography | 61.6% | 64.4% | 15.6% | 53.6% |
Таблица показывает реальную картину.
Sonnet 5.5 уверенно выигрывает один важный тест программирования, почти догоняет Opus в нескольких других, но не превосходит Opus 5.5 по всем направлениям.
Anthropic сама проводит такое же различие: результаты тестов — лишь один из способов оценить качество модели, а Opus остается сильнее в неоднозначных и открытых задачах, требующих длительного последовательного суждения.
Sonnet 5.5 эффективнее использует инструменты
Обновление связано не только с итоговыми результатами.
Первые тестировщики также заметили, что Sonnet 5.5 иначе организует свою работу.
По сравнению с Sonnet 5 модель охотнее объединяет вызовы инструментов, когда задачи можно выполнять параллельно, вместо последовательной обработки каждого действия.
Отзывы клиентов Anthropic включают одну оценку программирования, в которой Sonnet 5.5 использовала:
примерно на 1/3 меньше вызовов инструментов
примерно в 2 раза меньше запусков оболочки
для выполнения задачи того же типа.
Это важно для систем агентов, поскольку каждый дополнительный вызов инструмента может увеличивать:
- Задержку
- Расход токенов
- Инфраструктурные затраты
- Риск ошибки
- Объем состояния, которым необходимо управлять
Модель, которая достигает того же результата с меньшим числом взаимодействий с инструментами, может быть существенно дешевле, даже если ее заявленная цена за токены не меняется.
Base44: сопоставимый результат за половину итераций
Base44 протестировала Sonnet 5.5 на 118 реальных задачах по созданию приложений.
Полученный результат особенно показателен с практической точки зрения.
Sonnet 5.5 создавала приложения, которые набирали столько же баллов, сколько Opus 5, при этом требуя:
Sonnet 5.5:
в среднем 3,6 итерации на сборку

Opus 5:
в среднем 7,7 итерации на сборку
Base44 также сообщила, что Sonnet 5.5 продемонстрировала наименьшее число неудачных вызовов инструментов среди всех моделей в сравнении.
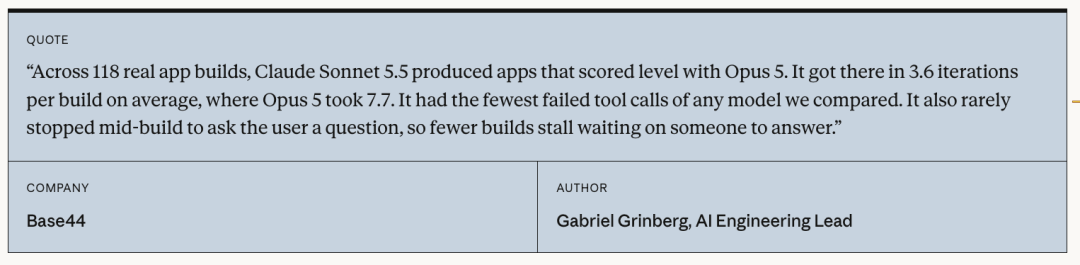
Это полезное напоминание о том, что «стоимость модели» — это не только:
цена входных токенов
+
цена выходных токенов
В реальных рабочих процессах агентов итоговая стоимость также зависит от:
числа итераций
числа вызовов инструментов
неудачных действий
повторных попыток
вмешательств человека
времени до принятого результата
Если одна модель завершает работу за половину итераций, фактическая разница в стоимости может быть намного больше, чем предполагает таблица цен API.
Epic Games протестировала модель на крупных кодовых базах
Epic Games протестировала Sonnet 5.5 на значительно более крупных программных системах.
Согласно опубликованным Anthropic отзывам клиентов, модель работала с десятками тысяч строк кода игровых систем, выполняя такие задачи, как:
- Аудит архитектуры систем
- Проверка потоков данных
- Многочасовые задачи программирования
Epic Games заявила, что модель достигала уровня качества, обычно ожидаемого от модели более высокого уровня, и при этом требовала менее подробных инструкций.
Именно в таких рабочих процессах модель меньшего размера может оказаться особенно ценной.
Разработчику по-прежнему может понадобиться Opus 5.5 для определения архитектуры или решения наиболее сложных неоднозначных задач, но Sonnet 5.5 способна взять на себя значительно большую часть работы по реализации и проверке при меньших затратах.
Unity учитывает задачу только после запуска проекта
Unity использовала более строгий стандарт завершения.
Вместо того чтобы принимать исправление кода только потому, что модель заявила о завершении работы, Unity заново открывала проект и проверяла, работает ли результат во время выполнения.
В рамках этой оценки Sonnet 5.5 выполнила:
90%
задач в многоэтапном тесте Unity для редактора и программирования.
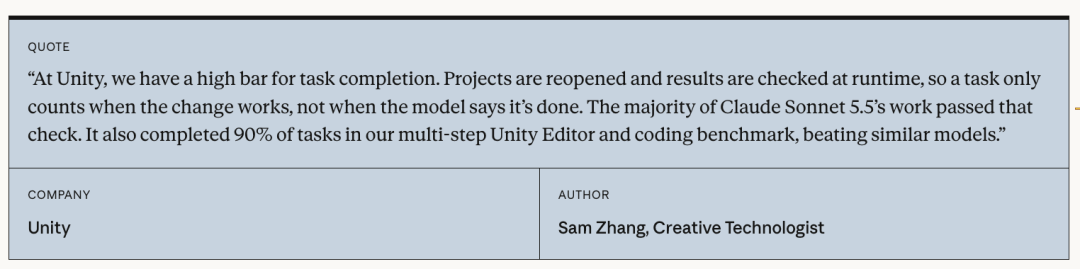
Такое тестирование информативнее, чем оценка одного лишь качества генерации кода.
Исправление может выглядеть корректным, но не работать из-за:
- Отсутствующих зависимостей
- Неправильного состояния проекта
- Ошибок сборки
- Предположений о среде выполнения
- Ошибок при использовании инструментов
- Изменений за пределами запрошенной области
Тест Unity пытается измерить фактическое выполнение задачи от начала до конца, а не только текстовый ответ.
Sonnet 5.5 может пройти Pokémon Red, работая со скриншотами
Anthropic также продолжила одну из своих регулярных демонстраций долгосрочной работы.
Sonnet 5.5 стала первой моделью Sonnet в семействе Claude, которая прошла Pokémon Red, работая только со скриншотами.
Этот тест не является прямым тестом программирования.
Его ценность заключается в другом.
Игра требует от модели:
- Интерпретировать визуальное состояние
- Помнить долгосрочные цели
- Планировать множество шагов вперед
- Исправляться после ошибок
- Продолжать действовать на протяжении длительного периода
Эти же свойства важны для агентов, работающих с компьютером, и долгосрочных программных рабочих процессов.
Улучшились также дизайн и офисные задачи
В исходной статье отмечается, что Sonnet 5.5 стала сильнее не только в программировании.
Anthropic также позиционирует ее для создания качественных документов, презентаций, электронных таблиц и визуальных материалов.
Модель рассчитана на следование существующим визуальным правилам, а не на создание каждого материала с нуля.
Например, получив существующий шаблон слайда, она может продолжать использовать те же:
- Макет
- Отступы
- Визуальную иерархию
- Стилевые правила
- Дизайн-язык
Anthropic заявляет, что это уменьшает объем ручной доработки после генерации.
Поэтому Sonnet 5.5 особенно актуальна для бизнес-процессов, в которых задача четко определена, но при этом требуется визуальная согласованность.
Цена API не выросла
Несмотря на заметный прирост производительности, Sonnet 5.5 сохраняет базовые цены API Sonnet 5.
Anthropic в настоящее время указывает:
| Тип токенов | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Входные | 2 доллара / 1 млн | 4 доллара / 1 млн |
| Выходные | 10 долларов / 1 млн | 20 долларов / 1 млн |
| Чтение кэша | 0,20 доллара / 1 млн | 0,20 доллара / 1 млн |
| Запись в кэш | 2,50 доллара / 1 млн | 5 долларов / 1 млн |
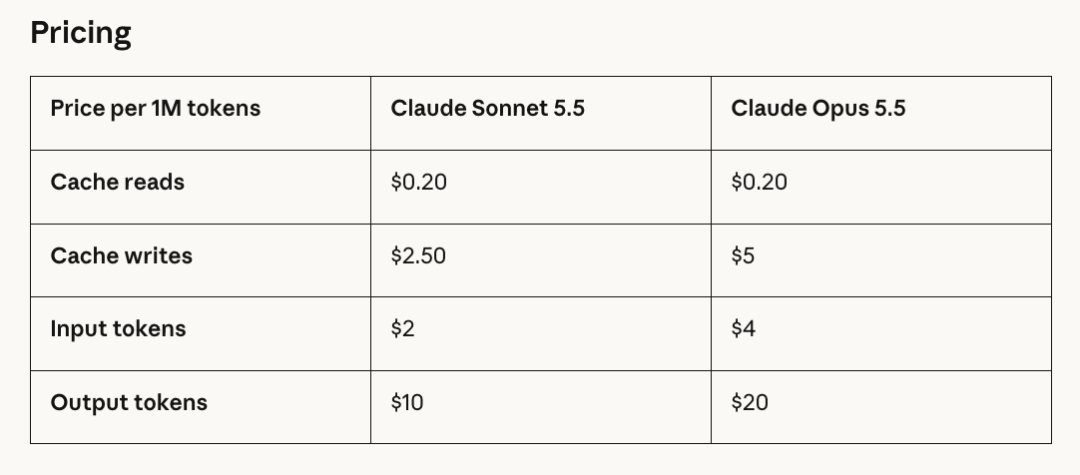
На уровне опубликованных цен стандартные входные и выходные токены Sonnet 5.5 стоят ровно в два раза дешевле, чем у Opus 5.5.
Однако теперь Anthropic уделяет больше внимания другому показателю:
Стоимость завершенной задачи.
Стоимость задачи ниже, хотя цены на токены остались прежними
Anthropic заявляет, что Sonnet 5.5 генерирует результаты более чем на 30% быстрее, чем Sonnet 5.
Компания также утверждает, что модели обычно требуется меньше токенов и шагов для выполнения одной и той же работы.
В результате Anthropic сообщает, что Sonnet 5.5 может стоить:
до 30% меньше за задачу
чем Sonnet 5 в большинстве рабочих процессов.
Именно поэтому оценка только по ставке 2 / 10 долларов за токены не отражает всю суть обновления.
Создайте сайт-витрину и привлекайте лиды за минуты
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Номинальная ставка осталась прежней.
Но объем работы модели, необходимый для завершения задачи, уменьшился.
Terminal-Bench: средний уровень усилий превосходит Sonnet 5 при существенно меньшей стоимости
Теперь Anthropic предоставляет несколько уровней усилий.
Более высокий уровень позволяет модели дольше рассуждать и проверять больше аспектов работы.
Более низкий уровень делает ее быстрее и дешевле.
В Claude Code и пользовательских приложениях Anthropic уровень усилий по умолчанию — Medium. На Claude Platform уровень по умолчанию — High.
На Terminal-Bench 4.0 график Anthropic, сопоставляющий стоимость и производительность, показывает, что Sonnet 5.5 при среднем уровне усилий уже превосходит лучший результат Sonnet 5 и при этом стоит примерно в десять раз дешевле за одну попытку.
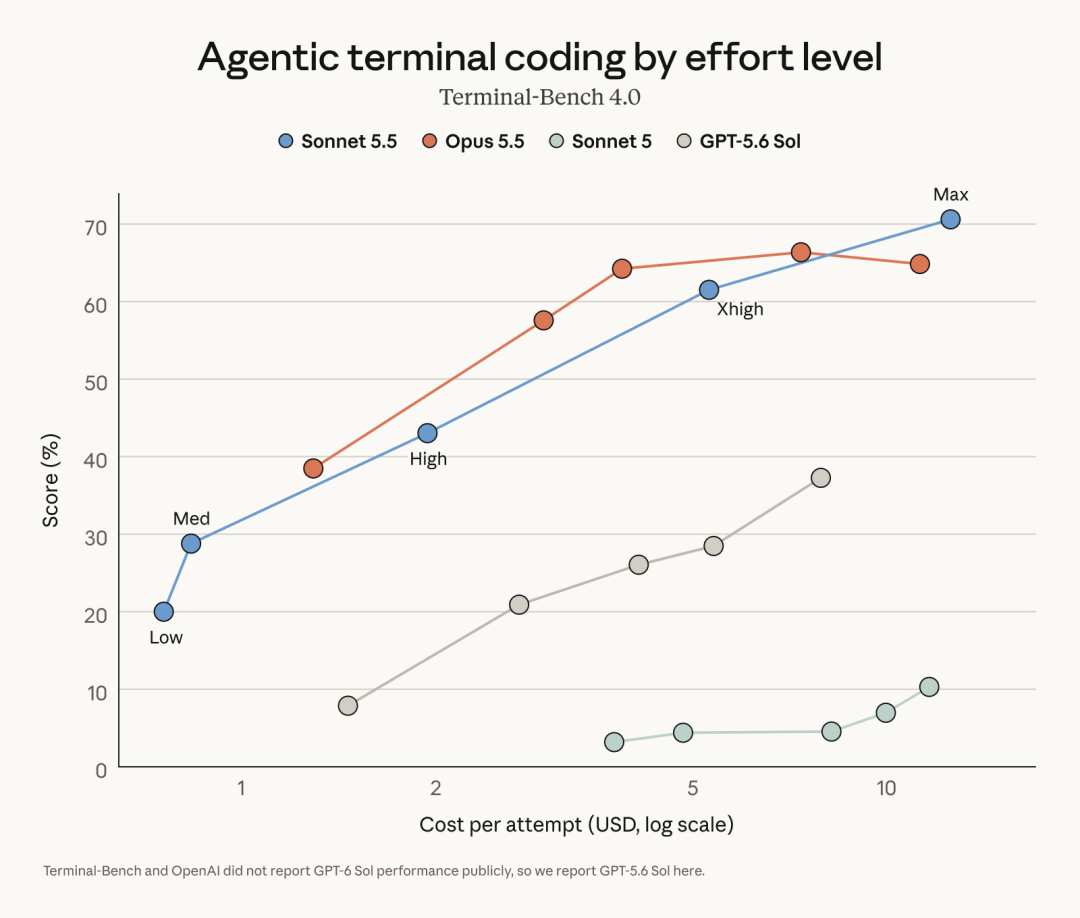
Главный вывод не в том, что Medium всегда является правильной настройкой.
Важно то, что разработчик теперь может точнее настраивать соотношение качества и стоимости.
Для типовых задач программирования может быть достаточно более низкого уровня усилий.
Для сложных задач повышение уровня дает Sonnet больше времени на рассуждение.
CursorBench показывает похожую картину
CursorBench 4.0 оценивает работу с кодом на основе реальных сессий в Cursor.
Sonnet 5.5 достигает:
55.5%
по сравнению с:
57.8%
у Opus 5.5.
График стоимости Anthropic показывает, что даже при относительно низком уровне усилий Sonnet 5.5 может превысить лучший результат Sonnet 5 примерно за одну десятую стоимости задачи.
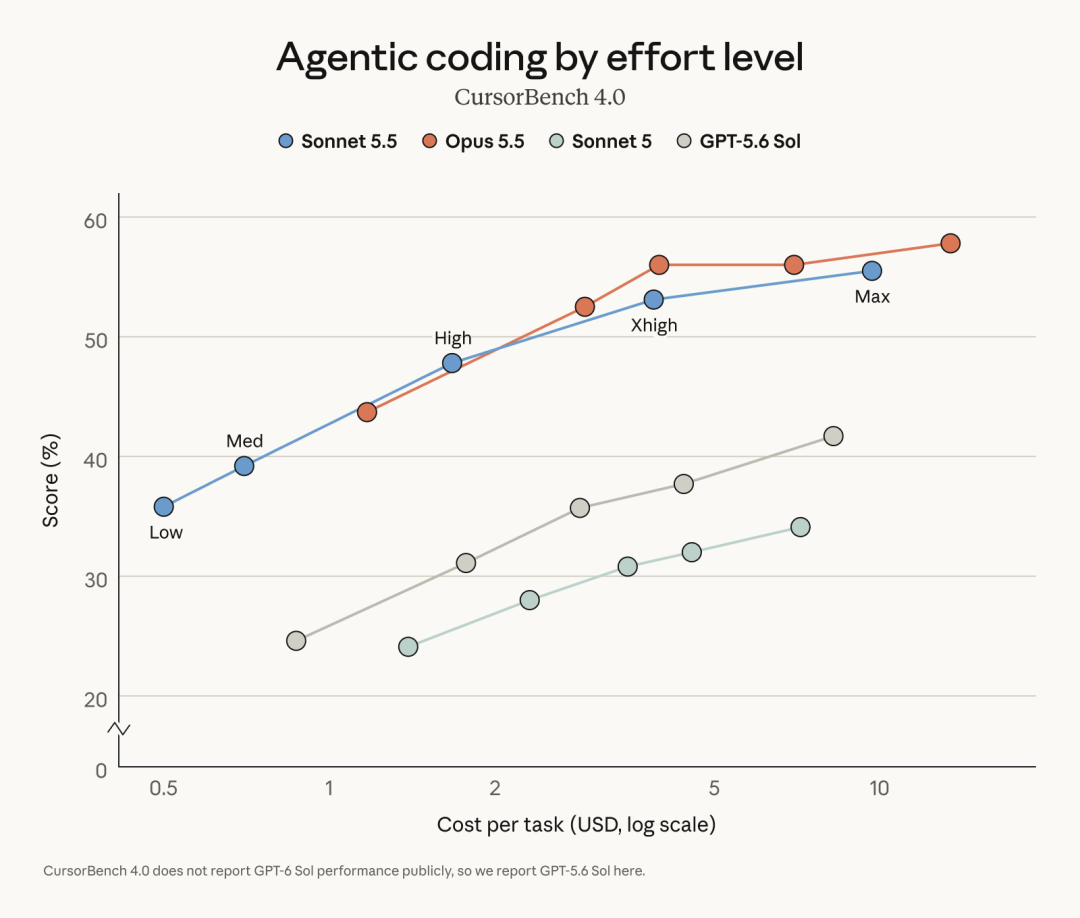
Именно здесь новая Sonnet становится особенно привлекательной.
Абсолютный разрыв с Opus может быть настолько небольшим, что более доступная модель часто оказывается лучшим производственным выбором для программирования в больших объемах.
FrontierCode сравнивает Sonnet 5.5 с GPT-6 Sol
В исходной статье особое внимание уделяется FrontierCode 1.1, поскольку в сравнении участвует GPT-6 Sol.
Опубликованный Anthropic график показывает, что Sonnet 5.5 достигает лучшего результата FrontierCode при уровне усилий Xhigh, тогда как разные уровни усилий GPT-6 Sol попадают в сопоставимый диапазон результатов.
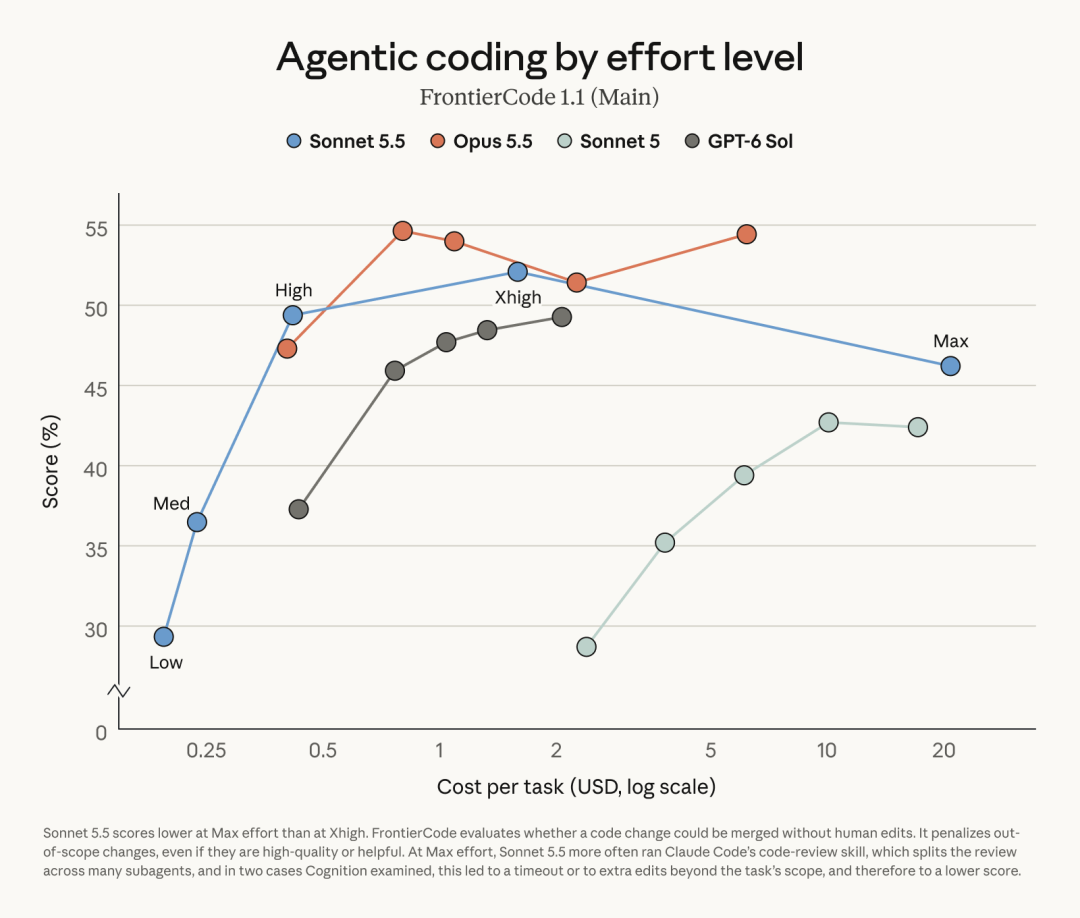
При высоком уровне усилий Sonnet 5.5 уже находится примерно в диапазоне результатов более сильных протестированных настроек GPT-6 Sol, а Anthropic оценивает стоимость задачи как существенно меньшую.
В исходной статье разрыв описывается примерно так:
Стоимость задачи Sonnet 5.5:
примерно 1/5 стоимости GPT-6 Sol
для сопоставимой точки, выделенной на графике Anthropic.
Эту цифру следует понимать как сравнение стоимости задачи в рамках конкретного теста, а не как универсальное соотношение цен API.
Модели:
- Имеют разные структуры ценообразования
- Используют разный объем рассуждений
- Генерируют разное количество токенов
- Могут требовать разного числа повторных попыток
- Сравниваются при конкретных настройках уровня усилий
Поэтому корректнее сказать, что график Anthropic показывает: в этой конфигурации Sonnet 5.5 достигает сопоставимого качества FrontierCode при значительно меньшей измеренной стоимости задачи.
Это не означает, что каждая задача Sonnet обходится ровно на 80% дешевле GPT-6 Sol.
Sonnet 5.5 не заменяет Opus 5.5
Заголовки тестов могут создать впечатление, что более дешевая модель Sonnet сделала Opus ненужной.
Anthropic прямо отвергает такую интерпретацию.
Собственные тесты и отзывы клиентов компании по-прежнему показывают, что Opus 5.5 явно сильнее в задачах, требующих:
- Открытого рассуждения
- Более длительного последовательного суждения
- Более неоднозначного планирования
- Архитектурных решений
- Сложных исследований
- Многоэтапных решений с высокой ответственностью
Поэтому практическая стратегия маршрутизации моделей выглядит скорее так:
Opus 5.5
→ архитектура
→ сложное планирование
→ неоднозначные исследования
→ задачи максимальной сложности

Sonnet 5.5
→ реализация
→ исправление ошибок
→ проверки
→ типовые задачи агентов
→ документы и офисная работа
→ программирование в больших объемах
Один из клиентов Anthropic описал взаимосвязь похожим образом: поручить Opus определить архитектуру, а затем поручить Sonnet реализовать ее.
Вероятно, это наиболее полезный способ понимать семейство 5.5.
Усиление возможностей программирования сопровождалось усилением мер безопасности
Исходная статья в основном посвящена производительности и стоимости, но стоит отметить одну официальную деталь.
Anthropic заявляет, что возможности Sonnet 5.5 в области кибербезопасности улучшились настолько, что это первая модель Sonnet, выпущенная с мерами кибербезопасности и резервными механизмами, аналогичными тем, которые используются для наиболее мощных моделей Anthropic.
Anthropic также заявляет, что эти меры направлены на узкий набор запросов с высоким риском и не должны мешать обычной разработке программного обеспечения.
Это важно, поскольку более сильные возможности программирования и работы с инструментами могут одновременно повышать возможности двойного назначения в сфере безопасности.
Sonnet 5.5 доступна на платформах Claude
Anthropic сообщает, что Sonnet 5.5 доступна через:
- Claude.ai
- Claude Code
- Claude Platform / API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
Идентификатор модели API:
claude-sonnet-5-5
Anthropic также поддерживает нулевое хранение данных для Sonnet 5.5 в подходящих конфигурациях API.
Командам, переходящим с Sonnet 5, Anthropic рекомендует изучить новые настройки уровня усилий и пересмотреть конфигурацию, а не предполагать, что все старые параметры среды выполнения нужно копировать без изменений.
Следующей будет Haiku 5.5
Исходная статья завершается взглядом на следующего участника семейства Claude 5.5.
Anthropic заявляет, что Haiku 5.5 последует в ближайшие недели.
Ее позиционирование уже понятно:
высокая пропускная способность
+
чувствительные к стоимости рабочие процессы
Если Sonnet 5.5 — это быстрый универсальный рабочий инструмент, а Opus 5.5 — модель для сложного открытого суждения, то Haiku 5.5, как ожидается, еще сильнее сместится в сторону экономики развертывания в больших объемах.
Направление развития семейства Claude 5.5 становится очевидным.
Anthropic конкурирует не только по абсолютным результатам тестов.
Компания все чаще представляет модели через сочетание:
качество
+
скорость
+
стоимость завершенной задачи
Для разработчиков это может быть более полезным показателем развертывания, чем один лишь результат теста.
FAQ
Что такое Claude Sonnet 5.5?
Claude Sonnet 5.5 — последняя модель Anthropic в линейке Sonnet и второй релиз семейства Claude 5.5. Она создана как более быстрый и доступный по стоимости помощник Opus 5.5 для программирования, работы агентов, интеллектуальной работы, документов, презентаций и других четко определенных задач.
Sonnet 5.5 лучше Opus 5.5?
В некоторых тестах — да. Sonnet 5.5 набирает 70,6% в Terminal-Bench 4.0 против 66,4% у Opus 5.5, однако Opus по-прежнему лидирует в большинстве более широких оценок и остается сильнее в сложной открытой работе, требующей длительного суждения.
Сколько стоит Claude Sonnet 5.5?
Anthropic указывает стандартную цену API на уровне 2 долларов за миллион входных токенов и 10 долларов за миллион выходных токенов. Чтение кэша стоит 0,20 доллара за миллион токенов, а запись в кэш — 2,50 доллара за миллион токенов.
Sonnet 5.5 дешевле Sonnet 5?
Цены на токены одинаковы, но Anthropic заявляет, что Sonnet 5.5 обычно использует меньше токенов и эффективнее завершает работу. По результатам тестов компании это снижает стоимость задачи до 30% во многих рабочих процессах.
Насколько Sonnet 5.5 быстрее?
Anthropic заявляет, что генерация результатов более чем на 30% быстрее, чем у Sonnet 5. Внешние тестировщики также сообщают о меньшем числе вызовов инструментов, запусков оболочки и итераций во многих задачах программирования.
Как Sonnet 5.5 сравнивается с GPT-6 Sol?
График стоимости и производительности FrontierCode от Anthropic показывает, что Sonnet 5.5 достигает сопоставимого диапазона качества с протестированными настройками GPT-6 Sol при существенно меньшей измеренной стоимости задачи в рамках этого теста. Это не универсальное соотношение стоимости и не доказательство того, что Sonnet выигрывает в каждой задаче программирования или рассуждения.
Какой идентификатор модели использовать разработчикам?
Официальный идентификатор модели Claude API:
claude-sonnet-5-5
Anthropic также сообщает о доступности модели через AWS, Google Cloud и Microsoft Foundry.
Когда выйдет Claude Haiku 5.5?
Anthropic заявляет, что Haiku 5.5 появится в ближайшие недели. Модель предназначена для приложений с высокой пропускной способностью и чувствительностью к стоимости.
Связанные инструменты
- Claude: пользовательский интерфейс Anthropic для работы с моделями Claude.
- Claude Code: среда Anthropic для агентной разработки программного обеспечения на уровне репозитория.
- Claude API: официальная документация API для интеграции
claude-sonnet-5-5в приложения. - Amazon Bedrock: платформа AWS, предлагающая модели Claude для корпоративных приложений.
- Google Vertex AI: платформа Google Cloud, предоставляющая доступ к моделям Claude.
- Microsoft Foundry: платформа Microsoft для разработки ИИ с доступом к моделям Claude.
Связанные ссылки
- Исходная статья на BAAI Hub: статья QbitAI на языке оригинала, адаптированная и проверенная по фактам в этой публикации.
- Anthropic — представляем Claude Sonnet 5.5: основной анонс с результатами тестов, оценками клиентов, ценами, графиками стоимости задачи и примечаниями о безопасности.
- Страница продукта Claude Sonnet: официальный обзор сценариев использования, доступности и цен Sonnet 5.5.
- Claude Opus 5.5: официальный анонс Opus 5.5 для сравнения с флагманской моделью Anthropic.
- Документация Anthropic API: официальная документация API и рекомендации по интеграции моделей.
- Цены Anthropic: актуальная информация о ценах на модели Claude и тарифных планах продуктов.
Резюме
Claude Sonnet 5.5 сократила разрыв между моделью Anthropic среднего уровня и флагманской моделью сильнее, чем можно предположить по названию. Она превосходит Opus 5.5 в Terminal-Bench 4.0, отстает всего на два пункта Elo в GDPval-AA и почти сравнивается с Opus в OSWorld и CursorBench.
Главная история с точки зрения развертывания — эффективность. Sonnet 5.5 сохраняет те же цены 2 / 10 долларов за токены, что и Sonnet 5, но Anthropic заявляет, что модель работает более чем на 30% быстрее и может снизить стоимость завершенной задачи до 30%. Внешние тестировщики также сообщают о меньшем числе вызовов инструментов, запусков оболочки и значительно меньшем количестве итераций.
Opus 5.5 по-прежнему остается более сильным выбором для сложной открытой работы, требующей длительного суждения. Sonnet 5.5 лучше понимать как рабочую лошадку для больших объемов задач, которая теперь достигает качества флагманского уровня во все большем числе четко определенных сценариев.
Самое важное обновление Sonnet 5.5 — не одна победа в тесте, а то, насколько близко модель подошла к качеству флагманской модели, сохранив цену уровня Sonnet и значительно снизив стоимость завершенной задачи.