На протяжении большей части вычислительной эпохи тенденция казалась очевидной: производительность чипов постоянно растёт, облачная инфрастру...
На протяжении большей части компьютерной эпохи направление развития казалось очевидным: производительность чипов неуклонно растёт, облачная инфраструктура постоянно расширяется, а эффективная цена вычислений снижается.
ИИ может нарушить эту закономерность.
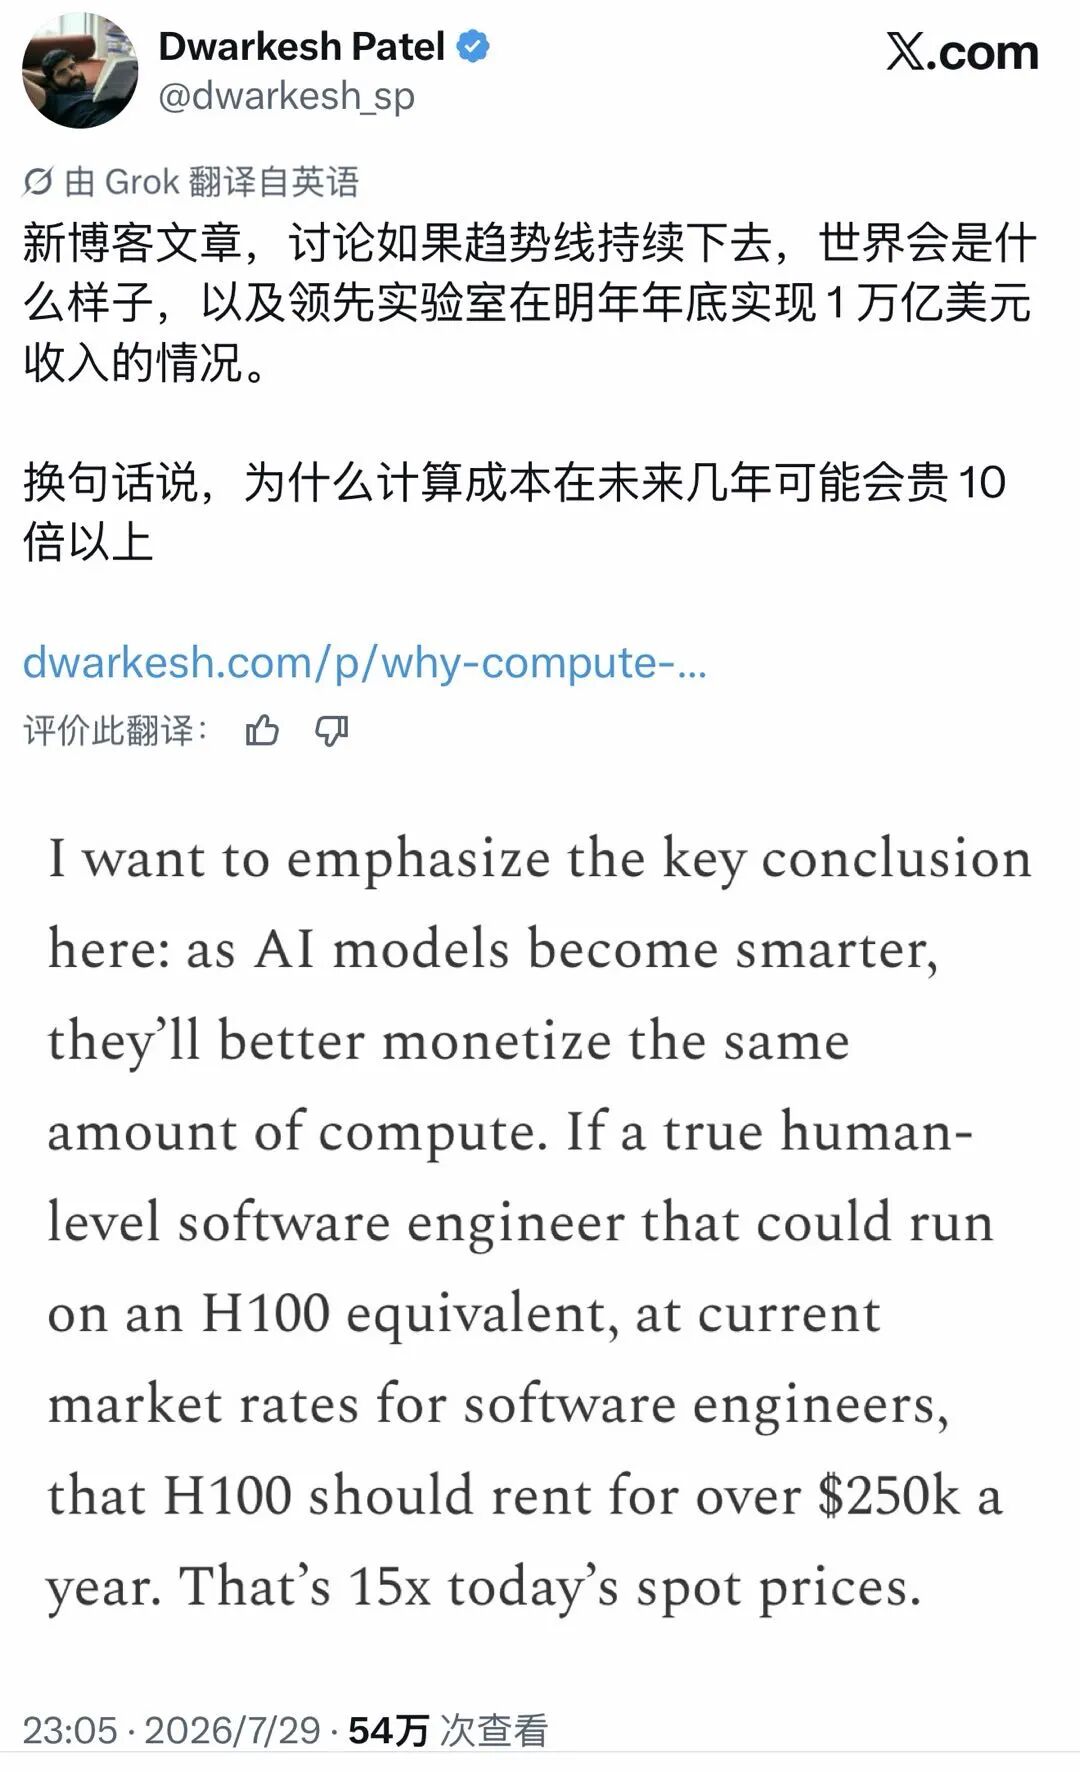
В статье от 29 июля 2026 года технологический интервьюер и писатель Дваркеш Патель представил намеренно радикальный сценарий: способность передового ИИ превращать вычисления в экономическую ценность резко возрастает, в то время как физическое предложение передовых вычислительных мощностей расширяется гораздо медленнее.
В этом сценарии рыночная цена высококлассных ИИ-вычислений может вырасти в 10 раз или более, прежде чем в конечном итоге вернуться к долгосрочной траектории снижения затрат.
Аргументация начинается с провокационного сравнения.
Если ИИ-агент, работающий на вычислительной мощности, эквивалентной одному NVIDIA H100, способен выполнять работу высокооплачиваемого инженера-программиста, то почему арендная цена этого GPU по-прежнему определяется главным образом амортизацией оборудования и облачной конкуренцией?
Почему его цена не приближается к экономической ценности человеческого труда, который он заменяет или усиливает?
В оригинале этот мысленный эксперимент расширяется до более широких прогнозов об ИИ-лабораториях, центрах обработки данных, производственных мощностях передовых полупроводников и о том, что мир может вступить в период серьёзной инфляции вычислительных мощностей.
С самого начала следует чётко обозначить несколько важных оговорок:
При соблюдении вышеуказанных условий этот мысленный эксперимент ценен тем, что поднимает вопрос, которого индустрия часто избегает:
Что произойдёт, когда экономическая ценность, создаваемая ИИ, будет расти быстрее, чем мир успевает создавать инфраструктуру для его работы?
Аргументация начинается со смены единицы сравнения.
Сегодня вычислительные мощности обычно оцениваются как инфраструктура:
Вопрос Пателя звучит так: что произойдёт, когда то же самое оборудование станет вместилищем автономной рабочей силы?
Представьте ИИ-инженера-программиста, способного:
Если этому агенту для работы требуется примерно одна H100-эквивалентная вычислительная мощность, то GPU перестаёт быть просто серверным компонентом. Он становится частью цифровой производственной системы.
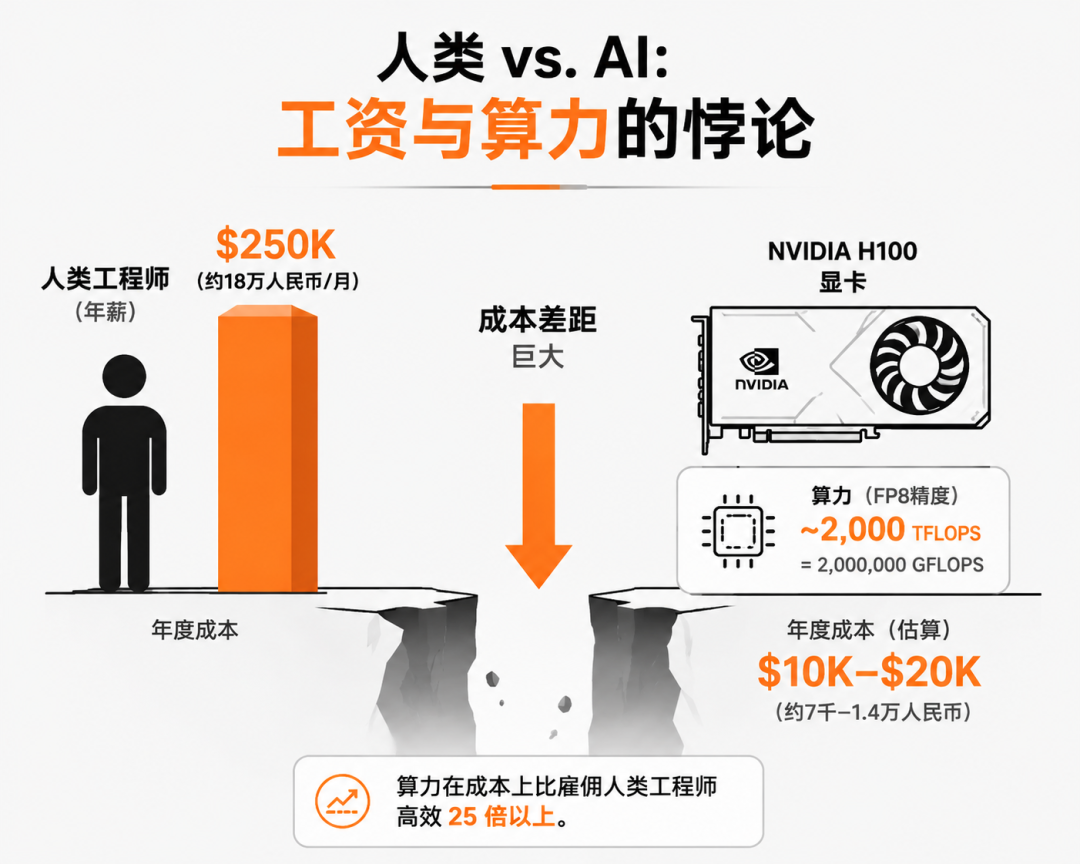
Патель берёт в качестве ориентира рыночную стоимость сильного инженера-программиста из Кремниевой долины — 250 тысяч долларов в год.
Затем он сравнивает её с годовой оценкой аренды H100 по спотовым ценам — примерно 16 тысяч долларов.
Подразумеваемый разрыв составляет:
250 000 / 16 000 ≈ 15,6 раза
В этом упрощённом мысленном эксперименте GPU, способный нести эквивалентную цифровую рабочую силу, выглядит сильно недооценённым относительно той трудовой ценности, которую он может создавать.
Этот расчёт не является прямым предсказанием того, что каждый H100 будет сдаваться в аренду за 250 тысяч долларов.
Он упускает несколько важных факторов:
Более узкая точка зрения Пателя состоит в том, что когда вычисления способны приносить более ценные результаты, готовность платить за них может резко возрасти.
Естественное возражение состоит в том, что добавление миллионов ИИ-инженеров-программистов снизит рыночную стоимость труда в разработке ПО.
Если программное обеспечение станет изобильным, цифровой инженер может больше не стоить 250 тысяч долларов.
Патель признаёт такую возможность, но считает, что это не произойдёт автоматически.
Стандартная экономическая логика обычно отвергает представление о том, что «объём полезной работы фиксирован». Дополнительные квалифицированные работники создают новые продукты, новые компании, новые специальности и новый спрос.
С этой точки зрения, массовый приток способных работников не просто делит существующую работу между большим числом участников. Он расширяет границы экономически возможного.
ИИ может вызвать аномально быстрый шок предложения труда, поэтому исторические аналогии могут быть неприменимы. Тем не менее, Патель считает разумным, что предельная ценность ИИ-вычислений останется высокой по мере того, как новое ПО и услуги становятся возможными.
Одно из полезных возражений в обсуждении под статьёй Пателя состоит в том, что сравнение ценности труда наиболее сильно работает, когда вся задача может быть выполнена в цифровой среде.
Разработка ПО близка к этому идеалу:
Когда доминируют физические ограничения, это сравнение становится слабее.
ИИ-система может быстро спроектировать лекарство, но клинические испытания по-прежнему требуют пациентов, регуляторов, производства и времени. Она может оптимизировать завод, но строительство, лицензирование, цепочки поставок и оборудование остаются подчинёнными физическим ограничениям.
В этих областях интеллект может перестать быть главным узким местом задолго до того, как вычислительные мощности смогут полностью взять на себя всю ценность замещаемого человеческого труда.
Вторая часть аргументации переходит от отдельного GPU к финансовому положению передовых ИИ-лабораторий.
Anthropic — главный пример, поскольку её недавний рост доходов исключительно стремителен.
Официально объявленные данные Anthropic:
Это показатели годового темпа (run-rate), а не аудированная выручка за полный год.
Они описывают скорость роста, подразумеваемую выручкой на конкретный момент времени.
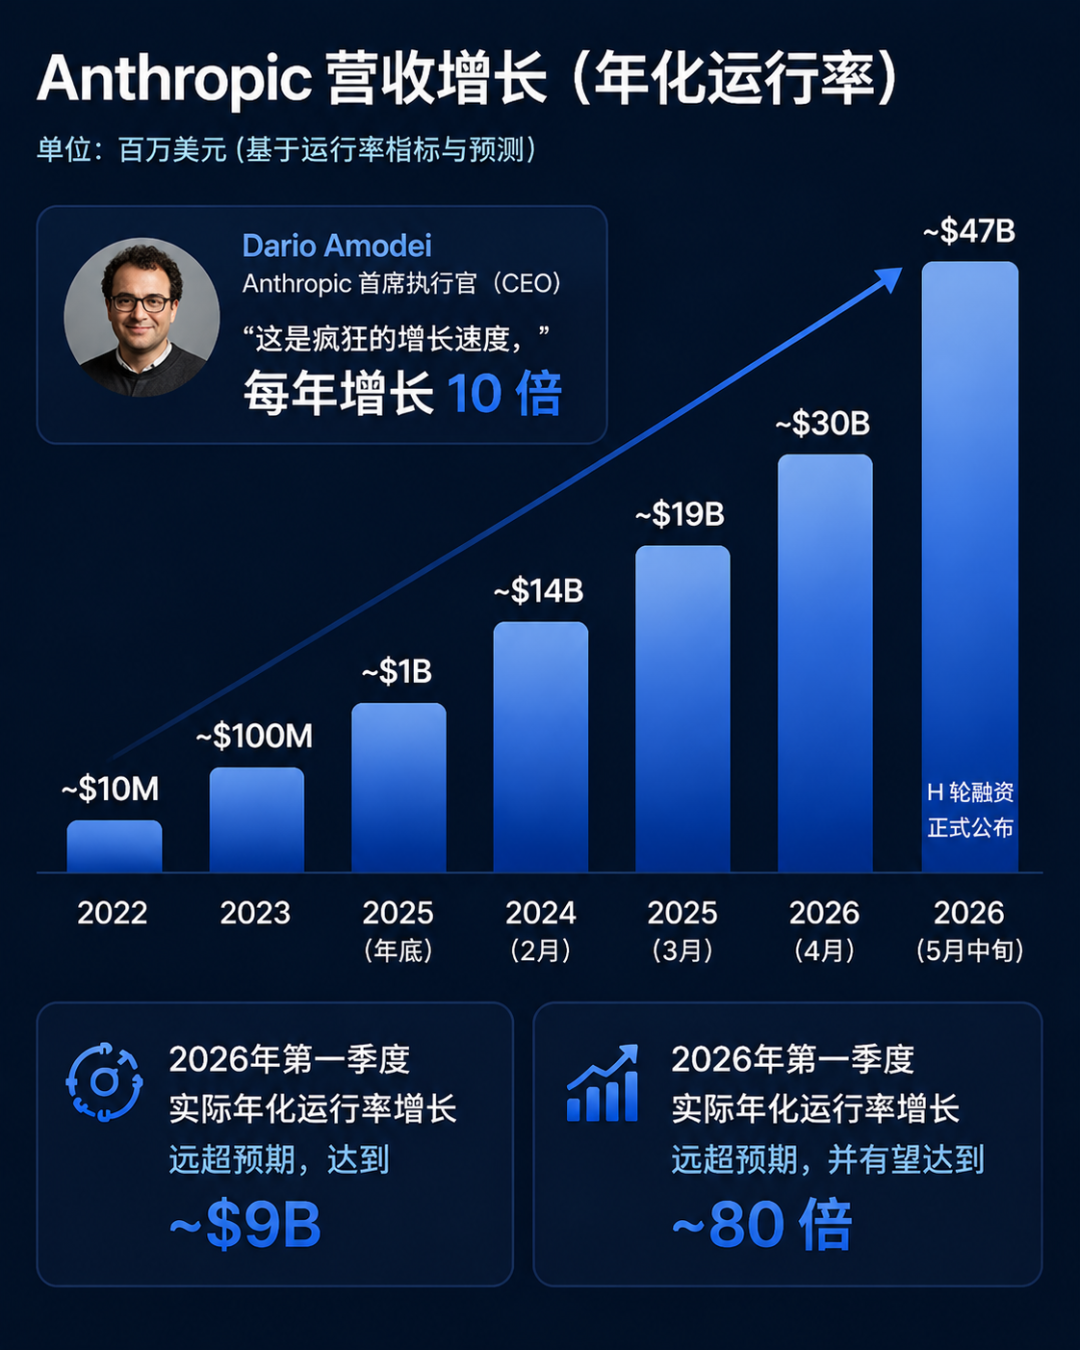
Исходная точка Patel — наблюдение: выручка Anthropic выросла примерно на порядок по сравнению с прошлым годом.
Затем он построил намеренно экстремальный гипотетический сценарий:
Patel прямо отмечает, что эта траектория не является обязательной и не имеет глубинной причины. Она зависит от будущих возможностей ИИ, темпов внедрения продуктов, ценообразования и конкуренции.
Цель сценария — не утверждать, что Anthropic прогнозирует триллионную выручку, а задать вопрос: если ИИ-компания действительно растёт такими темпами, какие ещё условия должны выполняться?
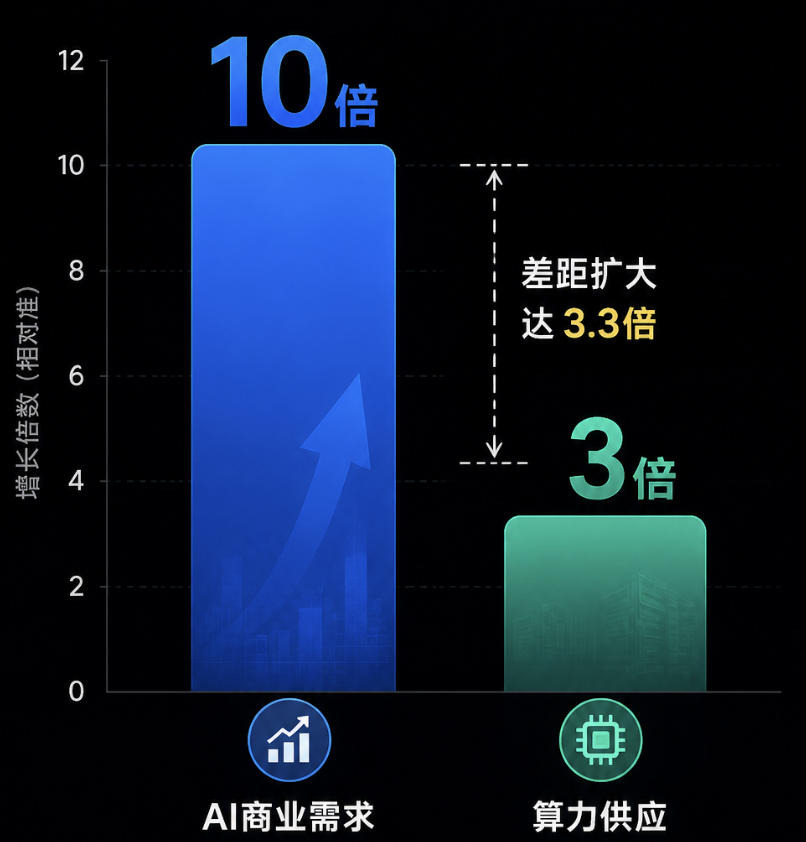
Patel сопоставляет гипотетический десятикратный рост выручки с оценочным трёхкратным ежегодным расширением вычислительных мощностей ИИ.
Epoch AI оценивает, что в 2025 году глобальный объём вычислительных мощностей ИИ в эквиваленте H100 вырос примерно вдвое (то есть утроился), хотя агентство также подчёркивает неопределённость оценок на уровне компаний и на перспективу.
Возникающий разрыв составляет примерно:
Рост потребностей ИИ-бизнеса: 10 раз
Рост физических мощностей:     3 раза
Разрыв:                        примерно 3,3 раза
Если выручка ведущей лаборатории растёт значительно быстрее доступных ей вычислительных мощностей, то должна измениться некоторая комбинация из трёх вещей:
доходные инференс-сервисы вместо исследований и обучения.
Patel считает, что все три процесса уже частично происходят.
Провайдеры моделей несут высокие фиксированные издержки на обучение моделей, а затем продают полученные способности множеству клиентов.
Это создаёт потенциальный эффект масштаба.
Одни и те же обученные способности можно продавать через:
Предельные издержки одного дополнительного запроса могут быть значительно ниже ценности, которую этот запрос создаёт.
Patel отмечает, что маржа на инференс у ведущих лабораторий значительно улучшилась. Однако его конкретные данные о марже инференс-сервиса Fable от Anthropic явно представлены как приблизительные оценки, а не как проверенные корпоративные показатели.
Высокая маржа может поглотить часть разрыва между ростом выручки и ростом вычислительных мощностей.
Сложность — в масштабе.
В сценарии Patel на 1 триллион долларов, если цены и распределение мощностей не будут скорректированы в достаточной степени, маржа должна вырасти до высоких уровней — около 95%. Он считает, что даже для ведущих технологических платформ это исключительно высокий показатель.
Точная требуемая маржа зависит от многих переменных, но более важный вывод остаётся в силе: только маржа вряд ли сможет примирить взрывной спрос с ограниченной инфраструктурой.
Второй вариант — направить большую долю вычислительных мощностей на обслуживание клиентов.
Epoch AI оценивает, что расходы OpenAI на инференс-мощности в 2024 году составили около 1,8 миллиарда долларов, а на исследовательские мощности — около 5 миллиардов. Таким образом, расходы на инференс составили примерно четверть от общего объёма заявленных вычислительных затрат.
По мере расширения коммерческого использования доля инференса может вырасти ещё больше.
Это помогает поддерживать выручку, но передовые лаборатории сталкиваются со стратегической дилеммой.
Инференс-сервисы оплачивают текущие счета.
Обучение и эксперименты создают модели, которые могут определить следующее поколение продуктов.
Лаборатория, направляющая большую часть мощностей на обслуживание текущих моделей, может генерировать более прямую выручку, но у неё останется меньше инфраструктуры для:
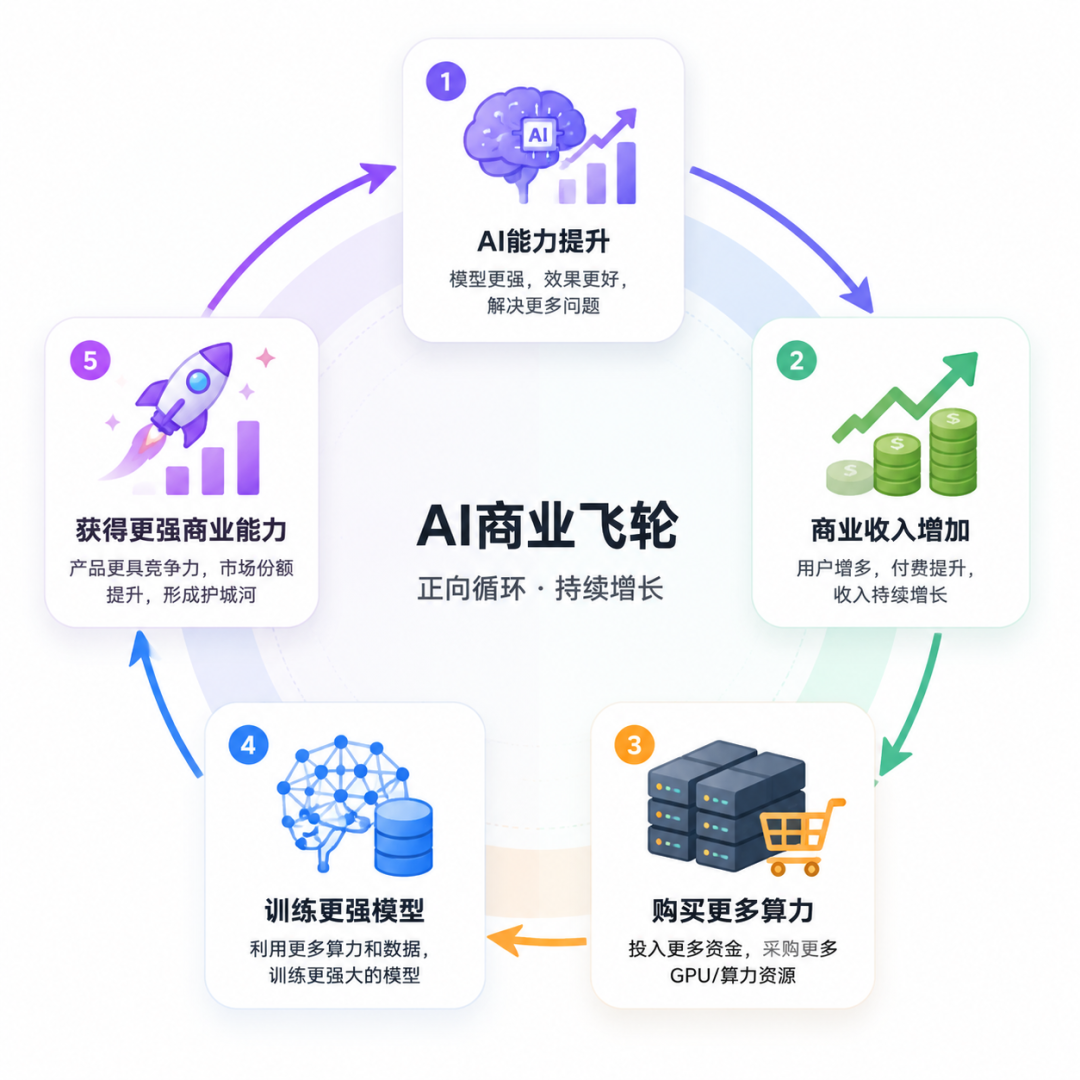
Patel описывает эффект маховика в Кремниевой долине: текущий доход от инференса помогает привлекать финансирование, финансирование покупает больше мощностей, мощности обучают более сильные модели, а более сильные модели приносят больше выручки.
Эти лаборатории обычно не считают сегодняшние модели конечной целью. Они ожидают, что нынешние передовые системы вскоре будут превзойдены.
Это делает их неготовыми полностью превратиться в высокомаржинальных облачных провайдеров, обслуживающих статичное поколение моделей.
Оставшийся механизм — цены.
Если ИИ-лаборатории и их клиенты могут создавать больше экономической ценности на единицу вычислительной мощности, они способны агрессивнее конкурировать за ограниченную инфраструктуру.
Это не означает, что цена за GPU-час вырастет одинаково везде.
Передовым лабораториям нужен особый класс вычислительных мощностей:
Спотовые инстансы с открытого рынка не могут полностью заменить безопасный многолетний контракт на инфраструктуру мощностью в несколько гигаватт.
Недавние контракты отражают премию за немедленную доступность мощностей.
Anthropic официально подтвердила соглашение с SpaceXAI на доступ к Colossus 1, а затем заявила о расширении мощностей на Colossus 1 и Colossus 2.
SpaceXAI описывает Colossus 1 как содержащий более 220 тысяч GPU NVIDIA, включая системы H100, H200 и GB200.
Axios сообщает, что Anthropic согласилась платить примерно 1,25 миллиарда долларов в месяц до 2029 года за эту договорённость.
TechCrunch затем сообщил о регуляторном документе, согласно которому Google будет платить SpaceX около 920 миллионов долларов в месяц с октября 2026 по июнь 2029 года за доступ к примерно 110 тысячам GPU и связанным компонентам.
Это не обычные закупки облачных ресурсов по требованию.
Они отражают ценность быстрого получения масштабной доступной инфраструктуры в условиях, когда строительство новых дата-центров, подключение к электросетям и поставки чипов могут занимать годы.
Patel оценивает, что подразумеваемая цена за GPU-час в сделке Google примерно вдвое превышает текущую спотовую цену на сопоставимое смешанное аппаратное обеспечение.
Это сравнение приблизительно, поскольку контракты включают не только голые GPU, а аппаратная комбинация охватывает разные поколения ускорителей.
В исходной статье используется промышленная аналогия.
В эпоху интернета компании конкурировали за:
Конкуренция в сфере передового ИИ добавила более материальное измерение:
Кластеры передовых GPU ближе к промышленным производственным линиям, чем к обычным наборам арендованных серверов.
Их продукция — не физические товары, а интеллект с экономической ценностью:
Компании, контролирующие самые мощные модели и самые надёжные вычислительные мощности, способны производить больше таких цифровых работ.
Спотовые мощности имеют несколько недостатков для передовых задач:
Лаборатории, обучающие или запускающие такие модели, поэтому ценят гарантированные вычислительные мощности больше, чем покупатели, выполняющие краткосрочные пакетные задачи.
Это помогает объяснить, почему контрактные вычислительные мощности сохраняют премию, даже когда публичные облачные предложения кажутся дешевле.
Аргумент Пателя опирается на утверждение, что предложение вычислительных мощностей не может реагировать на значительные шоки спроса достаточно быстро.
Он обобщает годовой рост вычислительных мощностей как произведение трёх широких множителей:
Годовой рост вычислительных мощностей ИИ ≈
1,4× улучшение аппаратного обеспечения
× 1,2× новые мощности по производству пластин
× 1,8× перераспределение передовых пластин в пользу ИИ
≈ 3,0×
Эти цифры — оценки, а не неизменные физические константы.
Они призваны показать источники недавнего роста.
Улучшения в полупроводниковых технологиях повышают эффективные вычисления на ватт, на чип и на доллар вложений.
Потенциальные выгоды включают:
Скорость прогресса не безгранична.
Каждое новое поколение технологического узла становится сложнее и дороже. Плотность мощности, утечки, выход годных, перемещение памяти и упаковка всё чаще становятся определяющими факторами фактической производительности.
Системы ИИ также могут повышать эффективность за счёт улучшений на уровне моделей и программного обеспечения, что может частично компенсировать дефицит аппаратного обеспечения. Поэтому любой прогноз цен на вычислительные мощности зависит от темпов повышения эффективности относительно роста спроса.
Новые полупроводниковые мощности требуют нескольких лет на планирование, финансирование, строительство, установку оборудования, валидацию и наращивание производства.
Цепочка поставок сильно зависит от специализированных систем, включая оборудование для экстремальной ультрафиолетовой литографии.
Передовые заводы также требуют:
Патель считает, что доступность EUV-оборудования будет ограничивать быстрое расширение мощностей как минимум до конца этого десятилетия.
Более высокие цены могут стимулировать инвестиции, но не могут мгновенно создать полностью валидированный передовой завод.
Значительная часть недавнего роста чипов для ИИ связана с переносом передовых производственных мощностей с других продуктов.
Смартфоны, персональные компьютеры, сетевые чипы и другие устройства конкурируют за одни и те же передовые узлы и упаковочные ресурсы.
Патель ссылается на оценку, согласно которой к концу 2027 года доля ИИ в мощностях N3 компании TSMC может вырасти с примерно 60% до 86%.
Это оценка модели предложения, а не публичное руководство TSMC по мощностям.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Смысл очевиден: рычаг перераспределения работает только до тех пор, пока не-ИИ спрос занимает мощности, которые можно перенаправить.
Как только ИИ уже потребляет большую часть мощностей соответствующего узла, этот рычаг роста значительно ослабевает.
Даже если предложение пластин расширится, вся система может быть ограничена следующими факторами:
Предложение вычислительных мощностей остаётся ограниченным.
Таким образом, это цепочка, а не продукт одного завода.
Эффективные мощности определяются самым медленным критическим звеном.
Источник далее представляет неочевидный аргумент: если вычисления становятся дороже, покупатели не обязательно перейдут на более слабые модели.
Они могут даже предпочесть самые сильные модели.
Патель связывает это с эффектом Альчиана–Аллена.
Когда фиксированные затраты добавляются к товарам разного качества, версии более высокого класса могут стать относительно более привлекательными, потому что премия за качество составляет меньшую долю в общей цене.
Предположим, базовая стоимость вычислений составляет 20 долларов в час.
Сильная модель выполняет задачу за один час с премией в 5 долларов за модель:
Сильная модель:
20 долларов вычислений + 5 долларов премии = 25 долларов
Слабая модель не имеет премии, но из-за повторов и неэффективного вывода требует двух часов:
Слабая модель:
2 × 20 долларов вычислений = 40 долларов
Модель, которая выглядит бесплатной, на самом деле дороже в расчёте на одну выполненную задачу.
Ключевой показатель — не цена за токен или лицензия модели, а стоимость за успешный результат.
Более мощные модели могут снижать затраты за счёт:
Если вычисления дешёвые, затраты на неэффективные попытки могут быть терпимыми.
Если вычисления дорогие, растрата вычислительных мощностей становится более болезненной.
Лаборатория, которая может извлечь максимально полезный результат из каждого дефицитного часа GPU, возможно, сможет устанавливать значительную премию.
Самая радикальная версия исходной статьи утверждает, что у посредственных моделей может не быть будущего.
Этот вывод слишком широк.
Меньшие и специализированные модели сохраняют привлекательность в следующих случаях:
Лёгкий классификатор не должен быть передовым программирующим агентом.
Аргумент Альчиана–Аллена применим, когда обе модели потребляют схожую дорогую инфраструктуру, а более слабой модели требуется значительно больше работы для достижения того же результата.
Когда меньшая модель действительно более эффективна для конкретной задачи, сила этого аргумента ослабевает.
Патель утверждает, что рост цен на вычисления может перераспределить мощности из низкоценных применений.
Если один GPU может запускать агента, приносящего высокоценное программное или коммерческое результат, то альтернативные издержки использования того же оборудования для одноразового медиаконтента становятся значительно выше.
Это может затронуть следующие применения:
Рынок не обязательно уничтожает сам контент.
Он может вместо этого перевести такой контент на:
Ключевым моментом является распределение ресурсов.
Дефицитные передовые вычисления будут стремиться流向 рабочие нагрузки с наивысшей готовностью платить.
Исходная статья также представляет несколько возражений.
Они важны, потому что прогнозы о вечном дефиците ресурсов часто оказываются неверными.
Сравнение с инженером на 250 000 долларов предполагает, что GPU может получать доход, близкий к текущей экономической ценности инженера.
Это предположение может не сработать по следующим причинам:
Некоторые комментаторы отмечают, что начальная ценность цифровых работников может быть высокой, но как только ИИ-труд станет изобильным, она может стабилизироваться на уровне около 50 000 долларов.
В таком сценарии ценность вычислений всё ещё может расти, но не обязательно в 15 раз.
Цена за токен не эквивалентна цене вычислений.
Модели и сервисные системы постоянно улучшаются за счёт:
Кэш
В будущем низкоценные видео- или чат-ответы могут требовать лишь малой доли текущих вычислительных затрат.
Даже если вычисления для передовых агентов станут дорогими, цена на универсальные ИИ-сервисы может продолжать снижаться, поскольку они будут переходить на более эффективные модели и оборудование.
Модели с открытыми весами могут оказывать давление на цены передовых API.
Если несколько моделей предлагают схожие возможности, пользователи могут переключаться между следующими вариантами:
Это ограничивает способность одной лаборатории получать сверхвысокую норму прибыли.
Дефицит вычислений по-прежнему может поднимать цены на базовую инфраструктуру, но конкуренция моделей определяет, какую долю ценности лаборатория сможет сохранить.
Классический ответ на дефицит — инвестиции.
Более высокие цены на вычисления стимулируют:
Патель также согласен, что вычисления в конечном итоге снова подешевеют.
Его аргумент касается текущего переходного периода, когда рост спроса может опережать реакцию долгосрочной физической инфраструктуры.
Источник сравнивает прогнозы о вычислениях со знаменитым пари между биологом Полом Эрлихом и экономистом Джулианом Саймоном.
В 1980 году Эрлих выбрал корзину из пяти металлов, поспорив, что их реальные цены вырастут за следующие десять лет.
К 1990 году цены корзины с поправкой на инфляцию упали, и Эрлих выплатил Саймону пари.
Это пари часто используется для аргументации, что прогнозы дефицита недооценивают инновации, замещение и реакцию предложения.
Историческая интерпретация более
сложна. Анализ показывает, что другой стартовый период мог бы привести к другим победителям.
Патель признает, что его аргумент о вычислениях похож на прогнозы дефицита, которые часто оказывались ошибочными.
Он считает, что вычисления могут отличаться от добычи металлов из-за меньшей краткосрочной эластичности предложения:
Таким образом, разногласия в основном касаются времени.
Смогут ли ценовые сигналы и инновации расширить эффективное предложение вычислений до того, как спрос ИИ превысит текущее строительство?
Вместо того чтобы рассматривать «10 раз» как фиксированный прогноз, аргумент лучше преобразовать в набор измеримых переменных.
Рост цен в 10 раз более вероятен, если:
Менее вероятен, если:
Даже если стоимость вычислений не вырастет в 10 раз, аргумент остается практически значимым.
Отслеживайте:
Если более дешевая модель постоянно ошибается, на деле она не дешева.
Оставляйте дорогие передовые модели для задач, которые действительно от них выигрывают.
Используйте меньшие модели для:
Передавайте наверх только сложные случаи.
Не привязывайте весь продукт к одной модели или одному GPU-провайдеру.
Полезные абстракции включают:
Память
Длительные циклы агентов могут тратить вычисления из-за повторяющегося контекста и чрезмерно больших выходов инструментов.
Направления улучшений:
Компании с предсказуемым спросом могут выиграть от:
Правильная стратегия зависит от уровня утилизации. Зарезервированное оборудование дорого, когда простаивает.
Этот аргумент также смещает внимание с бенчмарков моделей на инфраструктуру.
Важные области включают:
Если интеллект станет ключевым экономическим ресурсом, контроль над этими уровнями приобретет стратегическое значение.
Результатом может стать концентрация.
Лаборатории с лучшими моделями и наибольшими доходами могут перебивать цену новых игроков за дефицитные вычислительные ресурсы. Эти ресурсы помогают улучшать модели, что усиливает доход и облегчает следующую заявку.
Это усиливающийся цикл:
Лучшие модели
    ↓
Более ценные продукты
    ↓
Больше доходов
    ↓
Больше доступа к вычислениям
    ↓
Больше обучения и инференса
    ↓
Лучшие модели
Риск заключается в том, что производство интеллекта может сосредоточиться в руках немногих компаний, способных на огромные инфраструктурные вложения.
Патель считает, что более умные ИИ-модели могут приносить больше дохода на единицу вычислений, а реальное предложение передовых вычислений растет гораздо медленнее. Если спрос и готовность платить будут расти быстрее, чем предложение чипов, электроэнергии и ЦОД, рыночные цены могут резко вырасти.
Нет. Anthropic официально сообщает, что годовой объем дохода в пересчете на текущий темп превысил 47 миллиардов долларов в мае 2026 года. Цифры в 100–150 миллиардов к концу года и 1 триллион в следующем году — это допущения в мысленном эксперименте Пателя, а не корпоративные ориентиры.
Это сравнение исследует, как могли бы цениться вычисления, если бы система, эквивалентная H100, могла содержать ИИ-агента, выполняющего работу, сопоставимую с высокооплачиваемым инженером. Это гипотетический ориентир ценности, а не доказательство того, что каждый H100 уже заменяет инженера.
Epoch AI оценивает, что в 2025 году общий объем мировых ИИ-вычислений в эквиваленте H100 вырос примерно в три раза. Будущий рост неопределен и зависит от производительности чипов, производства, корпусирования, электроэнергии, строительства и капитальных вложений.
Передовым лабораториям нужны безопасные, надежные, масштабные кластеры с высокоскоростными сетями и предсказуемой производительностью.
Долгосрочная доступность. Публичные spot-инстансы не эквивалентны выделенным многолетним развертываниям с сотнями тысяч синхронизированных ускорителей.
Не всегда. Когда самая сильная модель достигает того же результата с меньшим числом токенов, меньшим числом повторов или за меньшее время, дорогие вычисления действительно ей выгодны. Но для узких, низколатентных, приватных или периферийных задач меньшие специализированные модели могут оставаться экономически более выгодными.
Патель не утверждает, что вычисления останутся дорогими навсегда.
Его аргументация касается переходного периода — в течение которого спрос на ИИ может превысить возможности расширения цепочек поставок полупроводников и дата-центров; в более долгосрочной перспективе аппаратное обеспечение и автоматизация могут снова сделать вычислительные мощности дешевле.
Если рост доходов от ИИ замедлится, возможности моделей достигнут потолка, открытые модели станут почти эквивалентной заменой, эффективность сервисов будет расти быстрее, чем спрос, или расширение производства полупроводников и электроснабжения окажется быстрее ожидаемого, этот аргумент будет ослаблен.
AI: расходы OpenAI на вычисления в 2024 году](https://epoch.ai/data-insights/openai-compute-spend): оценка распределения вычислений OpenAI в 2024 году между исследованиями, обучением и инференсом.
Аргумент Двакеша Пателя о десятикратном удорожании вычислений начинается с простой идеи: если один GPU способен разместить ИИ-агента, выполняющего высокоценную интеллектуальную работу, то готовность платить за этот GPU может сместиться в сторону ценности этой работы, а не исторической стоимости сервера.
В сочетании с быстрым ростом доходов Anthropic и оценками того, что глобальные вычислительные мощности ИИ расширяются примерно в 3 раза в год, этот аргумент становится еще более убедительным. Если коммерческий спрос на ИИ будет расти быстрее, корректировка неизбежно произойдет через норму прибыли, распределение вычислений, рост цен на инфраструктуру или некоторую комбинацию этих факторов.
Этот прогноз далеко не определен. Повышение энергоэффективности, открытые модели, более компактные специализированные системы, новые фабрики чипов, новые ускорители и замедление роста возможностей — все это может предотвратить десятикратное удорожание. Исторические прогнозы дефицита ресурсов также часто недооценивали способность к адаптации.
Действительно устойчивое прозрение заключается не в том, что вычисления должны подорожать ровно в 10 раз, а в том, что более умный ИИ может повышать экономическую ценность каждого GPU быстрее, чем физический мир способен производить и обеспечивать энергией новые GPU.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



