DeepSeek V4 Flash 0731 вызвал необычное сочетание реакций. Разработчики впечатлены его показателями в агентном кодинге. Инфраструктурные ком...
DeepSeek V4 Flash 0731 вызвала необычное сочетание реакций.
Разработчики впечатлены её показателями в тестах агентов-программистов.
Инфраструктурные команды заинтересованы в её контексте на 1 миллион токенов и низком количестве активных параметров.
ИИ-платформы предлагают бесплатное использование и агрессивные скидки.
А социальные сети заполняются скриншотами прототипов, чьи заявленные счета за инференс измеряются центами, а не долларами.
Наиболее широко обсуждаемые примеры в исходной статье включали:
Эти примеры передают ажиотаж, но они также могут смешивать несколько различных вещей:
Модель действительно недорогая.
Это не означает, что каждое приложение будет стоить семь центов.
Полезный вопрос не в том, можно ли точно воспроизвести один вирусный демо-ролик. Вопрос в том, как DeepSeek добился такого значительного скачка возможностей без изменения базовой архитектуры — и что новая экономика означает для разработчиков.
Официальная цена API была уже низкой ещё до применения сторонних акций.
DeepSeek в настоящее время указывает следующие цены за миллион токенов:
| Тип использования | Цена DeepSeek V4 Flash |
|---|---|
| Ввод, попадание в кэш | $0,0028 |
| Ввод, отсутствие в кэше | $0,14 |
| Вывод | $0,28 |
API поддерживает:
low, high и max.Эти официальные цены являются базовым уровнем.
Платформы затем могут:
Вот почему один разработчик может платить по прейскуранту DeepSeek, а другой — не платить ничего в течение ограниченного периода.
OpenCode публично заявил, что DeepSeek Flash обработала 8 триллионов токенов 1 августа через свою платформу.
Пост разбивает эту цифру следующим образом:
5 триллионов токенов бесплатного использования
+
3 триллиона токенов через OpenCode Go

В текущей документации OpenCode Zen указан вариант DeepSeek V4 Flash Free, доступный в течение ограниченного времени.
Это важное различие.
Показатель в восемь триллионов токенов описывает трафик через OpenCode, а не прямое использование, о котором сообщает DeepSeek на всех платформах.
Тем не менее это сильный сигнал о том, что недорогие модели могут генерировать огромный спрос, когда они встроены в популярный рабочий процесс кодинг-агента.
Nous Research объявила о семидневной акции, предлагающей DeepSeek V4 Flash 0731 со скидкой 90% через Nous Portal в партнёрстве с Novita Labs.

В промо-посте сравнивалась скидочная цена с Claude Fable 5, и утверждалось, что разница в цене на сопоставимых задачах превышает 1000 раз.
Это сравнение зависит от нескольких факторов:
Сравнение цены за токен полезно, но более значимый показатель:
Общая стоимость за принятую задачу
Модель, использующая меньше дорогих токенов, может оказаться дешевле, чем недорогая модель, которая многократно повторяет попытки.
И наоборот, когда недорогая модель также достаточно способна быстро выполнить задачу, преимущество в стоимости может стать огромным.
Cline изначально анонсировала бесплатное использование V4 Flash 0731 через своего кодинг-агента.
В более позднем публичном посте сообщалось, что бесплатная квота была утроена, поскольку экономика оказалась устойчивой.

В текущем каталоге моделей Cline и материалах ClinePass DeepSeek V4 Flash указана как быстрый и экономичный вариант для целенаправленных задач кодинга.
Бесплатные квоты и доступность моделей могут меняться, поэтому пользователям следует проверять актуальную страницу провайдера, а не полагаться на старый скриншот.
Более широкий урок остаётся неизменным.
Когда инференс становится достаточно дешёвым, платформа агентов может использовать бесплатный доступ как привлечение клиентов, не неся при этом
та же стоимость, с которой он столкнулся бы при использовании премиальной frontier-модели.
В исходной статье приведена панель управления, показывающая:
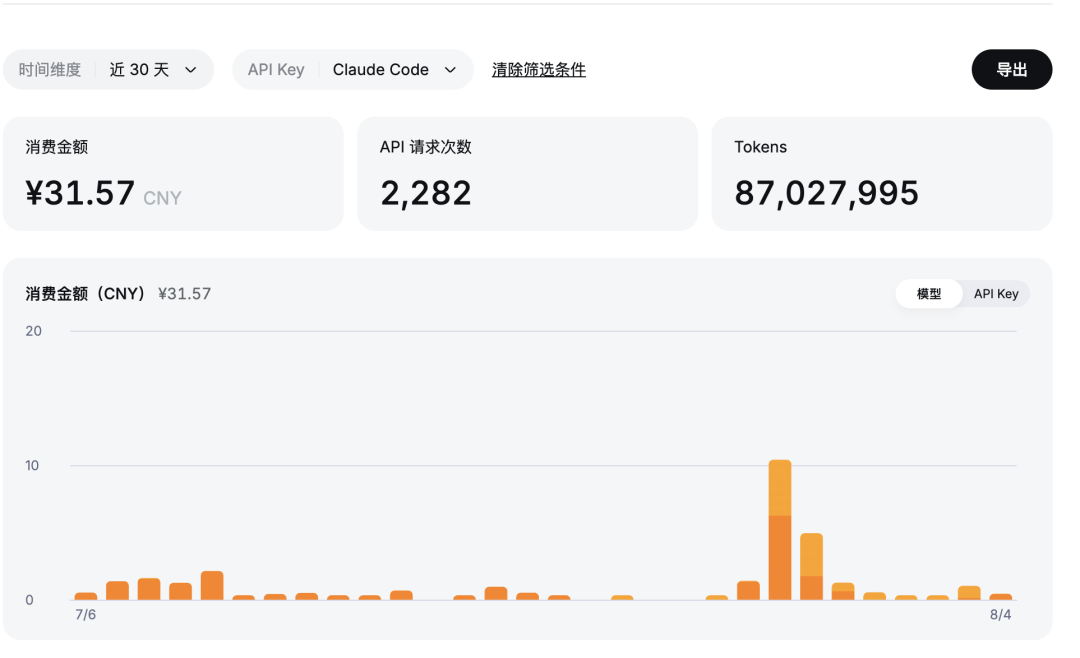
Скриншот полезен, поскольку демонстрирует порядок величин, который разработчики могут увидеть при благоприятных сценариях использования.
Он не содержит достаточно информации для точного восстановления счёта.
Отсутствующие переменные включают:
Длинный повторяющийся системный промпт может быть чрезвычайно дешёвым при попадании в кэш.
Длинный уникальный промпт, отправленный один раз, тарифицируется по цене входных токенов с промахом кэша.
Выходные токены также намного дороже, чем входные с попаданием в кэш.
Для агентных систем эти различия определяют итоговый счёт.
DeepSeek V4 Preview был запущен 24 апреля 2026 года.
Семейство включало:
Релиз Preview заложил основную архитектуру:
V4 Flash Preview позиционировался как меньшая, более быстрая и дешёвая альтернатива V4 Pro.
Обновление от 31 июля изменило его конкурентную позицию.
DeepSeek заявляет, что V4 Flash 0731 использует ту же архитектуру и размер модели, что и V4 Flash Preview.
Обновление было создано путём применения нового процесса пост-обучения.
В упрощённом виде:
Та же предобученная базовая архитектура
+
новое пост-обучение и оптимизация для агентов
=
значительно более сильное агентное поведение при написании кода
Это важно, поскольку показывает, сколько возможностей может оставаться скрытым в предобученной модели.
Архитектура и количество параметров — это не весь продукт.
Пост-обучение определяет, насколько эффективно модель:
Оригинальная карточка модели V4 Flash описывает базовую модель так:
| Спецификация | DeepSeek V4 Flash |
|---|---|
| Всего параметров базовой MoE | 284B |
| Активируемые параметры | 13B |
| Длина контекста | 1M |
| Лицензия | MIT |
| Основная модальность | Текст |
| Базовая точность | FP8 / смешанная низкая точность в зависимости от контрольной точки |
Карточка модели 0731 сообщает, что новый релиз имеет ту же структуру, что и вариант DSpark, и включает прикреплённый модуль спекулятивного декодирования.
Это объясняет, почему некоторые метаданные файлов модели могут показывать
Общее количество контрольных точек превышает 284B базовой модели MoE.
Наиболее точное описание:
Базовая модель MoE в V4 Flash по-прежнему составляет примерно 284B суммарных параметров с 13B активных, а в выпуске 0731 в опубликованную контрольную точку добавлен дополнительный компонент спекулятивного декодирования DSpark.
Спекулятивное декодирование использует быстрый процесс черновика для предложения нескольких будущих токенов.
Затем основная модель проверяет эти предложения.
Когда предсказания принимаются, система может генерировать несколько токенов с меньшим количеством последовательных операций.
В карточке модели DeepSeek 0731 указана явная поддержка DSpark для vLLM и SGLang.
Для vLLM соответствующая конфигурация выглядит так:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Для SGLang в карточке модели используется:
--speculative-algorithm DSPARK
DSpark сам по себе не улучшает логические способности модели.
Это оптимизация инференса, направленная на снижение задержки декодирования или повышение пропускной способности при сохранении распределения выходных данных целевой модели в поддерживаемой конфигурации.
DeepSeek публикует следующее сравнение для V4 Flash 0731:
| Бенчмарк | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 | 12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents’ Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
Наиболее значительный рост — у DeepSWE:
7.3 → 54.4
CyberGym почти удваивается:
38.7 → 76.7
Terminal Bench 2.1 поднимается более чем на двадцать пунктов:
61.8 → 82.7
Новая модель Flash также превосходит V4 Pro Preview во всех бенчмарках из опубликованной таблицы DeepSeek.
Это значительное изменение для модели, которая изначально позиционировалась в основном как более дешёвый и быстрый вариант.
Таблицу не следует воспринимать как чистое сравнение исходных контрольных точек.
В карточке модели DeepSeek содержится несколько важных примечаний.
Для задач публичного код-агента компания использовала:
DeepSeek Harness minimal mode
Reasoning effort: max
Temperature: 1.0
Top-p: 0.95
DeepSeek Harness не был публично выпущен на момент проверки.
Это означает, что внешние исследователи, возможно, пока не смогут воспроизвести точное программное окружение, использованное для опубликованных результатов код-агента.
Два теста также являются внутренними:
Внутренние бенчмарки могут быть полезны для разработки продукта, но независимые команды не могут проверить их скрытые задачи или средства контроля загрязнения.
Правильная интерпретация такова:
DeepSeek сообщает о значительном улучшении в рамках выбранного агентного стека и конфигурации оценки. Публичная воспроизводимость улучшится, когда станут доступны harness, промпты, логи и полная конфигурация оценки.
Бенчмарк для кода часто измеряет всю систему:
Модель
+
системный промпт
+
инструменты репозитория
+
терминал
исполнение
+
управление контекстом
+
политика повторов
+
обратная связь по тестам
+
логика отправки патчей
Одна и та же модель может получать разные оценки при изменении одного компонента.
Лучшая обвязка может:
Это не делает модель несущественной.
Это означает, что результат бенчмарка принадлежит комбинации модели и обвязки.
Сильные показатели 0731 позволяют предположить, что DeepSeek улучшил как агентное поведение модели, так и окружающий процесс оценки.
Artificial Analysis сообщает об индексе интеллекта примерно 50 для DeepSeek V4 Flash 0731, примерно на десять пунктов выше предыдущей версии Flash.
Независимая аналитическая фирма также описывает V4 Flash как исключительно недорогую по сравнению с другими известными фронтирными системами.
Reuters резюмировал выводы Artificial Analysis, сообщив о средней стоимости теста-бенчмарка примерно в три цента США по их методологии.
Это сравнение подтверждает аргумент о ценности.
Это не означает, что каждая производственная задача стоит три цента.
Artificial Analysis также сообщает о более слабых результатах по некоторым показателям надёжности знаний.
В статье о V4 Flash 0731 отмечается:
Эти цифры — полезное напоминание.
Модель может быть:
«Лучшая ценность» — это не то же самое, что «лучшая для любой задачи».
Прямая цена DeepSeek API:
| Категория тарификации | Цена за 1 млн токенов |
|---|---|
| Вход с попаданием в кэш | $0.0028 |
| Вход без попадания в кэш | $0.14 |
| Выход | $0.28 |
Разрыв в цене между попаданием в кэш и его отсутствием огромен:
$0.14 ÷ $0.0028 = 50
Кэшированный вход в пятьдесят раз дешевле некэшированного.
Для долгоживущих агентов структура промпта становится структурой затрат.
Предположим, один запрос использует:
100 000 некэшированных входных токенов
20 000 выходных токенов
Прямая стоимость модели:
Вход:
100 000 / 1 000 000 × $0.14
= $0.014

Выход:
20 000 / 1 000 000 × $0.28
= $0.0056

Итого:
$0.0196
Это меньше двух центов США.
Теперь предположим, что тот же префикс из 100 000 токенов кэширован:
Кэшированный вход:
100 000 / 1 000 000 × $0.0028
= $0.00028

Выход:
20 000 / 1 000 000 × $0.28
= $0.0056

Итого:
$0.00588
Теперь основную часть счёта составляет выход.
Эти примеры объясняют, почему недорогие прототипы для кодинга правдоподобны.
Они не включают:
Агентный кодинг — это редко один запрос.
Типичный рабочий процесс может включать:
failure.
7. Отредактируйте снова.
8. Запустите тесты снова.
9. Просмотрите изменения.
10. Подготовьте окончательный ответ.
Каждый шаг может привести к новому вызову модели.
Кажущаяся небольшой задача может стать дорогостоящей, когда:
V4 Flash снижает цену таких ошибок.
Но не устраняет их.
DeepSeek использует дисковое кэширование контекста.
При повторном использовании одного и того же префикса совпадающие входные токены могут получить более низкую цену попадания в кэш.
Хорошие кандидаты для стабильного префикса включают:
Упрощённая структура промпта выглядит так:
Стабильный повторяемый префикс
+
новый запрос пользователя
+
последний результат инструмента
Менее удобная для кэширования структура:
Переупорядоченные инструкции
+
переписанная сводка репозитория
+
изменяющиеся временные метки
+
случайные метаданные запроса
+
новый запрос пользователя
Небольшие изменения префикса могут снизить повторное использование кэша.
Разработчикам следует проверять поля использования токенов, а не предполагать, что длинный промпт был закэширован.
DeepSeek также предлагает изоляцию user_id для конфиденциальности и планирования. Повторное использование кэша и изоляция пользователей должны проектироваться вместе, чтобы контекст одного клиента случайно не смешивался с контекстом другого.
Официальный базовый URL остаётся:
https://api.deepseek.com
Идентификатор модели:
deepseek-v4-flash
DeepSeek заявляет, что стабильный идентификатор API автоматически обслуживает последнюю официальную версию Flash.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Это удобно, но производственные команды должны записывать возвращаемый отпечаток модели и проверять изменения, поскольку поведение за стабильным идентификатором может быть обновлено.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this function and propose a safe refactor.",
        }
    ],
)

print(response.choices[0].message.content)
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Write a small Python CLI that validates JSON files."
      }
    ]
  }'
Разработчикам следует проверять актуальную справочную документацию API для точных полей reasoning-effort и thinking-mode, поддерживаемых их конечной точкой и версией SDK.
Документация DeepSeek по режиму мышления гласит, что когда в ходе обмена присутствуют вызовы инструментов, reasoning_content из сообщения ассистента должен передаваться обратно в последующих запросах.
Многошаговый агент должен сохранять:
contentreasoning_content
tool_callsУдаление состояния рассуждений может снизить непрерывность или вызвать проблемы с проверкой запросов.
Это особенно актуально при интеграции через OpenAI-совместимый клиент, который обычно игнорирует поля рассуждений, специфичные для провайдера.
DeepSeek предоставляет более чем один интерфейс.
Используйте стандартный базовый URL DeepSeek и идентификатор модели:
deepseek-v4-flash
DeepSeek также документирует интерфейс в формате Anthropic.
Это может помочь программному обеспечению, построенному вокруг сообщений в стиле Claude, подключаться к DeepSeek с меньшим количеством изменений в приложении.
Совместимость не гарантирует идентичного поведения.
Поля, специфичные для провайдера, история рассуждений, схемы инструментов, поведение безопасности и обработка ошибок все еще требуют тестирования.
DeepSeek сообщает, что релиз 0731 нативно поддерживает формат Responses API и был адаптирован для использования в стиле Codex.
Это важно для продуктов кодинг-агентов, которые все больше зависят от объектных ответов с состоянием, вызовов инструментов и структурированных циклов агента.
DeepSeek выпустил веса V4 Flash 0731 на Hugging Face под лицензией MIT.
Это позволяет разработчикам просматривать, изменять, развертывать и распространять модель в соответствии с условиями лицензии.
Релиз с открытыми весами обеспечивает больше контроля, чем модель, доступная только через API.
Команды могут:
Практическим барьером является аппаратное обеспечение.
«Открытые веса» не означает «работает на обычном ноутбуке».
Официальная карточка модели 0731 предоставляет пример vLLM для одного узла 4×GB300:
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --data-parallel-size 4 \
  --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Этот пример демонстрирует класс инфраструктуры, ожидаемый для полноценного обслуживания.
Его не следует интерпретировать как единственную поддерживаемую конфигурацию.
Рецепт vLLM может со временем добавить поддержку других топологий GPU.
Официальный пример SGLang:
sglang serve \
  --trust-remote-code \
  --model-path deepseek-ai/DeepSeek-V4-Flash-0731 \
  --tp 4 \
  --moe-runner-backend flashinfer_mxfp4 \
  --speculative-algorithm DSPARK \
  --mem-fraction-static 0.90 \
  --chunked-prefill-size 4096 \
  --swa-full-tokens-ratio 0.1
Целевые и черновые веса взяты из одной контрольной точки, поэтому в документации указано не задавать отдельный путь к черновой спекулятивной модели.
Движки вывода быстро развиваются.
Используйте текущую карточку модели и рецепт серверного движка, а не копируйте старую команду запуска из предварительного релиза.
Хотя всего лишь около
13B параметров активны для одного токена, полные веса модели должны оставаться доступными во всей обслуживающей системе.
Планирование развертывания должно учитывать:
Меньшие квантизации могут сделать возможным экспериментирование на разном оборудовании, но они могут изменить качество, скорость или поддерживаемую длину контекста.
Для большинства индивидуальных разработчиков прямой API или хостинг-провайдер будут проще и дешевле, чем самостоятельное размещение.
Существует три распространенных способа использования V4 Flash.
| Маршрут | Главное преимущество | Главный компромисс |
|---|---|---|
| DeepSeek API | Официальные цены и актуальная официальная модель | Данные покидают вашу среду; стабильный ID может обновляться |
| Сторонняя платформа | Бесплатные квоты, интегрированные агенты, упрощенный биллинг | Акции и маршрутизация могут меняться |
| Самостоятельное размещение | Максимальный контроль и конфиденциальность | Значительные требования к оборудованию и инженерии |
Самый дешевый маршрут зависит от рабочей нагрузки.
Бесплатная квота Cline или OpenCode может быть лучшей для экспериментов.
Прямой API может быть лучшим для предсказуемого использования в небольших масштабах.
Самостоятельное размещение может стать привлекательным только при достаточно высоком, устойчивом объеме или когда требования конфиденциальности доминируют.
Исходная статья сравнивает недорогой ИИ с массовым производством автомобилей.
Аналогия несовершенна, но полезна.
Когда технология становится значительно дешевле, рынок не просто покупает то же количество за меньшие деньги.
Становятся возможными новые применения.
Недорогие агентные модели могут поддерживать эксперименты, которые ранее были бы отклонены до тестирования.
Примеры включают:
Ценность не в том, что модель заменяет всю программную инженерию.
Она снижает стоимость вопроса:
Стоит ли развивать эту идею дальше?
Дешевая генерация может создать убедительное первое демо.
Производственный продукт все еще требует:
Счет на семь центов за модель не означает бизнес на семь центов.
Это означает, что первый вычислительный эксперимент может быть достаточно дешевым, чтобы его стоит попробовать.
Это меняет то, кто может участвовать и сколько идей можно протестировать.
Исходная статья включает легковесное рабочее пространство для документов, показанное как один из примеров того, что разработчики создавали с помощью недорогих агентов для кодирования.
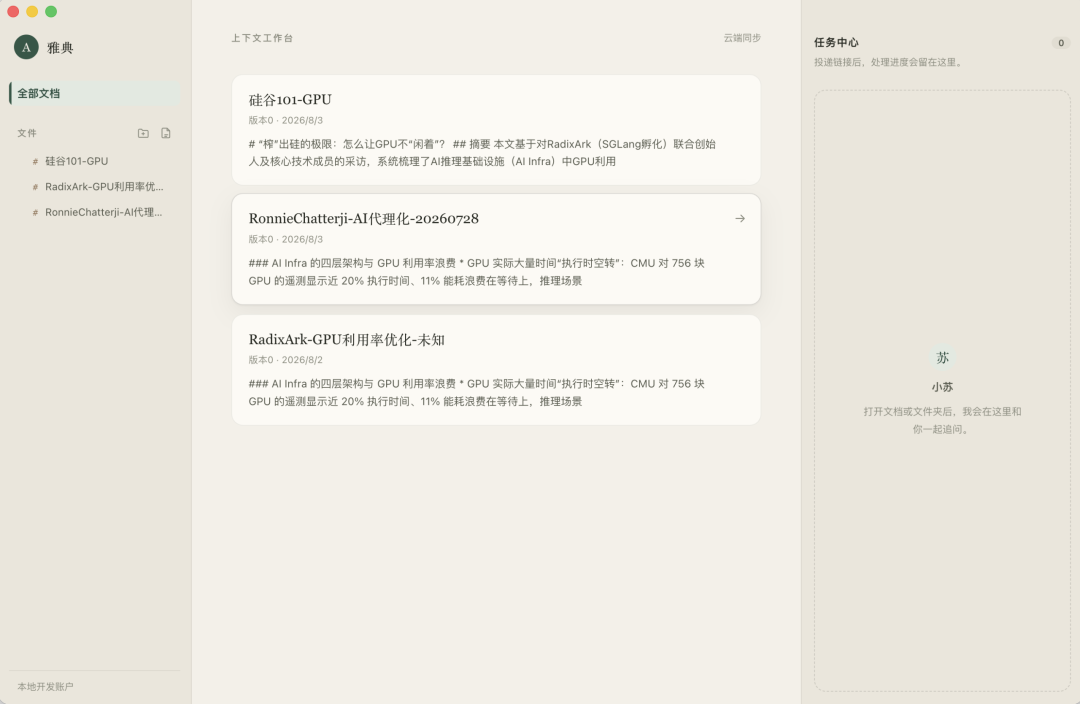
Скриншот не может установить, какая часть приложения была создана моделью, сколько потребовалось ручного редактирования и является ли продукт безопасным и поддерживаемым.
Тем не менее он показывает тип проекта, прототипирование которого облегчают недорогие модели генерации кода.
V4 Flash 0731 особенно привлекателен, когда:
Он может быть менее подходящим, когда:
Маршрутизатор моделей может комбинировать Flash с более мощной или более специализированной системой.
Например:
Обычные правки репозитория
→ V4 Flash

Решения с высоким риском по архитектуре или безопасности
→ более мощная модель + проверка человеком
Когда вызовы моделей дороги, разработчики стараются минимизировать каждый запрос.
Когда вызовы становятся дешёвыми, агент может позволить себе:
Это может повысить надёжность.
Это также может привести к лишней трате токенов.
Правильная цель — не минимальное использование токенов.
Она состоит в следующем:
Минимальная общая стоимость при достижении требуемого качества
DeepSeek описывает официальный API Flash как публичную бета-версию.
Цены, поведение, лимиты и версии моделей могут измениться.
Производственным командам следует поддерживать регрессионное тестирование.
Наиболее сильные результаты для код-агентов получены с использованием неопубликованной конфигурации harness.
Точное независимое воспроизведение пока затруднено.
Вывод, повторные попытки, инструменты и некэшированный контекст могут доминировать в итоговой стоимости.
Окно в 1 миллион токенов — это предел ёмкости, а не рекомендация отправлять миллион токенов в каждом запросе.
Большие объёмы предзагрузки увеличивают задержку и стоимость.
Независимая оценка показывает, что ценность и сила в коде могут сосуществовать с высокой частотой галлюцинаций в фактических тестах.
Критические факты следует проверять по источникам.
Недорогие модели могут генерировать больше кода, чем команда может безопасно проверить.
Автоматические тесты, статический анализ, сканирование зависимостей и проверка человеком остаются необходимыми.
Сторонние бесплатные модели и скидки могут исчезнуть.
Не стройте постоянную бизнес-модель вокруг семидневной или временной субсидии.
ID модели deepseek-v4-flash указывает на текущую версию.
Обновление за этим ID может изменить выходные данные без изменения кода в вашем приложении.
Поддерживайте согласованность системных инструкций и определений инструментов для улучшения повторного использования кэша.
Не полагайтесь только на общее количество входных токенов.
Установите реалистичный бюджет выходных данных для задачи.
Оставляйте max для задач, которые выигрывают от более длительного обдумывания.
Останавливайте циклы, которые не приносят прогресса.
Используйте линтеры, тесты, валидаторы схем и детерминированные проверки.
Эскалируйте только тогда, когда задача не проходит тест или превышает порог риска.
Включайте неудачные попытки и проверку человеком.
Исходная статья завершается возможным следующим шагом в экосистеме разработчиков DeepSeek.
Тяньи Цуй, указанный в источнике как ответственный за DeepSeek Harness, опубликовал сообщение о найме разработчиков для проектов агентных харнесов с открытым исходным кодом.
В сообщении заинтересованным разработчикам предлагалось поделиться аккаунтом GitHub и репрезентативными работами с открытым исходным кодом для участия во внутреннем тестировании.
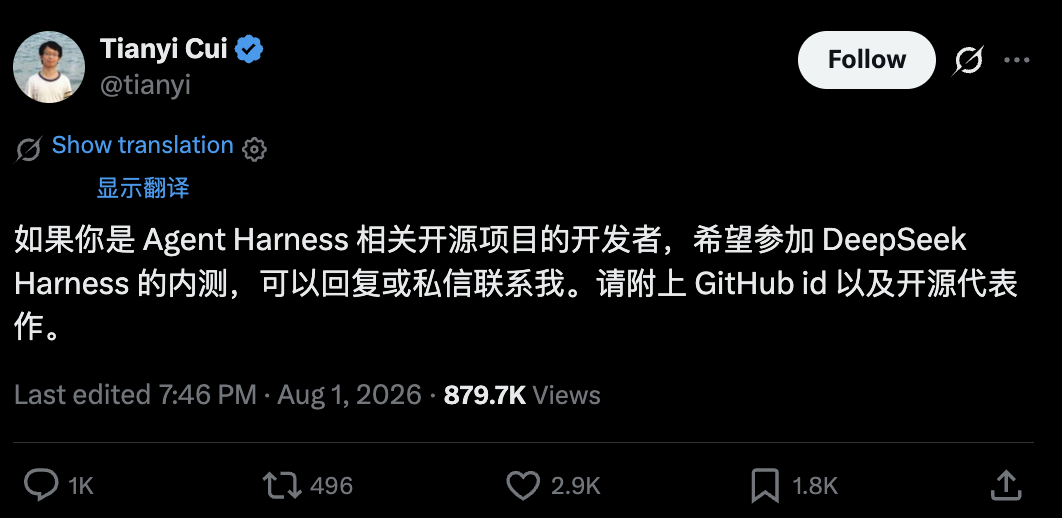
В журнале изменений DeepSeek от 31 июля также говорится, что минимальный режим DeepSeek Harness, используемый для оценки бенчмарков, «будет выпущен в ближайшее время».
По состоянию на момент проверки я не нашёл:
Доказательства подтверждают следующий более узкий вывод:
DeepSeek тестирует агентный харнес и намерен выпустить как минимум часть фреймворка, но окончательное название продукта, публичный охват и сроки запуска остаются неподтверждёнными.
Модель, API и открытые веса доступны уже сейчас.
Харнес — это будущий компонент экосистемы.
Собственный харнес может помочь DeepSeek контролировать весь стек кодинг-агента.
Он может предоставить:
DeepSeek уже документирует интеграции с внешними харнесами и кодинг-агентами.
Собственный инструмент первой стороны может превратить оптимизации под конкретные бенчмарки в продукт, доступный обычным разработчикам.
Он также может показать, какая часть скачка V4 Flash 0731 в бенчмарках обусловлена чекпоинтом, а какая — средой выполнения агента.
Ряд событий определит, станет ли момент V4 Flash устойчивым сдвигом в экосистеме.
DeepSeek заявляет, что официальный релиз V4 Pro последует за обновлением Flash.
Разрыв в производительности и цене между Pro и Flash повлияет на решения о маршрутизации.
Публичный релиз улучшил бы воспроизводимость бенчмарков и дал бы разработчикам нативный агентный фреймворк от самой модели.
Прямая цена уже низкая, но сторонние акции могут не сохраниться.
Дешёвый инференс привлекает очень высокий трафик.
Задержки, лимиты скорости и надёжность будут иметь значение по мере роста использования.
vLLM, SGLang, производители оборудования и проекты по квантованию определят, насколько доступным станет самостоятельный хостинг.
Больше публичных оценок должны проверить:
DeepSeek V4 Flash 0731 — это официальный релиз V4 Flash от 31 июля, который в настоящее время доступен через API deepseek-v4-flash в публичной бете. DeepSeek заявляет, что модель сохраняет базовую архитектуру и размер Preview-версии, но значительно улучшает агентные возможности за счёт нового пост-обучения.
Официальный API DeepSeek указывает $0,14 за миллион токенов ввода без попадания в кэш, $0,0028 за миллион токенов ввода с попаданием в кэш и $0,28 за миллион токенов вывода. Сторонние платформы могут предлагать другие цены, бесплатные квоты или временные скидки.
В исходной статье приводится пример из сообщества с указанной расчётной стоимостью модели. Пример не сопровождается полными промптами, журналами токенов, данными о кэше, повторами, затратами на инструменты или записями о ручной работе, поэтому его следует рассматривать как anecdote, а не как гарантированный бюджет.
DeepSeek сообщает о 82,7 в Terminal Bench 2.1, 76,7 в CyberGym, 54,4 в DeepSWE, 70,3 в Toolathlon-Verified и 54,2 в NL2Repo. Публичные оценки кодовых агентов использовали невыпущенный минимальный режим DeepSeek Harness с максимальными усилиями рассуждения.
Веса модели и репозиторий выпущены под лицензией MIT, поэтому описания «открытые веса» и «широко разрешительное использование» точны. Для запуска полного чекпоинта по-прежнему требуется значительная много-GPU инфраструктура.
Да, DeepSeek публикует веса и инструкции по обслуживанию для vLLM и SGLang. Официальные полноценные примеры используют продвинутое много-GPU оборудование, поэтому обычный ноутбук не является целевой средой для полной модели.
Официальный API и карточка модели указывают контекстное окно в 1 миллион токенов. API также указывает
Максимальная длина выходных данных составляет 384 тыс. токенов, однако использование максимального контекста или выходных данных может значительно увеличить задержку и потребление ресурсов.
Компания DeepSeek публично упоминала минимальный режим Harness и привлекала разработчиков открытого исходного кода для внутреннего тестирования. В ходе проверки не было обнаружено полного публичного репозитория, финальной спецификации продукта или подтверждённой даты выпуска.
reasoning_content при вызовах инструментов.DeepSeek V4 Flash 0731 сохраняет базовую модель Preview
Архитектура и размер сохранены, но новое пост-обучение обеспечивает значительный скачок в производительности агентов для программирования. DeepSeek сообщает о 82,7 на Terminal Bench 2.1, 76,7 на CyberGym и 54,4 на DeepSWE, хотя сильнейшие публичные результаты для агентов зависят от неопубликованной конфигурации DeepSeek Harness.
Официальная цена API необычно низкая: $0,14 за миллион некэшированных входных токенов, $0,0028 за миллион кэшированных входных токенов и $0,28 за миллион выходных токенов. Сторонние бесплатные квоты и скидки могут сделать доступ ещё дешевле, но эти акции временны и не должны путаться с постоянной прейскурантной ценой.
Релиз с открытыми весами по лицензии MIT, контекст на 1 миллион токенов, совместимость с API Responses и Anthropic, а также поддержка в vLLM и SGLang делают модель доступной как через хостинг, так и при самостоятельном развёртывании. Полное локальное развёртывание остаётся серьёзным инфраструктурным проектом, требующим нескольких GPU.
Вирусные прототипы за семь и пятьдесят центов — наглядные примеры того, насколько низким может стать предельный счёт за модель, но они не являются полноценными исследованиями стоимости продукта. Циклы агентов, длина выходных данных, промахи кэша, инструменты, тестирование и человеческий труд по-прежнему имеют значение.
DeepSeek V4 Flash 0731 важен не потому, что каждое приложение теперь стоит несколько центов, а потому, что способное агентное программирование стало достаточно дешёвым, чтобы гораздо больше разработчиков могли экспериментировать в значимых масштабах.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



