DeepSeek V4 Flash 0731 вышла в открытую бета-версию со знакомым обещанием: более мощные возможности кодинга и агентности при крайне низких ц...

DeepSeek V4 Flash 0731 вышел в открытую бета-версию со знакомым обещанием: повышенная производительность в кодинге и агентные возможности по крайне низким ценам на API.
Разработчики быстро превратили это заявление в реальные эксперименты.
Один из самых вирусных примеров — запуск Hermes Agent, в ходе которого DeepSeek V4 Flash сгенерировал играбельный шутер от первого лица в 3D всего по одному стартовому промпту. По сообщениям, проект занял 32 минуты, а стоимость использования модели составила всего 0,07 доллара.
Итоговый результат включал:
DeepSeek V4 поддерживает окно контекста в 1 миллион токенов.
Традиционные системы внимания становятся чрезвычайно дорогими в таких масштабах, поскольку каждый новый токен может потребовать обработки большого объёма предыдущего контекста и поддержания значительного KV-кэша.
В техническом отчёте DeepSeek описывается гибридная конструкция внимания, сочетающая:
Общая стратегия заключается в том, чтобы избегать полных и дорогостоящих вычислений внимания по всей истории на каждом шаге.
Система сжимает и фильтрует контекст, позволяя модели сосредоточить вычисления на наиболее полезной информации.
DeepSeek сообщает, что в контексте из 1 миллиона токенов V4 Pro требует:
27% от FLOPs на токен вывода DeepSeek V3.2.
Эти точные проценты указаны в техническом документе для V4 Pro и не являются отдельными данными аудита для Flash.
V4 Flash использует то же семейство архитектур, поэтому наследует те же принципы проектирования длинного контекста.
Практический эффект включает снижение:
и трафик памяти
Опубликованная модель V4 Flash использует смешанную низкую точность весов.
DeepSeek указывает:
FP4 + FP8 смешанная точность
Более низкая точность уменьшает объём данных, которые необходимо хранить, загружать из памяти, передавать между устройствами и обрабатывать во время инференса.
Это важно, потому что современный инференс языковых моделей часто ограничен пропускной способностью памяти, а не только вычислительной мощностью.
Если аппаратное обеспечение и ядра спроектированы для эффективного выполнения таких форматов, более компактное представление данных может повысить пропускную способность.
Низкая точность не является автоматически бесплатной.
Плохая квантизация снижает качество модели.
Релиз DeepSeek спроектирован и обучен под выбранную схему точности, а не полагается на постфактум-квантизацию сторонними сообществами.
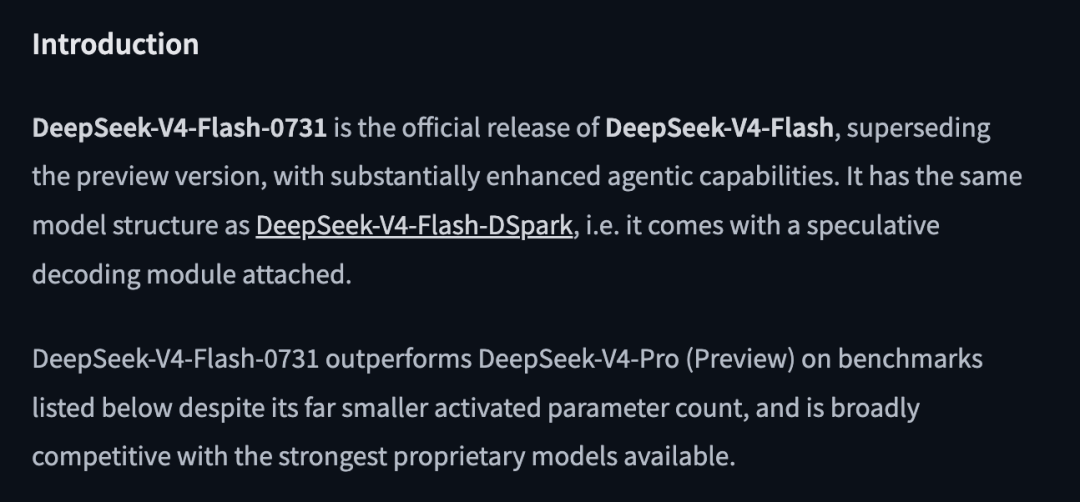
DeepSeek заявляет, что официальная версия 0731 сохраняет ту же архитектуру и масштаб модели, что и предварительная версия V4 Flash.
Компания не проводила полное предварительное обучение заново для этого обновления.
Вместо этого был переделан этап пост-обучения.
В исходной статье изменения резюмируются так:
В техническом отчёте DeepSeek более широкий процесс пост-обучения V4 описывается так:
Обновление 0731 сосредоточено на улучшении этих возможностей в реальных сценариях работы агентов.
DeepSeek-V4-Flash-0731 поставляется с модулем спекулятивного декодирования DSpark.
Спекулятивное декодирование использует более маленький или более дешёвый путь-черновик для предложения нескольких будущих токенов.
Основная модель пакетно проверяет эти предложения.
Упрощённый процесс выглядит так:
Черновой модуль предлагает токены
→ Основная модель одновременно проверяет
→ Принятые токены выводятся
→ Отклонённые пути исправляются
Когда прогнозы черновика точны, система может генерировать несколько принятых токенов с меньшим количеством дорогих последовательных рассуждений основной модели.
DeepSeek предоставляет поддержку DSpark для vLLM и SGLang.
Для vLLM официальная карточка модели использует:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Для SGLang соответствующий параметр:
--speculative-algorithm DSPARK
DeepSeek указывает, что веса целевой и черновой моделей хранятся в одном чекпоинте, поэтому SGLang не требует отдельного пути для черновой модели.
Спекулятивное декодирование в первую очередь повышает скорость обслуживания и пропускную способность.
Само по себе оно не объясняет улучшение рассуждений модели.
Эти улучшения связаны с обновлённым процессом пост-обучения.
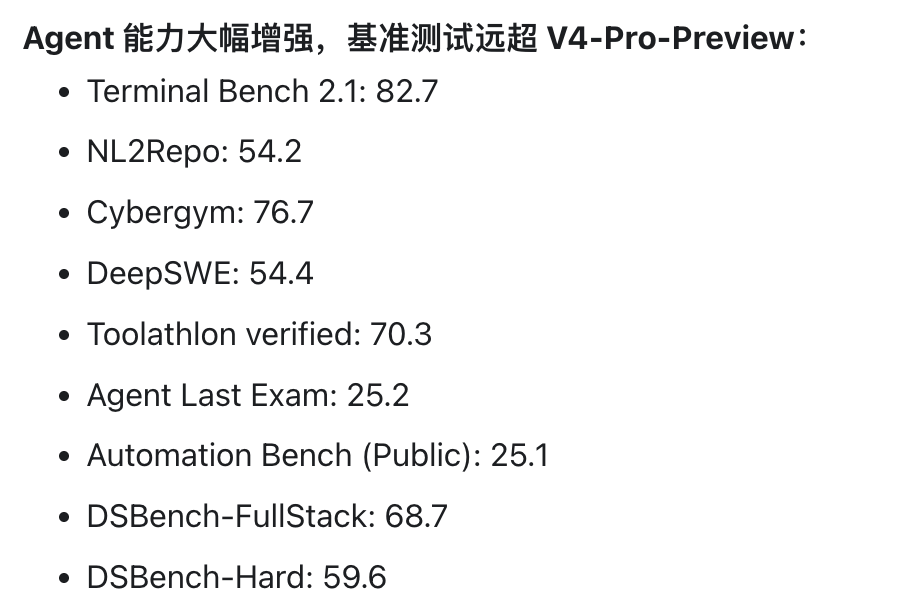
DeepSeek сообщает о значительных улучшениях по ряду агентских тестов по сравнению с предварительной версией V4 Flash.
| Бенчмарк | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 |
12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
DeepSeek сообщает, что публичные бенчмарки для кодовых агентов запускались со следующими настройками:
DeepSeek Harness минимальный режим
reasoning_effort = max
top_p = 0.95
temperature = 1.0
На момент официального обновления этот фреймворк тестирования ещё не был опубликован.
DSBench-FullStack и DSBench-Hard — внутренние бенчмарки DeepSeek.
Это означает, что их результаты могут служить свидетельством заявлений компании, но не могут быть независимо проверены так же, как полностью открытые наборы тестов.
Terminal Bench оценивает способность агента выполнять задачи в терминальной среде.
Модели может потребоваться просматривать файлы, выполнять команды, устанавливать зависимости, отлаживать сбои, изменять код и проверять завершение.
Высокий балл отражает совокупную производительность модели, фреймворка агента, стратегии использования инструментов, бюджета рассуждений и среды выполнения.
Toolathlon оценивает длительные задачи с использованием нескольких программных приложений и инструментов.
Бенчмарк включает сценарии, связанные с календарём, файловой системой, Notion, WooCommerce, Kubernetes и BigQuery.
Задачи требуют множества взаимодействий с инструментами и проверяются с помощью исполняемых оценщиков.
Результат 70.3, о котором сообщает DeepSeek, представляет собой значительное улучшение по сравнению с предварительной моделью.
Но это не следует интерпретировать как гарантию 70.3% успеха для каждого реального бизнес-процесса.
Пример игры из источника раскрывает важное различие между производительностью в бенчмарках и творческим программированием.
V4 Flash показывает высокие результаты в официальных агентских оценках, но для одного игрового сравнения всё же потребовалось три итерации.
Бенчмарки могут измерять частоту успеха на чётко определённых наборах задач с известными правилами оценки.
Творческие проекты могут включать нечёткие визуальные требования, проблемы совместимости с браузером, ошибки физического движка, отсутствующие ресурсы, субъективные оценки качества и отсутствие единого набора тестов для определения успеха.
В таких сценариях недорогие модели особенно полезны, потому что рабочий процесс может позволить несколько итераций.
Их ценность не обязательно в том, что первая генерация будет идеальной.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Это может быть:
Приемлемое качество
×
Большое количество доступных по цене попыток
DeepSeek предоставляет доступ к моделям следующими способами:
Базовый URL для совместимости с OpenAI:
https://api.deepseek.com
Базовый URL для совместимости с Anthropic:
https://api.deepseek.com/anthropic
DeepSeek заявляет, что V4 Flash — единственная модель V4 API, которая в настоящее время поддерживает API Responses.
Поддержка V4 Pro будет организована отдельно.
Совместимость с API Responses также позволяет использовать эту модель в Codex через документированную конфигурацию DeepSeek.
DeepSeek V4 Flash поддерживает режим рассуждений и режим без рассуждений.
Режим рассуждений является режимом по умолчанию.
Для локального вывода официальная карточка модели поддерживает три уровня усилий рассуждений:
low
high
max
DeepSeek рекомендует:
temperature = 1.0
top_p = 0.95
для сценариев с агентами.
Для уровней усилий high и max компания рекомендует разрешать максимальную длину вывода до 384K токенов.
Более высокие настройки рассуждений могут улучшить производительность на сложных задачах, но также могут увеличить задержку, объём вывода, стоимость API и время циклов агента.
Производственные системы должны оценивать самый низкий уровень усилий, способный надёжно удовлетворять требованиям задачи.
DeepSeek опубликовала веса V4 Flash 0731 на Hugging Face под лицензией MIT.
Это делает модель исключительно либеральной по лицензированию по сравнению со многими крупными коммерческими релизами.
Разработчики могут использовать официальный репозиторий модели с поддерживаемыми движками, включая:
Модель имеет большой размер.
Основная модель имеет 284B параметров, а в контрольной точке 0731 также присутствует компонент DSpark.
Для работы с приемлемой скоростью требуются значительные объёмы памяти и аппаратные ресурсы.
Возможность загрузки весов не означает, что полная модель сможет плавно работать на обычном потребительском ноутбуке.
Квантованные версии сообщества могут снизить требования к памяти, но могут изменить точность, пропускную способность, ёмкость контекста, поведение DSpark и надёжность вызова инструментов.
Источники в итоге приходят к выводу, что V4 Flash не всегда даёт лучший результат в каждом сравнении, но его очень трудно превзойти по соотношению цена/качество.
Это разумное резюме примеров, но с одной важной оговоркой:
Соотношение цена/качество зависит от полного рабочего процесса.
V4 Flash особенно привлекателен в следующих случаях:
В следующих случаях более дорогие передовые модели в целом могут всё же оказаться более экономичными:
Правильное сравнение — не:
цена за токен
а:
стоимость за каждую подтверждённую успешную задачу
Не тестируйте только отполированные демонстрации.
Используйте задачи, соответствующие производственной нагрузке, включая сложные и трудные сценарии.
Сохраняйте единообразие подсказок, инструментов, ограничений по времени, стратегий повтора, фреймворков, песочниц, тестовых наборов и настроек рассуждений между моделями.
Отслеживайте входные данные без попадания в кэш, входные данные с попаданием в кэш, выходные токены, вызовы инструментов, количество повторов, время выполнения, ручные проверки и неудачные попытки.
Для кода запускайте тесты и проверяйте поддерживаемость.
Для игр проверяйте управление, столкновения, производительность и совместимость с браузером.
Когда стабильный контекст многократно повторно используется на нескольких шагах агента, модель с крайне низкой ценой при попадании в кэш становится ещё более ценной.
Модель, которой потребовалось три дешёвые попытки для успеха, может быть более выгодной, чем модель, которая сразу достигла успеха по высокой цене.
Когда повторные попытки медленные или рискованные, ситуация может быть обратной.
DeepSeek V4 Flash 0731 — это официальная пост-тренировочная версия младшей модели DeepSeek V4 с смешанными экспертами. Она заменяет предварительную версию, добавляет модуль спекулятивного декодирования DSpark и ориентирована на задачи кодирования и агентов, использующих инструменты.
Текущие стандартные цены DeepSeek: 0,0028 доллара за миллион входных токенов с попаданием в кэш, 0,14 доллара за миллион входных токенов без попадания в кэш и 0,28 доллара за миллион выходных токенов. Компания объявила, что будущая политика удвоит цены в указанные пиковые часы.
Один разработчик сообщил, что один запуск Hermes Agent сгенерировал играбельный шутер от первого лица за 32 минуты при стоимости 0,07 доллара. Это пример из социальных сетей, а не стандартизированный бенчмарк, поэтому стоимость других задач может быть выше или ниже.
В техническом отчёте V4 указано, что общее количество параметров основной модели Flash составляет 284 миллиарда, при этом активируется 13 миллиардов параметров на токен. Полный репозиторий версии 0731 может показывать около 304 миллиардов параметров, поскольку включает дополнительный компонент спекулятивного декодирования DSpark.
Низкая стоимость обусловлена разреженной активацией смешанных экспертов, сжатым вниманием к длинному контексту, смешанной точностью FP4/FP8, кэшированием подсказок, спекулятивным декодированием и высококонкурентным обслуживанием. На каждый токен активируется лишь небольшая часть всех экспертов.
При текущих ценах API он значительно дешевле и показал конкурентоспособные результаты в нескольких демонстрациях сообщества. Opus 5 и GPT-5.6 могут по-прежнему обеспечивать более высокую надёжность первого прохода или качество в некоторых задачах, а вирусные сравнения не являются контролируемыми бенчмарками.
Да. DeepSeek опубликовала веса под лицензией MIT и предоставила инструкции по использованию с vLLM и SGLang. Полная модель чрезвычайно велика, поэтому реальное локальное развёртывание требует значительного объёма памяти ускорителей или агрессивных схем квантования сообщества.
Да. DeepSeek заявляет, что официальная версия Flash нативно поддерживает API Responses и адаптирована для использования в Codex. Текущий API V4 Pro пока не поддерживает API Responses.
0731](https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731): официальный репозиторий моделей, содержащий веса, бенчмарки, лицензию и руководства по развертыванию.
DeepSeek V4 Flash 0731 привлекла широкое внимание, поскольку разработчики сообщили, что смогли создать полноценные интерактивные демонстрации всего за несколько центов. Сообщается, что шутер от первого лица обошелся всего в 0,07 доллара, а другие сравнения в социальных сетях показали, что стоимость задач в десятки раз ниже, чем у Claude Opus 5 или GPT-5.6.
Эти примеры не являются контролируемыми бенчмарками, но официальные цены API подтверждают их основную мысль. V4 Flash взимает 0,14 доллара за миллион некешированных входных токенов и 0,28 доллара за миллион выходных токенов, а стоимость при попадании в кэш составляет поразительно низкие 0,0028 доллара.
Ее экономичность обусловлена всей системой: ядро MoE на 284B параметров с активацией 13B на токен, сжатое длинноконтекстное внимание, веса FP4/FP8, контекстное окно на миллион токенов, эффективные возможности обслуживания и спекулятивное декодирование DSpark. Обновление 0731 сохраняет архитектуру предварительной версии и улучшает поведение агентов за счет нового пост-обучения.
Наиболее убедительным официальным доказательством является улучшение бенчмарков. Terminal Bench 2.1 вырос с 61,8 до 82,7, Toolathlon-Verified — с 49,7 до 70,3, при этом модель сохранила ценовой уровень Flash.
Преимущество V4 Flash не в том, что она побеждает во всех сравнениях, — а в том, что ее крайне низкие предельные издержки делают
проведение повторяющихся агентных экспериментов практичным в масштабах, которые с трудом достижимы для многих моделей с передовым ценообразованием.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



