О кончине защитного рва CUDA от NVIDIA объявляли так часто, что это стало почти ритуалом в индустрии. Появляется новый ускоритель. Компилято...
"Ров" CUDA от NVIDIA объявляли мёртвым так часто, что это уже стало своего рода ритуалом в индустрии.
Появляется новый ускоритель. Компилятор выходит в открытое бета-тестирование. Облачный провайдер продвигает свой собственный AI-чип. Программная абстракция обещает переносимые ядра. Кто-то объявляет, что разработчикам больше не нужно писать CUDA вручную.
И всё же CUDA по-прежнему занимает центральное место в инфраструктуре ИИ следующего поколения.
Новый вызов тем более интересен, что он исходит от самого ИИ.
Infinity, ИИ-инфраструктурный стартап, основанный бывшим исследователем Google Brain Джереми Никсоном, утверждает, что их агент Ignition перенёс ключевые компоненты стека инференсного ПО на незнакомый ускоритель d-Matrix Corsair со скоростью, намного превышающей традиционные инженерные процессы.
Самый заметный результат: примерно за 10 часов Ignition реализовала тензорно-параллельное умножение матриц на всех 32 вычислительных блоках, достигнув 92% от измеренного вычислительного потолка чипа.
Это значимый результат. Но это не означает, что CUDA была воссоздана за 10 часов.
В самом кейсе Infinity отмечается, что полный сквозной путь инференса Qwen3 занял около 10 дней, при этом каждая требуемая операция была переписана под новое оборудование. А CUDA — это не одна реализация умножения матриц и не одна модель рантайма. Это зрелая платформа, включающая компиляторы, рантаймы, библиотеки, инструменты профилирования и отладки, системы коммуникации, интеграцию с фреймворками, документацию и почти два десятилетия производственного опыта.
Более правильный вопрос — не в том, скопировал ли ИИ CUDA за одну ночь.
А в том, могут ли кодирующие агенты кардинально сократить время, необходимое для того, чтобы новый ИИ-чип стал полезным.
Ответ всё чаще — «да».
NVIDIA больше всего известна своим железом: H100, Blackwell, Rubin и крупными системами, построенными вокруг них.
Её самое устойчивое преимущество — ПО, выстроенное вокруг железа.
CUDA расшифровывается как Compute Unified Device Architecture (единая вычислительная архитектура устройств). NVIDIA описывает её как платформу ускоренных вычислений, а не просто язык программирования.
Платформа CUDA включает:
В основании CUDA позволяет инженерам писать ядра, исполняемые напрямую на GPU от NVIDIA.
Поверх неё находятся такие библиотеки, как cuBLAS, cuDNN, cuFFT, NCCL, TensorRT и TensorRT-LLM. Над библиотеками — PyTorch, TensorFlow, JAX, инференс-серверы, исследовательский код и внутренние корпоративные системы.
Упрощённая схема выглядит так:
Приложения и AI-фреймворки
↓
Оптимизированные библиотеки и распределённые системы
↓
Компиляторы, рантаймы, профайлеры, отладчики и ядра
↓
GPU и интерконнекты NVIDIA
Компании остаются в экосистеме NVIDIA не только потому, что знакомы с синтаксисом CUDA, а потому, что модели, тесты, системы развёртывания, ожидания по производительности, процессы отладки и производственные команды уже зависят от всего стека.
Смена аппаратной платформы может означать не просто перевод исходного кода — это может потребовать восстановления доверия.
Официальный кейс Infinity гораздо строже, чем громкие заголовки.
Компания работала с d-Matrix — стартапом, специализирующимся на оборудовании для инференса генеративного ИИ. Ускоритель Corsair имеет архитектуру и систему команд, отличные от GPU NVIDIA. Infinity утверждает, что у этого чипа практически нет публичной программной истории, которую общие модели программирования могли бы воспроизвести из обучающих данных напрямую.
Ignition получил информацию об оборудовании и приступил к генерации низкоуровневого ПО, необходимого для запуска ИИ-нагрузок.
По данным Infinity, примерно за 10 часов система достигла:
«Скорость света» Infinity определяет как отношение производительности сгенерированного ядра к достижимому вычислительному пику чипа. Эмпирический потолок в опубликованном кейсе сам по себе составляет около 90% от теоретического пика.
Это отличный быстрый запуск ядра, но не полноценная платформа, эквивалентная CUDA.
Умножение матриц — ядро инференса Transformer, но это лишь один класс операций.
Полная модель требует также механизмов внимания, нормализации, функций активации, маршрутизации, квантования, управления KV-кэшем, сэмплирования, перемещения тензоров, обработки состояний и сервисной обвязки модели.
Infinity сообщает, что примерно за 10 дней Qwen3 заработала на Corsair сквозным образом. В последующем анонсе о финансировании утверждается, что за этот период три前沿-модели были запущены сквозным образом, причём ядра написаны с нуля.
Этот более длинный таймлайн тоже впечатляет.
Перевод незнакомого ускорителя от базовых операций до работающего модельного рантайма — с месяцев до дней — может радикально изменить экономику выпуска нового оборудования.
| Утверждение | Более точная интерпретация |
|---|---|
| «ИИ воссоздал CUDA за 10 часов» | Преувеличение |
| Умножение матриц заработало за 10 часов | Сообщается в кейсе Infinity |
| Производительность — 92% от эмпирического пика | Сообщается в кейсе Infinity |
| Qwen3 заработала сквозным образом примерно за 10 дней | Сообщается в кейсе Infinity |
| Infinity строит универсальную библиотеку инференса | Подтверждено Infinity |
| Полная экосистема CUDA воспроизведена | Нет |
Infinity называет Ignition ИИ-исследовательским агентом.
Его назначение — генерировать и улучшать низкоуровневое ПО, превращающее операции модели в эффективную работу на конкретном чипе.
Цикл напоминает автоматизированный процесс оптимизации производительности:
Генерация кода
→ Компиляция
→ Запуск на оборудовании
→ Проверка корректности
→ Измерение производительности
→ Диагностика узких мест
→ Изменение реализации
→ Повтор
com/cms-assets/image/2026/08/9a7908b8-ffee-4250-b280-649499618ce5-658d1e86-10d7-4116-a564-e2b43d0c3a24.png)
Инженеры-люди по-прежнему предоставляют цели, информацию об аппаратном обеспечении, ограничения, критерии приёмки и общее направление. Ignition же выполняет основной объём повторяющейся работы по поиску и оптимизации.
Такие задачи идеально подходят для агентов, поскольку среда даёт исключительно чёткую обратную связь.
Сгенерированные ядра можно оценивать по конкретным критериям:
Аппаратное обеспечение и тесты предоставляют объективную фактическую основу.
Во многих программных задачах критерии приёмки размыты. Оптимизация ядер, хоть и сложна, частично поддаётся количественной оценке.
Эффективная реализация должна соответствовать двум независимым критериям.
Ядро должно выдавать результаты в пределах допустимой численной погрешности.
Ядро должно достаточно эффективно использовать целевое аппаратное обеспечение, чтобы оправдать замену существующей реализации.
Агент может сгенерировать сотни кандидатов, отбраковать некорректные, прогнать бенчмарки на выживших и последовательно оптимизировать самые сильные варианты.
Та же схема прослеживается в CUDA-ориентированных агентах NVIDIA, PTX Kernel Factory от INT21, работе DeepSeek над TileKernels, а также в исследовательских системах, генерирующих ядра на Triton или TileLang.
Новизна в том, что базовые модели теперь могут участвовать в более полном цикле, а не просто заполнять несколько строк синтаксического кода.
Технологическая история Infinity привлекла инвесторов.
В июле 2026 года компания объявила о завершении раунда посевного финансирования на 15 миллионов долларов при оценке после инвестиций в 100 миллионов долларов, по сообщениям. В раунде участвовали Touring Capital и Principal Venture Partners, а также руководители чип-индустрии и исследователи, связанные с ведущими AI-лабораториями.
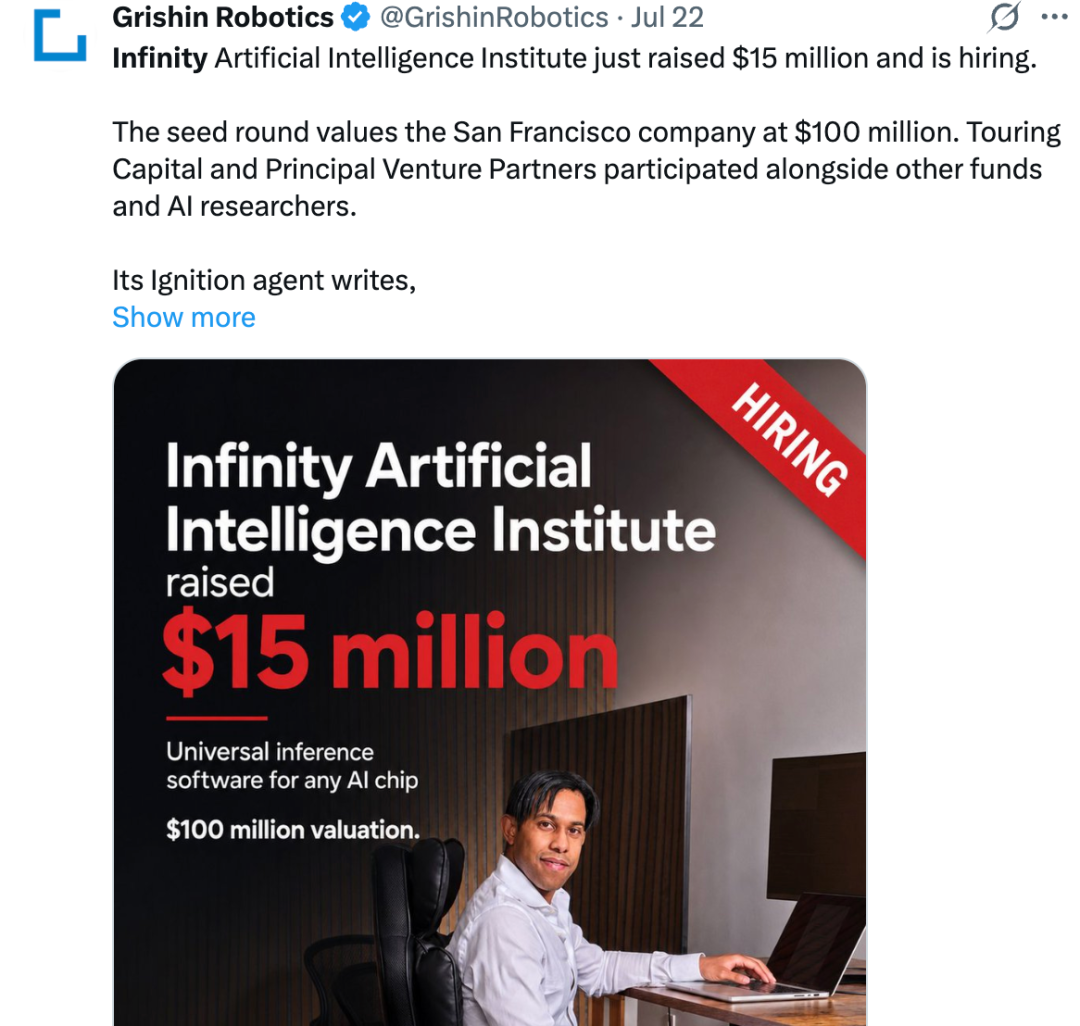
Infinity создаёт модель-ориентированный программный слой для логических выводов для поставщиков аппаратного обеспечения и провайдеров инференс-сервисов. Её заявленный рабочий процесс фактически таков:
Характеристики аппаратного обеспечения
→ Сгенерированное производственное ПО для логических выводов
Сообщается также, что Infinity создала
движок логических выводов NVIDIA с нуля, который на Qwen3-8B показывает производительность до 34,3% выше, чем конфигурационно совпадающая реализация vLLM.
Этот результат предоставлен самой компанией и зависит от аппаратного обеспечения, настроек батчинга, конфигурации модели и методики измерений. Тем не менее, это указывает на то, что амбиции Infinity простираются далеко за пределы базового запуска чипов.
В оригинальном тексте также упоминается репозиторий TileKernels от DeepSeek.
TileKernels — это библиотека оптимизированных GPU-ядер, написанных на TileLang, Python-подобном предметно-ориентированном языке для разработки высокопроизводительных ядер.
Репозиторий содержит следующие операции:
DeepSeek утверждает, что многие ядра уже близки к аппаратным пределам по вычислительной интенсивности или пропускной способности памяти, и часть из них используется внутри компании.
TileLang сокращает объём низкоуровневого кода CUDA C++, который инженерам приходится писать вручную.
В нынешнем виде это не свидетельствует о том, что DeepSeek устранила зависимость от технологического стека NVIDIA.
Текущие официальные требования TileKernels включают:
NVIDIA SM90 или SM100 GPU
CUDA Toolkit 13.1 или новее
PyTorch 2.10 или новее
TileLang 0.1.9 или новее
Текущая библиотека рассчитана на новейшие архитектуры NVIDIA. Она снижает зависимость от рукописного исходного кода CUDA, но не устраняет зависимость от аппаратного обеспечения NVIDIA или CUDA Toolkit.
Сам TileLang имеет более широкие амбиции.
Проект описывает модель мозаичного (tiled) программирования для GPU, CPU и ускорительных ядер, основанную на инфраструктуре компилятора TVM и использующую синтаксис в стиле Python.
Его цель — разделить поток данных, который хочет инженер, и низкоуровневое планирование (scheduling), необходимое для эффективного исполнения.
TileLang постоянно добавляет поддержку многобэкендных языков, а также аппаратные пути, охватывающие CUDA, ROCm и Metal.
Такая переносимость может снизить затраты на переключение между поставщиками, но только при условии, что результаты будут корректными, стабильными, поддающимися отладке и конкурентоспособными по сравнению с библиотеками поставщиков.
Ядро, которое работает везде, но с низкой производительностью, не сможет заменить путь CUDA в производственной среде.
В исследовательской статье за июль 2026 года рассматривался разрыв между корректностью ядер в Triton и TileLang и качеством их замены.
Авторы обнаружили, что ядра могут проходить тесты на численную корректность, но при этом иметь производительность значительно ниже оптимизированного базового уровня. Сообщается, что одна реализация LayerNorm на TileLang, несмотря на прохождение проверки корректности, работала более чем в 300 раз медленнее базовой линии PyTorch.
Статья не направлена против TileLang; она выступает за оценку сгенерированных ядер по двум измерениям:
Корректность
+
Аппаратная эффективность
Генерация кода становится всё быстрее. Но доказать, что сгенерированный код способен заменить зрелое производственное ПО, по-прежнему сложно.
Вызов CUDA выглядит более убедительным в сфере логических выводов, чем в обучении передовых моделей.
Масштабные обучающие запуски могут задействовать тысячи или десятки тысяч
ускорителей, работающих неделями или месяцами.
Обучающие платформы должны обеспечивать распределённую коммуникацию, контрольные точки, восстановление после сбоев, управление памятью, параллелизм, воспроизводимость и отладку на огромном количестве устройств.
Один сбой аппаратного обеспечения или программного обеспечения может привести к потере огромных вычислительных ресурсов. Поэтому организации крайне осторожно переносят критически важные обучающие нагрузки с устоявшихся систем.
CUDA, библиотеки CUDA-X, NCCL, поддержка PyTorch и интегрированные сетевые возможности NVIDIA дают компании сильные позиции в этой области.
Логические выводы — это этап обслуживания модели после завершения обучения.
Соответствующие бизнес-метрики обычно ближе к:
Приемлемое качество вывода
÷
Общая стоимость обслуживания
Логические выводы могут распределяться на одном ускорителе, небольшом кластере, масштабном парке машин и специализированном аппаратном обеспечении.
Новому чипу не обязательно заменять NVIDIA во всех сценариях. Ему достаточно доказать преимущество для конкретной модели или нагрузки по стоимости, скорости, энергопотреблению, пропускной способности или предсказуемости задержек.
Эта более узкая цель даёт специализированному аппаратному обеспечению реалистичную точку входа.
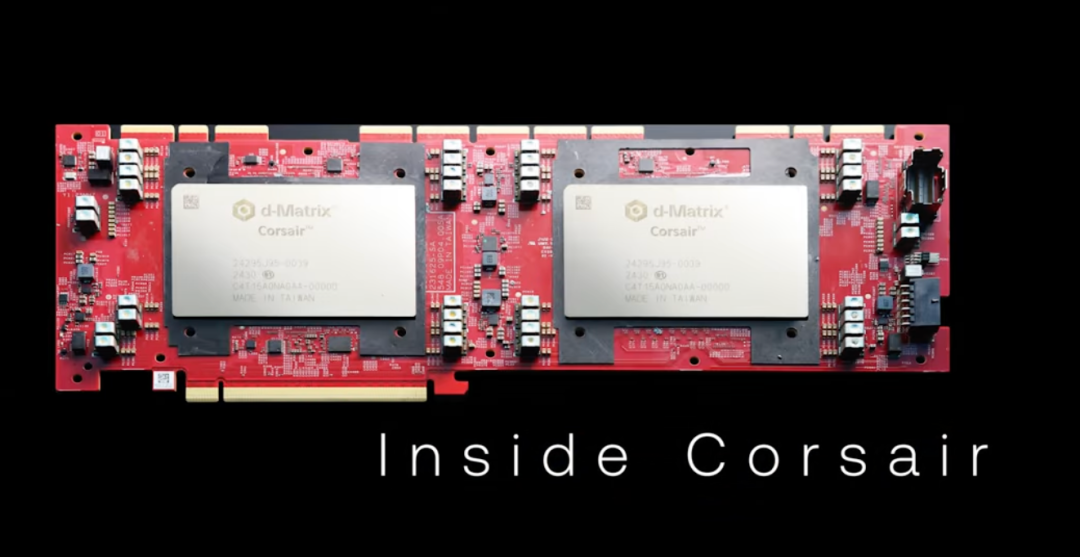
Компания d-Matrix, основанная в 2019 году, фокусируется на ускорении логических выводов. Её платформа Corsair, использующая большие объёмы встроенной SRAM, предназначена для снижения стоимости и энергопотребления при работе генеративных моделей.
Работа Infinity решает одну из классических проблем, с которыми сталкиваются новые ускорители.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Чип может обладать многообещающим аппаратным обеспечением, но пока не готовы ядро, исполнение моделей, работа с памятью, квантизация, сервисная логика и схема интеграции, клиенты не смогут эффективно им пользоваться.
Если агент способен сократить этот процесс запуска с нескольких месяцев до нескольких дней, аппаратные стартапы смогут предлагать поддержку ближе к моменту выхода моделей и раньше демонстрировать возможности своего оборудования.
Это ослабляет часть программного преимущества NVIDIA, но не устраняет его полностью.
Рынок инференса включает несколько challenger'ов:
| Производитель или платформа | Общее позиционирование |
|---|---|
| Rebellions | Специализированные ИИ-ускорители и системы для инференса |
| Cerebras | Системы на пластине для обучения и инференса |
| AWS Inferentia | Инференс-чипы от Amazon с использованием Neuron SDK |
| Google TPU | Ускорители Google с поддержкой XLA и основных фреймворков |
| AMD Instinct | Датацентровые GPU с платформой ROCm |
| d-Matrix | Ускорение генеративного ИИ-инференса на основе SRAM |
| NVIDIA | GPU и стек ускоренных вычислений CUDA |
Давление исходит от программных уровней, которые позволяют пользователям развёртывать модели без ручной переписывания каждой операции, включая AWS Neuron, Google XLA, AMD ROCm, Modular MAX и Mojo, TileLang, Triton и системы генерации ядер на основе ИИ.
Чем больше автоматизируют эти программные уровни, тем реже разработчикам приложений приходится вмешиваться вручную.
Речь непосредственно о CUDA.
Эффект блокировки CUDA наиболее силён, когда приложения и их оптимизированные ядра тесно связаны с оборудованием NVIDIA.
Переносимый уровень инференса призван обеспечить следующий рабочий процесс:
Модель
→ Переносимый уровень исполнения
→ Генерация или выбор аппаратных ядер
→ Целевой ускоритель
Реальный мир сложнее, поскольку разные чипы имеют различные иерархии памяти, числовые форматы, способы соединения, планировщики поведения и поддерживаемые операции.
Высокая производительность по-прежнему часто требует работы, специфичной для конкретного оборудования.
Ключевой тезис Infinity заключается в том, что агенты могут автоматически генерировать такую специализированную работу.
Результаты за 10 часов не воспроизводят те активы, которые делают CUDA сложной для замены.
К ним относятся:
Многие организации используют вендорские библиотеки вместо непосредственного написания ядер. cuBLAS, cuDNN, TensorRT, NCCL и другие содержат многолетний оптимизационный опыт.
NVIDIA Nsight и связанные инструменты помогают инженерам понимать корректность, поведение памяти, тайминги, коммуникации и производительность.
Новые возможности моделей обычно рано интегрируются и оптимизируются под оборудование NVIDIA.
Продакшен-команды знают, как системы NVIDIA ведут себя под нагрузкой.
Экосистема включает примеры, курсы, выступления на конференциях, ответы сообщества и экспертные ресурсы.
Предприятия имеют миллионы строк кода, тесты, процессы закупок и навыки сотрудников, привязанные к этой платформе.
ИИ может снизить стоимость перевода, но не автоматически устраняет организационные издержки перехода.
Бинг Сюй, основатель INT21 и бывший основатель HippoML, приобретённой NVIDIA, считает, что основным узким местом является верификация.
Агенты могут быстро генерировать код. Но продакшен-командам всё ещё нужны доказательства того, что он:
У NVIDIA уже есть большое количество тестов на соответствие, тестов производительности, эталонных реализаций, симуляторов, профайлеров, диагностики компилятора, продакшен-нагрузок и исторических данных об ошибках.
Эти активы делают агентов более полезными.
Таким образом, ИИ может сместить ров с генерации кода на качество среды верификации.
Технологии, бросающие вызов CUDA, применимы и к самой NVIDIA.
Business Insider со ссылкой на вице-президента экосистемы разработчиков NVIDIA Анкита Пателя сообщает, что компания использует ИИ-агентов для кодирования, чтобы быстрее развивать CUDA и проводить более масштабную верификацию.
NVIDIA уже
Также предложена стратегия CUDA Intelligence, объединяющая существующие знания CUDA, экспертизу оптимизации, облачное профилирование производительности, инструменты Nsight, бенчмарки и сервисы на основе MCP.
NVIDIA поддерживает ComputeEval — открытый бенчмарк для проверки ИИ-сгенерированного кода CUDA и ядер вычислительных библиотек CUDA.
Данный бенчмарк охватывает задачи, связанные с тензорными ядрами, разделяемой памятью, примитивами на уровне варпов, CUDA-графами, потоками и событиями.
Таким образом, это гонка относительная:
Скорость догоняющего ПО challenger'ов
против
Скорость улучшения ПО NVIDIA
Сооснователь и генеральный директор Modular Крис Латтнер даёт более осторожную оценку.
Он считает, что агенты кодирования дают инкрементальное улучшение, а не мгновенное разрушение преимущества CUDA.
Исходная статья обобщает три причины.
Продакшен-оптимизация определяет экономическую целесообразность чипа. Последние несколько процентов производительности могут требовать значительной экспертной работы.
Код приложений в интернете в изобилии.
Высококлассная разработка ядер и компиляторов — довольно нишевая область, и многие из самых сильных наработок по-прежнему остаются закрытыми.
Техническая осуществимость не устраняет затраты на сертификацию, эксплуатационные риски, переобучение сотрудников, контрактные обязательства, требования к надёжности или альтернативные издержки.
Эти соображения не означают, что агентная разработка ядер неважна. Они объясняют, почему впечатляющая демонстрация не превращается мгновенно в замену на рынке.
Наиболее сильная интерпретация — не «CUDA мертва».
А скорее: один из слоёв исторического преимущества CUDA становится легче воспроизвести.
Агенты, DSL и автоматизированные компиляторы могут сократить время, необходимое для создания ядер, рантаймов и поддержки моделей для новых чипов.
Наиболее уязвимый слой — быстрая адаптация для раннего инференса.
Наиболее защищённый слой — по-прежнему масштабное обучение, зрелые библиотеки генерации, валидация, отладка, оркестрация кластеров, интеграция с фреймворками, существующие рабочие процессы клиентов и постоянная оптимизация.
Стратегический вопрос может сместиться с:
У кого больше всего кода ядер, написанного вручную?
на:
У кого лучший замкнутый цикл автоматической генерации,
измерения, валидации и оптимизации?
NVIDIA находится в выгодном положении, поскольку уже владеет аппаратным обеспечением, инструментами, библиотеками, рабочими нагрузками и данными обратной связи. Претенденты выигрывают от того, что агенты снижают барьер входа.
Оба утверждения могут быть верны одновременно.
Результат Infinity меняет ожидания аппаратных стартапов.
Новым ускорителям больше не обязательно предполагать, что каждое полезное ядро будет написано вручную небольшой командой экспертов.
Агент может:
Это может сократить время от первой кремниевой тапеута чипа до достижения пригодного для использования инференса моделей.
Такое сокращение позволяет поставщикам чипов раньше демонстрировать аппаратное обеспечение, быстрее поддерживать новые модели, снижать нагрузку на персонал по разработке ПО, тестировать больше идей и конкурировать в более нишевых сегментах инференса.
Этот результат не стирает CUDA, но делает первый шаг к конкуренции с CUDA менее пугающим.
Опубликованные результаты Infinity получены от компании и её аппаратных партнёров. Внешние бенчмарки предоставят более веские доказательства.
Универсальный инференс-слой должен поддерживать множество архитектур, модальностей, форматов квантования и режимов обслуживания.
Демонстрация сквозного запуска — это одно; программное обеспечение, работающее месяцами под клиентской нагрузкой, — совсем другое.
Ключевой вопрос — как агентные системы могут доказать корректность и производительность в огромном пространстве тестов.
Если одна реализация будет давать отличные результаты на NVIDIA, AMD, Apple и других ускорителях, TileLang и другие предметно-ориентированные языки станут более стратегически значимыми.
NVIDIA активно строит агентов, бенчмарки, компиляторный интеллект и новые абстракции CUDA. Существующий гигант не стоит на месте.
Нет. Infinity сообщает, что Ignition за 10 часов сгенерировал программное обеспечение для тензорно-параллельного умножения матриц для d-Matrix Corsair, достигнув 92% от эмпирического вычислительного предела этого чипа. Сквозной инференс Qwen3 занял около 10 дней; проект не воспроизвёл полную экосистему CUDA.
Ignition — это исследовательско-инженерный агент ИИ от Infinity для генерации, тестирования, отладки и оптимизации низкоуровневого инференсного ПО. Он использует обратную связь от реального аппаратного обеспечения для итеративного улучшения ядер и рантаймов моделей.
Corsair — это платформа для генеративного ИИ-инференса от d-Matrix. Infinity использовала её как целевую платформу для автоматической генерации тензорно-параллельных операций и полного стека инференса моделей.
Нет. TileKernels снижает потребность в ручном написании низкоуровневых ядер CUDA с помощью TileLang, но его текущие требования включают аппаратное обеспечение NVIDIA SM90 или SM100 и CUDA Toolkit версии 13.1 или выше.
Инференс может работать на меньших системах и часто оценивается по стоимости, энергопотреблению, пропускной способности или задержке одной модели. Передовое обучение требует более крупных кластеров, зрелых коммуникационных систем, способности к восстановлению после сбоев и проверенной стабильности.
Ров CUDA включает зрелые библиотеки, интеграцию с фреймворками, инструменты отладки и профилирования, распределённые системы, документацию, производственную историю и существующий клиентский код. Валидация и постоянная оптимизация могут стать ещё более важными по мере снижения стоимости генерации кода.
Да. Исследования показывают, что ядра могут проходить тесты на числовую корректность, но их производительность может быть значительно ниже оптимизированных библиотечных реализаций. Производственная оценка требует как проверки корректности, так и проверки эффективности аппаратного обеспечения.
Да. NVIDIA заявляет, что использует агентов для ускорения разработки и валидации CUDA, и публично продемонстрировала агентные рабочие процессы для CUDA, интеграцию с профилировщиками и бенчмарк ComputeEval.
inc/research): Официальные тематические исследования, охватывающие d-Matrix, программное обеспечение для генеративного вывода и исследовательскую систему компании OMEGA.
Агент Ignition от Infinity не пересоздал NVIDIA CUDA за 10 часов. Он сгенерировал высокопроизводительное тензорно-параллельное матричное умножение для незнакомой архитектуры.
Тогдашний ускоритель d-Matrix, по заявлению, достиг 92% от эмпирического вычислительного предела чипа. Примерно через 10 дней был реализован полный конвейер вывода Qwen3.
Этот результат остаётся значимым и сегодня. Он показывает, что агенты способны ускорить ранний запуск программного обеспечения для новых ИИ-чипов, особенно в области вывода — где клиентов волнует стоимость за ответ и где можно применять специализированное оборудование для узких рабочих нагрузок.
TileKernels и TileLang от DeepSeek также указывают в том же направлении: больше работы над ядрами может быть выражено через системы более высокого уровня и автоматически оптимизировано. Текущая версия TileKernels по-прежнему зависит от новейших GPU и CUDA от NVIDIA, поэтому она сокращает объём рукописного кода CUDA, а не устраняет эту платформу.
Ров CUDA остаётся глубоким, поскольку включает в себя гораздо больше, чем исходный код. Библиотеки, валидация, профилирование производительности, поддержка фреймворков, распределённое обучение, производственная история и существующие организационные инвестиции трудно воспроизвести.
ИИ не преодолел весь ров CUDA за 10 часов — но он, возможно, снизил стоимость достижения первого барьера, сместив долгосрочную конкуренцию с владения кодом на автоматизированную генерацию, проверку и оптимизацию.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



