For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Google выпустила **EmbeddingGemma 2** — компактную мультимодальную модель эмбеддингов, предназначенную для переноса семантического поиска не...

Google выпустила EmbeddingGemma 2 — компактную мультимодальную модель эмбеддингов, предназначенную для переноса семантического поиска непосредственно на телефоны, ноутбуки, браузеры и другие периферийные устройства.
Модель была представлена 6 октября 2026 года. Ее основные характеристики необычно компактны для такого набора возможностей:
740 млн общих параметров
Единое пространство эмбеддингов размерностью 768
Контекстное окно на 8 тыс. токенов
Более 100 языков
~191 МБ активной ОЗУ для текстовых весов на Pixel 11 Pro
~567 МБ активной ОЗУ для полной мультимодальной модели на Pixel 11 Pro
EmbeddingGemma 2 может кодировать текст, код, изображения, видео, аудио и смешанные комбинации этих модальностей в одном общем векторном пространстве.
Это означает, что запрос на естественном языке может найти фотографию, аудиофрагмент или момент внутри видео без необходимости предварительно преобразовывать каждый файл в текст.
Генеральный директор Google Сундар Пичаи назвал ее первой открытой нативно мультимодальной моделью эмбеддингов Google.
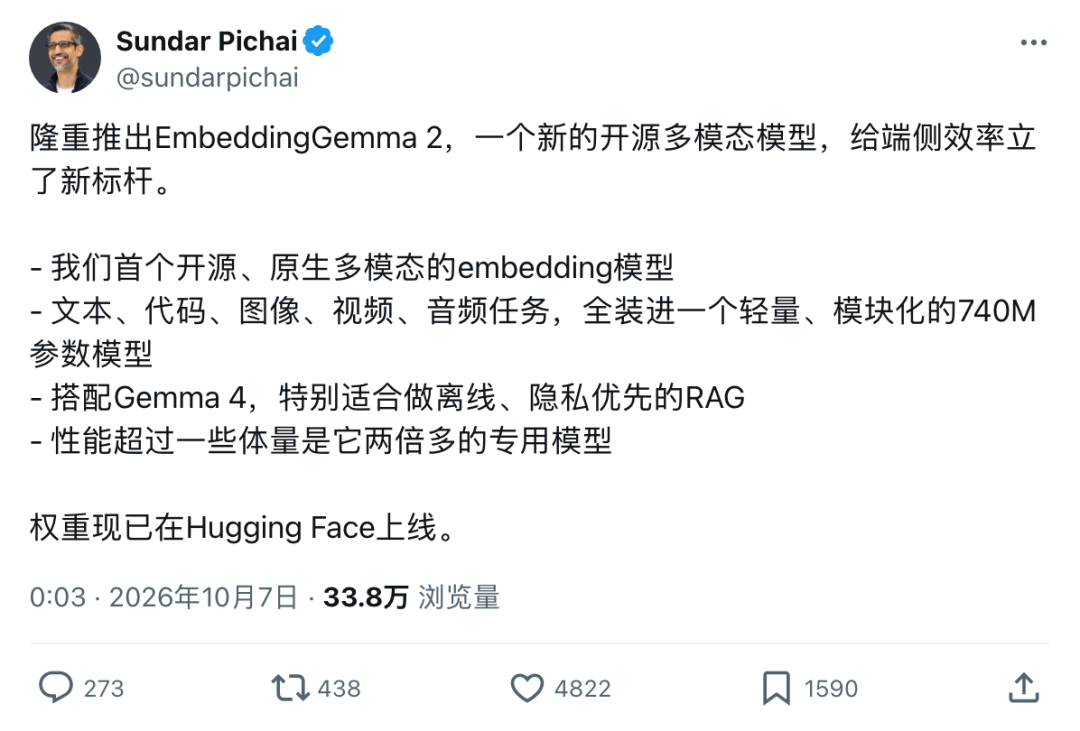
Практическая разница проста: поиск, который раньше зависел от облачных API или отдельных моделей для изображений, аудио и текста, теперь может выполняться локально с помощью одной компактной модели.
Модели эмбеддингов часто незаметны для конечных пользователей, однако они лежат в основе многих современных систем поиска и RAG.
Их задача — преобразовать контент в числовые векторы:
контент
→ вектор эмбеддинга
→ позиция в семантическом пространстве
Объекты с похожим смыслом располагаются ближе друг к другу. Затем поисковая система преобразует запрос пользователя в другой вектор и извлекает наиболее близкие совпадения.
Первая EmbeddingGemma была ориентирована на текст. EmbeddingGemma 2 расширяет эту идею до единого мультимодального пространства.
В карточке модели Google говорится, что новая модель отображает текст, изображения, видео и аудио в одном и том же 768-мерном пространстве эмбеддингов.
Таким образом, фотография кошки, слово «кошка» и аудиозапись с кошачьим мяуканьем могут быть семантически связаны, хотя их исходные форматы полностью различаются.
Это позволяет выполнять такие поисковые операции:
текстовый запрос → подходящие изображения
текстовый запрос → подходящее аудио
текстовый запрос → подходящие фрагменты видео
аудиозапрос → подходящее видео
запрос по изображению → связанные изображения или медиаданные
Один фрагмент контента также может содержать несколько модальностей.
Google приводит пример страницы товара с трейловыми кроссовками, на которой есть текстовое описание, фотографии товара и видео, демонстрирующее сцепление подошвы с мокрыми камнями. EmbeddingGemma 2 может представить объединенный контент одним эмбеддингом и сопоставить его с запросом «водонепроницаемые кроссовки для трейлраннинга».
Вскоре после запуска инженер Hugging Face Виктор М. продемонстрировал работу модели непосредственно в браузере.
Согласно исходной статье, он ввел запрос:
пение птиц
и сетка результатов сразу изменила порядок. Среди первых результатов были как фотографии птиц, так и аудиоклипы с визуализацией птичьих голосов в виде волновых форм.
Сообщается, что выполнение запроса заняло около 22 миллисекунд. Серверный вызов модели не использовался, внешний API также не требовался.
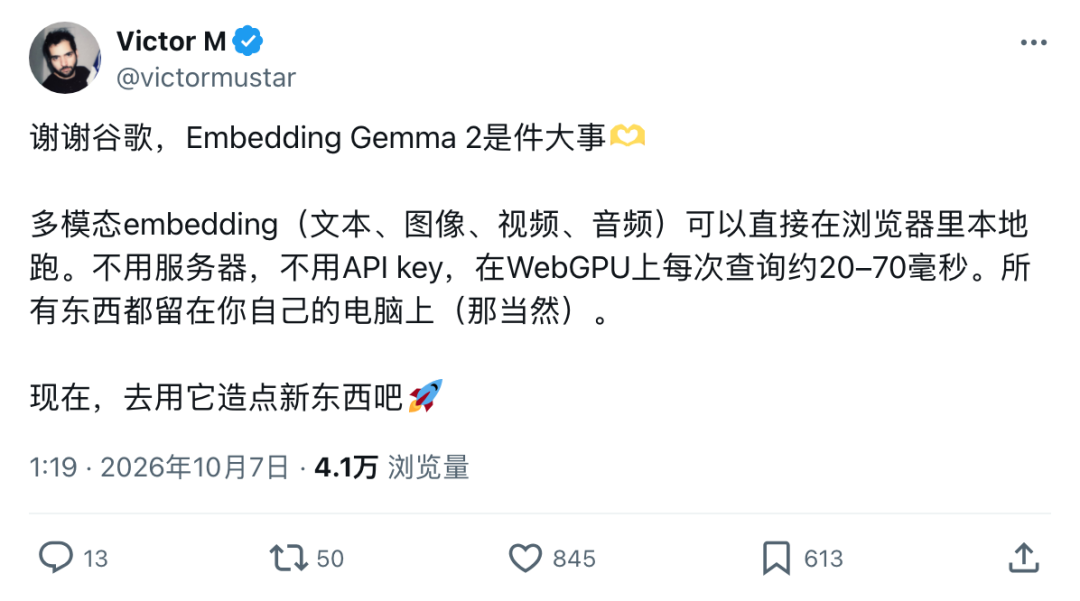
Это показатель из теста браузера, проведенного разработчиком, а не официальная гарантия задержки от Google.
Тем не менее общий вывод подтверждается собственными рекомендациями Google по развертыванию: EmbeddingGemma 2 предназначена для локального выполнения через такие среды, как LiteRT, MediaPipe, WebGPU, transformers.js, MLX, llama.cpp, Ollama и другие среды выполнения для периферийных устройств.
EmbeddingGemma 2 использует контекстное окно на 8 192 токена — в четыре раза больше, чем предыдущая EmbeddingGemma.
Google утверждает, что одномодальный ввод может содержать приблизительно:
5,5 минуты аудио
29 изображений
58 кадров видео
или чередующиеся комбинации модальностей.
Модель также поддерживает более 100 языков.
Это дает локальным поисковым системам гораздо больше гибкости. Вместо индексации только коротких текстовых фрагментов приложение может представлять более насыщенные элементы контента, содержащие длинные отрывки, изображения, видеокадры или аудиосегменты.
Google сравнила EmbeddingGemma 2 с несколькими системами эмбеддингов сопоставимого размера.
Исходная статья подчеркивает наиболее заметные различия в визуальном поиске.
В карточке модели Google приведены следующие результаты:
| Бенчмарк | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61.36 |
| MTEB Code v1 | 78.68 |
| MIEB Lite | 64.64 |
| MMEB v2 Image | 57.28 |
| MMEB v2 Visual Document | 67.84 |
| MMEB v2 Video | 50.67 |
| MSEB Retrieval | 69.54 |
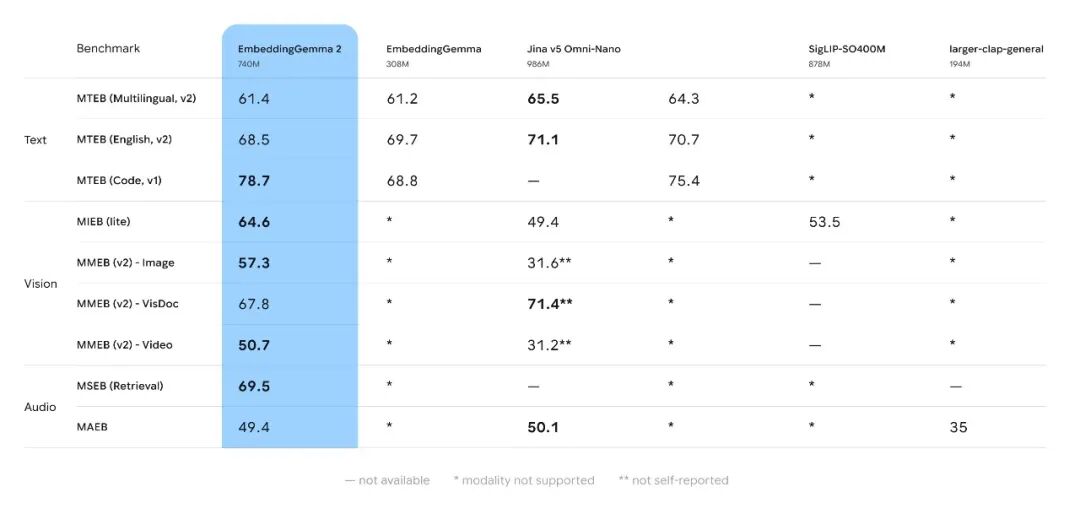
В исходной статье отдельно выделено сравнение с Jina v5 Omni-Nano:
MMEB v2 Image
EmbeddingGemma 2: 57.3
Jina v5 Omni-Nano: 31.6

MMEB v2 Video
EmbeddingGemma 2: 50.7
Jina v5 Omni-Nano: 31.2
Эти показатели взяты из опубликованной Google таблицы оценки.
Как всегда, результаты бенчмарков следует интерпретировать в рамках конкретной методики оценки, а не считать универсальным рейтингом для любой производственной поисковой нагрузки.
Общее количество параметров — 740 млн — разделено между модулями.
В карточке модели Google указано:
Текст:
270 млн параметров всего
  130 млн — базовая модель
  140 млн — эмбеддер

Визуальный энкодер:
170 млн параметров

Аудиоэнкодер:
300 млн параметров
Разработчикам необязательно загружать все три компонента.
| Активные модальности | Эффективный размер модели |
|---|---|
| Только текст | 270 млн |
| Текст + изображение | 440 млн |
| Текст + аудио | 570 млн |
| Полная мультимодальная модель | 740 млн |
Такая модульность важна для периферийных устройств. Если приложение выполняет поиск только по тексту и коду, нет причин держать аудио- или визуальный энкодер в памяти.
Google сообщает, что после квантования на Pixel 11 Pro модель может работать примерно с таким объемом памяти:
Активная ОЗУ только для текста:
~191 МБ

Активная ОЗУ для полной мультимодальной модели:
~567 МБ
Именно на этом основан заголовок исходной статьи о показателе «менее 600 МБ».
Модель использует обучение с учетом квантования и поддерживает варианты развертывания INT4 и INT8.
Это важно, поскольку мультимодальные поисковые конвейеры традиционно требовали нескольких отдельных компонентов:
энкодер изображений
+
распознавание речи или аудиоэнкодер
+
модель текстовых эмбеддингов
+
дополнительная предварительная обработка
EmbeddingGemma 2 объединяет значительную часть этой функциональности в одной унифицированной архитектуре.
Исходная размерность результата составляет 768.
EmbeddingGemma 2 также поддерживает Matryoshka Representation Learning, позволяя усекать векторы до:
512 измерений
256 измерений
128 измерений
Google утверждает, что это может уменьшить локальное хранилище векторной базы данных максимум в 6 раз по сравнению с полным представлением размерностью 768.
В блоге Google AI Edge говорится, что в некоторых конфигурациях локального индекса и хранилища сокращение может достигать 8 раз — в зависимости от способа настройки представления и конвейера хранения.
В карточке модели также приводится важная деталь реализации: перед поиском по косинусному сходству усеченные векторы следует нормализовать заново.
Если векторы запроса и документа имеют разные размерности, их также нельзя напрямую сравнивать.
Google опубликовала несколько эталонных приложений на базе этой модели.
Instant Media Search в Google AI Edge Gallery позволяет искать локальные фотографии и видео с помощью запроса на естественном языке или образца изображения.
Приложение:
Для вычисления эмбеддингов интернет-соединение не требуется.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Video Moments Finder позволяет искать конкретные моменты внутри локальных видеофайлов.
Google приводит такие примеры запросов:
дети смеются
собака ловит фрисби
человек задувает свечи на торте
Приложение индексирует визуальные и аудиофрагменты и возвращает подходящие временные метки.
Google также запустила AI Edge Foresight для Mac.
Foresight использует EmbeddingGemma 2 вместе с Gemma 4 для локального поиска и контекстного рассуждения.
Google сообщает, что приложение может индексировать расшифровки встреч, искать по личным файлам, извлекать изображения, документы и заметки, работать офлайн и сохранять конфиденциальные исходные материалы на устройстве.
Это близко к описанной в исходной статье архитектуре локального RAG:
EmbeddingGemma 2
→ извлечение релевантного локального контекста

Gemma 4
→ рассуждение на основе извлеченного контекста
В исходной статье также собраны несколько ранних экспериментов разработчиков.
Это полезные примеры, однако их следует рассматривать как результаты, сообщенные сообществом, а не как официальные бенчмарки Google.
Приложение Nativ сообщило о тестах с использованием 8-битной квантованной модели на Apple M5 Max.
Опубликованные показатели включали:
косинусное сходство по сравнению с FP32:
0.9997

пропускная способность создания текстовых эмбеддингов при размере пакета 32:
817 элементов в секунду
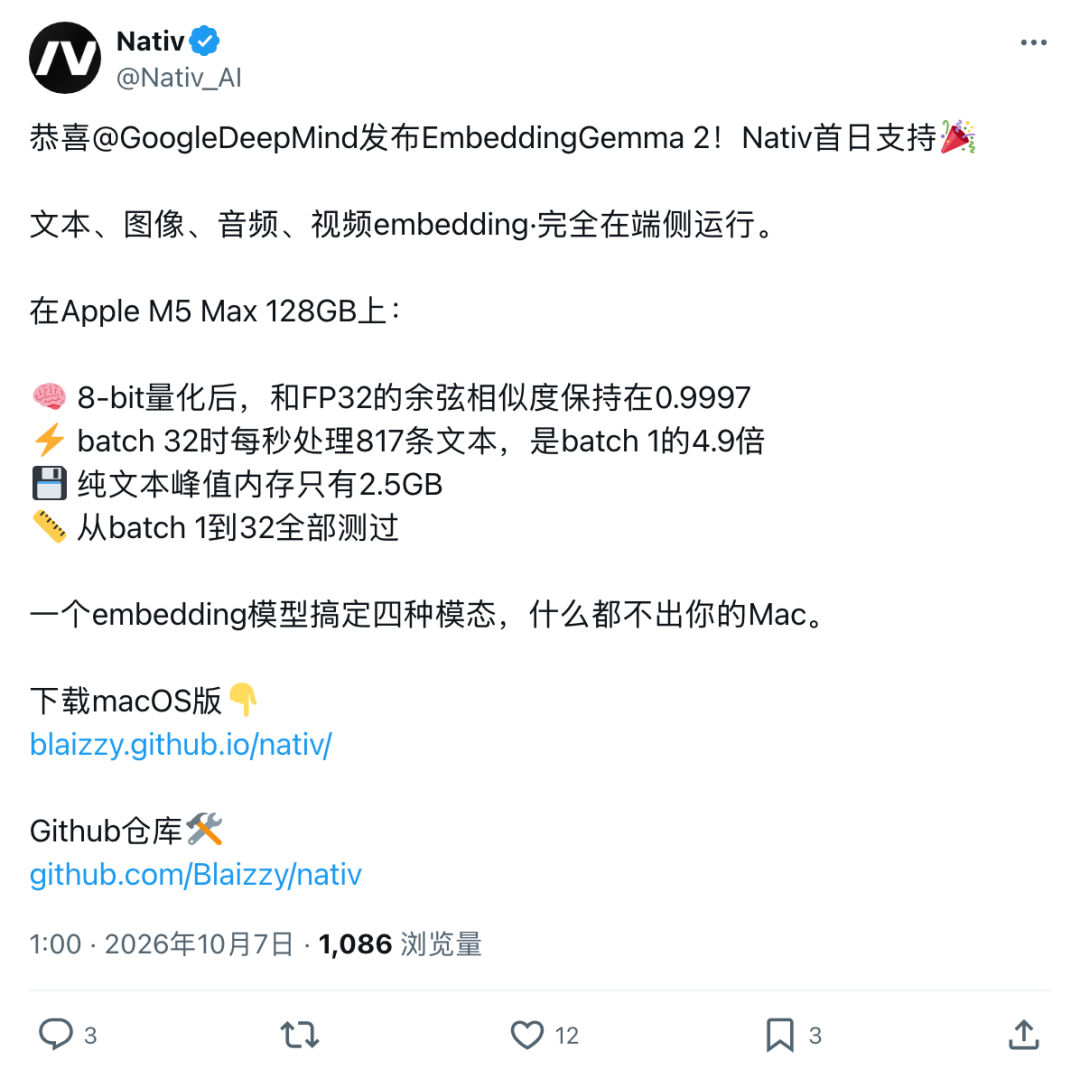
Эти показатели зависят от конкретной реализации, квантования, оборудования и размера пакета.
Турецкий разработчик, упомянутый в исходной статье, создал небольшой тест на личных заметках.
Заметки были в основном написаны на английском языке, а запросы формулировались на турецком.
В своем тесте он сообщил о таких результатах:
доля успешных совпадений при поиске по ключевым словам:
15%

доля успешных совпадений EmbeddingGemma 2:
97%
В рамках теста проверялось, попадала ли нужная заметка в число 18 лучших кандидатов.
Он также протестировал реальные сообщения с большим количеством опечаток и сообщил, что семантическая модель нашла примерно вдвое больше релевантных заметок, чем поиск по ключевым словам. По его словам, каждый запрос локально выполнялся примерно за 50 миллисекунд.
Это не стандартизированный бенчмарк, однако пример показывает одну из главных причин полезности поиска по эмбеддингам: семантическое сходство может работать даже тогда, когда запрос и сохраненный текст используют разные слова или языки.
Разработчик Nick Lo также продемонстрировал квантованную сборку EmbeddingGemma 2, работающую через llama.cpp на Nano-плате для разработки.
Он сообщил, что преобразование текстового запроса в эмбеддинг для небольшой локальной системы поиска изображений занимало примерно:
~15 мс
После нахождения подходящего изображения ESP32-S3 выводила его построчно.

И снова: это эксперимент разработчика, а не официальное значение задержки.
Модель предназначена не только для работы с медиаданными.
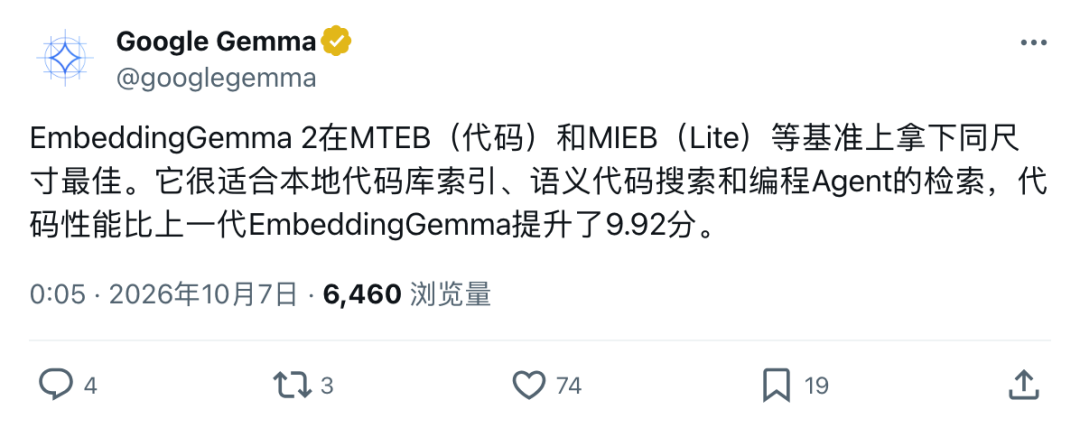
Качество поиска по коду значительно улучшилось по сравнению с предыдущей EmbeddingGemma.
Google приводит такие результаты:
MTEB Code v1

EmbeddingGemma:
68.76

EmbeddingGemma 2:
78.68
Это увеличение на 9,92 пункта.
Google Gemma отдельно выделяет локальную индексацию кодовой базы, семантический поиск по коду и извлечение данных для кодовых агентов как целевые варианты использования.
Инструментам вроде кодовых агентов необходимо найти релевантную часть репозитория, прежде чем они смогут внести в него изменения.
Компактный локальный эмбеддер дает разработчикам еще один вариант архитектуры:
исходный репозиторий
→ локальное построение эмбеддингов
→ локальное сохранение индекса
→ запрос на естественном языке
→ извлечение релевантного кода
→ передача только выбранного контекста более крупной кодовой модели
Индексация и первичное извлечение могут оставаться на собственном компьютере разработчика.
Ранее в 2026 году Google уже запустила Gemini Embedding 2 как облачный API.
EmbeddingGemma 2 использует другой подход.
Вместо обязательного обращения к размещенному в облаке API для создания мультимодальных эмбеддингов это модель с открытыми весами, способная работать локально.
| Подход | Главное преимущество |
|---|---|
| Облачный API эмбеддингов | Управляемая инфраструктура и простое масштабирование |
| EmbeddingGemma 2 на устройстве | Конфиденциальность, автономная работа и низкая локальная задержка |
Для личных медиаданных, конфиденциальных файлов, корпоративных заметок и локальных репозиториев кода второй вариант может быть привлекательным, поскольку исходным материалам не обязательно покидать устройство.
Google прямо продвигает это решение как подход с приоритетом конфиденциальности.
Однако это не означает, что любое приложение автоматически становится конфиденциальным. Остальную часть приложения также необходимо правильно спроектировать, включая безопасное локальное хранение, контроль доступа и осторожную работу с извлеченным контентом.
EmbeddingGemma 2 — это мультимодальная модель эмбеддингов Google с открытыми весами, созданная на базе технологий Gemma 4. Она преобразует текст, код, изображения, видео, аудио и смешанные входные данные в общее векторное пространство размерностью 768 для поиска, RAG, оценки сходства, классификации и кластеризации.
Полная модель содержит 740 млн параметров. Текстовый компонент использует 270 млн параметров, а дополнительные визуальный и аудиоэнкодеры добавляют соответственно 170 млн и 300 млн параметров.
Да. Google разработала ее для использования на устройствах и предлагает варианты развертывания на телефонах, ноутбуках, в браузерах и на периферийном оборудовании. Собственные демонстрации Google AI Edge выполняют локальный поиск без облачных вызовов для создания эмбеддингов.
Google сообщает примерно о 191 МБ активной ОЗУ для квантованных текстовых весов и примерно о 567 МБ для полной мультимодальной модели на Pixel 11 Pro. Фактическое потребление памяти зависит от среды выполнения, оборудования, точности вычислений и активных энкодеров.
Да. Все поддерживаемые модальности отображаются в одном векторном пространстве, поэтому текст может находить изображения, аудио или фрагменты видео, а медиаданные также можно сопоставлять с другими медиаданными.
Google выпускает веса модели по коммерчески разрешительной лицензии Apache 2.0 и описывает ее как открытую модель. При этом пользователи должны соблюдать Политику запрещенного использования Gemma и применимые условия.
Да. Google сообщает о результате 78.68 в MTEB Code — по сравнению с 68.76 у предыдущей EmbeddingGemma — и прямо называет локальную индексацию репозиториев и извлечение данных для кодовых агентов одними из целевых вариантов использования.
EmbeddingGemma 2 — это модель эмбеддингов: она преобразует контент в векторы для извлечения и оценки сходства. Gemma 4 — генеративная модель, способная рассуждать на основе извлеченной информации, поэтому Google показывает их совместное использование в полностью локальных RAG-сценариях.
EmbeddingGemma 2 переносит мультимодальный семантический поиск из облака в область, доступную обычному пользовательскому оборудованию. Одна модель на 740 млн параметров может создавать эмбеддинги текста, кода, изображений, видео и аудио в едином векторном пространстве, используя около 567 МБ активной ОЗУ в полной мультимодальной конфигурации Google на Pixel 11 Pro.
Ее главное практическое преимущество — архитектурная простота: одна компактная модель может поддерживать локальный поиск по медиаданным, поиск моментов в видео, конфиденциальный RAG, поиск заметок на разных языках и индексацию репозиториев без необходимости загружать каждый исходный файл на сервер.
Официальные демонстрации Google, карточка модели и стек развертывания подтверждают сценарий работы на устройстве. Показатели браузера, Nativ, поиска по турецким заметкам и Nano-плате из исходной статьи представляют собой полезные ранние эксперименты разработчиков, но их следует воспринимать как результаты, зависящие от конкретной реализации, а не как гарантированную производительность.
EmbeddingGemma 2 делает локальное мультимодальное извлечение достаточно реалистичным, чтобы фотографии, записи, видео, документы и код все чаще можно было искать там, где они уже находятся, — на собственном устройстве пользователя.
Начните с одной фразы и получите полноценный сайт за считанные минуты.