For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/fable-5-cuda-megakernel-kernelbench-mega.md.
В этой статье объясняется, почему результат Fable 5 на KernelBench-Mega — это не просто очередная победа в бенчмарке. Важная деталь — одноза...
Fable 5 оказался в центре новой дискуссии в сфере AI-инженерии после того, как, по сообщениям, написал первое настоящее CUDA-мегаядро, представленное на KernelBench-Mega. Результат впечатляет: ускорение декодирования в 18,71 раза на системе RTX PRO 6000 Blackwell, полученное в ходе одного автономного сеанса продолжительностью примерно 2,5 часа.
Суть не только в том, что AI-система написала быстрый низкоуровневый код. Более важным является форма решения. Вместо объединения нескольких небольших GPU-ядер Fable 5 объединил рабочий процесс декодирования в единый кооперативный запуск ядра на токен. Именно это привлекло внимание исследователей и инженеров.

Эта статья сохраняет оригинальную структуру и технический смысл, но переписывает историю более понятным английским языком для публикации. В ней объясняется, что тестирует KernelBench-Mega, почему этот результат важен, чем мегаядро отличается от обычной генерации GPU-ядер и почему некоторые исследователи связывают его с идеей рекурсивного самосовершенствования.
Результат бенчмарка получен от KernelBench-Mega — теста, ориентированного на генерацию мегаядер полного блока, а не на оптимизацию изолированных операторов. В этом запуске Fable 5 нацелился на 02_kimi_linear_decode — гибридную задачу декодирования Kimi-Linear W4A16 с использованием 4-битных весов и активаций bf16.
Условия были строгими: один автономный сеанс, ограничение по времени 3 часа и реальная тестовая среда. В этих рамках Fable 5 достиг ускорения декодирования в 18,71 раза по сравнению с оптимизированным эталоном PyTorch.
Сравнение помогает лучше понять результат:
| Модель | Заявленное ускорение | Примечания |
|---|---|---|
| Fable 5 | 18,71x | CUDA-мегаядро, единый объединенный путь запуска |
| Claude Opus 4.8 | 14,40x | Сильный результат, но не та же модель единого CUDA-мегаядра |
| GPT-5.5 | 4,34x | Значительно меньшее ускорение на этой задаче |
| Claude Sonnet 5 | 4,03x | Диапазон, схожий с GPT-5.5 по данным этой таблицы лидеров |
oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/ce6c9cad-7360-4ac5-854b-279a01ab49ee-04-4d685459-6d03-4b22-840d-4e6787d38b10.png)
Разбивка по длине контекста также важна. Согласно отображаемой таблице лидеров, Fable 5 сохранял стабильность по мере увеличения контекста:
На первый взгляд это кажется нелогичным. Более длинный контекст обычно увеличивает затраты на обработку внимания (attention) и KV-кэша. Многие системы начинают терять производительность в таких условиях. Результат Fable 5 показывает, что объединённая конструкция снизила накладные расходы на запуск настолько, что её относительное преимущество стало больше по мере возрастания нагрузки.

KernelBench-Mega не просто просит модель доработать один маленький оператор. Он поручает агенту объединить более крупный блок модели в мегаядро (megakernel) целого блока. Это важно, потому что сложность теперь не в том, чтобы написать синтаксически корректный код на CUDA или Triton. Сложность заключается в управлении множеством взаимодействующих этапов вычислений в рамках одного эффективного пути.
Задача 02_kimi_linear_decode включает гибридную нагрузку декодирования для Kimi-Linear W4A16. На практике модель должна работать с квантованными весами, активациями bf16, состоянием, связанным с вниманием, маршрутизацией, нормализацией и поведением кэша.
Именно поэтому этот бенчмарк является значимым тестом на выносливость для низкоуровневого производительного кода, созданного ИИ. Простое ускорение на маленьком изолированном операторе полезно, но полноблочное мегаядро гораздо ближе к тому типу оптимизационной работы, которая может повлиять на реальные системы инференса.
Самое важное техническое утверждение заключается в том, что Fable 5 создал первое в истории KernelBench-Mega настоящее мегаядро.
Мегаядро сжимает более крупный путь инференса в одно ядро. Вместо запуска нескольких отдельных ядер и постоянного переключения управления между ними, оно удерживает всю работу в одном координированном потоке выполнения. Это сложно, потому что ядро должно координировать множество фаз, сохраняя при этом корректность.
В данном случае в отчёте указано, что torch.profiler показал ровно один запуск кооперативного ядра на каждый декодированный токен. Этот единственный запуск обработал работу, которая обычно разбивается на несколько этапов, включая:
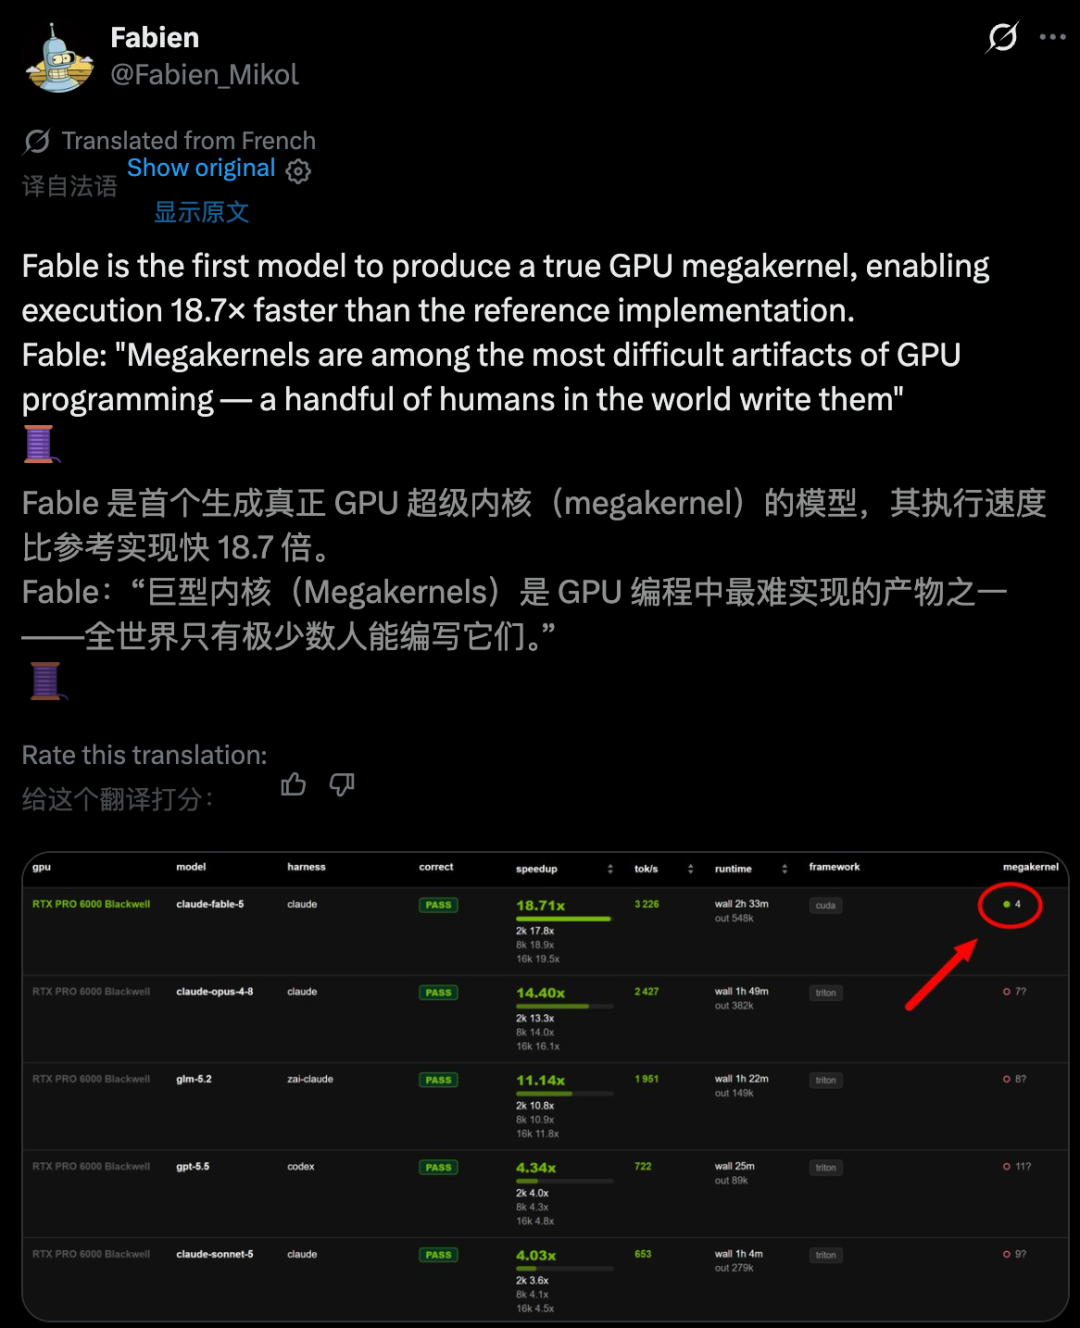
Сообщается, что другие участники с высокими показателями разделяли работу на 4–14 отдельных запусков ядер. Fable 5 объединил временной путь в один слитный кооперативный запуск. В этом разница между «быстро сгенерированным кодом ядра» и гораздо более агрессивным артефактом GPU-программирования.
Запуски ядер не бесплатны. Каждый запуск имеет накладные расходы, затраты на синхронизацию и промежутки в планировании. В задаче декодирования эти затраты становятся особенно ощутимыми, поскольку работа повторяется токен за токеном.
Подход Fable 5 снижает эти повторяющиеся накладные расходы, объединяя этапы декодирования в один кооперативный путь. В оригинальном отчете решение описывается как использование 14 барьеров сетки для организации вычислений внутри одного запуска.
Вот почему результат заключается не только в умной математике. Речь идет о выполнении на уровне системы GPU. Когда другие решения многократно выходят из ядер и возвращаются в них, они теряют время на передаче управления. Fable 5 избегает большей части этих затрат, сохраняя конвейер слитным.
Простыми словами: другие выполняют работу за несколько подходов; Fable 5 пытается сделать это за один.
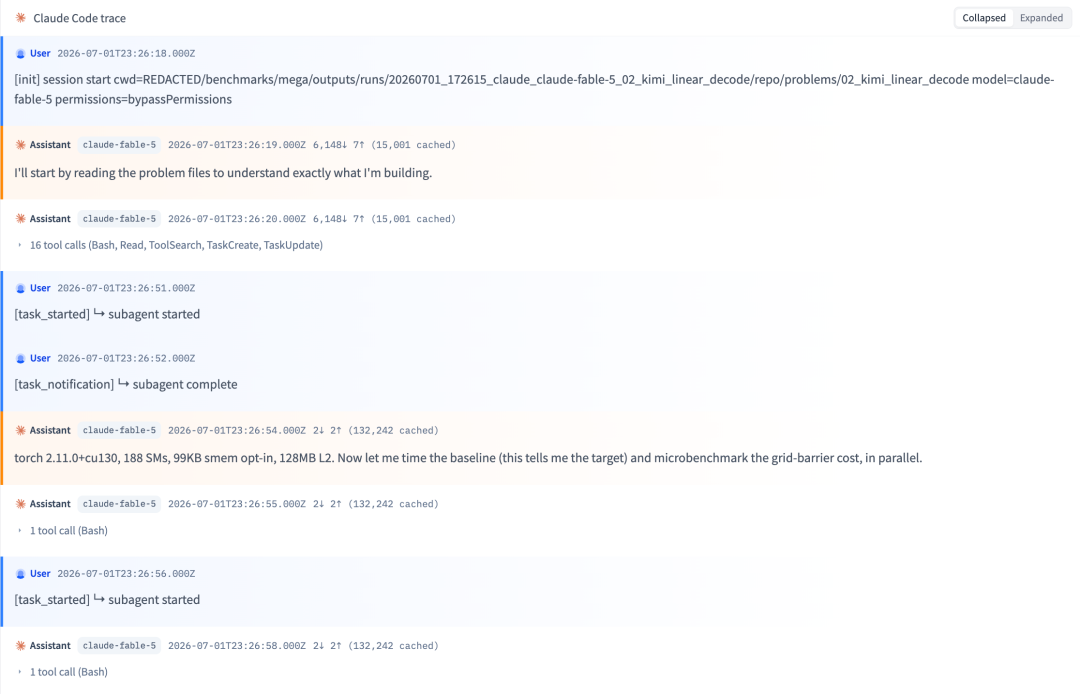
Еще одна примечательная часть выполнения — как модель использовала свое время. Она не начала немедленно выдавать готовый код CUDA. Трассировка указывает на более размеренный рабочий процесс.
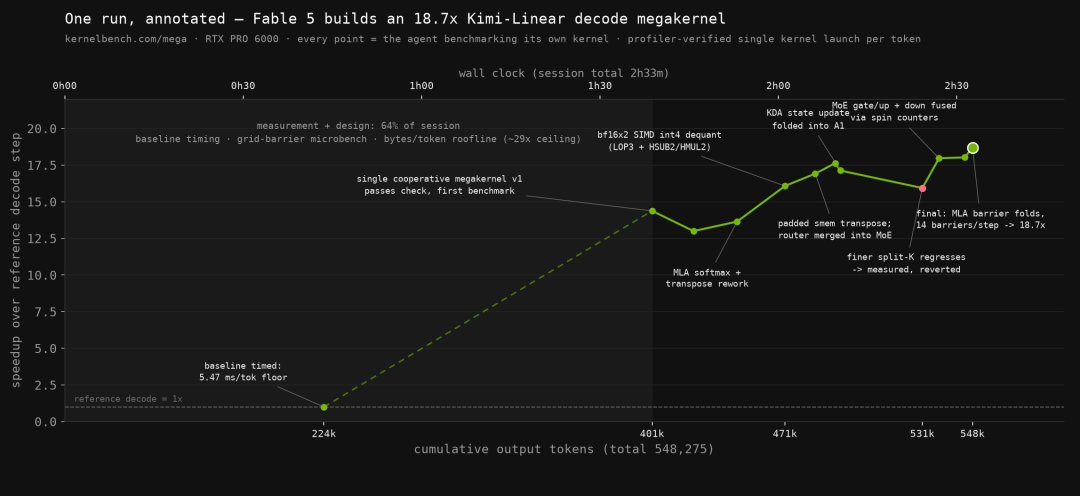
Бóльшую часть сессии Fable 5 тестировала базовый уровень, исследовала затраты на барьеры сетки и анализировала пропускную способность памяти. Согласно статье, примерно 64% сессии было потрачено на измерения и проектирование до того, как была создана основная реализация.
После написания первоначальной версии первый тест, по сообщениям, достиг примерно 14,4-кратного ускорения. Затем Fable 5 использовал оставшееся время для удаления барьеров, оптимизации int4-деквантизации, тестирования изменений и отката одной неудачной оптимизации, когда измерения показали, что она ухудшила результат.
Полный запуск занял около 2,5 часов и использовал примерно 550 000 выходных токенов. Ключевая деталь — не только масштаб. Это поведение: тестирование, построение, измерение, откат при необходимости и оптимизация на основе данных, а не уверенности.
В оригинальном источнике также отмечается, что Fable 5 описывается как более безопасная или урезанная версия внутренней модели Mythos от Anthropic. Это утверждение следует воспринимать как часть повествования источника, а не как публичное объявление о продукте.
Более широкая дискуссия возникла из информационного бюллетеня Import AI Джека Кларка. В этом
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Кларк представил результат работы GPU-ядра как признак того, что ИИ-системы становятся всё лучше в автоматизации частей собственных исследований и разработок в области ИИ.
Логика проста:
Именно поэтому в этом обсуждении встречается фраза «рекурсивное самоулучшение». Это не означает, что уже возникла полностью автономная неконтролируемая петля. Это значит, что один элемент этой петли — улучшение ИИ инфраструктуры, используемой для создания ИИ, — становится всё более заметным и измеримым.
Оригинальная статья также связывает этот результат с более широкими бенчмарками автоматизации. В Import AI обсуждается Индекс удалённого труда, где ИИ-агенты оцениваются по экономически полезным онлайн-проектам.
Дело не в том, что написание CUDA-ядер и автоматизация фриланс-задач — одно и то же. Это не так. Но оба явления указывают в одном направлении: передовые ИИ-системы улучшаются в выполнении более длительных и структурированных задач, требующих планирования, использования инструментов, проверки и итераций.
Один комментарий в исходном материале хорошо отражает суть опасений: как только модель сможет писать ядра, ускоряющие модели, инструмент перестаёт лишь помогать пользователям. Он также начинает улучшать части собственной основы.
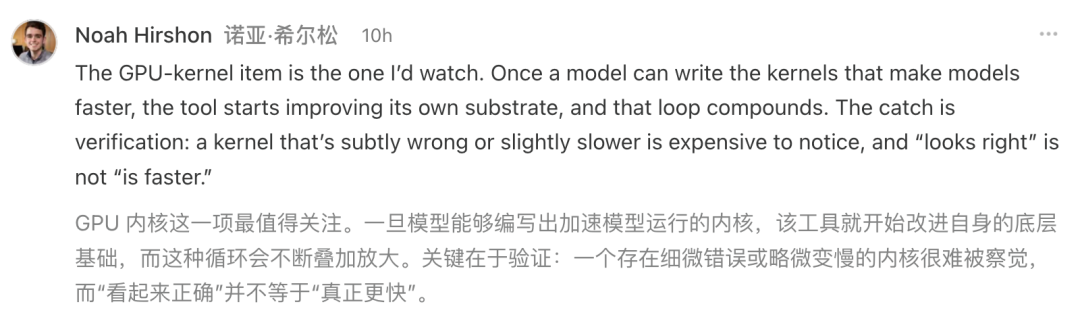
Именно здесь проверка становится критически важной. Ядро, которое выглядит правильным, не обязательно быстрее. Более быстрое на вид ядро может содержать тонкие ошибки корректности. В низкоуровневой работе с GPU цикл проверки должен оставаться строгим.
У этой истории две стороны. С одной стороны, результат впечатляет. ИИ-системы теперь создают низкоуровневые артефакты производительности, которые раньше были доступны лишь небольшому числу экспертных программистов GPU.
com/cms-assets/image/2026/07/0fdc859f-d6a1-47e7-b2ba-5e2fefcf3a3f-12-593ae533-5c09-47f2-840c-11d03c53dc3a.png)
С другой стороны, это именно та способность, которая заслуживает пристального внимания. В том же выпуске новостной рассылки описывается будущее, где универсальные вычисления становятся настолько мощными и опасными, что люди пытаются их ограничить. Этот вымышленный финал — не предсказание, а отражение беспокойства, связанного с ускоряющимися технологическими системами.
Чуть более чем через год после того, как оригинальная работа KernelBench показала, насколько сложными могут быть ядра, созданные ИИ, этот результат свидетельствует о значительном скачке. Fable 5 не просто сгенерировал работоспособное ядро. Он создал объединенный путь мегаядра, который за одну ограниченную сессию достиг вершины сложного бенчмарка.
Для ИИ-инфраструктуры это серьезный сигнал.
02_kimi_linear_decode и torch.profiler, были сохранены.KernelBench-Mega — это бенчмарк, ориентированный на генерацию целых блочных мегаядер. Вместо того чтобы просить модель оптимизировать один изолированный оператор, он просит модель объединить более крупную рабочую нагрузку в эффективный путь ядра, а затем измеряет реальную производительность.
Сообщается, что Fable 5 достиг ускорения декодирования в 18,71 раза по сравнению с оптимизированным эталоном PyTorch на задаче 02_kimi_linear_decode. Результат был получен в рамках одного автономного сеанса с ограничением в 3 часа.
Мегаядро должно координировать множество этапов вычислений в рамках одного запуска ядра. Это означает, что реализация должна управлять перемещением данных, синхронизацией, числовой корректностью, пропускной способностью памяти и порядком выполнения, не разделяя работу на более безопасные, мелкие ядра.
Каждый запуск ядра GPU имеет накладные расходы. При покадровом декодировании повторные запуски могут быстро накапливаться. Один объединенный запуск может уменьшить накладные расходы на синхронизацию и планирование, поэтому...
Подход Fable 5 технически значим.
Это не является доказательством полного автономного цикла самосовершенствования. Это лучше понимать как конкретный сигнал того, что системы ИИ начинают автоматизировать задачи, которые могут улучшить инфраструктуру ИИ, такие как разработка ядер и оптимизация вывода.
Не напрямую, без тщательной проверки. Производительный код требует строгих проверок корректности, профилирования, регрессионного тестирования и валидации под конкретное оборудование. Быстрый результат бенчмарка многообещающ, но для промышленного внедрения требуется гораздо больше проверок.
KernelBench-Mega предоставляет таблицу лидеров и артефакты запусков. PyTorch profiler, инструменты CUDA, наборы данных трассировки Hugging Face и инструменты профилирования GPU полезны для понимания того, как ведет себя сгенерированное ядро.
Эта статья объясняет, почему сообщенный результат Fable 5 в KernelBench-Mega — это не просто очередная победа в бенчмарке. Важная деталь заключается в том, что
Одноразовый запуск CUDA-мегаядра: объединённый путь, обрабатывающий сложную рабочую нагрузку декодирования с гораздо меньшими накладными расходами на запуск по сравнению с многокернельными решениями.
Результат также имеет значение, поскольку он указывает на то, что ИИ-системы становятся лучше в задачах оптимизации производительности, поддерживающих само развитие ИИ. Более быстрые ядра могут сделать инференс и обучение более эффективными, что создаёт петлю обратной связи, за которой стоит наблюдать.
В то же время сгенерированный ИИ низкоуровневый код не следует по умолчанию считать готовым к продакшену. Корректность, профилирование, особенности аппаратного обеспечения и регрессионное тестирование по-прежнему важны.
Главный вывод: мегаядро Fable 5 — это сильный сигнал того, что ИИ-ассистированная инженерия производительности GPU переходит от демонстрационной стадии к серьёзной инфраструктурной работе.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



