For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/fable-5-pxpipe-image-context-token-savings.md.
pxpipe показывает умный способ снизить затраты на входные данные в Fable 5: преобразовывать контекст с большим количеством токенов в компакт...
В сообществе Fable 5 начал привлекать внимание один на удивление олдскульный приём: превращать длинный текстовый контекст в плотные изображения, а затем позволять модели считывать эти изображения обратно с помощью своей способности к компьютерному зрению.
Звучит почти как создание маленькой шпаргалки к экзамену. Но в данном случае эта «шпаргалка» предназначена не для человека. Она предназначена для мультимодальной модели, которая умеет читать скриншоты. Один разработчик обнаружил, что при преобразовании контекста Claude Code в плотно упакованные PNG-изображения стоимость входных токенов в протестированных сценариях могла снизиться примерно на 59–70%.
Базовая идея проста: системные промпты, документация по инструментам, вывод команд, логи и старая история диалога часто оказываются чрезвычайно «тяжёлыми» по числу токенов. Если эти блоки отрисовать в виде изображений, то стоимость в image-token будет в основном зависеть от размеров изображения, а не от объёма текста, упакованного в него.
В этой статье рассматривается, что делает pxpipe, почему этот метод позволяет экономить, где он даёт сбой и как он связан с более ранними исследованиями, такими как CLIPPO, а также с более новыми работами по оптическому сжатию контекста, например DeepSeek-OCR.
Эта статья основана на оригинальной китайской публикации на BAAI Hub, где указано, что источником послужил материал QbitAI в WeChat. Среди исходных ссылок упоминаются GitHub-репозиторий pxpipe и статья о CLIPPO. Изображения, сохранённые ниже, представляют собой скриншоты, демо, диаграммы и скриншоты обсуждений в соцсетях, относящиеся к теме статьи. QR-коды, призывы подписаться, CTA для вовлечения и несвязанное декоративное оформление платформ были удалены.
Метод, ставший вирусным, называется pxpipe. Это локальный прокси с открытым исходным кодом, который переписывает громоздкий входной контекст Claude Code до того, как запрос покинет вашу машину.
Согласно описанию проекта, pxpipe снижает потребление токенов, визуализируя большие текстовые блоки в виде изображений. Те же системные промпты, документация по инструментам, вывод инструментов и старая история могут занимать значительно меньше токенов, если модель достаточно хорошо умеет читать плотно отрисованный текст.
В одном из примеров около 48 000 символов системного промпта и документации по инструментам заняли бы примерно 25 000 токенов в виде обычного текста. После рендеринга в изображение размером 1573 × 1248 тот же контент, как сообщается, потребовал около 2700 image-token.
Именно эта разница и даёт снижение стоимости.
Приблизительная
Логика такова:
Некоторые разработчики шутили, что это буквальный случай выражения «картинка стоит тысячи слов». В данном случае шутка оказалась необычайно близка к технической реальности.

pxpipe — это не новая модель и не традиционный OCR-движок. Он работает как локальный прокси между Claude Code и API модели.
Перед отправкой запроса pxpipe ищет большие блоки, подходящие для сжатия. Затем он рендерит эти блоки в компактные страницы PNG и вставляет их обратно в запрос как входные изображения. Модель читает эти страницы через свой обычный канал зрения.
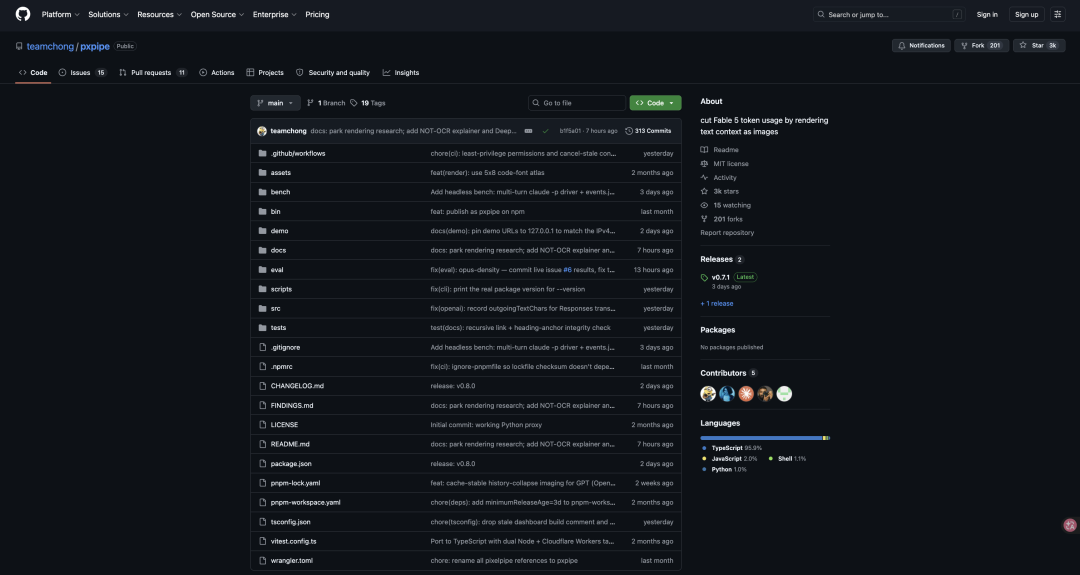
Проще говоря, pxpipe работает как автоматический микропринтер для длинного контекста. Он не заставляет модель выполнять «OCR» текста в строгом инженерном смысле. Вместо этого он опирается на встроенную способность модели читать визуальный ввод, похожий на скриншоты.
В README pxpipe объясняется, что он фокусируется на громоздком входном контексте, таком как:
tool_result, включая чтение файлов, вывод команд и логи.Он намеренно не преобразует всё подряд. Недавние реплики, пользовательские сообщения, точные идентификаторы, небольшие блоки, разреженная проза и вывод модели остаются текстом.
Ключевое несоответствие в ценообразовании заключается в том, что входные изображения и текстовые
входные данные измеряются по-разному.
Для ориентированных на текст рабочих процессов разработчиков исходный материал часто имеет высокую плотность токенов. Код, логи, JSON, трассировки стека и схемы инструментов могут обходиться дорого, если отправлять их как обычный текст. Автор pxpipe предполагает, что в реальном трафике Claude Code плотный контент может упаковываться примерно по 3,1 символа на один токен изображения, по сравнению примерно с 1 символом на один текстовый токен.
Это соотношение дает pxpipe возможность снижать стоимость, когда текст достаточно плотный.
Автор также поделился сравнительной демонстрацией. В исходной текстовой версии тестовый прогон, как сообщается, завершился со счетом в $42.21 и почти полностью заполненным контекстным окном. В версии с pxpipe та же задача была выполнена за $6.06, при этом свободного места в контексте осталось значительно больше.
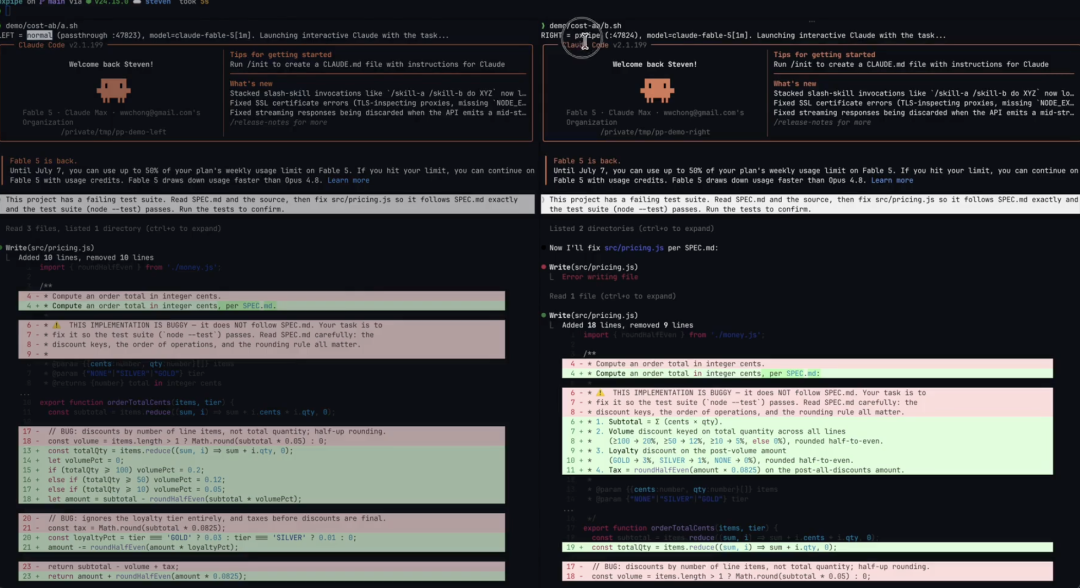
Важная деталь состоит в том, что pxpipe сжимает только сторону запроса. Ответ модели по-прежнему обычно возвращается потоком в виде текста. Выходные токены он не сжимает.
Метод впечатляет, но он не является без потерь. Плотный контекст в изображениях сильно зависит от способности модели читать визуальную информацию.
Скриншот бенчмарка pxpipe показывает, что Fable 5 хорошо справляется с несколькими задачами на контекст изображений, включая новую арифметику, воспроизведение общей сути, отслеживание состояния и некоторые тесты на воспроизведение плотно отрендеренного содержимого. Но точное воспроизведение строк — слабое место, особенно у моделей, которые плохо читают плотный текст.
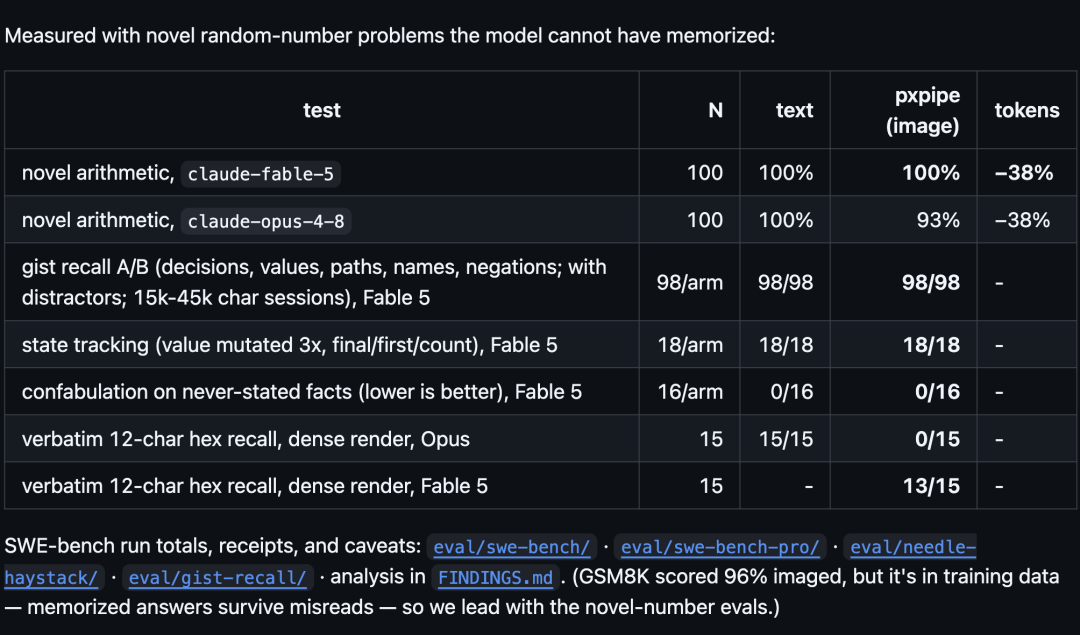
Упрощенная версия приведенной таблицы бенчмарка выглядит так:
| Тест | N | Текст | Изображение pxpipe | Изменение токенов |
|---|---|---|---|---|
Новая арифметика, claude-fable-5 | 100 | 100% | 100% | -38% |
Новая арифметика, claude-opus-4-8 | 100 | 100% | 93% | -38% |
| Воспроизведение сути A/B, Fable 5 | 98 на вариант | 98/98 | 98/98 | — |
| Отслеживание состояния, Fable 5 | 18 на вариант | 18/18 | 18/18 | — |
| Галлюцинации о фактах, которые никогда не утверждались, Fable 5 | 16 на вариант | 0/16 | 0/16 | — |
| Дословное воспроизведение 12-символьной hex-строки, Opus | 15 | 15/15 | 0/15 | — |
| Дословное воспроизведение 12-символьной hex-строки, Fable 5 | 15 | — | 13/15 | — |
Опасность очевидна: контекст на основе изображений может быть достаточно хорош для широкого семантического понимания, отслеживания состояния и многих задач программирования, но при этом он может незаметно неверно считывать точные строки.
Идентификаторы, хэши, секреты, фиксированные числа и другие значения, требующие точного побайтного совпадения, не следует помещать в плотные изображения. В собственных примечаниях pxpipe этот момент подчеркивается: компромисс здесь серьезный, а типичный сценарий сбоя — это уверенный, но неверный ответ, а не очевидная ошибка.
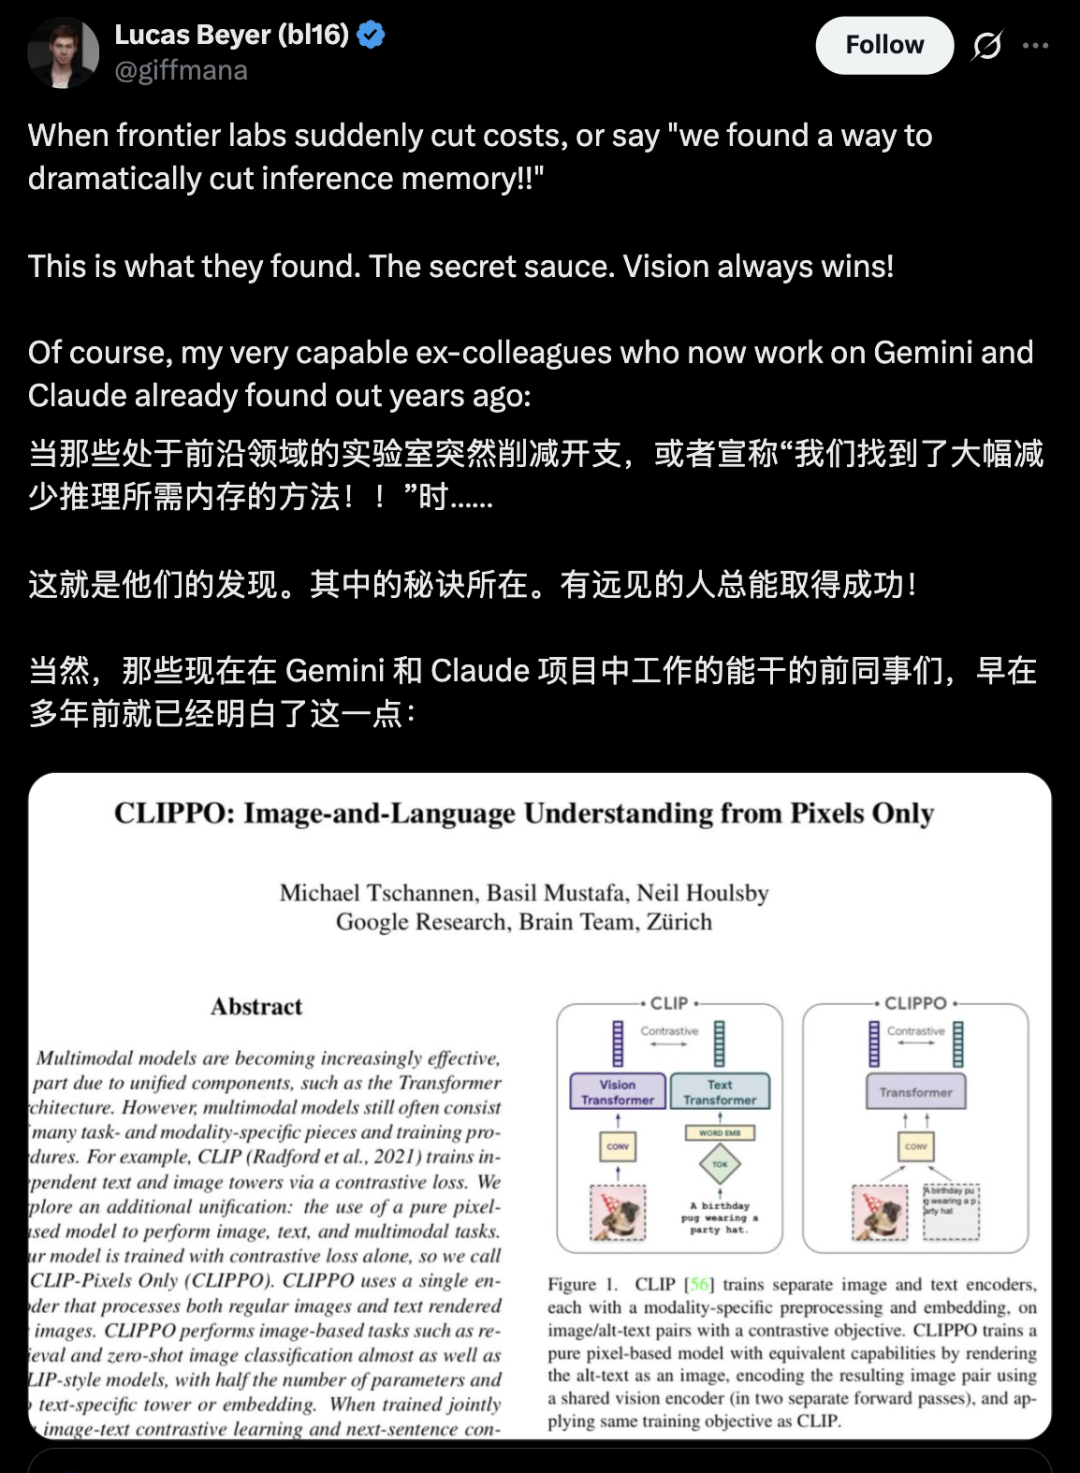
Нижеприведённый пост был опубликован в ответе @sanixdarker, который отметил, что такой подход вовсе не нов: он делает так с момента выхода Opus, и это не имеет прямого отношения к серии Fable. Изображение тесно связано с контекстом и наглядно иллюстрирует обсуждение рисков, которые может нести преобразование определённых данных в плотные изображения.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/8d83ec15-fc8e-4019-8909-2d441f51f258-10-af6628e8-7211-4ee2-8a25-33b3a4e2a529.png)
Поскольку сжатие является с потерями, pxpipe не превращает без разбора каждый входной блок в изображение. Чувствительный контент и данные, критичные к точности, он сохраняет в текстовом виде.
Примеры того, что должно оставаться обычным текстом:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Именно поэтому проект и описывает экономию как зависящую от характера нагрузки. Если запрос в основном состоит из длинной прозы на естественном языке, сжатие может оказаться невыгодным. Если же запрос насыщен кодом, JSON, логами и выводом инструментов, экономия может быть значительно больше.
Автор приводит очень краткую схему запуска. Сначала запустите прокси локально, затем направьте Claude Code на этот прокси.
npx pxpipe-proxy                                  # прокси на 127.0.0.1:47821
ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude  # направить Claude Code на него
После запуска pxpipe также открывает локальную панель управления:
http://127.0.0.1:47821/
Панель может показывать экономию токенов, параллельное сравнение преобразований текста в изображение, аварийный выключатель и теги моделей в реальном времени. Это упрощает понимание того, что именно сжимается, а что проходит без изменений.
После того как pxpipe начал распространяться, некоторые исследователи отметили, что сама ключевая идея не является совершенно новой.
Связанное направление работы появилось в статье Google 2022 года CLIPPO: Image-and-Language Understanding from Pixels Only. Центральная идея CLIPPO заключается в том, чтобы рассматривать текст как пиксели, а не как отдельный поток токенизированного текста.
Традиционные модели в стиле CLIP часто используют две башни: одну для изображений и одну для текста. CLIPPO устраняет это разделение, визуализируя текст как RGB-изображения и пропуская и изображения, и визуализированный текст через общий Vision Transformer.
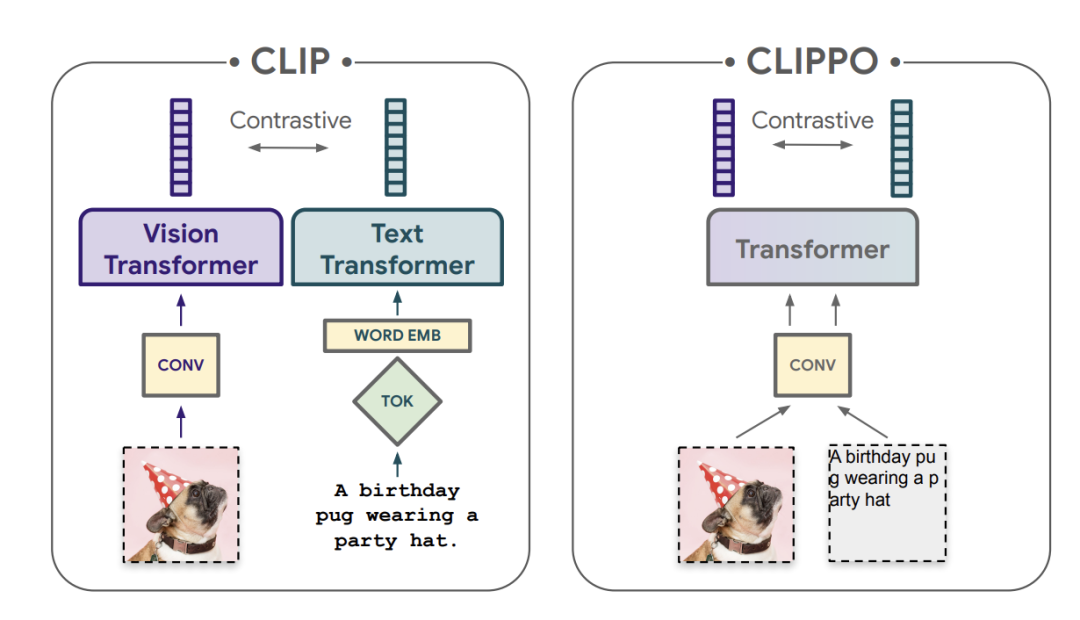
Главный вывод здесь важен: текст не всегда должен поступать в модель в виде дискретных текстовых токенов. Его также можно преобразовать в пиксели и обрабатывать через визуальные каналы.
Обсуждение также
упомянул DeepSeek-OCR, который сосредоточен на оптическом сжатии для длинного контекста. В его репозитории проект описывается как «Contexts Optical Compression».
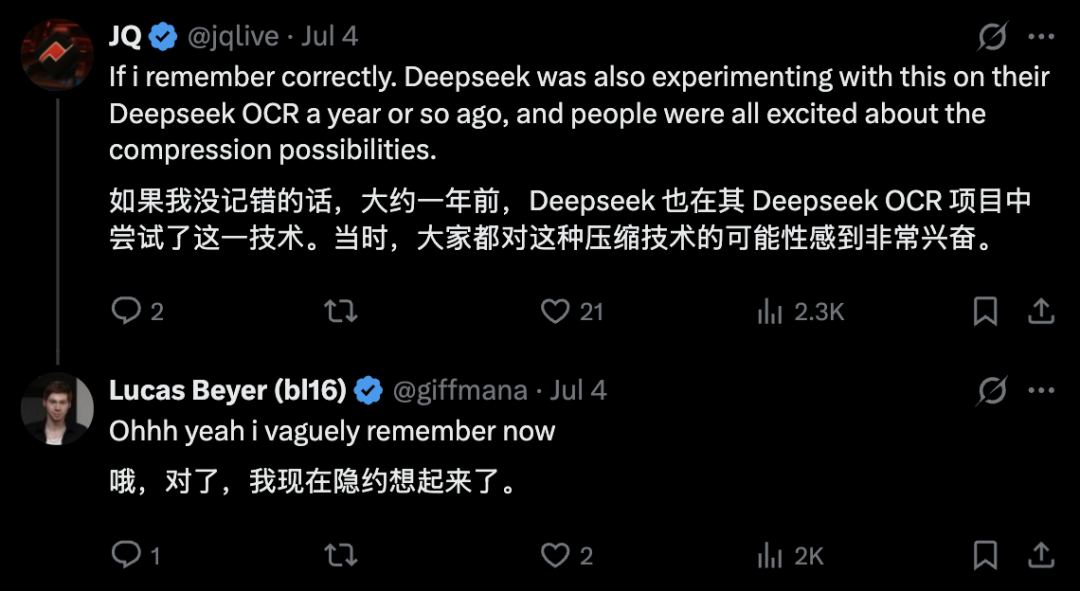
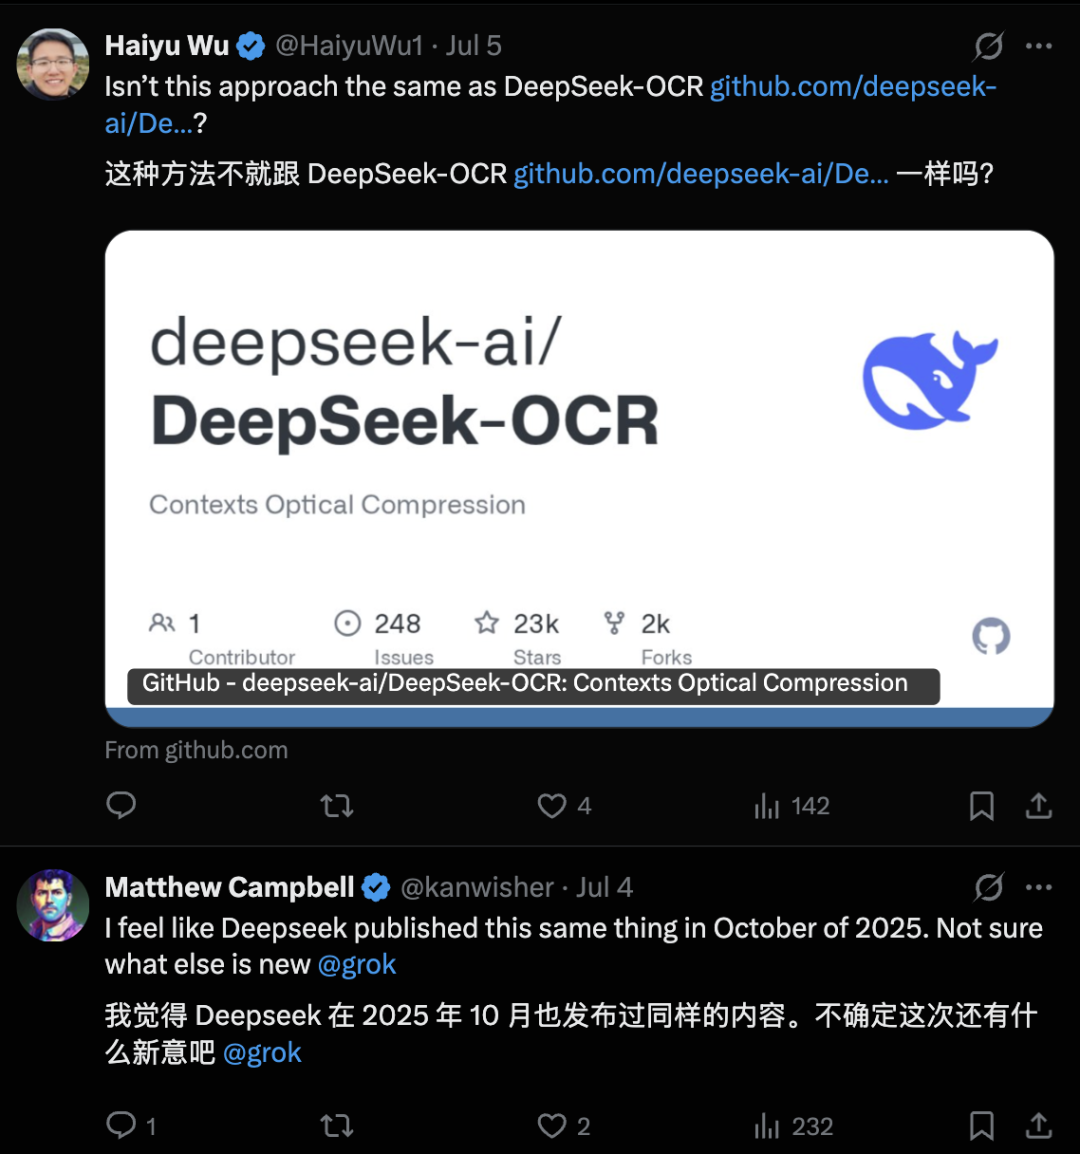
В этом смысле pxpipe — не просто разовый трюк для снижения затрат. Он связывает сразу несколько тенденций:
Однако остаётся жёсткое ограничение: надёжность точного воспроизведения строк. Некоторые комментаторы предположили, что проблему можно улучшить просто за счёт масштабирования более мощных визуально-языковых моделей.
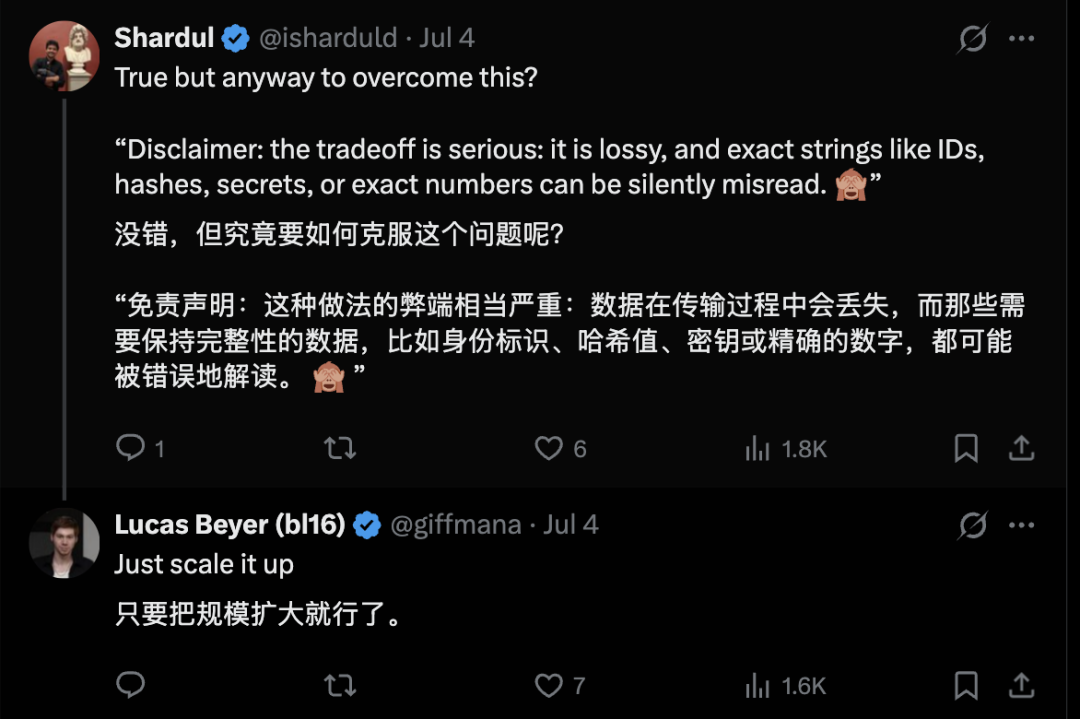
pxpipe наиболее полезен, когда контекст большой, плотный и не требует критической точности. Сеансы программирования — естественный вариант применения, потому что агенты часто перечитывают файлы перед их редактированием, что может снижать риск действий на основе неверно прочитанного блока изображения.
Он хуже подходит для рабочих процессов, где важна точная посимвольная реконструкция. Если задача зависит от идентификаторов, хэшей, учётных данных, точных юридических формулировок, финансовых чисел или другого чувствительного к точности содержимого, к сжатию на основе изображений следует относиться с осторожностью.
Разумный способ использовать pxpipe — держать его как слой оптимизации, а не как границу доверия. Пусть он сжимает объёмный контекст там, где это математически выгодно, но критически важные значения оставляйте в текстовом виде и проверяйте панель управления при отладке странного поведения модели.
pxpipe — это локальный прокси, который снижает расход токенов, преобразуя объёмный входной контекст Claude Code в компактные PNG-изображения. Он предназначен для плотного контекста, такого как выводы инструментов, логи, код, системные промпты и более старая история диалога.
Он использует тот факт, что стоимость токенов для изображений в основном зависит от размеров в пикселях, тогда как стоимость текстовых токенов растёт вместе с объёмом текста. Если модель может надёжно читать плотно отрисованный текст, большие блоки могут обходиться дешевле в виде изображений, чем в виде обычного текста.
Нет. pxpipe сжимает только выбранные входные блоки перед отправкой запроса. Модель的
ответ по-прежнему обычно передаётся в виде текста, поэтому количество выходных токенов не уменьшается.
Нет. Это метод сжатия с потерями. Он может хорошо работать для широкого контекста, отслеживания состояния и многих задач программирования, но точные строки, такие как идентификаторы, хеши, секреты и точные числа, могут быть распознаны неверно.
Не безопасно. В собственной документации pxpipe поддержка моделей рассматривается как ограниченная и зависящая от типа нагрузки. Некоторые модели значительно хуже читают плотный отрисованный текст, чем другие, поэтому неподдерживаемые или более слабые модели должны получать данные в виде текста, если только это явно не включено.
Идентификаторы, хеши, секреты, точные числа, сообщения пользователей, недавние реплики и другие критически важные для точности блоки следует оставлять в виде текста. pxpipe лучше подходит для длинных, плотных и менее чувствительных к побайтовой точности материалов, таких как журналы, документация по инструментам и старая история.
Запустите прокси с помощью npx pxpipe-proxy, затем запустите Claude Code с ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude. Локальная панель управления доступна по адресу http://127.0.0.1:47821/.
pxpipe демонстрирует изобретательный способ снизить затраты на входные данные в Fable 5: преобразовывать насыщенный токенами контекст в компактные изображения и позволять модели считывать эти изображения с помощью своей способности работать со зрительной информацией. Для плотных рабочих нагрузок, связанных с программированием, это может значительно сократить затраты на стороне запроса
меньшее потребление токенов и более низкая сквозная стоимость.
Компромисс заключается в том, что этот метод является с потерями. Он может сохранять достаточно смысла для многих рабочих процессов, связанных с программированием и отслеживанием состояния, но на него не следует полагаться для побайтно точного воспроизведения идентификаторов, хэшей, секретов или точных чисел.
Более общий вывод состоит в том, что текст внутри ИИ-систем не всегда должен оставаться текстом. CLIPPO, DeepSeek-OCR и pxpipe указывают на одну и ту же идею: пиксели могут стать практичным слоем сжатия для длинного контекста.
Лучший сценарий использования очевиден: сжимать объёмный контекст, не требующий высокой точности, но сохранять критически важные точные значения в обычном тексте.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



