For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize объявила о подтверждённом результате Gemini 4 Argon в 97,5% на ARC-AGI-3. По данным организатора, Google DeepMind стала второй вед...
ARC Prize объявила о подтверждённом результате Gemini 4 Argon в 97,5% на ARC-AGI-3. По данным организатора, Google DeepMind стала второй ведущей лабораторией, преодолевшей на этом бенчмарке отметку 95%.
Не менее важен результат сравнения: в том же семействе моделей результат составил 49,8% при использовании стандартной тестовой оболочки, тогда как с Provider Adapter он достиг 97,5%. По опубликованным данным, оценка обошлась примерно в 5800 и 4800 долларов соответственно.
Это результаты конкретно настроенных систем. Прежде чем делать выводы на основании громкой цифры, необходимо разобраться в бенчмарке, уровне рассуждений, тестовой оболочке и неполных запусках.
В объявлении ARC Prize приведены следующие показатели:
| Бенчмарк и конфигурация | Заявленный результат | Заявленная стоимость оценки |
|---|---|---|
| ARC-AGI-1, лучший опубликованный результат | 98,5% | Около 0,16 доллара за задачу |
| ARC-AGI-2, лучший опубликованный результат | 91,3% | Около 0,32 доллара за задачу |
| ARC-AGI-3, Provider Adapter, низкий уровень рассуждений | 97,5% | Около 4800 долларов за оценку |
| ARC-AGI-3, Standard, низкий уровень рассуждений | 49,8% | Около 5800 долларов за оценку |
Единицы измерения стоимости различаются. Суммы для ARC-AGI-1 и ARC-AGI-2 указаны за задачу; суммы для ARC-AGI-3 относятся ко всему оценочному запуску. Сопоставлять их в рамках одной шкалы стоимости нельзя, не учитывая это различие.
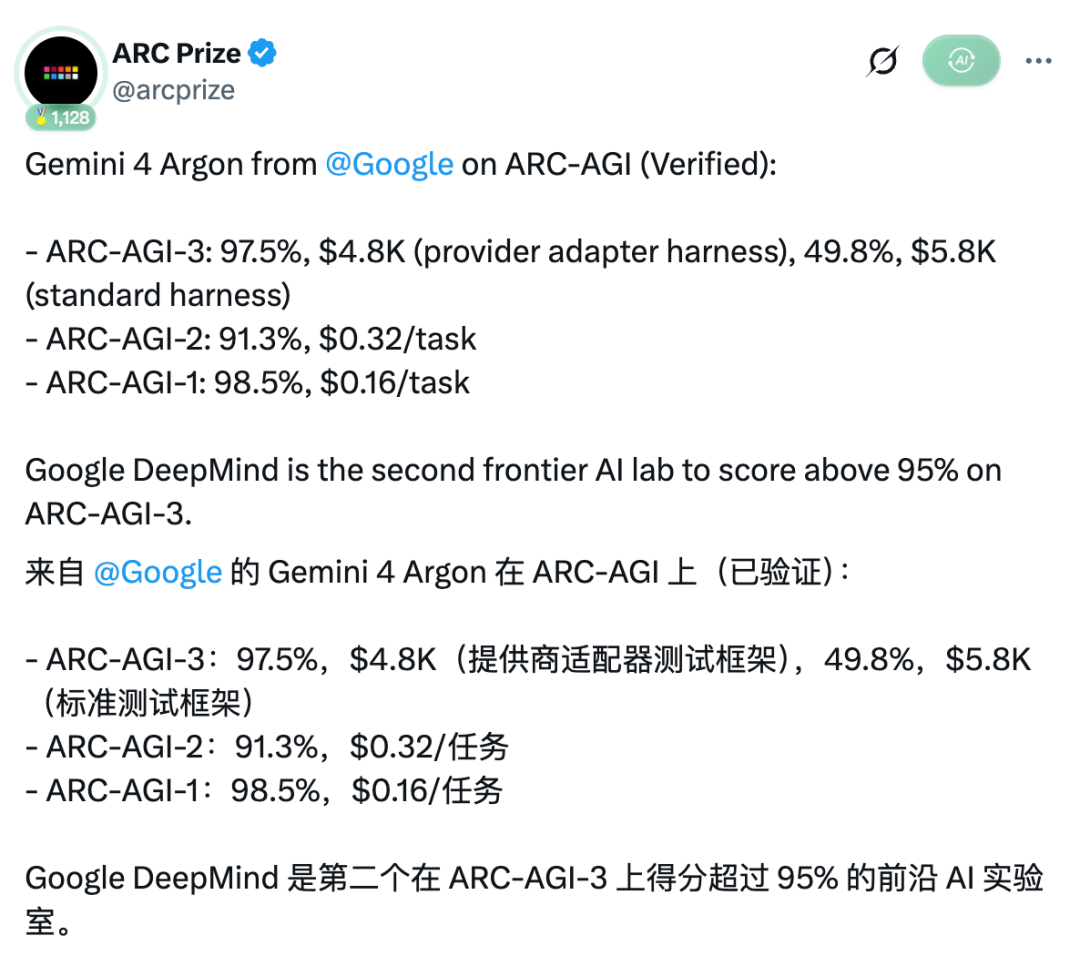
Объявление ARC Prize о подтверждённых результатах, воспроизведённое в исходном отчёте.
В актуальной таблице указана более точная стоимость лучших результатов: 0,162 доллара за задачу для ARC-AGI-1 и 0,325 доллара для ARC-AGI-2. Там указан результат 91,3% для ARC-AGI-2, совпадающий с объявлением, хотя в сопровождающем абзаце на странице результатов говорится о 91,2%. В этой статье сохранено значение из объявления и таблицы, а расхождение отмечено.
ARC-AGI-3 отличается от первых двух поколений. Вместо вывода сетки с ответом по статическим примерам агент исследует незнакомую интерактивную среду, выясняет, как работают действия, и учится достигать целей без текстовых инструкций, объясняющих правила игры.
ARC Prize описывает этот тест как измерение эффективности освоения навыков, адаптации и планирования с течением времени. Поэтому оценка не равна «проценту выигранных игр». Согласно объяснению бенчмарка, результат в 100% предполагает завершение игр с эффективностью, сопоставимой с эталонной человеческой.
В исходном материале прослеживается путь от результатов ведущих моделей ниже 1% примерно на момент запуска ARC-AGI-3 в марте до показателей, близких к верхнему пределу, позднее в том же году. В нём отмечен более ранний результат OpenAI — GPT-6 Astra, за которым последовало появление Gemini с результатом выше 95%.
Для этой оценки это существенный сдвиг. Но он не означает, что организатор проверил все возможные формы рассуждения или доказал, что любая из систем способна осваивать новые задачи так же, как человек.
В отчёте также говорится об эффективном выполнении действий в 25 общедоступных играх: на 62% меньше действий, чем у человека в качестве эталона; в трёх играх результат соответствовал рекордам спидранов или превосходил их; ещё в шести результат отставал от таких рекордов не более чем на 10%. Эти сравнения относятся к наблюдениям на общедоступном наборе, опубликованным в источнике. Их нельзя переносить на все 55 оценочных задач или произвольные игры.
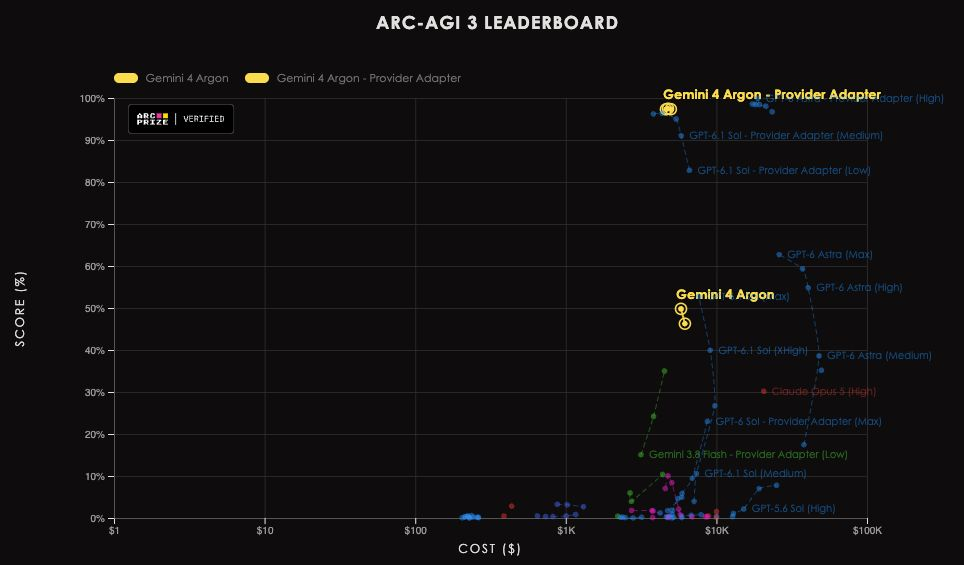
Снимок таблицы лидеров из отчёта; актуальные сведения о конфигурациях приведены на текущей странице результатов.
Тестовая оболочка агента управляет взаимодействием с моделью: определяет, как поступают наблюдения, как отправляются действия, какой контекст сохраняется и что происходит при увеличении длины диалога.
ARC Prize описывает два условия отдельно:
Для Gemini 4 Argon на актуальной странице результатов указаны следующие значения:
| Уровень рассуждений | Тестовая оболочка Standard | Тестовая оболочка Provider Adapter |
|---|---|---|
| Низкий | 49,8% | 97,5% |
| Средний | 46,3% | 97,3% |
| Высокий | Нет полного опубликованного результата для сравнения | 97,3% |
Разница при низком уровне рассуждений составляет 47,7 процентного пункта. Это показывает, что настроенная система взаимодействия существенно влияет на измеряемый результат, но не позволяет выделить единственную причину. Помимо названия тестовой оболочки, необходимо учитывать обработку контекста, условия выполнения, надёжность API и другие настройки.
В частности, ARC Prize сообщает о проблемах с API, из-за которых не удалось завершить оценку Standard. Запуски с низким, средним и высоким уровнями рассуждений завершились для 42, 46 и 19 задач из 55 соответственно. В опубликованных итоговых результатах учтены все 55 задач и сохранены частичные баллы за незавершённые запуски; эти числа не означают, что в 42 или 46 играх обязательно удалось полностью достичь цели.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Незавершённый результат Standard с высоким уровнем рассуждений не включили в диаграмму. Поэтому в рамках этой оценки более высокие усилия на рассуждение не дали последовательности полностью завершённых и напрямую сопоставимых результатов Standard.
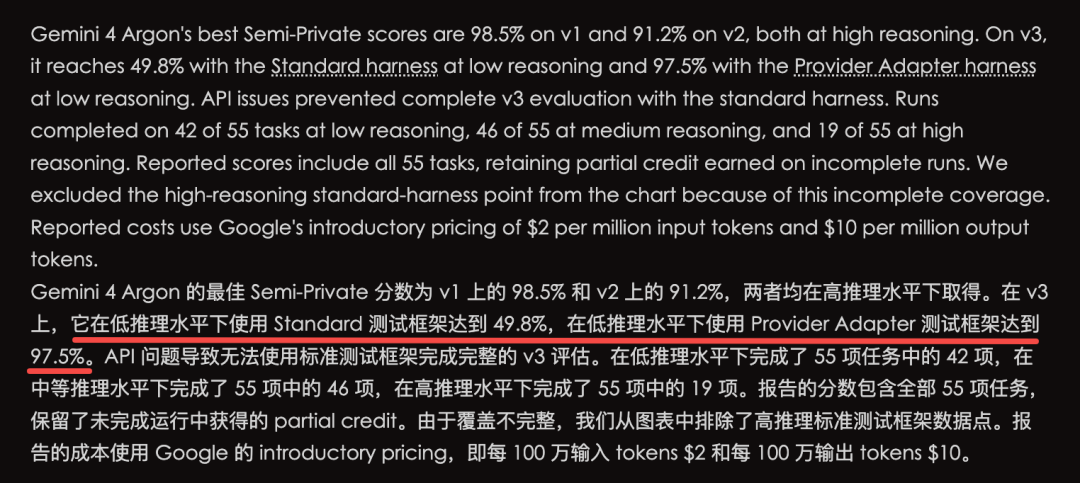
Примечание о конфигурации и охвате, воспроизведённое в исходном отчёте; для получения обновлений следует обращаться к актуальной странице результатов.
По данным ARC Prize, оценки стоимости рассчитаны по вводным ценам Google API: 2 доллара за миллион входных токенов и 10 долларов за миллион выходных токенов. Это не фиксированная цена решения новой задачи из реального мира; она может измениться в зависимости от тарифов и конфигурации.
Главный практический вывод исходного материала обоснован: название модели и единственный процент не раскрывают всей системы, которую оценивают. Два результата с одним и тем же названием модели могут отвечать на разные вопросы, если в них используются интерфейсы управления контекстом с разными возможностями.
В правилах ARC Prize прямо говорится, что результаты для двух тестовых оболочек публикуются отдельно, поскольку они предназначены для ответа на разные оценочные вопросы. Подтверждённые результаты организатор получил в ходе собственных проверок и опубликовал методику; это более весомое свидетельство, чем неподтверждённый слайд поставщика. Тем не менее выводы ограничены распределением задач и условиями тестирования.
Тем, кто сравнивает результаты, стоит изучить их в следующем порядке: версию бенчмарка, точную конфигурацию модели, уровень рассуждений, тестовую оболочку, охват задач, правила подсчёта баллов и единицу измерения стоимости. Так проще отличить реальное улучшение от сравнения разных экспериментов.
Результаты, близкие к верхнему пределу, также поднимают исследовательский вопрос о том, какой запас для дальнейшего улучшения остался у теста. Но это не отменяет существующих ограничений и не превращает выражение «бенчмарк общего искусственного интеллекта» в доказательство наличия такого интеллекта.
По данным ARC Prize, результат составил 97,5% при низком уровне рассуждений с тестовой оболочкой Provider Adapter. Результат Standard при низком уровне рассуждений составил 49,8%; он был получен в других условиях оценки, причём некоторые запуски остались незавершёнными.
Нет. В ARC-AGI-3 применяется система оценки на основе эффективности, которая предусматривает частичные баллы. Результат нельзя напрямую переводить в количество полностью завершённых игр.
Standard — это минимальный интерфейс, не привязанный к конкретному поставщику, который сохраняет выбранные моделью заметки. Provider Adapter может использовать специфичные для поставщика средства управления контекстом, в том числе сохранение состояния рассуждений и сжатие диалогов.
Объявленные запуски с низким уровнем рассуждений стоили около 4800 долларов с Provider Adapter и 5800 долларов с тестовой оболочкой Standard. ARC Prize сообщает, что оценки основаны на вводных ценах за токены; это стоимость всего оценочного запуска, а не отдельной задачи.
ARC Prize обозначает результаты как подтверждённые и публикует правила тестирования и отдельную страницу с результатами модели. Эта статья сверила опубликованные материалы, но не повторяла оценку и не воспроизводила результаты независимо.
Нет. Ни один отдельный бенчмарк не позволяет сделать такой вывод. Результат демонстрирует высокие показатели на ARC-AGI-3 при указанной конфигурации системы, однако для выводов о надёжности и обобщении результатов за пределами этих условий нужны дополнительные данные.
Подтверждённые результаты Gemini 4 Argon на ARC-AGI показывают высокие показатели в статических и интерактивных тестах. Заголовочный результат ARC-AGI-3 в 97,5% относится к конкретной конфигурации Provider Adapter с низким уровнем рассуждений; по опубликованным данным, оценочный запуск обошёлся примерно в 4800 долларов.
Для правильной интерпретации сравнения необходимо учитывать результат Standard, незавершённые запуски и различия в управлении контекстом. Рассматривайте модель, тестовую оболочку и условия оценки вместе: один процент сам по себе не доказывает наличие общего искусственного интеллекта.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



