For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
В ZCode незаметно появилось новое название модели Z.ai: **GLM-5.3 Highspeed**.
В ZCode незаметно появилось новое название модели Z.ai: GLM-5.3 Highspeed.
Модель появилась в ZCode 3.15.1, где некоторые подписчики случайным образом отбираются для пробного доступа HighSpeed. Один пользователь, @leo114119, опубликовал запуск с выходной скоростью, близкой к 490 токенам в секунду, а на другом скриншоте указано примерно 493 ток/с.
Это впечатляющий показатель.
Если модель способна поддерживать 490 выходных токенов в секунду, генерация 10 000 выходных токенов заняла бы всего около:
10 000 / 490 ≈ 20,4 секунды
Этот расчёт охватывает только фазу генерации токенов. В него не входят время до первого токена, рассуждение до появления видимого ответа, вызовы инструментов, сетевые накладные расходы или паузы в рабочем процессе агента.
Что ещё важнее, результат в 490 TPS пока является наблюдением сообщества, а не официальной гарантией пропускной способности от Z.ai.
Подтверждено, что ZCode 3.15.1 ввёл случайное пробное тестирование GLM HighSpeed для подписчиков и что идентификатор glm-5.3-highspeed уже присутствует в публичном каталоге моделей Pi.
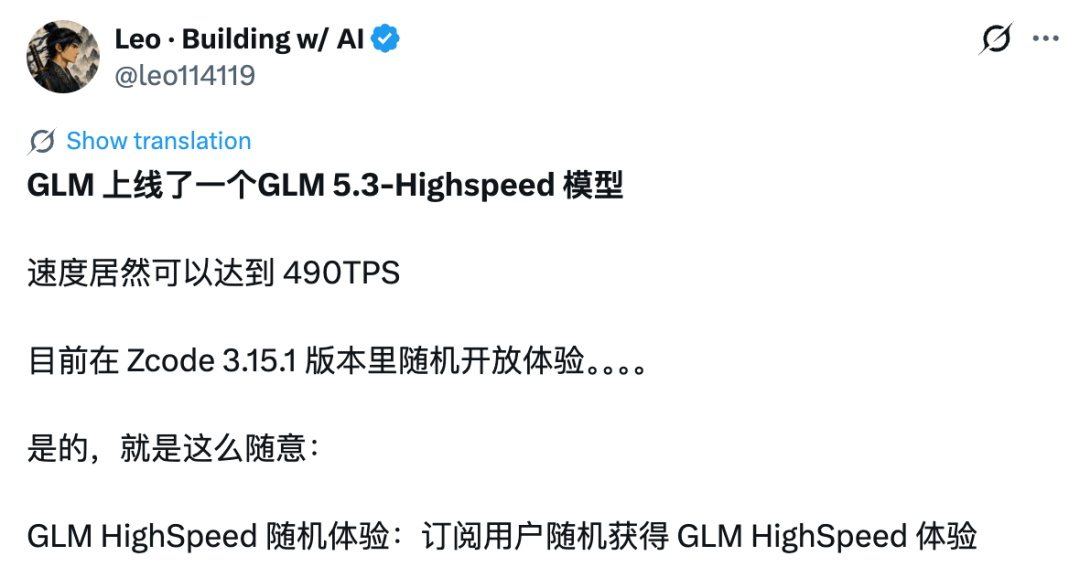
Первая подсказка — не просто скриншот из социальных сетей.
В официальных примечаниях к выпуску ZCode версии 3.15.1 сказано:
Теперь подписчики могут случайным образом выбираться для пробного тестирования GLM HighSpeed.
Эта формулировка важна, поскольку объясняет, почему доступ различается от аккаунта к аккаунту.
В исходной статье сообщается, что автор попытался вручную добавить GLM-5.3 Highspeed и переключиться на неё, но не смог воспользоваться моделью с подпиской Lite.
Интерфейс показывал, что модель существует, но текущий тариф не включает доступ.
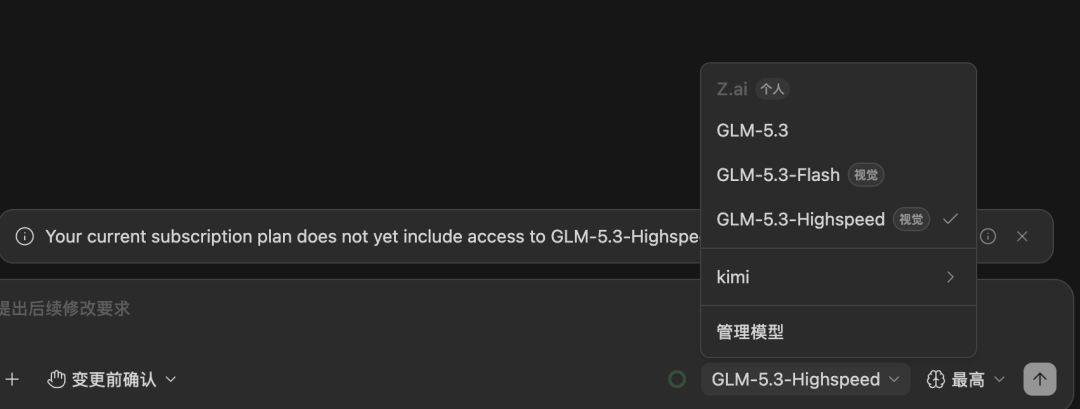
Это соответствует текущей стратегии развёртывания ZCode:
Обновление до ZCode 3.15.1
        ↓
Аккаунт подписчика
        ↓
Случайное право на пробный доступ HighSpeed
        ↓
Если аккаунт выбран, пробный доступ появляется в клиенте
Сейчас эта возможность не описывается как функция, автоматически доступная на каждом платном тарифе.
Скриншот из сообщества, суммирующий формулировку самого ZCode, указывает на то же самое: режим HighSpeed является случайно назначаемым преимуществом для подписчиков, а клиент служит источником истины о том, выбран ли конкретный аккаунт.
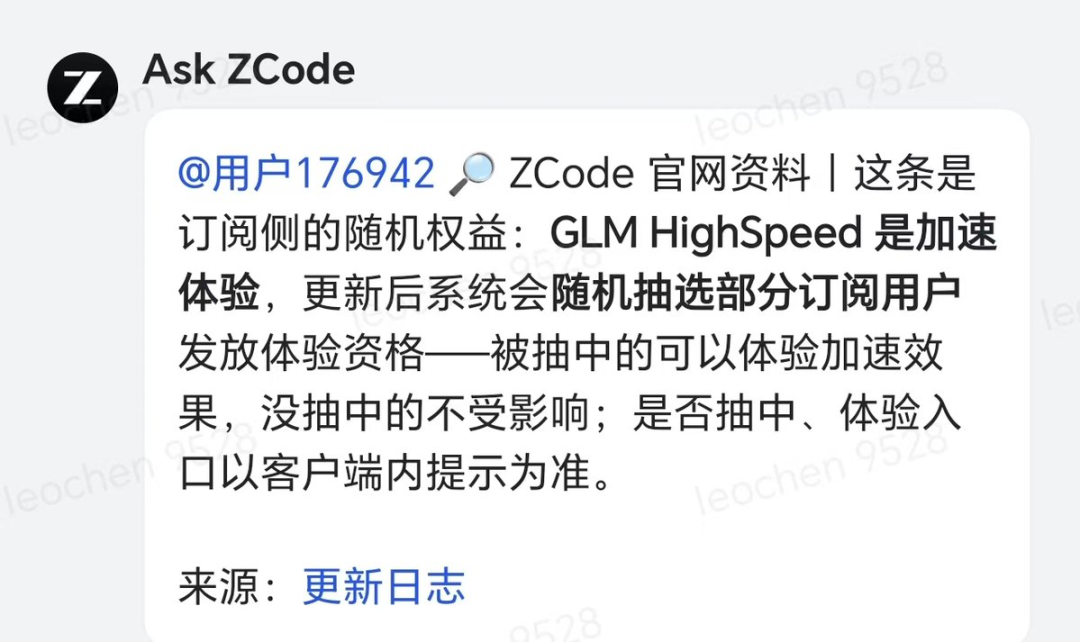
Основная причина, по которой модель привлекла внимание, — скриншот со скоростью.
Пользователь-источник опубликовал запуск со скоростью примерно 493 ток/с.
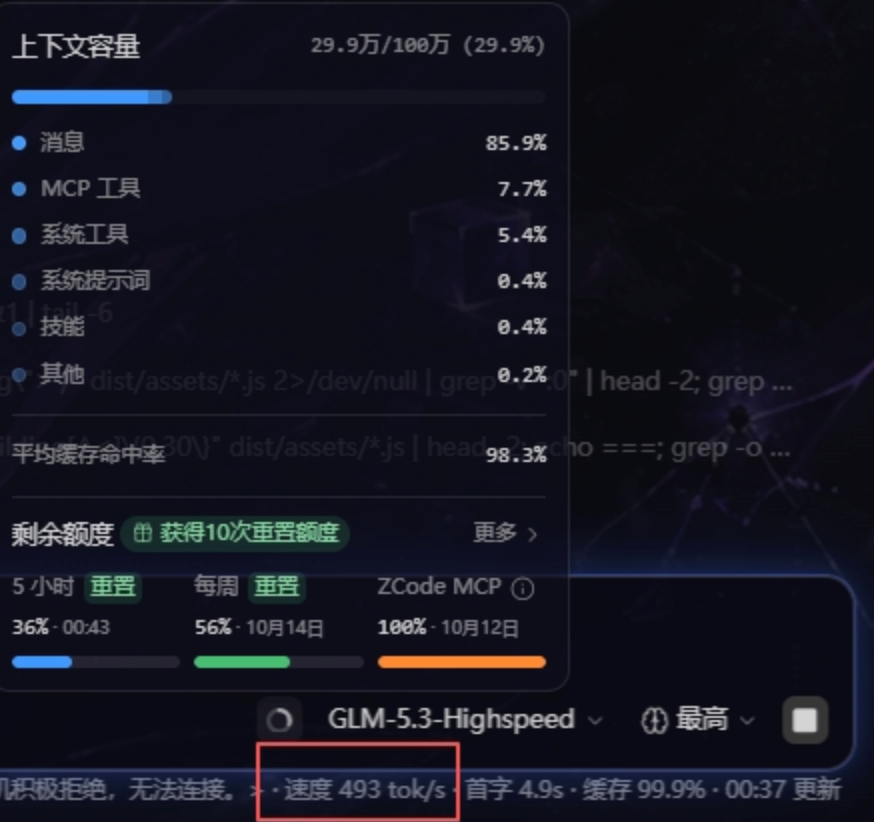
Этот показатель достаточно близок к цифре 490 TPS в заголовке статьи, поэтому разница несущественна.
Однако полезно точно определить, что этот скриншот показывает, а чего не показывает.
GLM-5.3-Highspeed.Пропускная способность может сильно зависеть от:
Поэтому корректный вывод на данный момент таков:
GLM-5.3 Highspeed продемонстрировала очень высокую пропускную способность вывода как минимум в одном публичном тесте ZCode, но Z.ai пока не публиковала официальную спецификацию в 490 TPS.
Этот показатель привлекает внимание, потому что семейство GLM уже включает несколько ориентированных на скорость вариантов обслуживания.
В документации Z.ai сказано, что GLM-5.3-FlashX может достигать до 200 токенов/с. FlashX — это высокоскоростной вариант обслуживания GLM-5.3-Flash.
В документации Pi и Z.ai для GLM-5.3-Flash указан контекст в 1 млн токенов и максимальный вывод класса 128 тыс. токенов, тогда как FlashX ориентирован на меньшую задержку обслуживания и более быструю генерацию.
В исходной статье также приводится измерение Artificial Analysis — примерно 60 токенов/с для GLM-5.3-Flash на собственном API Z.ai на момент написания.
Независимые измерения пропускной способности меняются со временем, а поздние снимки заметно различались в зависимости от провайдера и даты, поэтому единичную цифру не следует воспринимать как постоянную.
Поэтому полезно следующее сравнение:
| Модель / путь обслуживания | Заявленная или документированная скорость | Статус |
|---|---|---|
| GLM-5.3 Highspeed в ZCode | ~490–493 ток/с на скриншоте пользователя | Наблюдение сообщества / случайный пробный доступ |
| GLM-5.3-FlashX | До 200 ток/с | Публично документированный вариант, ориентированный на скорость |
| GLM-5.3-Flash в API Z.ai | Значительно ниже в независимых снимках первого API | Независимое измерение меняется в зависимости от даты и провайдера |
Разрыв достаточно велик, чтобы закономерно возник вопрос: что именно означает «Highspeed».
glm-5.3-highspeedНазвание модели появилось не только в ZCode.
В публичном каталоге моделей Pi уже есть страница для GLM-5.3 Highspeed.
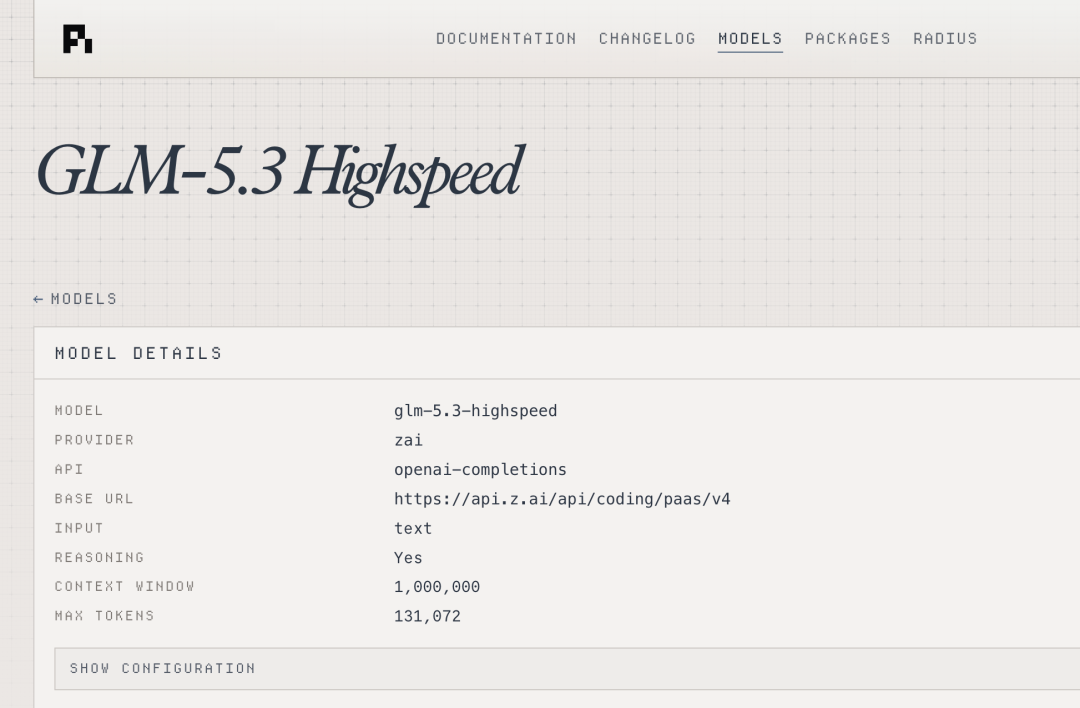
Указанная конфигурация:
| Поле | Значение |
|---|---|
| ID модели | glm-5.3-highspeed |
| Провайдер | zai |
| Стиль API | Совместимые с OpenAI completions |
| Вход | Текст |
| Рассуждения | Да |
| Контекстное окно | 1 000 000 токенов |
| Макс. вывод | 131 072 токена |
| Уровни рассуждений | низкий / высокий / максимальный |
Конечная точка, показанная Pi:
https://api.z.ai/api/coding/paas/v4
Pi также сопоставляет модель с форматом API для программирования Z.ai.
Особенно примечательны две детали.
Это соответствует конфигурации длинного контекста, встречающейся в текущих инструментах семейства GLM-5.3.
Для агентов программирования контекст в 1 млн токенов может быть полезен для:
Это приблизительно 128 тыс. токенов.
Опять же, это соответствует текущей конфигурации длинного вывода у нескольких записей семейства GLM-5.3.
Таким образом, запись Pi не указывает на очевидно иную архитектуру контекста по сравнению с обычной линейкой GLM-5.3.
Главным образом она подтверждает, что идентификатор Highspeed достаточно реален для наличия структурированной конфигурации провайдера.
Pi сопоставляет три активные настройки рассуждений:
низкий
высокий
максимальный
В исходной статье отмечается, что эти настройки также знакомы по стандартной конфигурации GLM-5.3.
Это даёт ещё одну причину не предполагать, что Highspeed — совершенно новая базовая модель.
Это может быть:
Без карточки модели Z.ai эти варианты пока нельзя уверенно разграничить.
Одного названия недостаточно.
Здесь история становится спекулятивной.
До появления скриншотов ZCode пользователи Reddit уже заметили glm-5.3-highspeed в каталоге Pi и задались вопросом, может ли он быть связан с Omen Alpha.
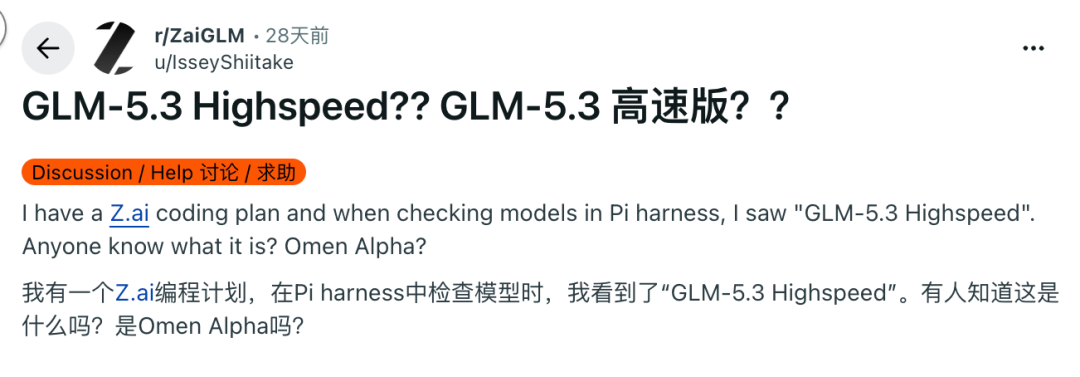
Omen Alpha — анонимная модель, появившаяся в тестировании OpenCode.
Участники сообщества уже связывали её с Zhipu/Z.ai на основе наблюдаемого поведения и признаков инфраструктуры.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
В одном ответе на Reddit предполагалось, что это может быть новый высокоскоростной вариант GLM с качеством, близким к GLM-5.3-Flash, но со значительно более высокой пропускной способностью.
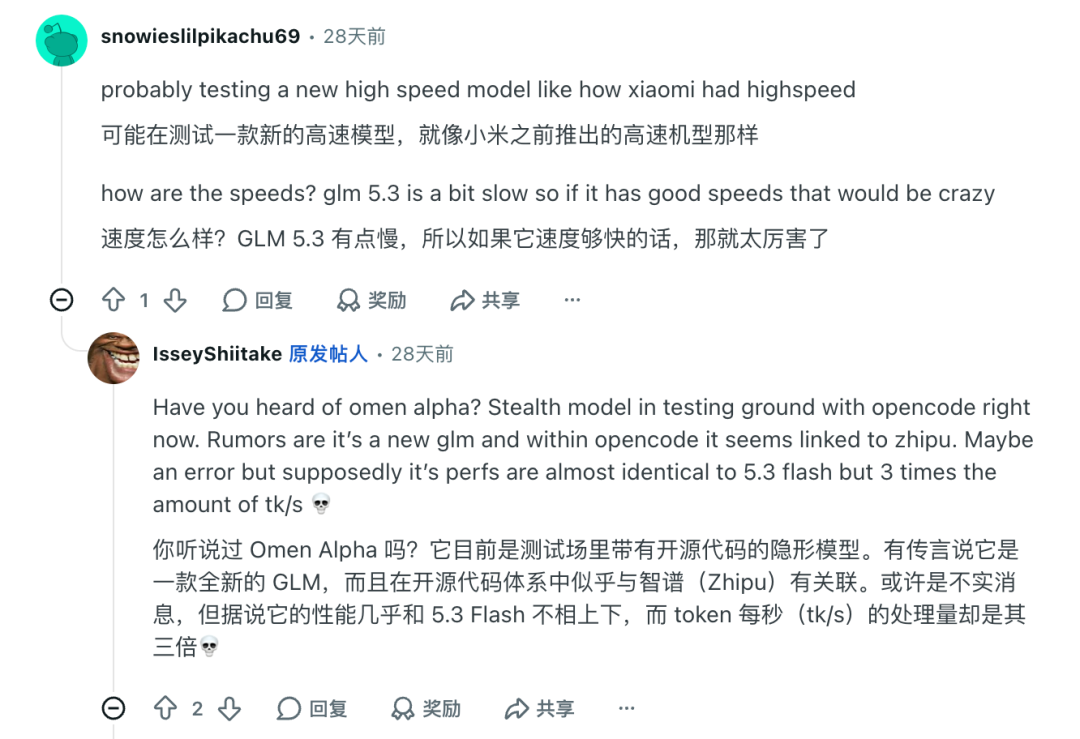
На другом скриншоте источника показана запись модели omen-alpha, связанная с меткой провайдера, относящейся к Zhipu, что усилило эту теорию.
Однако ничто из этого окончательно не устанавливает её идентичность.
В исходной статье перечислено несколько предположений:
Эти названия следует считать спекуляциями сообщества, пока Z.ai не опубликует официальное сопоставление.
Две конечные точки могут ощущаться очень похожими, даже если это не одна и та же модель.
На наблюдаемое поведение могут влиять:
Поэтому поведенческое сходство является свидетельством, но не доказательством.
Само название не является необычным для Zhipu.
Компания ранее выпускала высокоскоростные версии моделей GLM.
Исходная статья ссылается на GLM-5.1-highspeed, продвигавшуюся со скоростью вывода около 400 токенов/с в мае 2026 года.
В более свежем семействе GLM-5.3 также есть FlashX — публичный ориентированный на скорость вариант, документированный со скоростью до 200 токенов/с.
Это указывает на более широкую продуктовую схему:
Базовая или флагманская модель
        ↓
Высокоскоростной путь обслуживания
        ↓
Меньшая задержка / более высокая пропускная способность для интерактивных нагрузок
Эта схема делает продукт GLM-5.3 Highspeed технически правдоподобным, не требуя предполагать наличие новых весов модели.
Зачем вообще беспокоиться о 490 TPS?
Для короткого ответа на 200 токенов разница между 100 TPS и 500 TPS составляет всего несколько секунд.
Для длинных результатов агентов, генерации кода или подробных рассуждений разница становится намного больше.
Например:
| Длина вывода | 100 ток/с | 200 ток/с | 490 ток/с |
|---|---|---|---|
| 1 000 токенов | 10,0 с | 5,0 с | ~2,0 с |
| 5 000 токенов | 50,0 с | 25,0 с | ~10,2 с |
| 10 000 токенов | 100,0 с | 50,0 с | ~20,4 с |
Это только упрощённые расчёты времени декодирования.
Реальные задачи агентов также включают:
Тем не менее более быстрое декодирование может сделать длительные итеративные рабочие процессы значительно отзывчивее.
Это особенно актуально в агентах программирования, таких как ZCode, где один пользовательский запрос может приводить к нескольким вызовам модели, а не к одному финальному ответу.
На скриншоте с ~493 ток/с также указан чрезвычайно высокий коэффициент попаданий в кэш.
На это стоит обратить внимание.
Высокий коэффициент попаданий в кэш может уменьшить объём повторной обработки промпта, необходимой в длинных сессиях агента.
Типичная сессия программирования может многократно переносить:
системные инструкции
+ контекст репозитория
+ определения инструментов
+ предыдущий разговор
+ недавние изменения
Если значительная часть этого контекста эффективно используется повторно, системе требуется меньше времени на повторное вычисление входной части каждого шага.
Однако отображаемая цифра ток/с обычно относится к пропускной способности генерации вывода, а не только к пропускной способности кэша промпта.
Показатель кэша всё равно важен, поскольку общая задержка сессии может выглядеть намного лучше, когда одновременно эффективно работают повторное использование промпта и быстрое декодирование.
Это ещё одна причина, по которой один скриншот не может полностью характеризовать модель.
GLM-5.3-FlashX даёт наиболее ясное публичное сравнение, поскольку документация Z.ai уже описывает её как модель, ориентированную на скорость.
Текущая опубликованная информация о FlashX включает:
glm-5.3-flashx.Таким образом, FlashX демонстрирует, что Z.ai уже готова создавать выделенные высокопроизводительные варианты, не представляя их как совершенно новые поколения интеллектуальных моделей.
GLM-5.3 Highspeed может следовать той же продуктовой логике на ещё более быстром уровне обслуживания.
Это остаётся выводом, а не официальным описанием продукта.
Текущие сведения можно разделить на три уровня уверенности.
glm-5.3-highspeed как модель Z.ai.Это наиболее безопасный способ интерпретировать текущее развёртывание.
GLM-5.3 Highspeed — идентификатор модели Z.ai, появившийся в ZCode и публичном каталоге моделей Pi. ZCode 3.15.1 официально подтверждает случайное пробное тестирование GLM HighSpeed для подписчиков, но Z.ai пока не опубликовала полноценную отдельную карточку модели GLM-5.3 Highspeed в проверенных здесь источниках.
Публичный скриншот пользователя показывает примерно 493 ток/с в одном запуске ZCode, и именно он стал основой для заголовка о 490 TPS. Это полезное наблюдение, но не официальная гарантия устойчивой пропускной способности: показатель может меняться в зависимости от нагрузки, поведения кэша, региона и условий серверов.
Pi сейчас указывает для glm-5.3-highspeed контекстное окно в 1 000 000 токенов и максимальный вывод в 131 072 токена. Эти значения аналогичны конфигурации длинного контекста у других актуальных моделей семейства GLM-5.3.
Нет. В официальном журнале изменений ZCode v3.15.1 говорится, что подписчики случайным образом выбираются для пробного доступа GLM HighSpeed. Если ваш аккаунт не выбран, видимое название модели не обязательно означает, что вы можете её запустить.
Официального подтверждения, что это один и тот же продукт, нет. FlashX — публичный высокоскоростной вариант GLM-5.3-Flash, документированный со скоростью до 200 ток/с, тогда как GLM-5.3 Highspeed сейчас появляется через пробные версии ZCode и каталог провайдеров для программирования Pi.
Это остаётся спекуляцией. Пользователи Reddit и OpenCode связывали Omen Alpha с Zhipu/Z.ai, но официальный источник, подтверждающий, что Omen Alpha соответствует glm-5.3-highspeed, отсутствует.
Агенты программирования часто выполняют несколько длинных вызовов модели при чтении файлов, написании патчей, запуске инструментов и проверке результатов. Более высокая пропускная способность декодирования может сократить время ожидания между этими шагами, особенно когда модель создаёт тысячи токенов за один вызов.
Используйте актуальный клиент ZCode после обновления до версии, включающей пробный режим. В примечаниях к выпуску ZCode указано, что доступ случайным образом назначается подписчикам, поэтому интерфейс аккаунта и клиента — практический источник истины для проверки права на участие.
glm-5.3-highspeed.GLM-5.3 Highspeed больше не является просто случайным названием модели: ZCode 3.15.1 официально подтверждает рандомизированный пробный доступ GLM HighSpeed для подписчиков, а Pi уже раскрывает структурированную конфигурацию glm-5.3-highspeed с контекстным окном в 1 млн токенов и лимитом вывода в 131 072 токена.
Привлекающая внимание цифра 490–493 ток/с получена с реального публичного скриншота, но остаётся наблюдением пользователя, а не формальной гарантией пропускной способности Z.ai. Наиболее безопасная интерпретация заключается в том, что Z.ai тестирует очень быстрый путь обслуживания для программирования и пока не опубликовала полную спецификацию продукта.
Связь с Omen Alpha по-прежнему не установлена. Она может оказаться реальной, но текущие свидетельства косвенные и основаны на данных сообщества, а не на официальной информации.
Сегодня подтверждены развёртывание и идентификатор модели; пока не подтверждены точная архитектура, публичная цена, устойчивая пропускная способность и то, является ли Omen Alpha той же моделью.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



