For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/google-android-bench-harbor-claude-fable-5.md.
Обновление Android Bench от Google — это не просто обновление рейтинга. Перейдя на фреймворк Harbor, бенчмарк теперь делает акцент на воспро...
Google обновил рейтинг кодирования Android Bench и перенес workflow бенчмарка на фреймворк Harbor. Это обновление важно, поскольку Android Bench — это не общий конкурс по программированию. Он создан для проверки того, насколько хорошо большие языковые модели справляются с реальными задачами разработки под Android, включая понимание кодовой базы, генерацию патчей, специфические для Android API, системы сборки и проверку тестов.
Новые результаты дают разработчикам интересный сигнал. Claude Fable 5 теперь занимает верхнюю строчку обновленного рейтинга, за ним следует GPT 5.5, в то время как собственные модели Google Gemini показывают более неоднозначные результаты по точности, задержке и стоимости. Для команд, использующих ИИ-агенты кодирования в проектах под Android, главный вывод — не просто "какая модель победила". Это то, как метод оценки, среда песочницы, стоимость и задержка вместе меняют способ оценки производительности модели.
9 июля Google объявил о крупном обновлении Android Bench — своего бенчмарка и рейтинга для ИИ-ассистированной разработки под Android. Самое важное изменение — принятие Harbor, стандартизированного фреймворка для выполнения задач агентов в изолированных средах.
Ранее Android Bench использовал конфигурацию оценки на основе mini-swe-agent v1, адаптированную для разработки под Android. В новой версии Google перешел на Harbor, чтобы сделать выполнение бенчмарка более стандартизированным, изолированным и воспроизводимым. Цель — упростить разработчикам и исследователям проведение независимых оценок, сравнение различных конфигураций агентов и обмен результатами более прозрачным способом.
Google также сделал инструментарий Android Bench открытым на GitHub. Это дает сообществу более четкое представление о том, как работает бенчмарк, и открывает возможности для обратной связи, пользовательских задач разработки под Android и более широкого участия в оценке моделей.
Фреймворк, лежащий в основе бенчмарка, может повлиять на результат. Особенно это верно для ИИ-агентов кодирования, где модели не просто отвечают на вопросы; они изучают репозитории, выполняют команды, редактируют файлы, вызывают инструменты и пытаются пройти тесты.
Harbor построен вокруг оценки задач агентов в изолированной среде. Для Android Bench это означает, что запуски моделей могут быть организованы в более контролируемой среде выполнения вместо использования ad hoc локальных конфигураций. Это помогает уменьшить неопределенность при сравнении моделей и упрощает воспроизведение конкретной оценки.
Методология Google Android Bench также подчеркивает проблемы, специфичные для разработки под Android, а не общие задачи программирования. Бенчмарк включает работу, связанную с такими областями, как Jetpack Compose, Coroutines и Flows, Room, Hilt, миграция навигации, конфигурация Gradle,
Изменения в SDK, медиа, камера, складные устройства, разрешения времени выполнения и другие общие вопросы разработки Android.
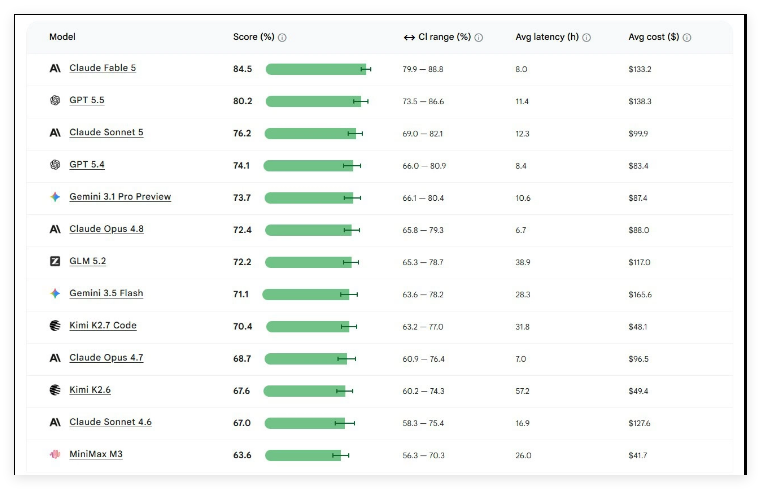
После изменения методологии Google повторно запустила тестирование и обновила таблицу лидеров Android Bench. Согласно обновлённым результатам, Claude Fable 5 занимает первое место с результатом 84,5%. GPT 5.5 следует с 80,2%, а Claude Sonnet 5 занимает третье место с 76,2%.
Упрощённый вид лучших результатов выглядит следующим образом:
| Место | Модель | Результат | Доверительный интервал | Средняя задержка | Средняя стоимость |
|---|---|---|---|---|---|
| 1 | Claude Fable 5 | 84,5% | 79,9–88,8 | 8,0 ч | 133,2 $ |
| 2 | GPT 5.5 | 80,2% | 73,5–86,6 | 11,4 ч | 138,3 $ |
| 3 | Claude Sonnet 5 | 76,2% | 69,0–82,1 | 12,3 ч | 99,9 $ |
| 4 | GPT 5.4 | 74,1% | 66,0–80,9 | 8,4 ч | 83,4 $ |
| 5 | Gemini 3.1 Pro Preview | 73,7% | 66,1–80,4 | 10,6 ч | 87,4 $ |
| 6 | Claude Opus 4.8 | 72,4% | 65,8–79,3 | 6,7 ч | 88,0 $ |
| 7 | GLM 5.2 | 72,2% | 65,3–78,7 | 38,9 ч | 117,0 $ |
| 8 | Gemini 3.5 Flash | 71,1% | 63,6–78,2 | 28,3 ч | 165,6 $ |
Эти цифры следует воспринимать как результаты, характерные для данного теста. Они не доказывают, что одна модель универсально лучше во всех задачах кодирования. Они показывают, как каждая модель проявила себя в обновлённой среде оценки Google, ориентированной на Android.
Обновлённый рейтинг примечателен тем, что собственные модели Google не возглавляют таблицу. Gemini 3.1 Pro Preview занимает пятое место с результатом 73,7%. Её заявленная средняя стоимость ниже, чем у нескольких лучших моделей, но точность уступает Claude Fable 5, GPT 5.5, Claude Sonnet 5 и GPT 5.4.
Gemini 3.5 Flash представляет ещё больший интерес. Она позиционируется как более лёгкая модель, но в этом тесте она демонстрирует высокую среднюю задержку в 28,3 часа и среднюю стоимость 165,6 $ за полный прогон теста. Это делает её менее привлекательной в данной конкретной оценке, несмотря на общее ожидание, что более лёгкие модели должны быть быстрее и дешевле.
Главный урок прост: выбор модели для агентов кодирования не может основываться только на бренде, семействе моделей или цене за токен. Модель, которая выглядит экономически эффективной в обычном чате, может вести себя совершенно иначе, когда её просят решить 100 реальных задач разработки Android, включающих вызовы инструментов, редактирование репозитория и выполнение тестов.
Android Bench предназначен для оценки того, может ли LLM действовать как практичный разработчик Android. Он предоставляет модели описания реальных проблем и просит сгенерировать изменения кода, которые решают проблему. Затем полученный патч проверяется с помощью настроенной валидации.
Методология Google гласит, что тест включает 100 задач, отобранных из гораздо большего пула запросов на слияние. Отбор фокусируется на Android-репозиториях и реальных рабочих процессах разработки, включая случаи, связанные с Kotlin, Java, Jetpack Compose, традиционными Views, приложениями, библиотеками, небольшими целевыми изменениями и более крупными модификациями кода.
Это отличает Android Bench от простых тестов завершения кода. Он ближе к агентной оценке программной инженерии, где модели необходимо понять репозиторий, внести соответствующие изменения и пройти автоматическую проверку.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
AI-кодирование
рабочие процессы переходят от простых фрагментов кода на основе промптов к автономным или полуавтономным агентам. В реальном Android-проекте агент должен ориентироваться в структуре проекта, понимать ограничения сборки, безопасно редактировать несколько файлов, обрабатывать изменения API и запускать тесты, не нарушая существующего поведения.
Такой бенчмарк, как Android Bench, помогает разработчикам оценивать модели в рамках подобных рабочих процессов. Он также делает видимыми затраты и задержки. Для промышленного использования лучшая модель — не всегда та, что набрала наивысший балл. Команда может предпочесть модель с несколько более низким баллом, если она намного быстрее, дешевле или стабильнее в своей собственной среде разработки.
Обновление также подчеркивает более широкий момент: методология бенчмаркинга должна развиваться по мере развития ИИ-агентов. Вызов инструментов, изоляция, трассировка выполнения, воспроизводимость и отслеживание затрат теперь являются частью оценки, а не дополнительными опциями.
Android Bench — это бенчмарк Google для оценки больших языковых моделей на задачах разработки под Android. Он фокусируется на реальных инженерных проблемах Android, а не на общих вопросах по кодингу или изолированных алгоритмических задачах.
Google перенес Android Bench на фреймворк Harbor для стандартизации выполнения бенчмарков в изолированных средах. Это облегчает воспроизведение, сравнение и обмен результатами оценки между различными конфигурациями моделей и агентов.
В обновленном рейтинге, описанном в исходной статье и на странице Google Android Bench, первое место занимает Claude Fable 5 с результатом 84,5%. GPT 5.5 следует за ним с 80,2%, а Claude Sonnet 5 занимает третье место.
Не обязательно. Android Bench измеряет производительность кодинга под Android в рамках определенной конфигурации бенчмарка. Модель, показывающая здесь наилучшие результаты, может не быть лучшим выбором для веб-разработки, инженерии данных, DevOps или других программных задач.
Задержка показывает, сколько времени требуется модели для выполнения задач бенчмарка. Для реальных инженерных команд высокий балл полезен только в том случае, если модель может завершить работу в приемлемые сроки.
Стоимость важна, потому что агентный кодинг может включать множество вызовов инструментов, длинные контекстные окна, просмотр репозитория и многократные запуски тестов. Модель с высокой точностью, но очень высокой стоимостью может быть менее практична для частого промышленного использования.
Репозиторий Android Bench на GitHub содержит инструменты и инструкции по настройке для оценки моделей. Официальная документация также предоставляет разработчикам доступ к набору данных и методологии, чтобы они могли лучше понять или воспроизвести бенчмарк.
Задачи агентов.
Обновление Android Bench от Google — это не просто обновление таблицы лидеров. Переход на фреймворк Harbor позволяет бенчмарку больше сосредоточиться на воспроизводимой, изолированной и специфичной для Android оценке агентов.
Новый рейтинг ставит Claude Fable 5 на первое место, за ним следуют GPT 5.5 и Claude Sonnet 5. Gemini сохраняет конкурентоспособность, но не лидирует в обновленном рейтинге, а Gemini 3.5 Flash показывает, что более легкие модели не обязательно быстрее или дешевле в задачах оценки кодинга с агентами.
Для разработчиков и AI-команд полезный вывод — сравнивать вместе точность, задержку, стоимость и методологию бенчмарка. Android Bench лучше всего воспринимать как практический сигнал для агентов кодинга под Android, а не как универсальный рейтинг всех AI-моделей.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



