For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/gpt-5-6-sol-vision-benchmark.md.
GPT-5.6 Sol может оказаться одним из самых значительных недавних скачков OpenAI в практическом визуальном понимании. Roboflow протестировала...
GPT-5.6 Sol может оказаться одним из самых значительных недавних скачков OpenAI в области практического визуального понимания.
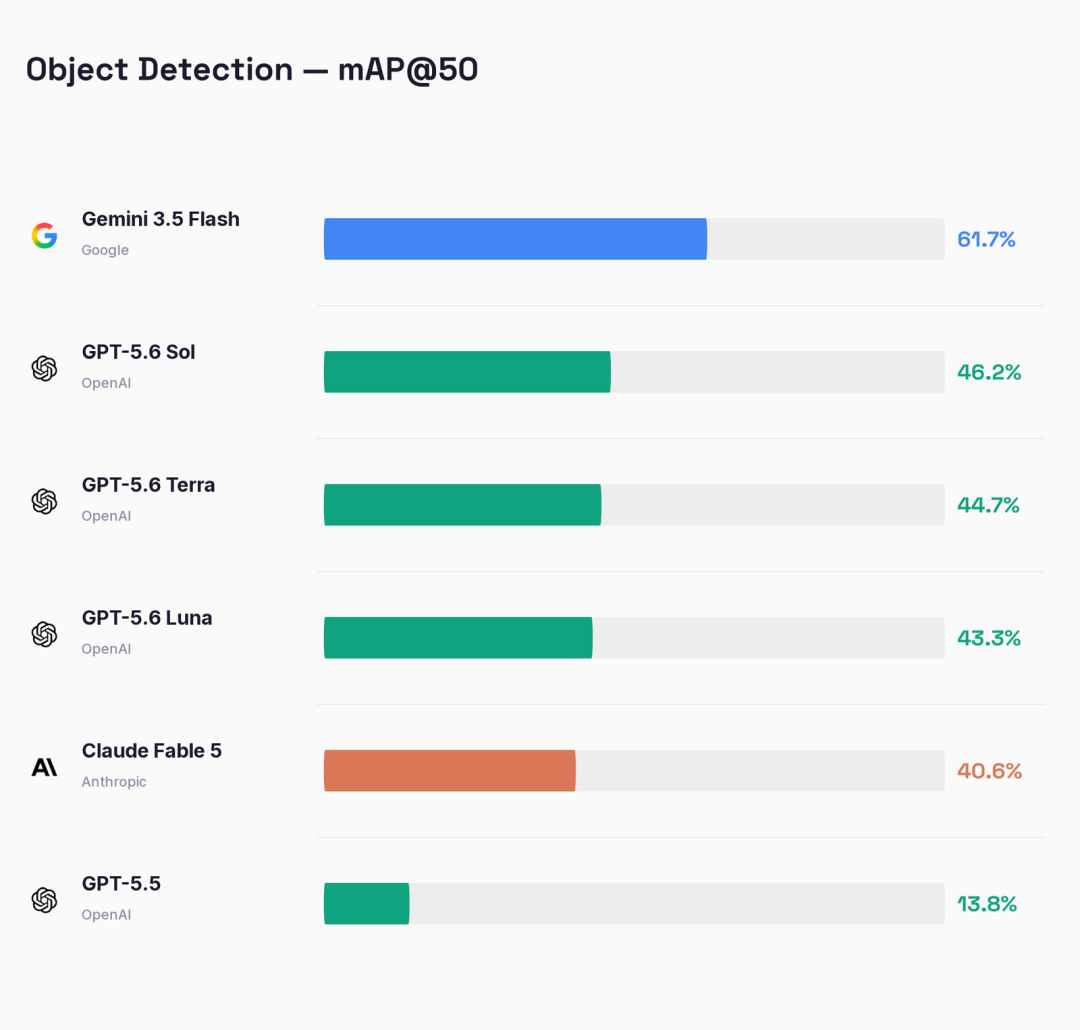
Roboflow протестировала семейство GPT-5.6 — Sol, Terra и Luna — на бенчмарке для визуально-языковых моделей, охватывающем обнаружение объектов, подсчёт объектов, OCR и целевое извлечение данных. Наиболее впечатляющий результат был получен в обнаружении объектов: GPT-5.5 набрал лишь 13,8 mAP@50, тогда как GPT-5.6 Sol достиг 46,2, более чем утроив предыдущий результат в бенчмарке Roboflow на момент запуска.
Terra и Luna также значительно улучшились, достигнув 44,7 и 43,3 соответственно.
Пётр Скальски из Roboflow назвал Sol самой сильной моделью компьютерного зрения, выпущенной OpenAI на тот момент. Этот вывод относится именно к оценке Roboflow и не должен восприниматься как универсальный рейтинг для всех задач компьютерного зрения, однако улучшение по сравнению с GPT-5.5 является существенным.
Однако улучшения не являются равномерными. Sol значительно лучше справляется с локализацией объектов, их подсчётом, пониманием пространственных ограничений и обнаружением областей документов, но при этом не превосходит GPT-5.5 во всех задачах типа OCR. Также наблюдается специфический сбой на очень больших изображениях, где ограничивающие рамки могут становиться нестабильными.
В результате мы получаем более полную картину, чем простой заголовок «лучшая модель зрения»: GPT-5.6 значительно более способен к визуальной работе, но выбор модели по-прежнему зависит от точности, задержки, стоимости, размера изображения и конкретной задачи.
Обнаружение объектов исторически было слабым местом универсальных GPT-моделей.
Задача звучит просто: определить каждый relevant-объект на изображении и вернуть ограничивающую рамку вокруг него. На практике визуально-языковая модель должна правильно понять целевую категорию, локализовать каждый экземпляр, сгенерировать координаты в требуемом формате и избежать дубликатов или смещённых рамок.
В бенчмарке Roboflow GPT-5.5 справлялся с этим крайне плохо.
GPT-5.6 меняет картину.
| Модель | Обнаружение объектов mAP@50 |
|---|---|
| Gemini 3.5 Flash | 61,7 |
| GPT-5.6 Sol | 46,2 |
| GPT-5.6 Terra | 44,7 |
| GPT-5.6 Luna | 43,3 |
| Claude Fable 5 | 40,6 |
| GPT-5.5 | 13,8 |
Эти значения взяты из снимка бенчмарка Roboflow, обсуждаемого в оригинальной статье и анализе Roboflow за июль 2026 года. Живой бенчмарк Roboflow может меняться по мере развития наборов данных, тестовых сред, версий моделей и методологии лидерборда.
Один из наиболее полезных примеров — анализ структуры документов.
Sol смогла определять такие области, как:
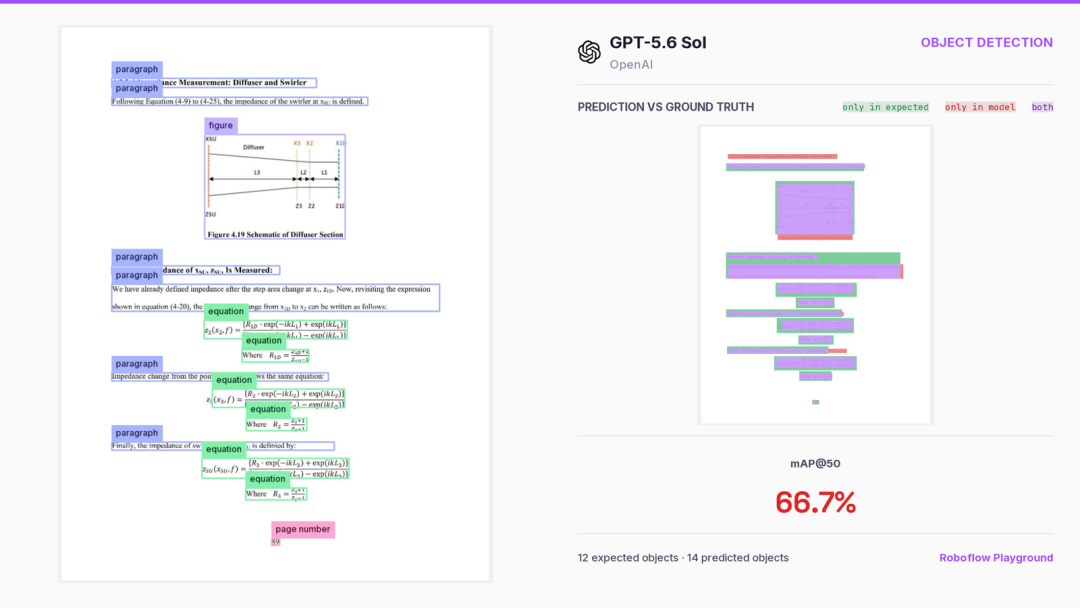
Это важно для конвейеров обработки документов, поскольку OCR часто не является первым шагом.
Типичная система сначала должна ответить:
Где находится релевантное содержимое на этой странице?
Только после этого имеет смысл транскрибировать текст, извлекать дату, читать таблицу или направлять одну область в специализированный парсер.
Для контрактов, счетов, форм, отчётов и отсканированных PDF-файлов лучшее обнаружение областей может улучшить весь последующий рабочий процесс.
Roboflow обнаружила, что GPT-5.6 показывает наилучшие результаты, когда в запросах на обнаружение объектов запрашиваются абсолютные пиксельные координаты XYXY.
Эту деталь легко упустить из виду.
По данным Roboflow, использование неправильного представления координат снизило производительность обнаружения GPT-5.6 примерно на 15 пунктов mAP в их тестировании. Gemini 3.5 Flash ведёт себя иначе и показывает наилучшие результаты с нормализованными координатами YXYX по шкале 0–1000.
Это означает, что качество бенчмарка — и реальное производственное качество — может сильно зависеть от запрашиваемого формата вывода.
Поэтому практическая инструкция по обнаружению для GPT-5.6 должна явно указывать соглашение о координатах, а не расплывчато запрашивать «ограничивающие рамки».
Плотные изображения сложны для обнаружения объектов на основе VLM, поскольку модель обычно выдаёт метки объектов и координаты в виде текста.
Чем больше объектов, тем длиннее становится этот вывод. Это создаёт больше возможностей для:
Roboflow протестировала сцены, содержащие множество визуально схожих объектов, расположенных вплотную друг к другу, включая таблетки и яйца.
Sol справился с этими случаями гораздо лучше, чем предыдущие модели OpenAI.
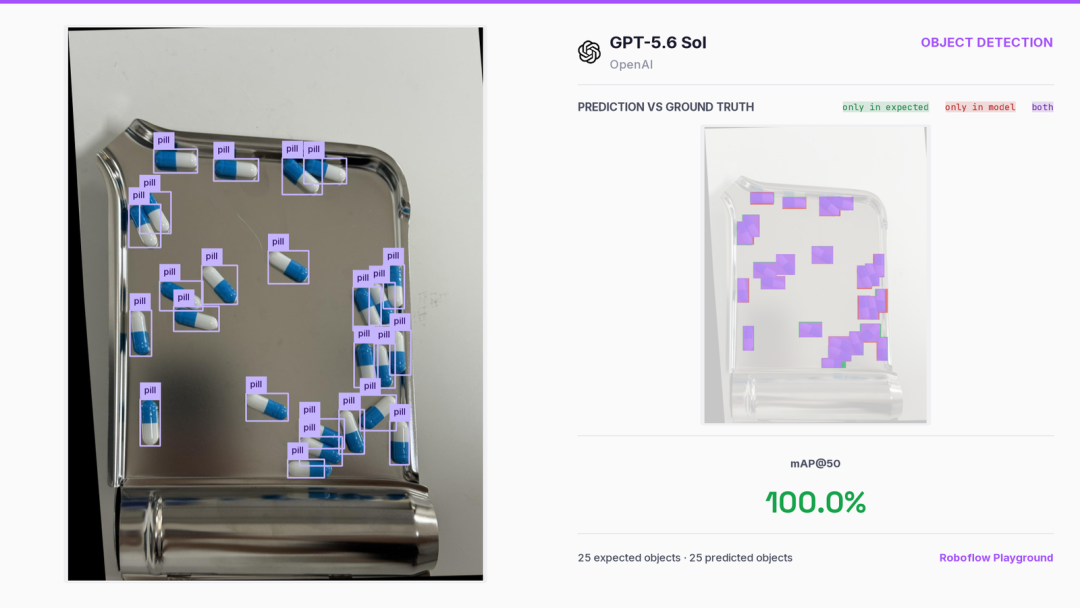
Результат позволяет предположить, что GPT-5.6 выходит за рамки простого распознавания общего содержимого изображения и движется к более структурированной работе по локализации.
Это не делает его заменой для каждого специализированного детектора. Специализированные модели обнаружения объектов всё ещё могут быть быстрее, дешевле, проще в настройке или надёжнее в ограниченных производственных средах. Но разрыв между универсальной мультимодальной моделью и специализированным зрительным конвейером явно сокращается.
Подсчёт улучшился у Sol, Terra и Luna.
Roboflow сообщила:
| Модель | Точность подсчёта |
|---|---|
| GPT-5.6 Sol | 73,0% |
| GPT-5.6 Terra | 67,6% |
| GPT-5.6 Luna | 66,2% |
| GPT-5.5 | 64,9% |
Улучшение особенно заметно.
для Sol, но даже Luna — самая дешёвая модель в семействе GPT-5.6 — превзошла GPT-5.5 в этом бенчмарке.
Некоторые примеры Roboflow требовали большего, чем просто возврат общего количества видимых объектов.
В одном тесте Sol нужно было подсчитать только пулевые отверстия в заданных зонах scoring на мишени. Это требовало двух уровней визуального рассуждения:
Модель успешно справилась с примером, выделенным Roboflow.
Это ближе к реальной визуальной автоматизации, чем простой вопрос: «Сколько объектов на этом изображении?»
Приложения часто содержат условные правила, такие как:
Универсальная мультимодальная модель, которая может сочетать обнаружение объектов с правилами на естественном языке, может быть полезна в рабочих процессах, где визуальная логика часто меняется.
Бенчмарк также включает примеры, которые остаются сложными.
Блистерные упаковки вызывали трудности, потому что заполненные и пустые ячейки могут выглядеть очень похоже при отражениях. Повторяющиеся макеты могут дополнительно запутывать модель.
Roboflow также показала пример с аномальными конфетами, где Sol вернула неверное количество. Было неясно, ошиблась ли модель в подсчёте или неправильно поняла, какие элементы относятся к запрошенной категории.
Это различие важно в производственных системах.
Неверное количество может быть следствием нескольких разных причин:
Ошибка обнаружения
Неправильное понимание категории
Неправильное понимание пространственного правила
Дублирующееся обнаружение
Пропущенный объект
Ошибка координат
Одно лишь итоговое число не говорит о том, на каком этапе произошла ошибка.
Самая неожиданная часть бенчмарка — OCR.
Показатель полного транскрибирования текста у Sol составил 90,7%, что немного ниже, чем у GPT-5.5 — 91,2%.
Разница невелика, но это означает, что новый флагман не улучшил результаты по всем визуальным категориям.
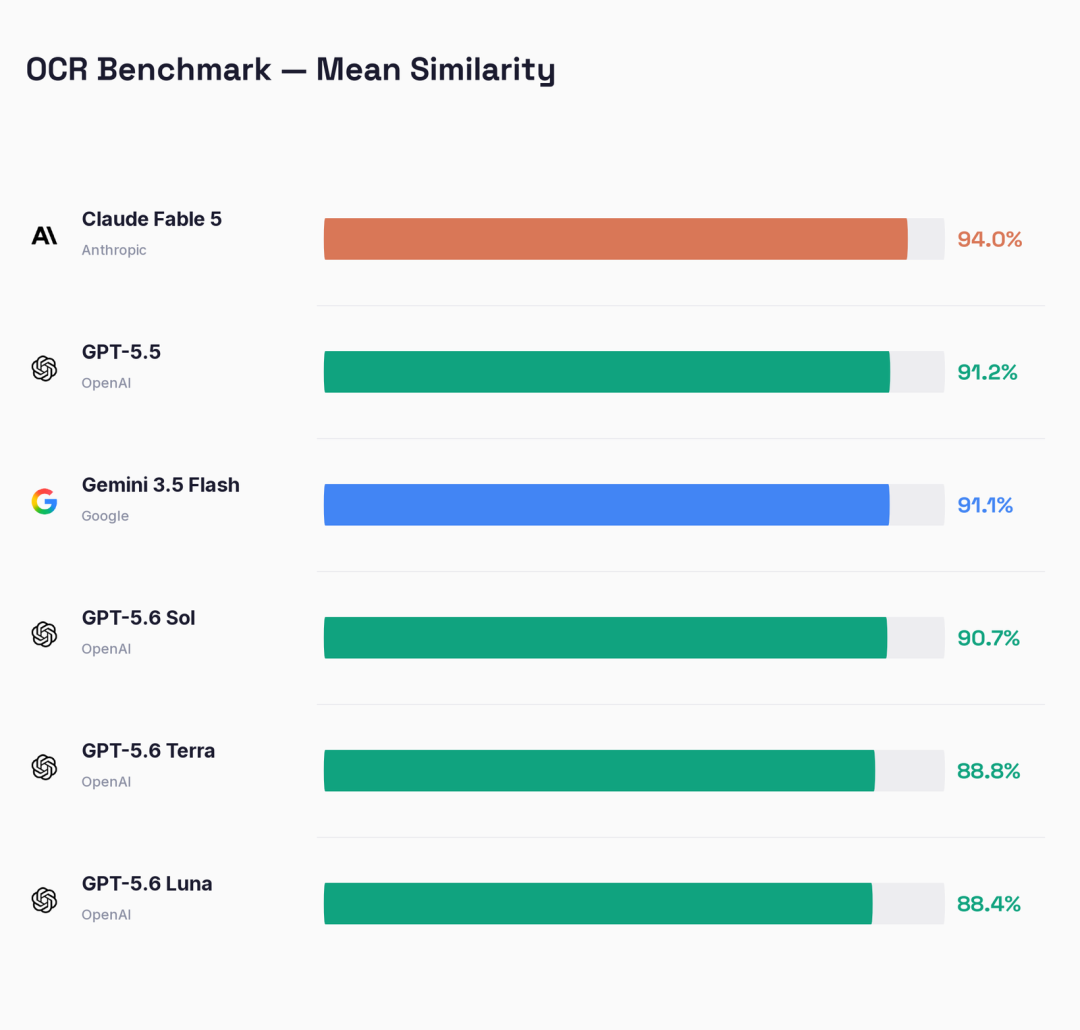
Roboflow разделила две связанные задачи:
Вторая категория показала более значительный спад.
| Модель | OCR | Точечное извлечение текста |
|---|---|---|
| GPT-5.5 | 91,2% | 87,6% |
| GPT-5.6 Sol | 90,7% | 82,5% |
| GPT-5.6 Terra | 88,8% | 79,4% |
| GPT-5.6 Luna | 88,4% | 81,4% |
Показатель извлечения у Sol снизился более чем на пять пунктов по сравнению с GPT-5.5 в этом срезе бенчмарка.
Тем не менее модель успешно справилась с несколькими сложными примерами.
Roboflow показала, как Sol транскрибирует рукописный
заметки с высокой степенью схожести символов.
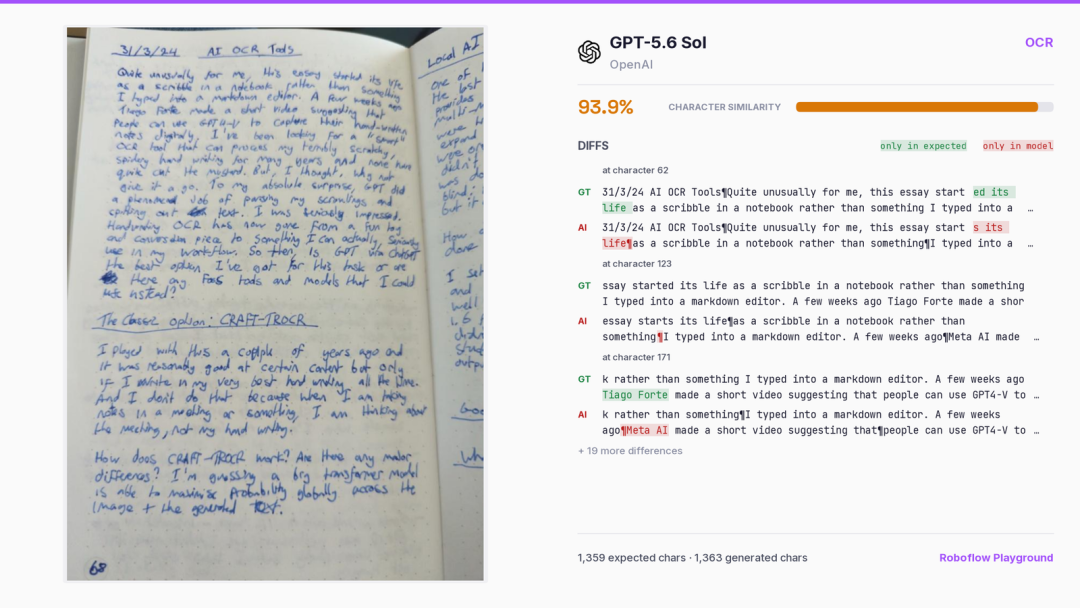
Она также успешно считывала текст из визуально сложных сцен, включая строку размером с шину, напечатанную на грязной изогнутой поверхности, и живой счёт, показанный в хоккейной трансляции.
Эти примеры демонстрируют, что ограничение OCR модели — это не просто «невозможность работы с мелким текстом».
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Её производительность зависит от контраста, ориентации, бликов, размера шрифта, окружающего визуального шума и точной инструкции по извлечению.
Одним из самых явных сбоев был срок годности, напечатанный на блистерной упаковке.
Текст был мелким, вертикально ориентированным, с низким контрастом и искажался отражающей упаковкой.
Sol не смогла корректно извлечь запрошенную дату.
Это полезное напоминание для документооборота и промышленных процессов: впечатляющие примеры с рукописным текстом или графикой в трансляциях не гарантируют надёжность при работе с упаковкой, тиснёным текстом, отражающими материалами или крошечными низкоконтрастными этикетками.
Для ответственных задач извлечения данных вывод модели по-прежнему следует проверять с помощью специализированного OCR-движка, детерминированного парсера, штрихкод-системы или процесса ручной проверки, где это уместно.
Roboflow обнаружила ещё один важный сбой при обнаружении объектов.
На некоторых изображениях Sol возвращала ограничивающие рамки в частях изображения, которые имели мало или вообще не имели пересечения с реальными объектами. Некорректные рамки иногда появлялись в неестественно регулярных узорах, таких как ряды или равномерно расположенные группы.
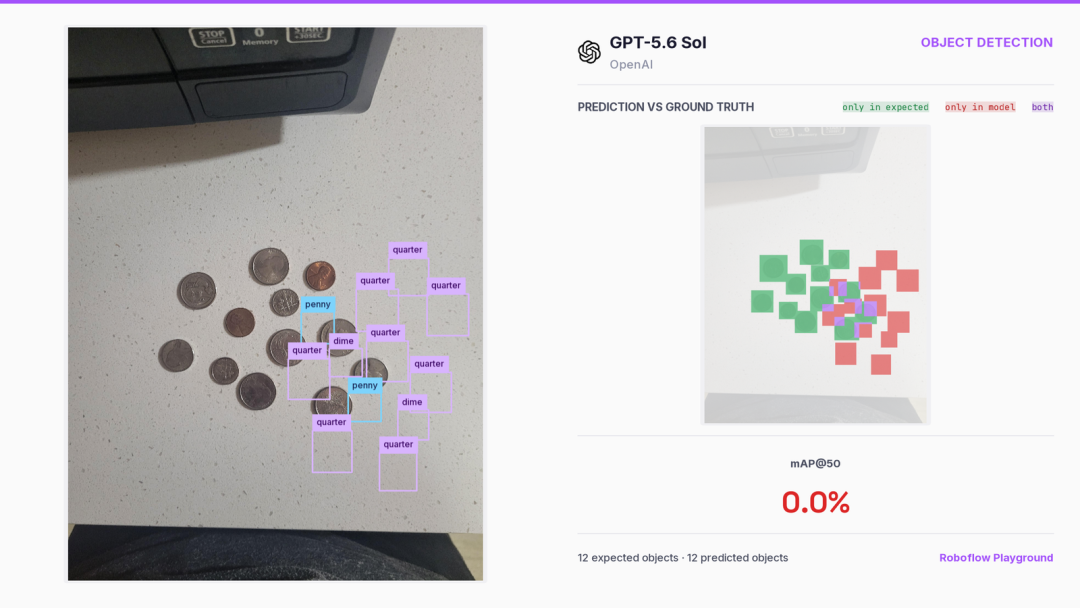
Roboflow сообщает, что поделилась этими примерами с OpenAI, и ей ответили, что Sol становится менее стабильной на изображениях примерно от 2000 × 2000 пикселей и крупнее, особенно при низком усилии рассуждения.
Это разъяснение приходит через отчёт Roboflow, а не через отдельную страницу документации OpenAI, поэтому это лучше всего описать как ограничение, которое, по словам Roboflow, подтвердила OpenAI.
Более высокое усилие рассуждения улучшило стабильность в тестах Roboflow.
Компромисс очевиден:
Более высокое усилие рассуждения
→ больше токенов
→ выше задержка
→ выше стоимость
Это может иметь смысл для анализа изображений с низким объёмом и высокой ценностью, где один сбойный результат обнаружения обходится дорого.
Это менее привлекательно для очень больших партий.
Более практичная рекомендация Roboflow — изменить размер или кадрировать большие изображения перед отправкой в API.
Это может помочь двумя способами:
Для обработки документов разбиение или кадрирование большого скана на значимые области также может сделать
задача становится проще для оценки и повторных попыток.
Визуальные улучшения сопряжены с практическими издержками.
В июльском бенчмарке Roboflow расчётная стоимость изображения и задержка выглядели примерно так:
| Модель | Прибл. стоимость за изображение | Прибл. задержка |
|---|---|---|
| GPT-5.6 Sol | $0,025 | ~10 с |
| GPT-5.6 Terra | $0,01 | ~6 с |
| GPT-5.6 Luna | < $0,005 | ~5 с |
| Gemini 3.5 Flash | $0,008 | Быстрее, чем Sol в указанном сравнении |
Это оценки для конкретного бенчмарка, а не фиксированные цены API за изображение. Стоимость изображения зависит от его размеров, длины запроса, выходных токенов, усилий рассуждения, настроек провайдера и текущих тарифов на токены.
Текущие цены API OpenAI также существенно различаются в рамках семейства GPT-5.6. Sol — флагманский уровень, Terra — сбалансированный, а Luna оптимизирована для высокообъёмных нагрузок, чувствительных к стоимости.
Это делает Luna особенно интересной, когда рабочему процессу требуются улучшенные визуальные возможности поколения GPT-5.6, но нет возможности использовать Sol для каждого изображения.
Вывод исходной статьи не в том, что GPT-5.6 теперь доминирует во всех визуальных бенчмарках.
В июльском сравнении Roboflow Gemini 3.5 Flash остался впереди GPT-5.6 Sol в обнаружении объектов и подсчёте, при этом значительно дешевле за изображение.
Это делает Gemini 3.5 Flash привлекательным для высокочастотных задач, таких как:
Официальная документация Google по Gemini описывает Gemini 3.5 Flash как мультимодальную модель, поддерживающую ввод изображений, видео, аудио, текста и PDF с контекстным окном на 1 млн токенов. Его API-цены также рассчитаны на высокопроизводительное производственное использование.
Поэтому практический выбор зависит от конкретной рабочей нагрузки.
GPT-5.6 Sol может подойти лучше, когда:
Terra или Luna могут быть лучше, когда:
Многоуровневый конвейер часто может быть более экономичным, чем отправка каждого изображения напрямую во флагманскую модель.
Самое важное изменение в GPT-5.6 — не то, что он внезапно стал идеальным OCR-движком или специализированным детектором.
А то, что визуальные возможности становятся пригодными для использования в более широких агентных рабочих процессах.
Sol всё больше может сочетать:
Сам запуск GPT-5.6 от OpenAI подчёркивает более сильное использование компьютера, мультимодальные рассуждения и агентные рабочие процессы. Бенчмарк Roboflow помогает показать
как эти улучшения выглядят на низкоуровневом визуальном слое.
Для разработчиков это различие имеет значение.
Традиционная система компьютерного зрения может требовать отдельных моделей для обнаружения объектов, OCR, разбора документов и последующих рассуждений. Фронтовая VLM может выполнять несколько таких операций через один интерфейс, хотя специализированные модели всё ещё могут превосходить её по точности, стоимости, скорости или предсказуемости.
Поэтому следующий этап конкуренции VLM меньше связан с тем, может ли модель описать изображение, и больше с тем, может ли она достаточно надёжно выполнять структурированные визуальные задачи, чтобы быть полезной в производстве.
Результаты Roboflow указывают на несколько практических правил для разработчиков, тестирующих GPT-5.6 на визуальных нагрузках.
Roboflow описал GPT-5.6 Sol как самую сильную модель зрения OpenAI, которую он тестировал на тот момент. OpenAI также позиционирует Sol как флагманскую модель GPT-5.6 и официально поддерживает ввод изображений, но «лучшая» всё равно зависит от визуальной задачи и бенчмарка.
В бенчмарке Roboflow за июль 2026 года GPT-5.5 набрал 13,8 mAP@50, а GPT-5.6 Sol достиг 46,2. Это более чем трёхкратное увеличение заявленного показателя.
Он способен, но бенчмарк не показывает универсального улучшения. Sol набрал 90,7% в тесте OCR Roboflow против 91,2% у GPT-5.5, а его показатель целевого извлечения текста также был ниже, чем у GPT-5.5 в этой оценке.
Roboflow рекомендует запрашивать абсолютные координаты XYXY в пикселях изображения для задач обнаружения GPT-5.6. Его тестирование показало, что формат координат оказывает значительное влияние на измеряемую производительность.
Roboflow сообщает, что OpenAI подтвердил, что Sol может становиться менее стабильным на изображениях около 2000 × 2000 пикселей или больше, особенно при низком уровне усилий рассуждения. Изменение размера или обрезка изображения, а также повышение усилий рассуждения улучшили результаты в тестах Roboflow.
Да. Luna набрала 43,3 mAP@50 для обнаружения объектов и 66,2% для подсчёта в упомянутом бенчмарке Roboflow, что значительно сильнее, чем результат обнаружения GPT-5.5. OpenAI позиционирует Luna как самый дешёвый уровень GPT-5.6, что делает её
актуально для высоконагруженных рабочих нагрузок.
Не во всём, но он остался сильнее в указанных бенчмарках Roboflow по обнаружению объектов и подсчёту, а также дешевле за изображение в этом тесте. Sol может быть предпочтительнее, когда зрение встроено в более сложные рассуждения или агентные рабочие процессы.
Иногда, но не автоматически. Универсальная VLM может упростить смешанные визуальные рабочие процессы, тогда как специализированные детекторы и OCR-системы могут по-прежнему обеспечивать меньшую задержку, предсказуемые результаты, тонкую настройку под домен или меньшую стоимость для узких производственных задач.
Бенчмарк Roboflow показывает значительное улучшение практических визуальных возможностей GPT-5.6. Результат обнаружения объектов у Sol вырос с 13,8 mAP@50 у GPT-5.5 до 46,2, а точность подсчёта улучшилась до 73%. Terra и Luna также показали большой прогресс, что позволяет предположить, что улучшение зрения распространяется на всё семейство, а не только на флагманскую модель.
Улучшение не является универсальным. OCR остался близок к уровню GPT-5.5, целевое извлечение текста в указанном бенчмарке снизилось, а большие изображения могут давать нестабильные ограничивающие рамки. Стоимость и задержка также остаются важными факторами: Gemini 3.5 Flash сохраняет сильные
Позиция для высокообъёмного обнаружения и подсчёта в сравнении Roboflow.
GPT-5.6 Sol является гораздо более надёжным универсальным работником в области компьютерного зрения, чем GPT-5.5, но производственным командам всё же следует выбирать модели по задаче, размеру изображения, надёжности, задержке и стоимости — а не по одному заглавному бенчмарку.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



