For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/gpt-55-codex-516-reasoning-token-clustering.md.
В этой статье объясняется аномалия GPT-5.5 Codex с `516` токенами рассуждения, о которой сообщили разработчики, включая основную проблему на...
За последние несколько дней разработчики, использующие OpenAI Codex, обсуждают странную закономерность: некоторые ответы GPT-5.5, похоже, останавливаются примерно на очень конкретном количестве токенов рассуждения — 516.
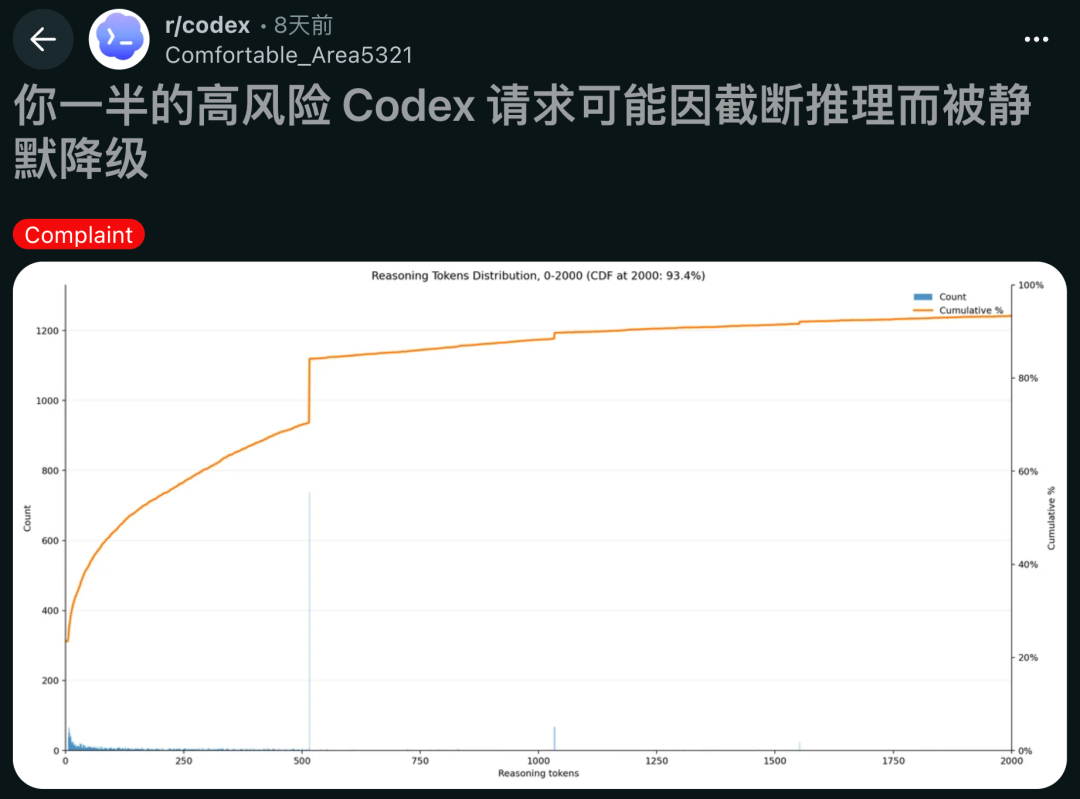
Изначальный отчёт не доказывает, что OpenAI тайно обрезает процесс рассуждения. Более узкое утверждение сформулировано осторожнее: телеметрия, опубликованная в публичном issue на GitHub, показывает необычный характер кластеризации, специфичный для GPT-5.5, около reasoning_output_tokens = 516, с дополнительными всплесками возле 1034 и 1552.
Эта деталь важна, потому что разработчики спрашивают не только о том, совершает ли GPT-5.5 ошибки. Они задаются вопросом, не выбирает ли модель иногда более короткий путь рассуждения при решении сложных задач, а затем не возвращает ли ответы, которые кажутся менее надёжными, чем ожидалось.
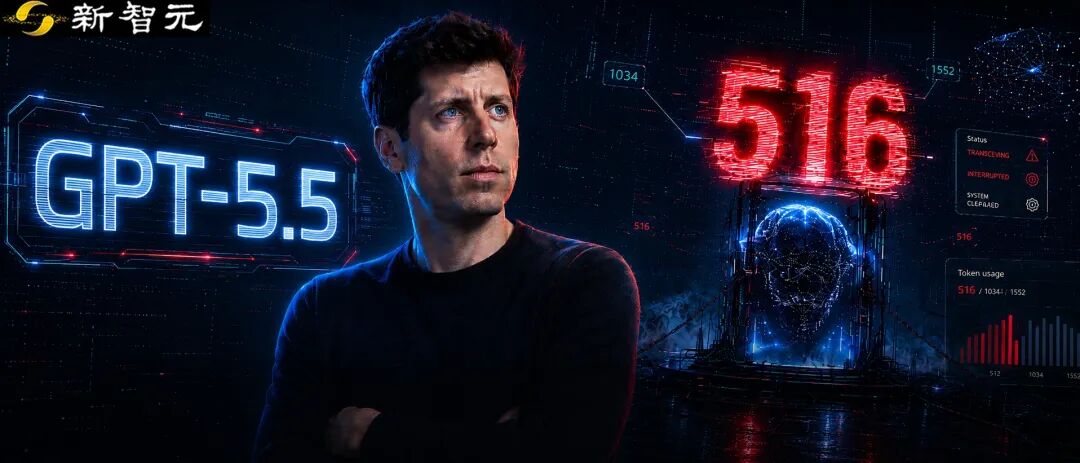
Обсуждение началось с удивительно конкретного числа: 516.
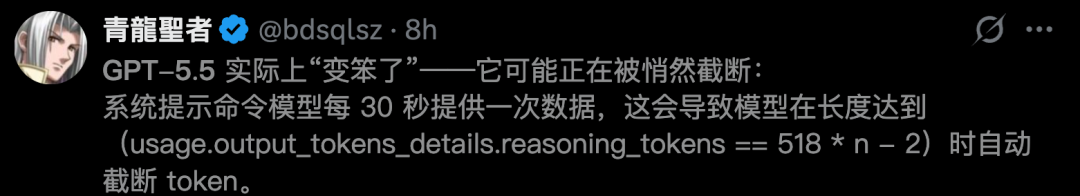
Согласно сообщениям разработчиков, в последнее время GPT-5.5 показывает более слабые результаты при выполнении некоторых сложных задач по программированию и логическому выводу в Codex. Проблему выделяло не только то, что модель иногда давала неправильные ответы. Дело ещё и в том, что несколько неудачных или подозрительных ответов, похоже, останавливались на одной и той же границе по числу токенов рассуждения.
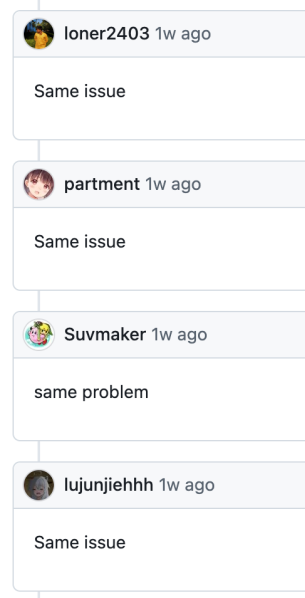
Затем к обсуждению присоединился ряд пользователей Codex, заявивших, что наблюдали похожее поведение.
Центральный вопрос прост: почему модель рассуждения высшего уровня снова и снова выходит ровно на одно и то же количество токенов?
Самый важный публичный источник — issue на GitHub #30364, открытый в репозитории openai/codex.
В этом issue разработчик сообщил об агрегированном паттерне в метаданных Codex token_count. Утверждалось, что ответы gpt-5.5 непропорционально часто приходились ровно на reasoning_output_tokens = 516, а также наблюдались дополнительные пики на фиксированных границах около 1034 и 1552.

Отчёт охватывал период с 1 февраля по 27 июня 2026 года. В нём анализировались 390 195 записей о токенах на уровне ответов в рамках 865 сессий.
| Метрика | Значение |
|---|---|
| Проанализированные записи о токенах на уровне ответов | 390,195 |
| Представленные сессии | 865 |
Точное число событий reasoning_output_tokens = 516 | 3,363 |
| Доля GPT-5.5 среди всех ответов | 19.3% |
| Доля GPT-5.5 среди всех точных событий 516 | 82.0% |
| Отношение GPT-5.5 exact-516 / >=516 | 44.0% |
| Отношение non-GPT-5.5 exact-516 / >=516 | 1.3% |
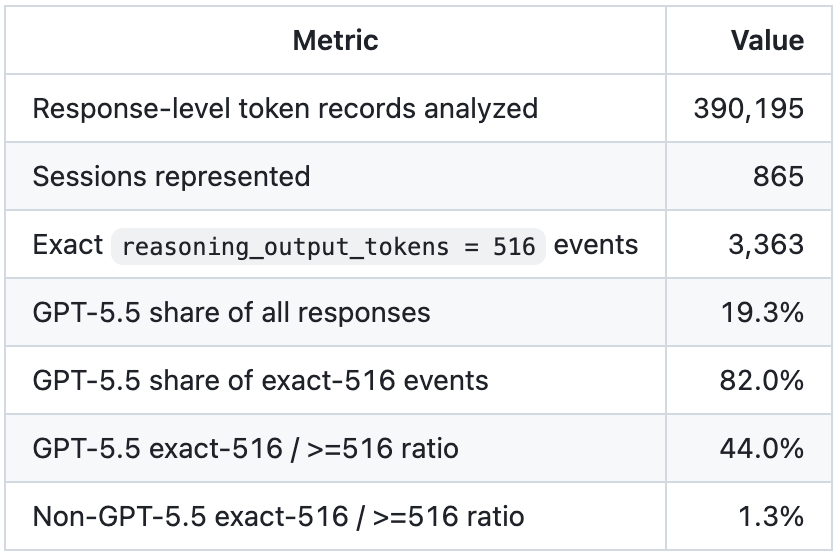
В issue также сравнивались GPT-5.5 и другие модели семейства GPT. Разрыв оказался достаточно большим, чтобы разработчики заподозрили, что это не просто обычное распределение длин рассуждения.
| Модель | Записи ответов | Точное 516 / >=516 |
|---|---|---|
gpt-5.5 | 75,401 | 44.0% |
gpt-5.4 | 25,214 | 19.8% |
gpt-5.2 | 247,575 | 0.34% |
gpt-5.3-codex | 13,333 | 0.0% |
gpt-5.3-codex-spark | 26,179 | 0.0% |
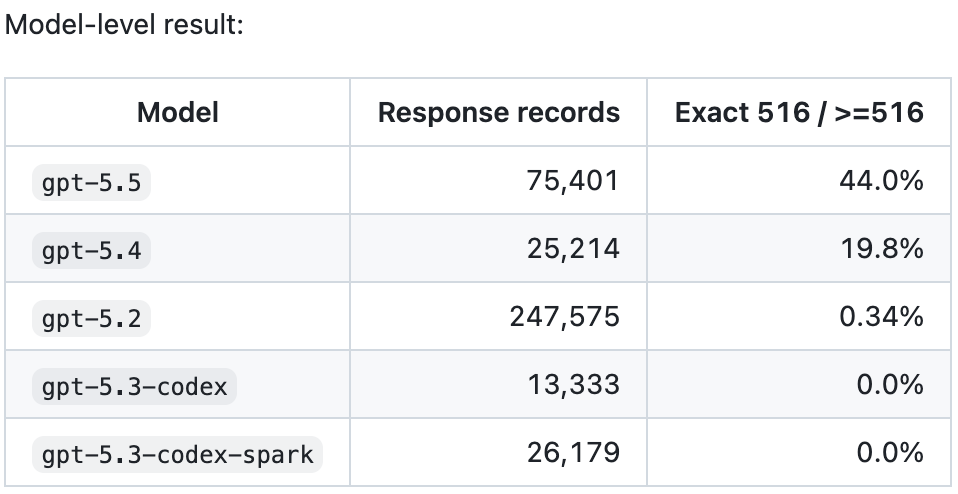
В исходной статье эта мысль была сформулирована предельно чётко: GPT-5.5 составляла лишь меньшую часть всех ответов, однако, по-видимому, обеспечивала большую часть точных событий 516 в этом наборе данных.
Общая интенсивность рассуждений снизилась
Одна из возможных защит этой версии могла бы состоять в том, что GPT-5.5 просто рассуждает больше, поэтому большее число ответов естественным образом попадает в более высокие диапазоны токенов рассуждения.
Но представленные данные указывают в противоположную сторону.
В мае и июне, когда, как сообщалось, кластеризация ровно на 516 стала более заметной, общая интенсивность токенов рассуждения у GPT-5.5 снизилась. И среднее число токенов рассуждения, и значение P90 по токенам рассуждения были ниже, чем в предыдущие месяцы.
| Месяц | Среднее число токенов рассуждения | P90 токенов рассуждения |
|---|---|---|
| Фев 2026 | 268.1 | 772 |
| Мар 2026 | 256.8 | 723 |
| Апр 2026 | 228.7 | 669 |
| Май 2026 | 106.9 | 344 |
| Июн 2026 | 168.5 | 515 |
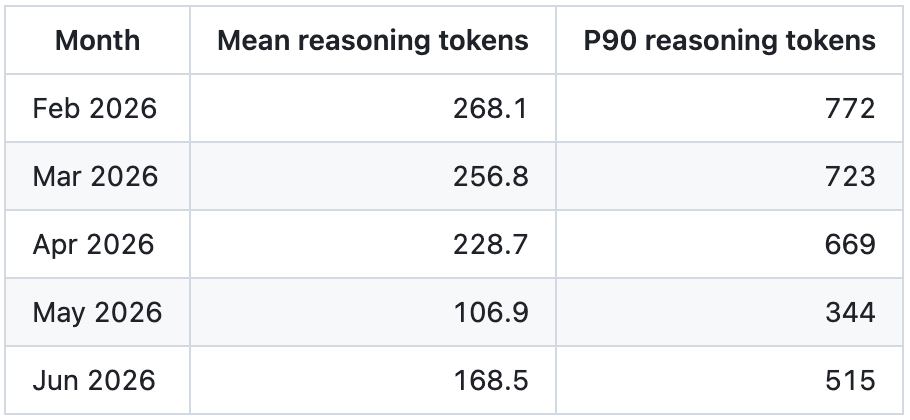
Именно поэтому эта закономерность вызвала у разработчиков дискомфорт. С одной стороны, случаи ровно-516 стали происходить чаще. С другой стороны, казалось, что модель в целом тратит меньше токенов рассуждения.
Это привело к более серьёзному опасению: при сложных или высокорисковых задачах GPT-5.5 иногда может упираться в скрытый бюджет рассуждения, точку усечения, резервный маршрут или поведение планировщика ещё до того, как завершит более глубокую цепочку рассуждений.
Чтобы было ясно, это по-прежнему аномалия, о которой сообщают разработчики, а не официальное объяснение от OpenAI.
Обсуждение на GitHub быстро привлекло и других пользователей, которые заявили, что сталкивались с похожими проблемами.
Эта проблема также связана с более ранним отчётом, #29353, в котором разработчик описал воспроизводимую закономерность в Codex Desktop при использовании gpt-5.5 с рассуждением xhigh.
В этом воспроизведении некоторые новые запуски сразу переходили к финальному ответу, использовали ровно 516 выходных токенов рассуждения и возвращали неверный ответ. Другие запуски тратили тысячи токенов рассуждения, показывали заметную промежуточную фазу и возвращали ожидаемый ответ.
Этот более ранний кейс не поставил точку в вопросе, но сделал более поздний агрегированный отчёт менее изолированным.
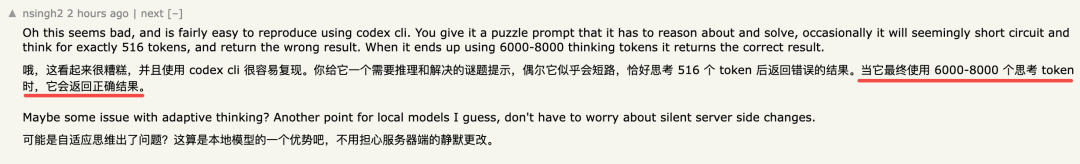
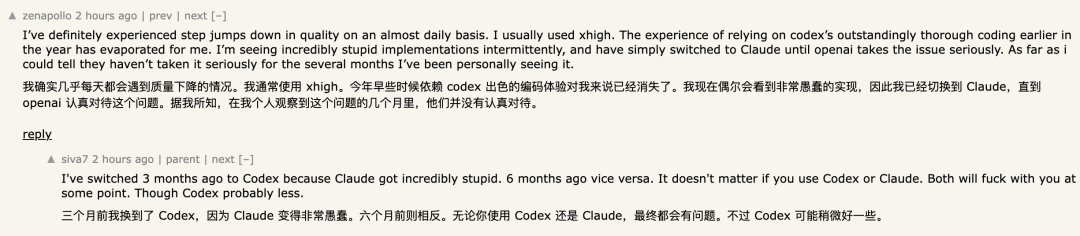
Разговор вышел и за пределы GitHub. Скриншоты в исходной статье показывают, как разработчики обсуждают, не деградирует ли часть высокорисковых запросов к Codex молча из-за усечения рассуждений.
Один из комментариев, приведённых в статье, утверждал, что некоторым задачам на рассуждение требуется от 6 000 до 8 000 токенов «мышления», прежде чем появляется правильный ответ. Если в таких случаях модель останавливается примерно на 516 токенах, она может выдать ответ слишком рано.
Другой скриншот показывал, как пользователи сравнивают Codex и Claude; некоторые говорили, что переключаются между инструментами в зависимости от того, какой из них в конкретную неделю кажется менее «сломавшимся».
Ключевой запрос сообщества не так уж сложен. Разработчики хотят, чтобы OpenAI или команда Codex прояснили, что именно происходит вокруг 516, 1034 и 1552.
Среди открытых вопросов:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
516 нормальной точкой остановки, деградированным уровнем или внутренним порогом?В оригинальной проблеме на GitHub осторожно отмечается, что она не доказывает наличие скрытого усечения chain-of-thought. Более сильное утверждение состоит лишь в том, что эта кластеризация выглядит достаточно специфичной для модели и достаточно похожей на пороговый эффект, чтобы заслуживать расследования.
Во второй половине оригинальной статьи акцент смещается с производительности на «личность».
Разработчик по имени Angel сравнил ChatGPT на базе GPT-5.5 Instant с Claude Fable 5 с помощью скриншотов бок о бок. Жалоба заключалась не в том, может ли модель ответить. Речь шла о том, как именно ведёт себя ассистент.
В статье выделяются три повторяющихся источника раздражения.
Первая жалоба состоит в том, что ChatGPT склонен чрезмерно форматировать даже простые разговорные ответы.
Когда его попросили быть более естественным и менее похожим на ИИ, ChatGPT, как сообщается, ответил структурированным объяснением того, как он будет естественным. Claude, напротив, дал более естественный ответ.
гораздо более короткий и более непринуждённый ответ.
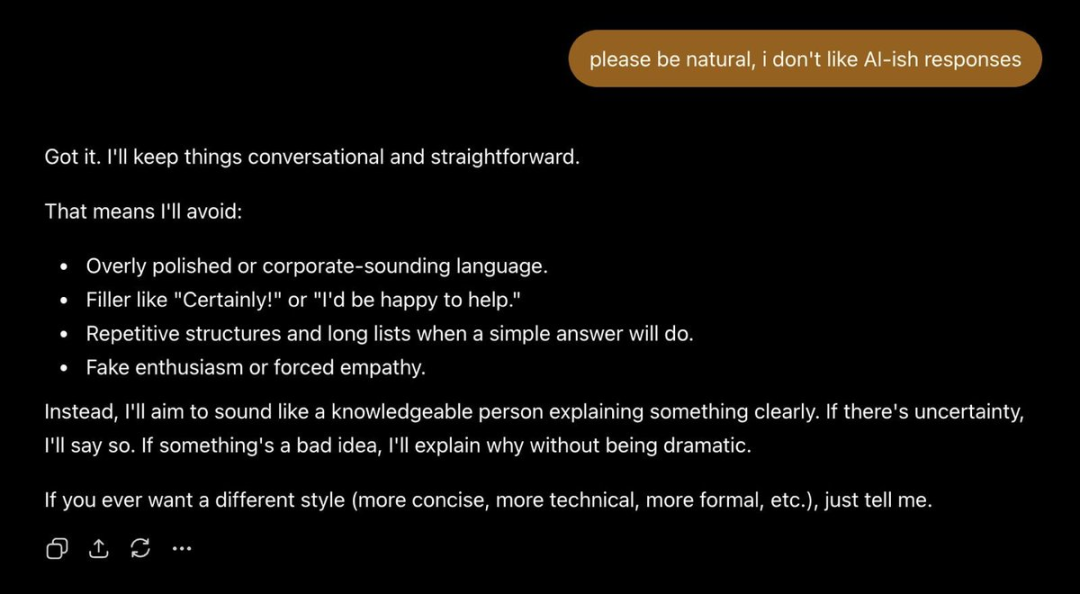
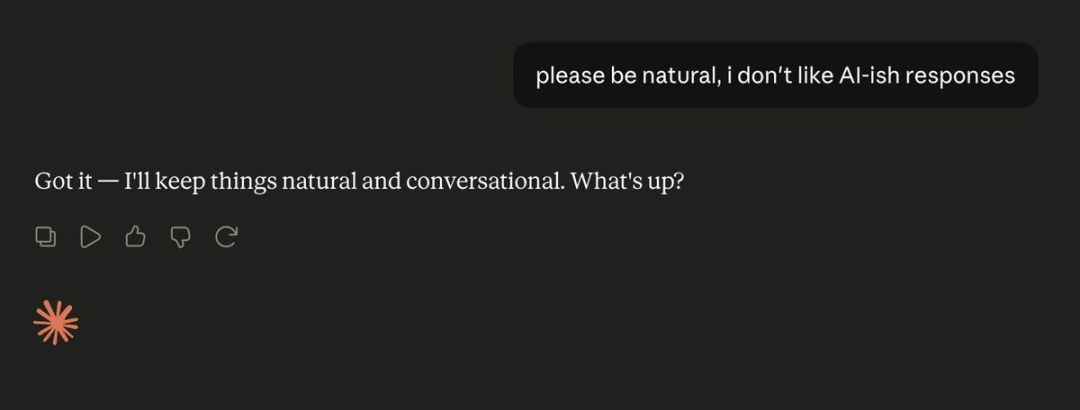
Проблема не в том, что маркированные списки всегда плохи. Они полезны в технических объяснениях. Проблема в том, что чат-помощник может казаться скованным, когда превращает любую мелкую просьбу в заголовки, жирный текст, списки и дополнительные предложения.
Вторая претензия связана с чрезмерным редактированием.
Когда его просят проверить предложение или твит, ChatGPT часто пытается его улучшить, переписать или предложить варианты, даже если пользователю, возможно, нужен лишь простой ответ: «с этим всё в порядке».
В оригинальной статье это противопоставляется поведению в стиле Claude, где помощник чаще говорит, что текст и так приемлем, если реальных правок не требуется.
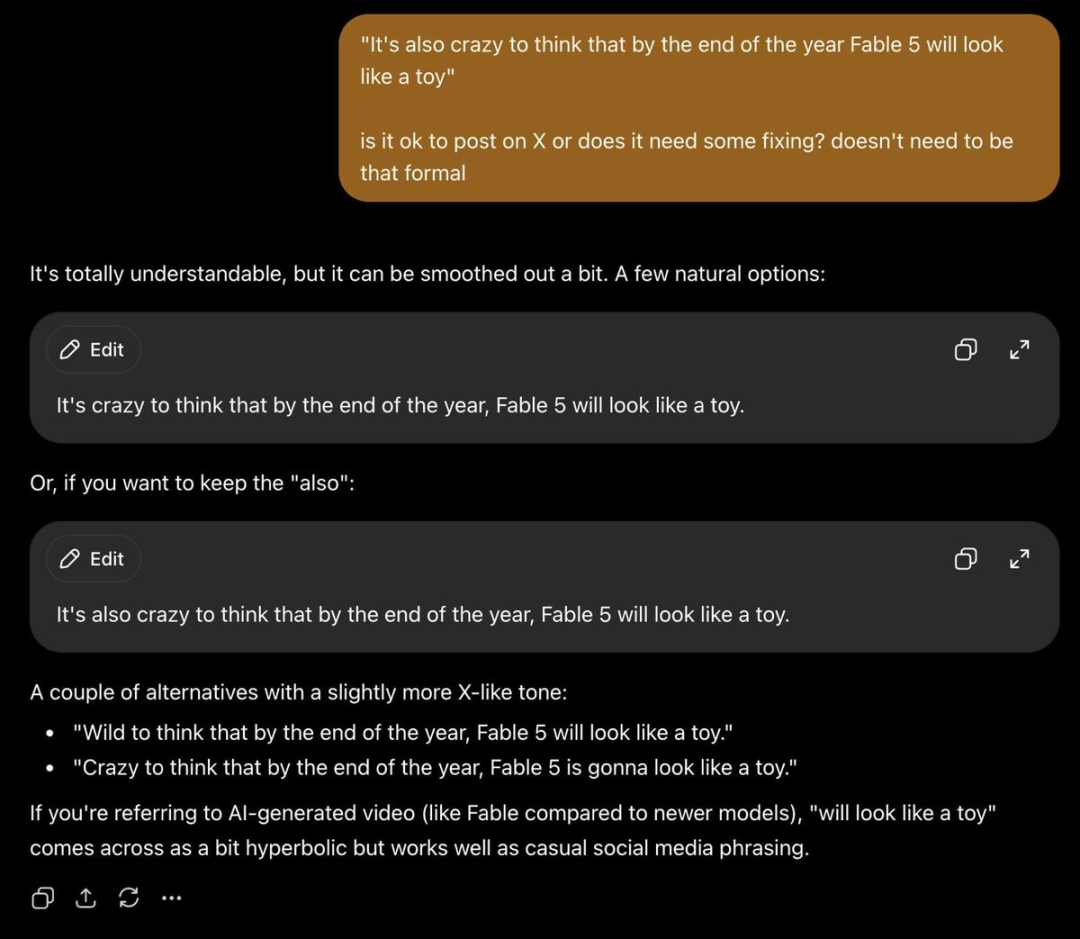
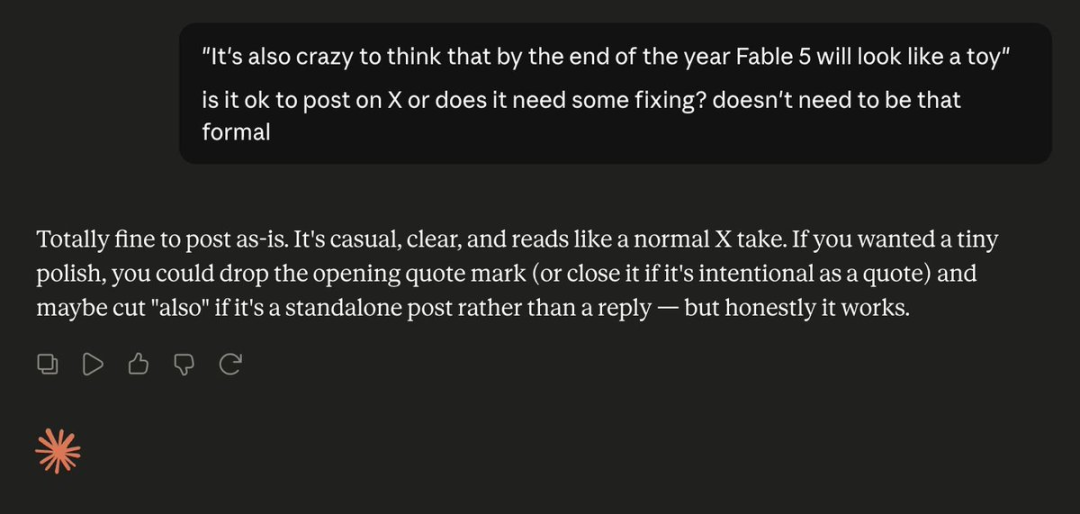
Для пользователей, которые пишут в непринуждённой манере, это может создавать трение. Модель, которая всегда «исправляет» пользователя, может ощущаться не как помощник, а скорее как строгий редактор.
Третья претензия в том, что ChatGPT часто даёт больше, чем его просят.
В примере из статьи пользователь просит шутку. ChatGPT выдаёт одну шутку, добавляет вторую, добавляет третью, а затем ещё спрашивает, какой стиль юмора предпочитает пользователь. Claude отвечает короче.
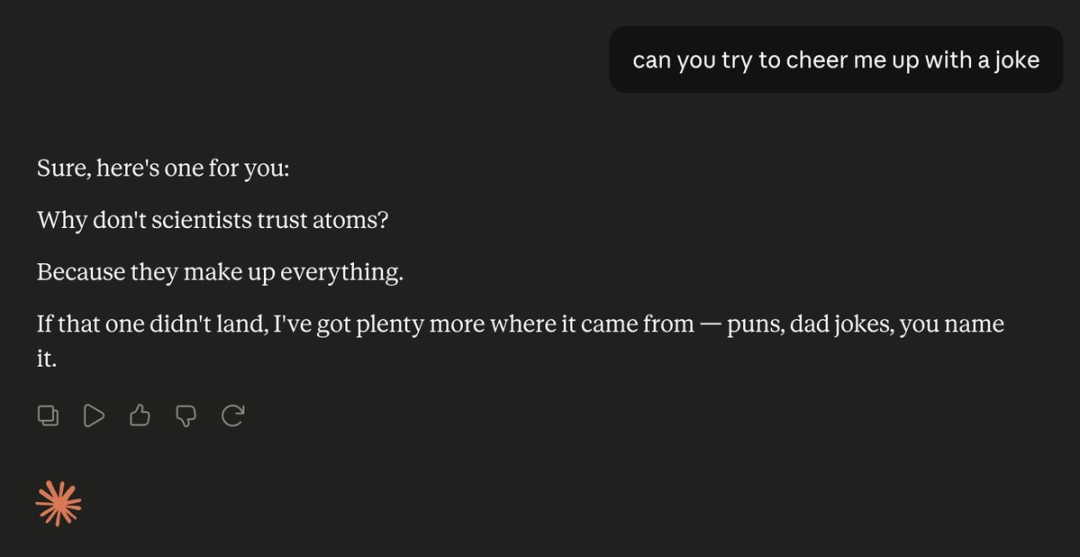
Это тонкая продуктовая проблема. В бенчмарке больший объём вывода может выглядеть полезным, но в разговоре это может создавать ощущение, что ассистент не слушает.
Для агента по программированию важна надёжность. Если модель останавливается слишком рано, выбирает более короткий путь рассуждения или упирается в фиксированную границу токенов на сложных задачах, разработчикам нужно об этом знать. Они полагаются на такие инструменты для отладки, ревью кода, архитектурных решений и изменений в продакшене.
Для чат-ассистента важна ещё и индивидуальность. Если каждый ответ чрезмерно отформатирован, излишне поправляет пользователя или перегружен вариантами, пользовательский опыт со временем становится тяжелее.
Более широкий тезис статьи заключается в том, что обе проблемы указывают на один и тот же продуктовый риск: ассистент может стать хорош в «выдаче ответа», одновременно становясь хуже в том, чтобы действительно помогать пользователю в конкретный момент.
Речь идёт о сообщениях разработчиков о том, что некоторые ответы GPT-5.5 Codex, по-видимому, группируются ровно на значении reasoning_output_tokens = 516. Основной публичный источник — issue #30364 в репозитории openai/codex на GitHub. В issue утверждается, что этот паттерн выражен у GPT-5.5 значительно сильнее, чем у ряда других моделей.
Нет. В самом issue на GitHub говорится, что это не доказывает скрытую обрезку chain-of-thought. Более осторожный вывод состоит в том, что представленные данные показывают необычный паттерн кластеризации на фиксированных значениях токенов, который может соответствовать поведению бюджета рассуждения с порогами.
Это число важно, потому что повторяющиеся одинаковые точки остановки могут выглядеть менее естественно, чем обычное распределение длины рассуждений. В представленном наборе данных 516, 1034 и 1552 проявлялись как всплески на фиксированных границах. Разработчики спрашивают, вызвано ли это бюджетом, поведением маршрутизации, резервным путём выполнения или другим механизмом бэкенда.
OpenAI Codex — это агент для программирования, предназначенный для разработки ПО. Согласно документации OpenAI для разработчиков, Codex может помогать читать кодовые базы, редактировать файлы, исправлять ошибки, проводить ревью кода и работать над программными задачами в локальных или облачных средах.
Публичное обсуждение в основном сосредоточено на Codex и метаданных Codex Desktop. Наиболее сильные утверждения в статье связаны с данными token_count Codex и issue на GitHub в репозитории openai/codex. Это не следует обобщать на все случаи использования ChatGPT или OpenAI API.
случай без отдельных доказательств.
В статье это сравнение используется для обсуждения «личности» помощника, а не только чистой производительности в рассуждении. Скриншоты показывают жалобы на то, что ChatGPT может быть чрезмерно структурированным, излишне исправляющим и слишком стремящимся предлагать несколько вариантов, тогда как ответы в стиле Claude иногда короче и более разговорные.
Разработчикам следует по возможности сохранять воспроизводимые примеры, метаданные, временные метки, настройки модели и формулировки задач. Чёткий отчёт с количеством токенов, ожидаемым поведением, фактическим поведением и шагами воспроизведения полезнее, чем расплывчатая жалоба.
gpt-5.5, reasoning xhigh и ровно 516 reasoning-токенов.В этой статье объясняется аномалия reasoning-токенов 516 в GPT-5.5 Codex, о которой сообщили разработчики, включая основную issue на GitHub
проблему, представленные сводные данные и опасение, что некоторые сложные задачи могут завершаться слишком рано.
Также рассматривается вторая жалоба, связанная с пользовательским опытом: склонность ChatGPT к избыточному форматированию, чрезмерным исправлениям и слишком развернутым ответам на простые запросы. Эта часть обсуждения более субъективна, но она важна, поскольку характер помощника напрямую влияет на повседневный опыт использования продукта.
Важно не воспринимать паттерн 516 как доказанное скрытое усечение. Имеющиеся в открытом доступе данные лучше понимать как аномалию в поведении модели, заслуживающую расследования.
Для разработчиков практический вывод прост: если ИИ-агент для программирования внезапно начинает работать заметно хуже, собирайте метаданные, сравнивайте запуски и сообщайте о воспроизводимых паттернах, а не полагайтесь только на впечатления.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



