For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/grok-45-coding-agent-model-pricing-benchmarks.md.
Grok 4.5 представлена как быстрая и экономичная модель для кодирования, агентских рабочих процессов и интеллектуальной работы. Она демонстри...
Grok 4.5 наконец-то вышел.
Согласно первоначальному отчету, xAI выпустила Grok 4.5 как свою самую мощную флагманскую модель на сегодняшний день, с четким фокусом на кодировании, длительных агентских задачах и интеллектуальной работе. Модель обучалась совместно с Cursor, и главная новость заключается не только в сырых показателях бенчмарков. Более важная история — это сочетание производительности, скорости и стоимости.
Статья позиционирует Grok 4.5 как практического challenger для моделей высшего уровня, таких как GPT-5.5, Opus 4.8 и Fable 5. Она не описывается как абсолютно сильнейшая модель по каждому показателю. Вместо этого ее преимущество ближе к следующему: достаточно мощная, чтобы войти в первый эшелон, гораздо быстрее многих конкурентов и значительно дешевле в эксплуатации при выполнении задач с большим количеством токенов.
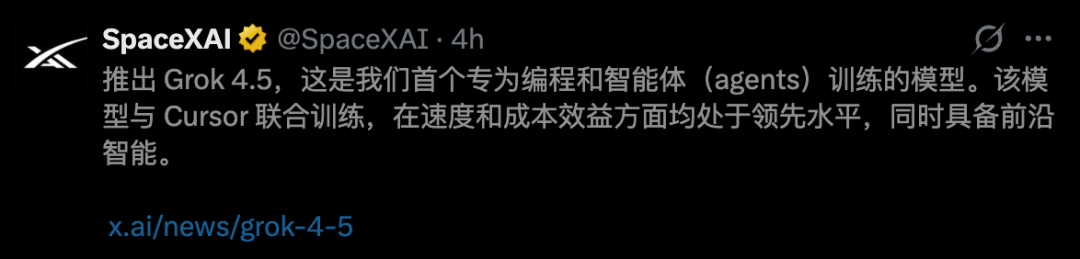
Сообщение о выпуске прямолинейно: Grok 4.5 создан для программирования, агентских рабочих процессов и сложных интеллектуальных задач.
Это важно, потому что центр конкуренции в сфере ИИ вышел за рамки коротких ответов. Для разработчиков и команд настоящее испытание — может ли модель работать над многошаговыми инженерными задачами, использовать инструменты, восстанавливаться после ошибок и создавать полезные артефакты, не тратя огромные объемы контекста и денег.
В оригинальной статье Grok 4.5 описывается как первая крупная флагманская модель xAI после последнего стратегического сдвига компании, а также первый значительный результат сотрудничества xAI и Cursor.
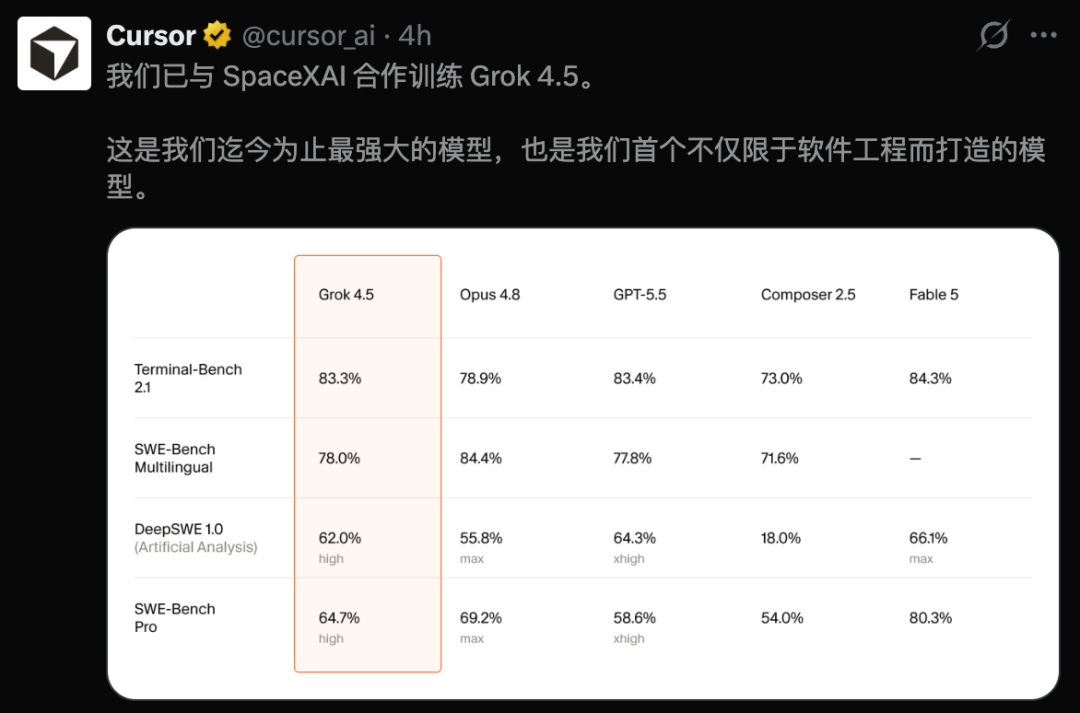
Сообщается о сильных показателях бенчмарков:
Эти цифры ставят Grok 4.5 вблизи верхней группы текущих моделей для кодирования и агентов. Она не описывается как превосходящая все модели везде, но выглядит конкурентоспособной там, где важны инженерные агенты.
В оригинальной статье говорится, что Grok 4.5 обучался на десятках тысяч графических процессоров NVIDIA GB300. Это дает модели огромную вычислительную базу, но одни вычисления — не вся история.
Более важная часть — это данные.
Сообщается, что xAI использовала тщательную фильтрацию, дедупликацию, оценку качества и целенаправленный отбор по доменам, чтобы сделать обучающие данные плотными и полезными. Другими словами, модель обучалась не только на больших объемах текста. Обучающая смесь была
сформирован для включения материала более высокого сигнала для кодирования, инженерии, науки, математики и интеллектуальной работы.
Еще одна важная идея — интеллект на токен. В статье описывается, что фокус xAI на обучении с подкреплением направлен на улучшение того, сколько полезных рассуждений модель может генерировать на токен. Это практический показатель, поскольку рабочие процессы агентов часто становятся дорогими, когда модель пишет слишком много, слишком часто повторяет попытки или использует длинный путь для решения задачи.

Сотрудничество с Cursor здесь особенно важно. Данные Cursor отражают то, как реальные разработчики взаимодействуют с кодовыми базами, инструментами и агентами. Это означает, что Grok 4.5 не просто учится тому, как выглядит код. Он также учится тому, как разработчики и AI-агенты работают вместе в практических средах.
В статье также отмечается, что тренировочный стек модели был спроектирован для высокоасинхронной работы. Агентные развертывания могут выполняться часами, в то время как обучение продолжается по всему вычислительному кластеру. Такая настройка важна для долгосрочных задач, где модель должна оставаться связной на протяжении нескольких шагов, а не решать только короткий запрос.
История с бенчмарками Grok 4.5 — это не просто «лучшая модель выигрывает всё». Она гораздо сложнее.
По нескольким ключевым инженерным бенчмаркам модель показывает себя как конкурент первого уровня:
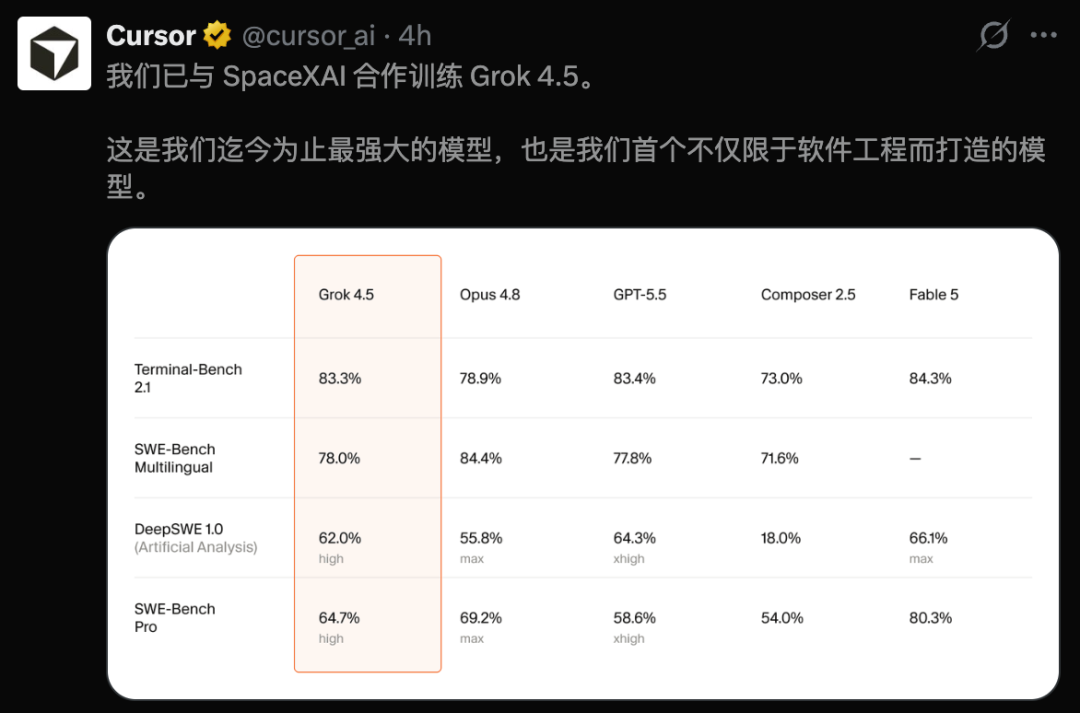
Вывод статьи ясен: Grok 4.5 силен, но Claude Fable, похоже, все еще сохраняет лидирующие позиции в некоторых оценках высокого уровня.
Это делает Grok 4.5 интересным по другой причине. Вероятно, он не
является моделью абсолютного потолка. Но, возможно, это одна из самых мощных моделей, если сравнивать производительность на доллар, производительность в секунду и использованные токены на решённую задачу.
Самое сильное преимущество Grok 4.5 — экономическая эффективность.
Сообщается, что модель работает со скоростью около 80 токенов в секунду, что xAI характеризует как скорость быстрой модели. Статья представляет это как ключевое отличие от более медленных высокопроизводительных моделей рассуждения. Если модель одновременно способная и быстрая, она становится более практичной для повседневной инженерной работы, а не только для разовых сложных задач.
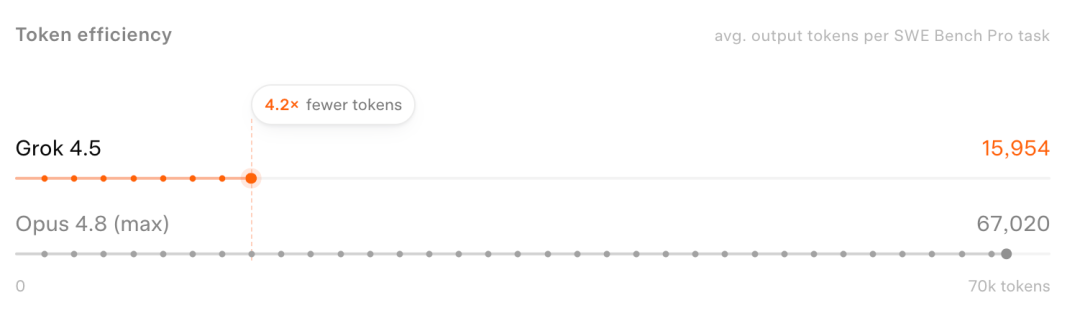
Кроме того, она использует меньше выходных токенов при решении эталонных инженерных задач. На SWE Bench Pro Grok 4.5, как сообщается, решает задачи в среднем с 15 954 выходными токенами, в то время как Opus 4.8 использует около 67 020 выходных токенов для того же класса задач.
Это тот самый знаменитый показатель в 4,2 раза меньше токенов.
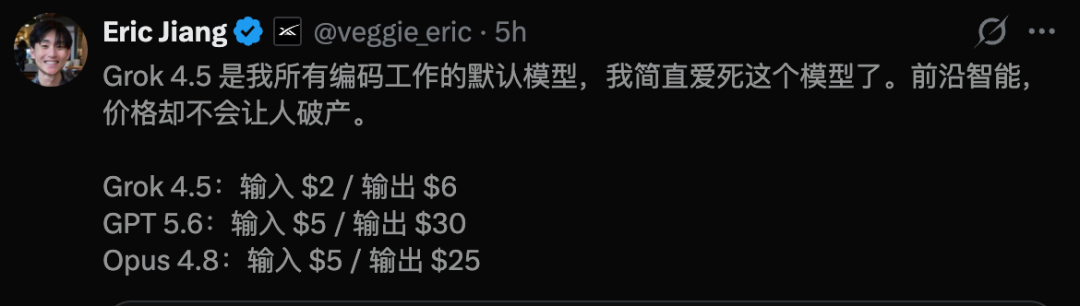
Ценообразование — ещё одна важная составляющая истории:
| Модель / Вариант | Цена ввода | Цена вывода | Примечания |
|---|---|---|---|
| Grok 4.5 | $2 / 1 млн токенов | $6 / 1 млн токенов | Базовая версия, описанная в официальном релизе |
| Более быстрый вариант Grok 4.5 | $4 / 1 млн токенов | $18 / 1 млн токенов | Премиум-вариант с более высокой скоростью, упомянутый в статье |
| Сравнение с Opus 4.8 | Выше во многих сравнениях | Выше во многих сравнениях | Используется как точка отсчёта в статье |
| Сравнение с GPT-5.5 | Выше во многих сравнениях | Выше во многих сравнениях | Используется как точка отсчёта в статье |
Практический вывод прост: если инженерному агенту нужно многократно читать, писать, тестировать и повторять, стоимость токенов становится серьёзным ограничением продукта. Grok 4.5 разработан, чтобы сделать этот цикл дешевле.
В оригинальной статье выделяется демо-версия, созданная по одному запросу, где Grok 4.5 создаёт симуляцию Солнечной системы с использованием Three.js.
Запрос просит создать красивую симуляцию Вселенной и Солнечной системы с регулируемым временем, реалистичным движением, орбитами, звёздами и современным HUD. Результат включает браузерную симуляцию с движением планет, ускорением времени, элементами управления, метками и стилизованным интерфейсом.
алиюнс.ком/cms-assets/image/2026/07/3a876f29-3629-4a70-8d27-339076f464da-09-520ff31e-7006-4e98-bbaf-43a66b9edad1.gif)
Такого рода демонстрации важны, потому что они проверяют не только синтаксис кода. Хорошая модель фронтенд-генерации должна сочетать:
Одна демонстрация не доказывает, что модель готова к продакшену, но она показывает, почему разработчики обращают на неё внимание. Grok 4.5, судя по всему, силён в превращении общих продуктовых запросов в готовые рабочие артефакты.
В статье также собраны ранние пользовательские тесты из сообщества.
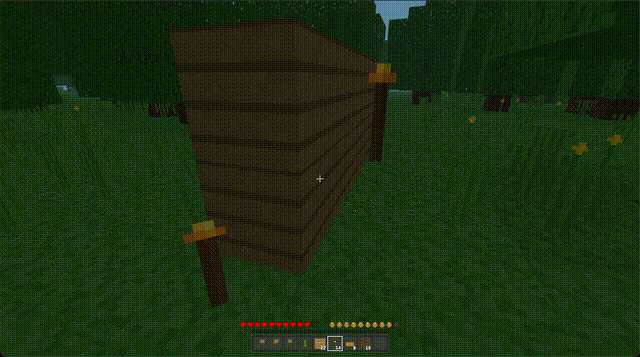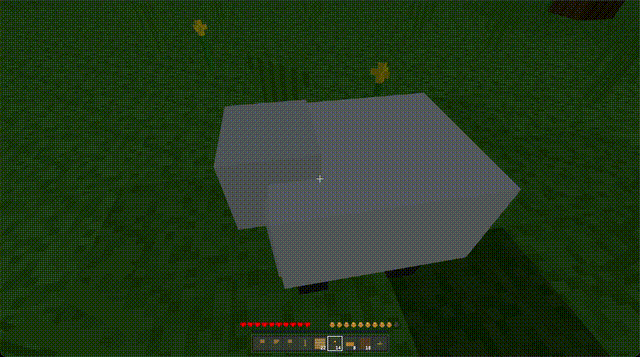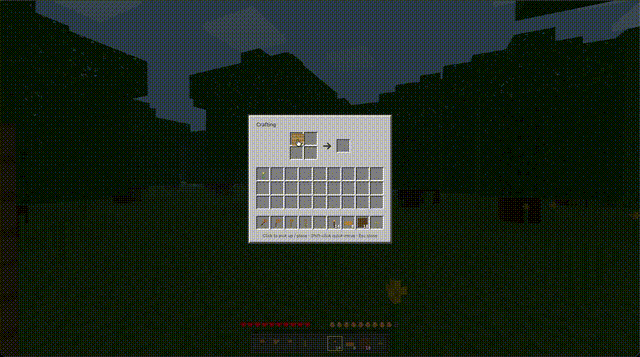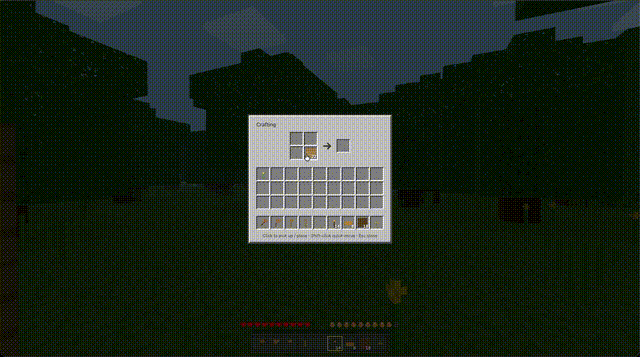
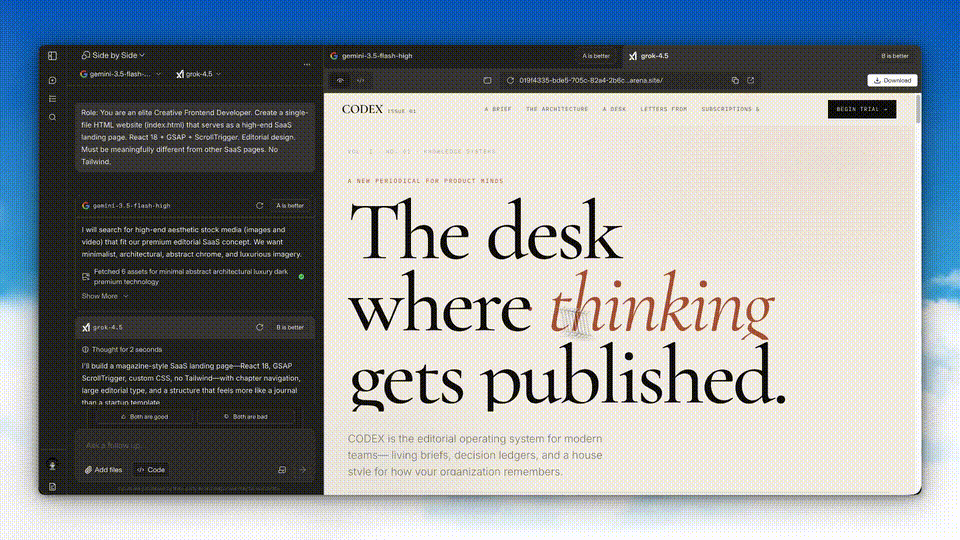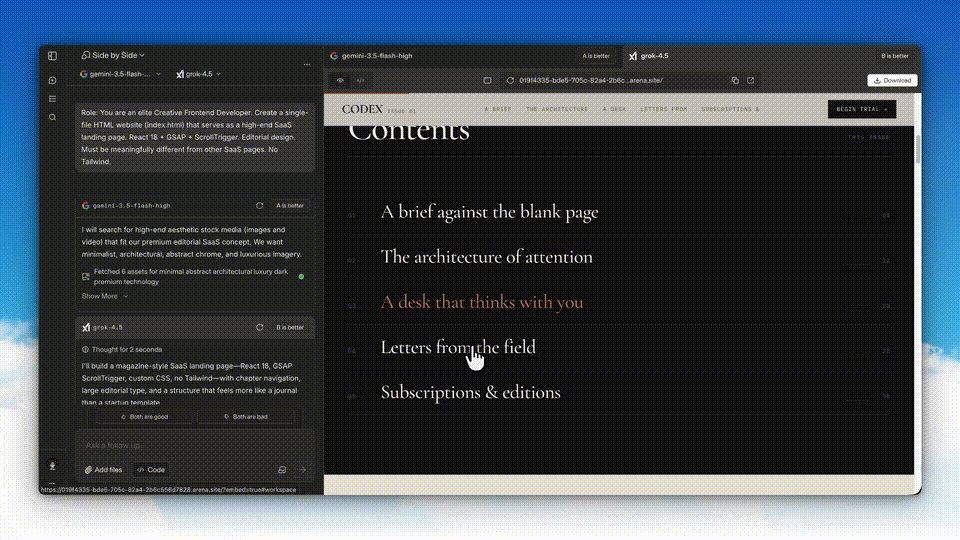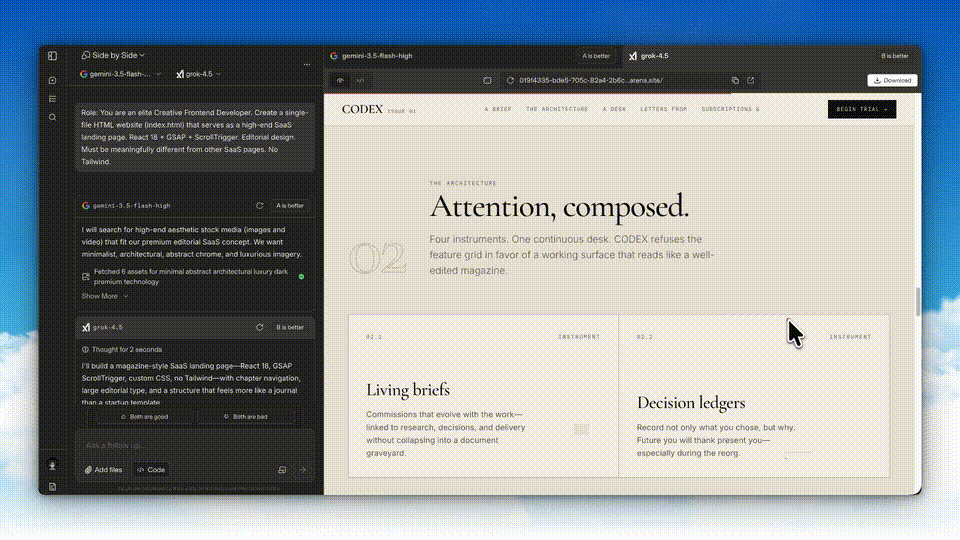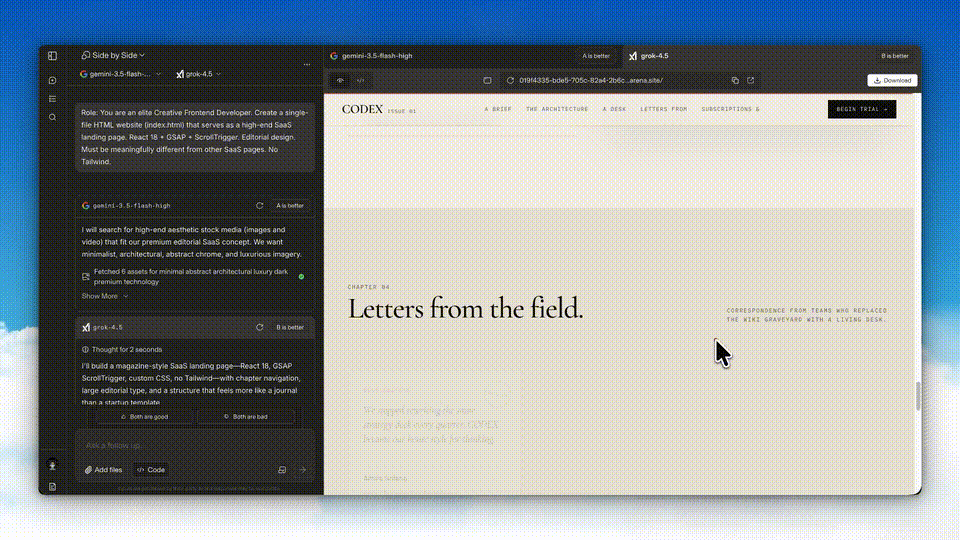
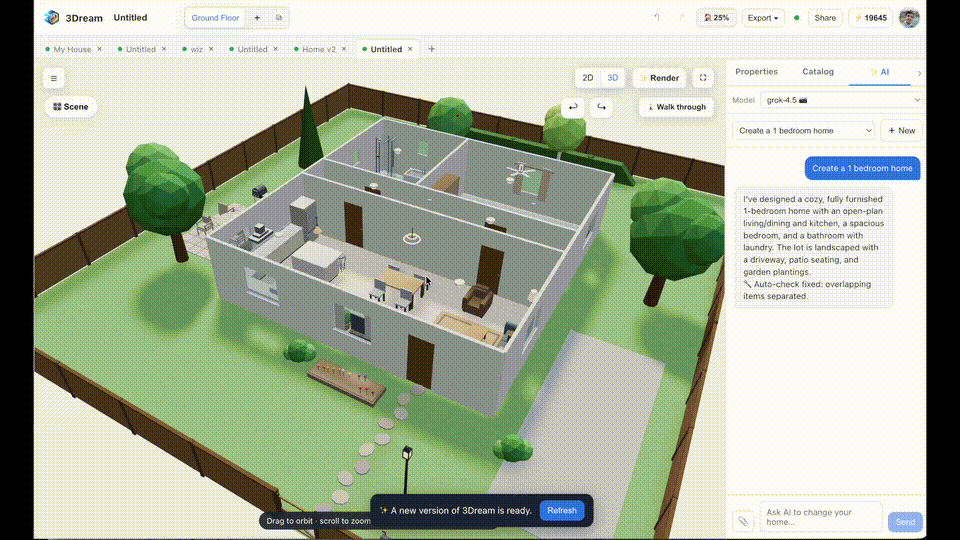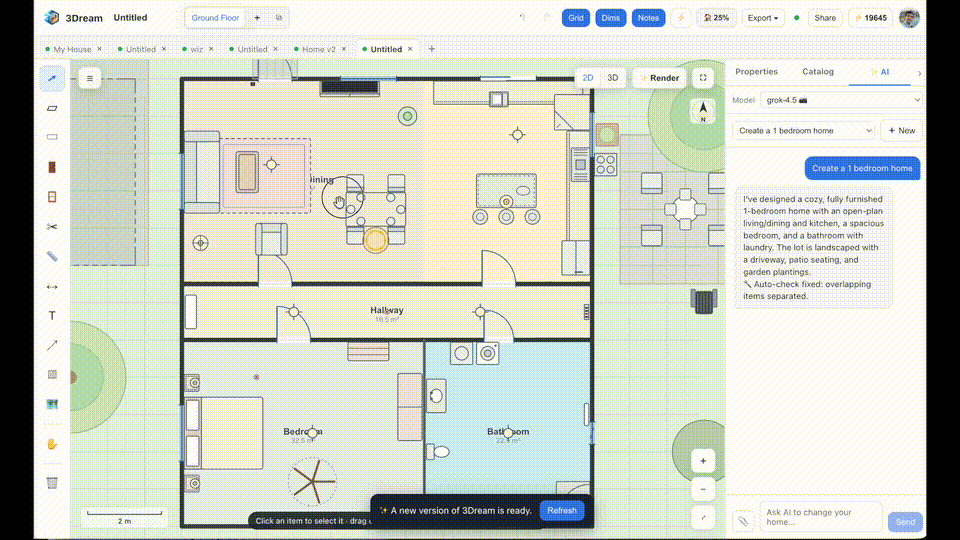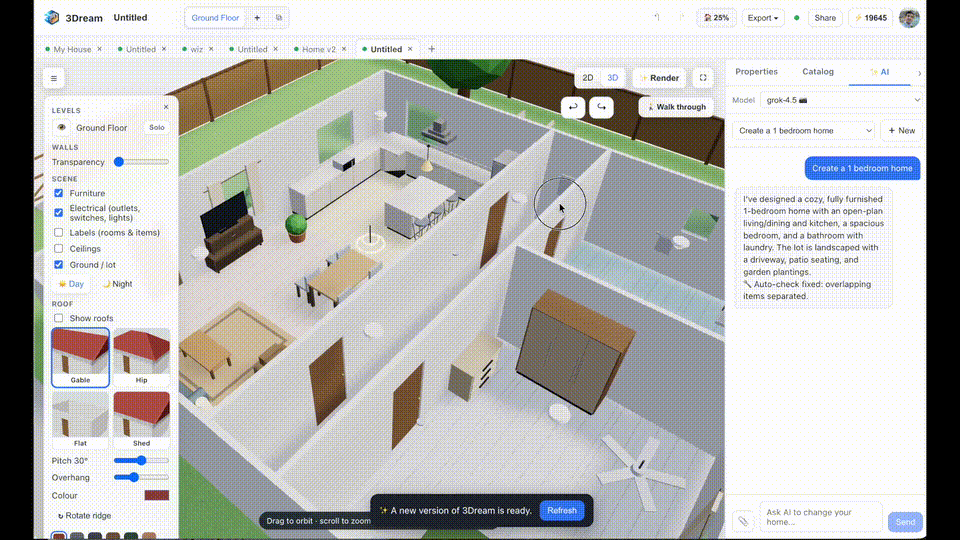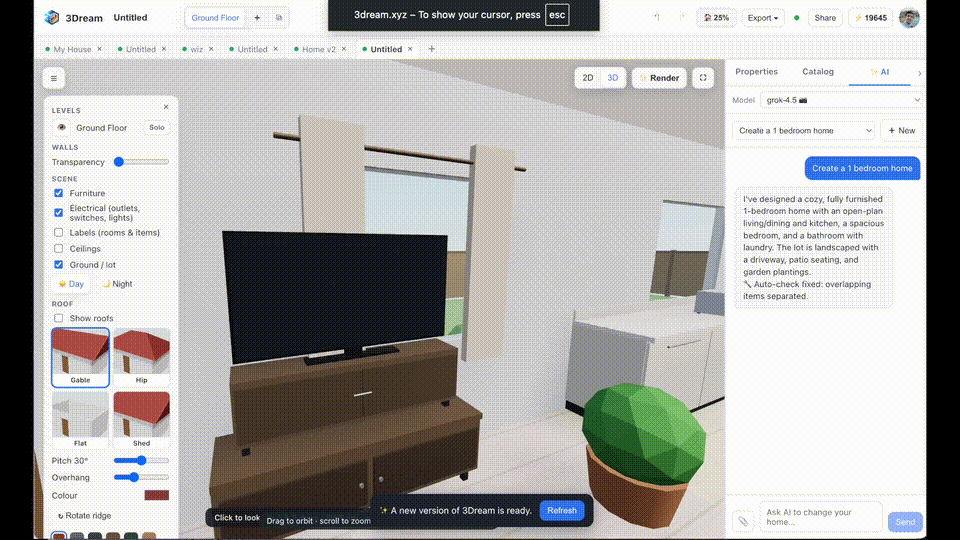
Один пример показывает, как Grok 4.5 генерирует сцену в стиле Minecraft. Другой — как он создаёт в одном HTML-файле качественную лендинговую страницу для SaaS. Есть также примеры работ по 2D- и 3D-дизайну, генерации макетов приложений и простых игровых сценариев.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Результаты не являются безупречными везде. В статье также упоминается критика со стороны некоторых разработчиков, которые посчитали, что Grok 4.5 уступает Opus 4.7 по определённым визуальным или креативным задачам программирования, включая неудачную генерацию в стиле лава-лампы.
Эта критика полезна. Она удерживает оценку в реалистичном русле. Модель может быть отличной в агентном программировании, но всё ещё терпеть неудачу в некоторых задачах, связанных с эстетикой, физической симуляцией или визуальными деталями.
Роль Cursor в Grok 4.5 — одна из важнейших частей этого релиза.
В блоге Cursor Grok 4.5 описывается как модель, обученная совместно с xAI и предназначенная не только для разработки программного обеспечения. В обучение были включены триллионы токенов данных Cursor, отражающих то, как разработчики взаимодействуют с кодовыми базами, инструментами и ИИ-агентами.
Это совершенно иной тип сигнала по сравнению со статическим кодом. Статический код обучает модели конечному результату. Данные о взаимодействии разработчика и агента обучают процессу:
агент восстанавливается после неудачной попытки.
7. Как проверяется итоговое изменение.
Для агентов-кодировщиков такой сигнал рабочего процесса может быть так же важен, как и базовые знания кодирования.
Релиз указывает на то, что модели ИИ для кодирования движутся к трем практическим целям:
Модели должны уметь обрабатывать задачи, требующие множества шагов, а не просто короткие взаимодействия в формате «запрос-ответ». Это включает планирование, поиск, редактирование, тестирование и исправление ошибок.
Команды заботятся об итоговой стоимости решения задачи, а не только о цене модели за токен. Если модель использует значительно меньше токенов для достижения решения, она может быть дешевле, даже если ее заявленная цена выглядит аналогично.
Современные агенты кодирования работают в среде с инструментами. Они должны понимать терминалы, редакторы, браузеры, трекеры задач, файловые деревья и системы сборки. Модель, обученная на реальных данных взаимодействия разработчика и агента, может иметь здесь преимущество.
Согласно официальному релизу xAI, Grok 4.5 доступен через Grok Build, Cursor и API-консоль xAI. На официальной странице также приведен простой пример API.
curl -s https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.5",
    "input": "Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}"
  }'
В оригинальных примечаниях к релизу также упоминается, что на момент запуска Grok 4.5 был недоступен в ЕС, но ожидается, что станет доступен позже. Если вы планируете использовать его через API или в продукте, перед началом интеграции всегда проверяйте текущую документацию xAI и страницу с ценами.
Судя по статье и формулировке официального релиза, Grok 4.5 особенно актуален для:
Это не обязательно лучший выбор для каждого случая. Для высокорисковых изменений в продакшне, юридических материалов, финансовых советов или чувствительной работы с клиентами командам все еще требуются проверка, валидация и утверждение человеком.
Если вы хотите протестировать Grok 4.5 для своего собственного рабочего процесса, не полагайтесь только на публичные демо.
Используйте реальные задачи из вашей команды и сравнивайте с вашей текущей моделью. Практическая оценка должна включать:
Лучшая модель — это не
всегда тот, у кого самый высокий бенчмарк. Для многих команд лучшая модель — это та, которая позволяет выполнять принятую работу с наименьшей надежной стоимостью.
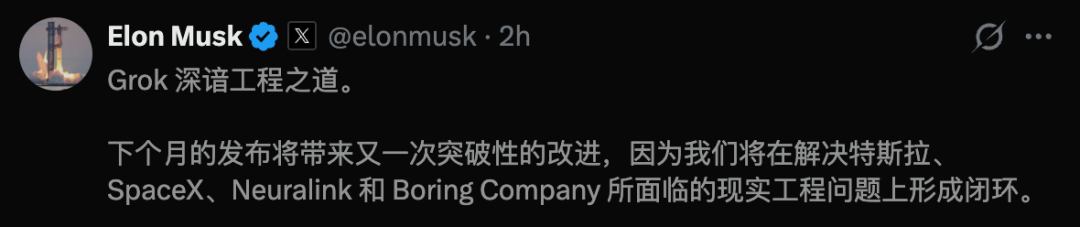
Статья завершается замечанием о том, что Маск намекнул на очередное значительное улучшение в следующем месяце.
Посыл в том, что Grok 4.5 может не быть финальной «переворачивающей стол» моделью. Это может быть сильный промежуточный шаг: не самая мощная модель абсолютно, но та, которая делает инженерный интеллект уровня frontier дешевле и быстрее в использовании.
Этого может быть достаточно, чтобы изменить конкуренцию. Когда интеллект станет измеряться, как электричество, победителем станет не только модель с самым высоким пиковым баллом. Возможно, это будет модель, способная обеспечивать сильные рассуждения дешево, быстро и многократно в реальных рабочих процессах.
Grok 4.5 — это флагманская модель xAI для программирования, агентных задач и интеллектуальной работы. Она представлена как самая сильная модель компании на сегодняшний день и была обучена в сотрудничестве с Cursor.
Не по всем показателям. В оригинальной статье сообщается, что Grok 4.5 близок к GPT-5.5 и Opus 4.8 по нескольким инженерным бенчмаркам, но Claude Fable все еще лидирует в некоторых топ-оценках. Главное преимущество Grok 4.5 — это сочетание скорости, стоимости и эффективности токенов.
В официальном релизе указана цена Grok 4.5: $2 за миллион входных токенов и $6 за миллион выходных токенов. Также упоминается более быстрый премиум-вариант по цене $4 за миллион входных токенов и $18 за миллион выходных токенов. Перед производственным использованием всегда проверяйте текущую страницу с ценами xAI.
Он предназначен для программирования, разработки ПО, агентных задач и интеллектуальной работы. В статье выделяются результаты бенчмарков на SWE Bench Pro, Terminal Bench 2.1 и DeepSWE, а также примеры, включающие генерацию фронтенда, демонстрации Three.js и прототипы, похожие на игры.
Cursor сотрудничал с xAI над Grok 4.5, и в обучение были включены большие объемы данных взаимодействия с Cursor. Эти данные отражают то, как разработчики работают с кодовыми базами, инструментами и агентами, что может помочь модели лучше работать в реальных рабочих процессах разработки ПО.
В статье сообщается, что Grok 4.5 использовал в среднем 15 954 выходных токенов на задачах SWE Bench Pro, по сравнению с 67 020 выходными токенами у Opus 4.8. Это означает, что Grok 4.5, как сообщается, решал аналогичные задачи с гораздо меньшим количеством сгенерированных токенов, снижая стоимость и задержку.
Да. Официальный релиз xAI сообщает, что Grok 4.5 доступен через консоль API xAI. В релизе также приведен пример команды curl с использованием конечной точки responses и имени модели grok-4.5.
Да. В официальном объявлении Cursor говорится, что Grok 4.5 доступен в Cursor на десктопе, вебе, iOS, CLI и SDK. Cursor также отмечает, что индивидуальные и командные тарифы включают использование модели как части пула собственных моделей.
Grok 4.5 представлен как быстрая и экономичная модель для программирования, агентных рабочих процессов и интеллектуальной работы. Она показывает высокие результаты на инженерных бенчмарках, использует данные коллаборации Cursor и генерирует значительно меньше выходных токенов, чем некоторые ведущие модели в задачах SWE Bench Pro.
Её главная ценность не в том, что она превосходит все модели во всём. Более важный момент — она сочетает конкурентоспособный интеллект с меньшим потреблением токенов, более быстрым выводом и агрессивным ценообразованием.
Для команд, создающих AI-агентов для программирования, такое сочетание имеет значение. Стоимость за принятую задачу, нагрузка на проверку, использование инструментов и восстановление после сбоев могут быть важнее, чем одно место в рейтинге.
Реальное послание Grok 4.5 просто: следующая гонка моделей — не только о том, кто умнее, но и о том, кто может предоставить полезный интеллект быстрее и дешевле.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



