For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 — это фронтирная модель, ориентированная на кодирование, агентов и работу со знаниями. Её основные практические преимущества — соче...
Grok 4.5 возвращает xAI в число лидеров в гонке моделей для программирования.
Выпущенная 8 июля 2026 года, модель предназначена для разработки программного обеспечения, агентных задач и более широкой интеллектуальной работы. Она была обучена с использованием Cursor и теперь доступна через xAI API, Grok Build и Cursor. Главная новость — не только качество модели. Grok 4.5 также позиционируется за счет более быстрой обработки, меньшего количества генерируемых токенов и сниженной стоимости за выполненную задачу.
В официальной документации модели указаны контекстное окно в 500 000 токенов, ввод текста и изображений, настраиваемые рассуждения, вызов функций, поддержка структурированных результатов и цены API: 2 доллара за миллион входных токенов и 6 долларов за миллион выходных токенов.
В этой статье объясняется, где Grok 4.5 показывает хорошие результаты, как следует интерпретировать заявления об эффективности, что изменилось в обучении и почему окружающий стек вывода может стать таким же важным, как сама модель.

Grok 4.5 — флагманская модель xAI для программирования, агентной работы и общих компьютерных интеллектуальных задач. В официальных материалах о запуске она описывается как модель, способная выполнять длительные задачи, использовать инструменты, исправлять ошибки и проверять результаты, а не останавливаться после одного ответа.
Это ставит ее в ту же широкую категорию, что и высококлассные модели, используемые для автономного программирования, изменений на уровне репозиториев, технических исследований, анализа данных и многоэтапных офисных рабочих процессов.
| Параметр | Grok 4.5 |
|---|---|
| Название модели | grok-4.5 |
| Основные случаи использования | Программирование, агентные задачи, интеллектуальная работа |
| Типы входных данных | Текст и изображения |
| Тип выходных данных | Текст |
| Контекстное окно | 500 000 токенов |
| Рассуждения | Настраиваемые |
| Вызов функций | Поддерживается |
| Структурированные результаты | Поддерживаются |
| Цена за вход | $2 за 1M токенов |
| Цена за кэшированный вход | $0,50 за 1M токенов |
| Цена за выход | $6 за 1M токенов |
| Заявленная скорость обработки | До 80 токенов в секунду |
| Доступность | xAI API, Grok Build, Cursor |
Контекстное окно в 500K токенов достаточно велико для больших баз кода, длинных технических документов, многофайловых исследований и длинных историй агентов. Большое контекстное окно автоматически не гарантирует лучших результатов, но дает инструментам больше возможностей для предоставления соответствующего исходного материала без агрессивного усечения.
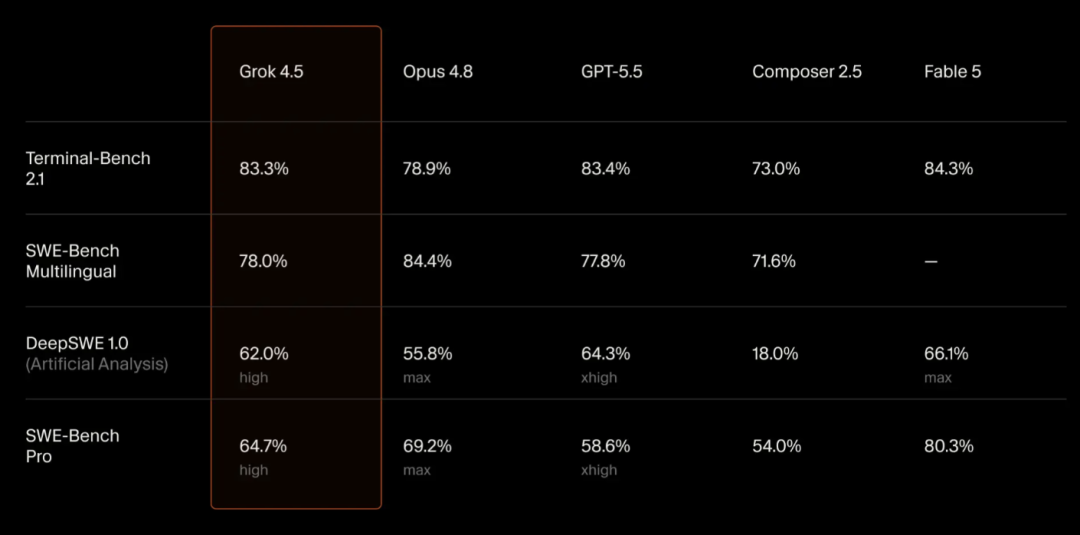
В официальном объявлении xAI публикуются результаты нескольких оценок по разработке ПО. Grok 4.5 не является лучшей моделью во всех бенчмарках, но остается конкурентоспособной с другими передовыми системами.
| Бенчмарк | Grok 4.5 | Избранные результаты сравнения |
|---|---|---|
| DeepSWE 1.0 | 62,0% | Fable max 66,1%; GPT-5.5 xhigh 64,31%; Opus 4.8 max 55,75% |
| DeepSWE 1.1 | 53,0% | Fable max 70%; GPT-5.5 xhigh 67%; |
Opus 4.8 max 59% |
| Terminal-Bench 2.1 | 83.3% | Fable max 84.3%; GPT-5.5 xhigh 83.4%; Opus 4.8 max 78.9% |
| SWE-Bench Pro | 64.7% | Fable max 80.4%; Opus 4.8 max 69.2%; Opus 4.7 max 64.3% |
| SWE Marathon | 29.0% | Opus 4.8 max 26.0%; Fable max 24.0%; Opus 4.7 max 16.0% |
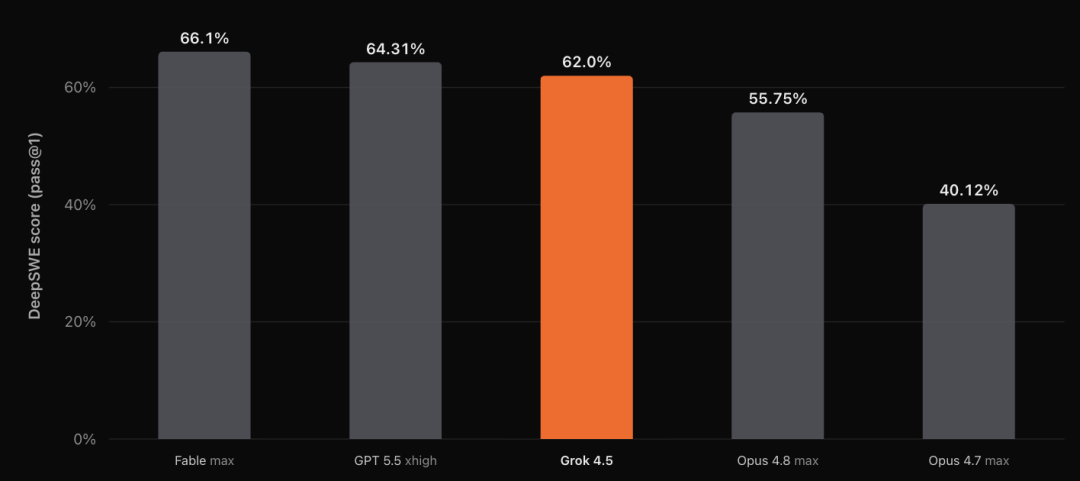
Эти цифры указывают на то, что модель особенно сильна в работе с терминалом, решении практических инженерных задач и длительных агентных процессах. Однако к ним следует относиться с осторожностью. На результаты могут влиять тестовые среды, настройки рассуждений, доступ к инструментам и конфигурации конкретных провайдеров.
Cursor также сообщил, что старая версия кодовой базы Cursor случайно попала в обучающие данные, что могло повлиять на CursorBench. Компания исключила этот бенчмарк из публичного сравнения и заявила, что эти данные не будут использоваться для будущих моделей.
Самое практическое утверждение относительно Grok 4.5 — это эффективность.
xAI заявляет, что модель обслуживается со скоростью до 80 токенов в секунду. Этого достаточно, чтобы длительные цепочки рассуждений, редактирование репозиториев и итеративные агентные циклы ощущались более отзывчивыми по сравнению с медленными премиальными моделями.
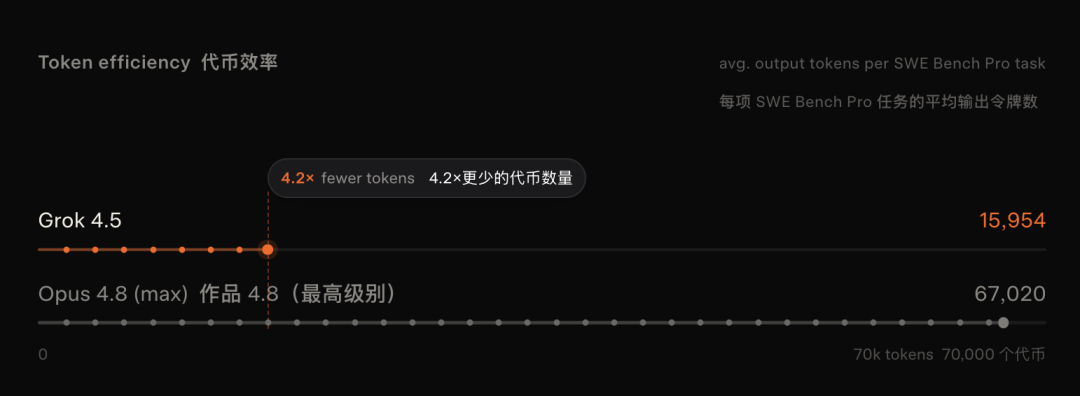
Компания также сообщает, что Grok 4.5 использовал в среднем 15 954 выходных токена на задачу SWE-Bench Pro, в то время как Opus 4.8 на максимальной настройке — 67 020 выходных токенов. Это примерно в 4,2 раза меньше выходных токенов на измеряемую рабочую нагрузку.
Эффективность токенов важна по трем причинам:
Важным показателем является не просто цена за миллион токенов. Командам следует сравнивать стоимость выполнения одной и той же задачи с приемлемым уровнем качества. Модель с более высокой заявленной ценой за токен может оказаться дешевле, если ей требуется меньше попыток, меньше вызовов инструментов или меньше
сгенерированные токены.
Базовая цена API составляет:
| Тип токена | Цена |
|---|---|
| Входные | $2 за 1 млн токенов |
| Кэшированные входные | $0.50 за 1 млн токенов |
| Выходные | $6 за 1 млн токенов |
Cursor также предлагает более быстрый вариант по цене $4 за миллион входных токенов и $18 за миллион выходных токенов в рамках собственного предложения моделей. Цены и доступность могут различаться в зависимости от платформы, поэтому производственным командам следует уточнить тариф в среде, которую они фактически используют.
Grok 4.5 призван делать больше, чем просто завершать функцию или объяснять ошибку. Официальные примеры включают:
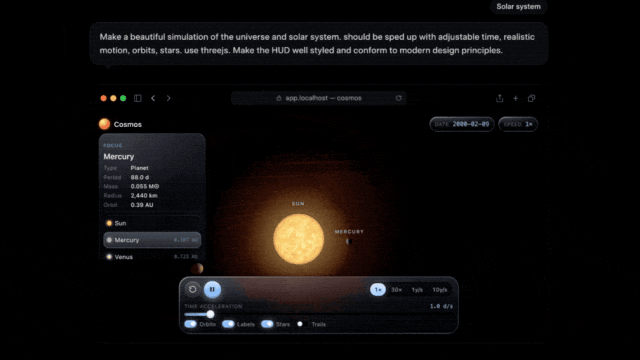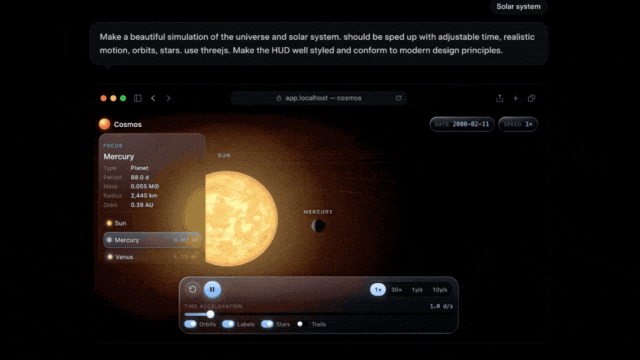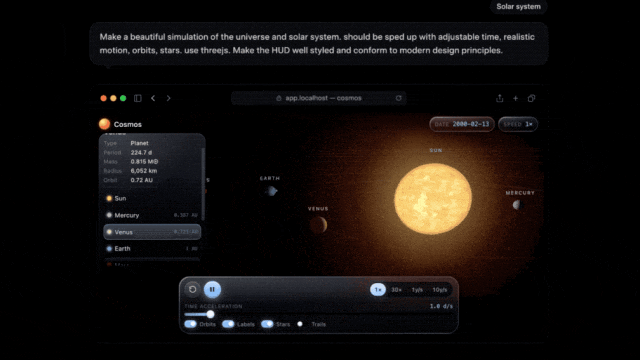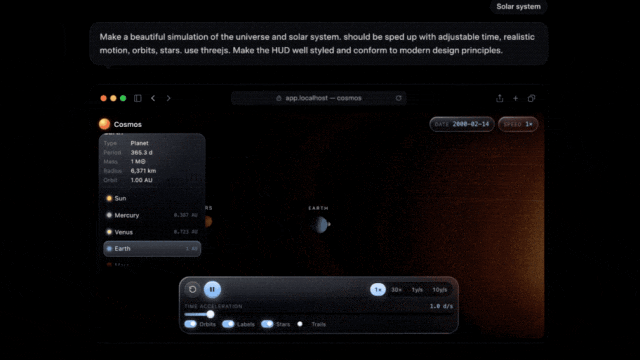
Демонстрация Солнечной системы полезна, поскольку она объединяет дизайн, фронтенд-код, 3D-рендеринг, элементы управления и логику взаимодействия. Это не является доказательством того, что любое приложение, созданное по одному запросу, будет готово к production, но это показывает тип комплексной задачи, для решения которой оптимизируется модель.
Grok 4.5 также распространяется на офисную работу. В анонсирующих материалах он создает структурированные слайды для бизнес-обзоров и работает с электронными таблицами, включающими формулы, веб-исследования и несколько листов.

Для команд разработчиков практический рабочий процесс может выглядеть следующим образом:
Модель может быть быстрой и способной, но при этом все равно порождать ошибочные предположения, небезопасные изменения или неполную валидацию. Наилучшее применение моделей для кодинга в роли агента — это обычно структурированная автоматизация с видимыми доказательствами, а не неограниченная автономия.
Повышение эффективности не представлено как простая оптимизация обслуживания. И xAI, и Cursor описывают изменения в архитектуре модели, подготовке данных, обучении с подкреплением и распределенном обучении.
Cursor описывает Grok 4.5 как экспертную модель на основе смеси (MoE). В системе MoE для каждого токена или задачи активируется только часть сети. Это позволяет увеличить общую ёмкость модели, не требуя участия всех параметров в каждом этапе вычислений.
Официальные источники не публикуют достаточно деталей реализации, чтобы точно рассчитать количество вычислений на токен. Поэтому корректнее сосредоточиться на измеряемых характеристиках — скорости, качестве бенчмарков и потреблении токенов, — чем строить предположения о производительности на основе неподтверждённого числа параметров.
xAI утверждает, что Grok 4.5 обучалась на десятках тысяч GPU NVIDIA GB300. Обучение в таком масштабе требует не только мощного оборудования. Длительные сессии нуждаются в стабильных распределённых системах, восстановлении после контрольных точек, сетевой инфраструктуре, конвейерах данных и мониторинге, способном поддерживать продуктивность тысяч ускорителей.
В анонсе подчёркиваются методы обеспечения стабильности, разработанные для масштабных процессов обучения. Это важно, так как сбой в длительном эксперименте может привести к значительным потерям вычислительных ресурсов, если система не способна эффективно восстанавливаться.
Конвейер обучения включал:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Цель — повысить плотность полезных обучающих сигналов, а не полагаться исключительно на сырой объём токенов. Повторяющиеся, некачественные или слабо релевантные данные могут увеличить затраты на обучение, не давая такого же прироста, как тщательно отобранные примеры.
Cursor сообщает, что модель обучалась на триллионах токенов данных Cursor. По данным компании, набор данных включает взаимодействия пользователей, кодовых баз, программных инструментов и агентов.
Это различие важно. База кода обучает синтаксису, шаблонам, библиотекам и типовым реализациям. Данные взаимодействий позволяют также изучать последовательность работы:
Это объясняет, почему Grok 4.5 позиционируется для задач программной инженерии, а не просто для изолированного автодополнения кода.
xAI заявляет, что программа обучения с подкреплением охватывает сотни тысяч задач, с акцентом на многоэтапную программную инженерию и другие технические виды деятельности.
Cursor описывает среды, которые обучают модель:
Компании также создали распределённые системы агентов для массовой генерации, тестирования и совершенствования этих сред обучения. Некоторые запуски агентов могут длиться часами, в то время как более масштабный процесс обучения продолжается асинхронно.
Это существенное изменение по сравнению с узкой оптимизацией под бенчмарки. Модель обучается не только давать правильный конечный ответ, но и проходить путь, который к нему приводит.
Обращение к одному.
Веса модели — лишь одна из составляющих конечного продукта.
В публичном заявлении Илон Маск сообщил, что Grok 4.5 ещё не использует внутреннее программное обеспечение для инференса на C/C++, разработанное xAI специально для оборудования GB300. Он предположил, что оптимизированный стек потенциально может удвоить скорость обработки или даже улучшить её.
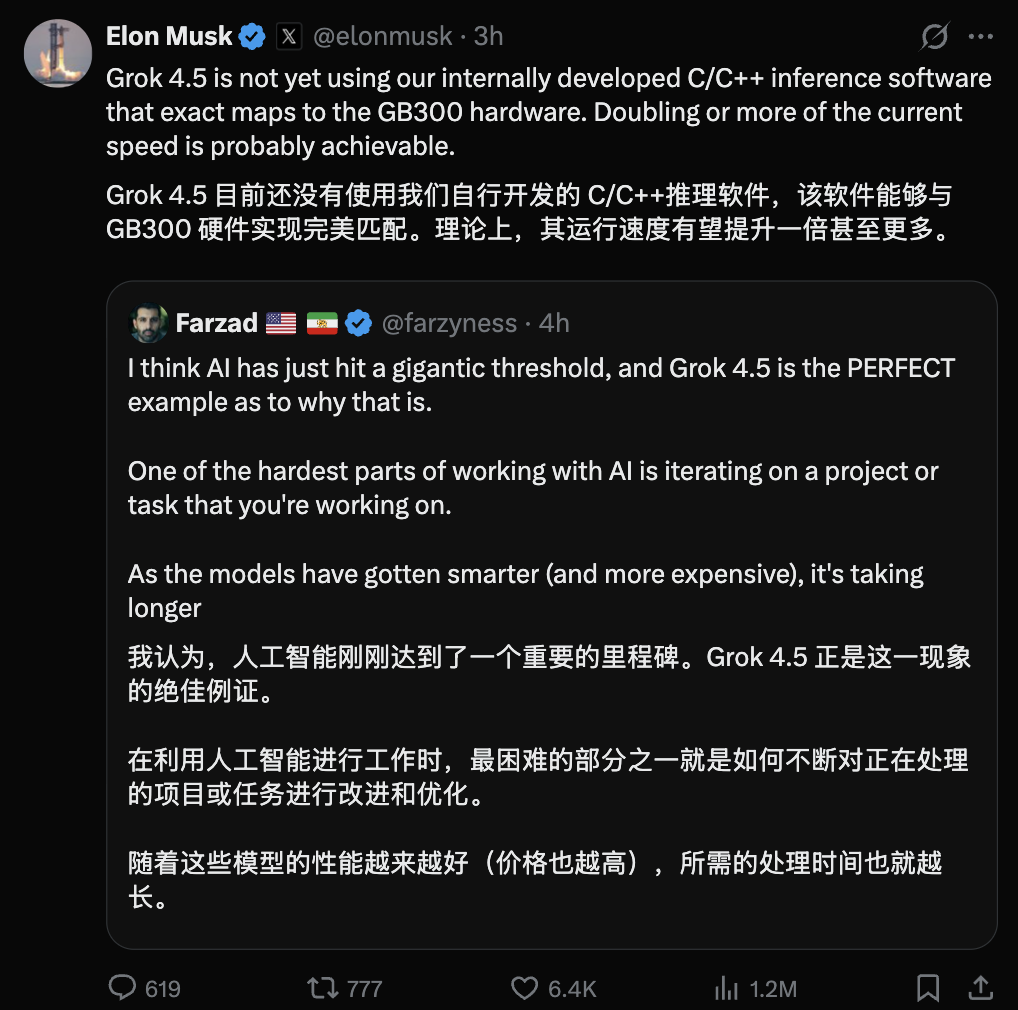
Это скорее перспективное заявление, а не подтверждённый производственный результат, поэтому не следует воспринимать его как гарантированную производительность. Тем не менее, оно указывает направление, в котором движется конкуренция моделей.
Когда ведущие модели становятся сопоставимы по качеству бенчмарков, окружающая система может создать практическое преимущество:
Для пользователей это означает, что сравнение моделей должно включать не только показатель интеллекта. Модель, которая отвечает быстрее, генерирует меньше токенов, эффективно использует кэширование и выполняет задачи с меньшим количеством повторов, может обеспечить лучшую практическую ценность, даже если другая модель лидирует в бенчмарке.
Grok 4.5 доступен через Responses API от xAI. В следующем примере на Python используется интерфейс клиента, совместимый с OpenAI:
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("Сначала задайте переменную окружения XAI_API_KEY.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "Проверьте эту функцию JavaScript, исправьте ошибку "
        "и объясните изменение: "
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
Перед использованием модели в production:
Grok 4.5 — это ведущая модель xAI для программирования, агентных задач и интеллектуальной работы. Она поддерживает ввод текста и изображений, настраиваемое рассуждение, вызов функций и структурированные выходные данные.
Официальная документация xAI указывает контекстное окно в 500 000 токенов. Фактический используемый контекст может зависеть от формата запроса, вывода инструментов и ограничений платформы.
Опубликованная базовая цена составляет 2 доллара за
миллион входных токенов — $0,50 за миллион кэшированных входных токенов и $6 за миллион выходных токенов. Платформенные варианты или приоритетное обслуживание могут использовать другие тарифы.
Ответ зависит от теста и рабочего процесса. Grok 4.5 конкурентоспособен в нескольких инженерных тестах и лидирует в некоторых сравнениях, в то время как другие модели остаются впереди в других. Скорость, использование токенов, надежность инструментов и стоимость выполнения задач следует оценивать вместе с результатами тестов.
xAI сообщает, что Grok 4.5 в среднем использовал 15 954 выходных токена на задачу SWE-Bench Pro, по сравнению с 67 020 для Opus 4.8 при максимальных настройках. Это примерно в 4,2 раза меньше выходных токенов для измеряемой нагрузки.
Да. На официальной странице модели указаны ввод текста и изображений с выводом текста. Это делает его подходящим для таких задач, как анализ скриншотов, проверка документов и визуальный контекст в рамках агентного рабочего процесса.
Да. Cursor сообщает, что Grok 4.5 доступен на десктопе, вебе, iOS, CLI и через SDK. Лимиты использования и цены зависят от выбранного плана Cursor.
Его можно использовать в качестве модели рассуждений внутри производственного агента, но окружающая система все равно требует контроля разрешений, валидации, наблюдаемости, повторных попыток и одобрения человека для действий с высоким влиянием. Сильные результаты тестов не отменяют необходимости операционных мер безопасности.
Grok 4.5 — это передовая модель, нацеленная на программирование, агентов и интеллектуальную работу. Ее самые сильные практические преимущества —
сочетание высоких инженерных характеристик, обработки до 80 токенов в секунду, окна контекста в 500 тысяч токенов и сниженного потребления токенов в опубликованном сравнении SWE-Bench Pro.
Метод обучения объединяет крупномасштабную инфраструктуру, тщательно отобранные данные, следы взаимодействия с Cursor и обучение с подкреплением в реалистичных средах использования инструментов. Это помогает перевести модель от изолированной генерации кода к более длинным сквозным рабочим процессам.
Главная история не только в том, что Grok стал более способным; дело в том, что xAI конкурирует по полной стоимости и скорости выполнения реальной работы.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



