For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
Стартап Янна ЛеКуна в области мировых моделей, **Advanced Machine Intelligence (AMI)**, опубликовал один из своих первых крупных исследовате...
Стартап Янна ЛеКуна в области мировых моделей, Advanced Machine Intelligence (AMI), опубликовал один из своих первых крупных исследовательских результатов.
В статье H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning исследователи из AMI, Нью-Йоркского университета, INRIA Paris и Brown University представляют иерархическую мировую модель, построенную на основе нескольких JЕPA, обусловленных действиями.
Основная идея проста: вместо того чтобы заставлять одно латентное представление одновременно отвечать за непосредственное управление движением и долгосрочное планирование, H-JEPA задаёт разным уровням и разные временные масштабы, и разные пространства представлений.
Верхние уровни смотрят дальше в будущее и планируют на более грубом уровне. Их предсказанные промежуточные состояния становятся подцелями для нижних уровней, которые постепенно уточняют их, пока система не перейдёт к исполнимым действиям.
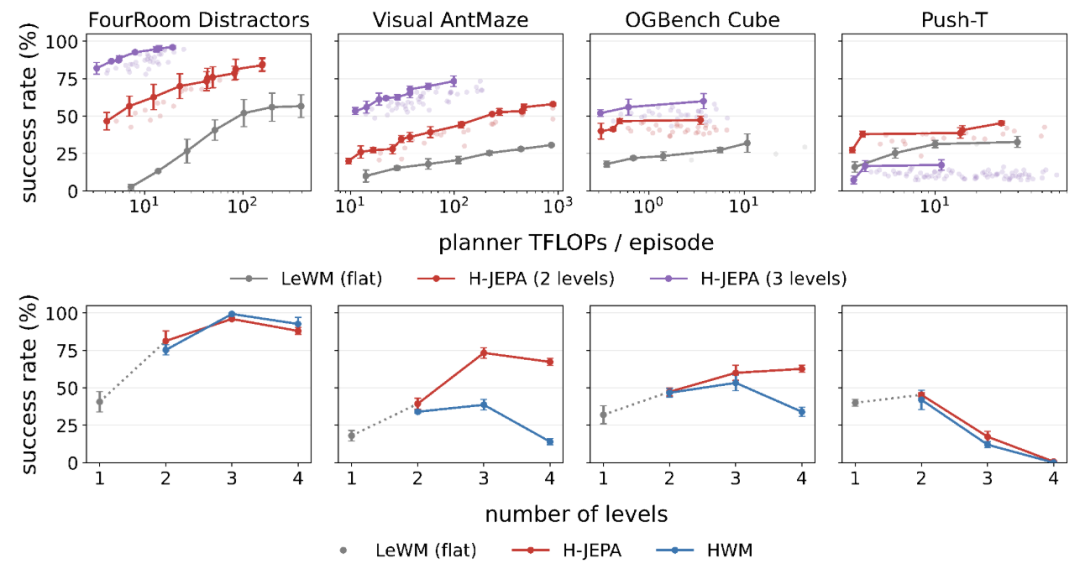
В Visual AntMaze трёхуровневая H-JEPA достигает примерно 73,3% успеха планирования по сравнению с 18,0% у плоской базовой модели LeWorldModel, одновременно демонстрируя более эффективный компромисс между успешностью и вычислительными затратами.
Проект продолжает направление открытых исследований, которое AMI подчёркивает с момента запуска. Авторы опубликовали код обучения и оценки, предварительно обученные контрольные точки и вспомогательные наборы данных.
Официальный репозиторий на GitHub распространяется по лицензии MIT. Опубликованный на Hugging Face репозиторий контрольных точек H-JEPA также отмечен лицензией MIT, а сопутствующий репозиторий набора данных выпущен по лицензии CC BY 4.0.
ЛеКун на протяжении многих лет выступает за иерархическое планирование.
Лежащая в его основе интуиция похожа на то, как люди планируют сложные задачи в реальном мире.
Представьте, что вы сидите в офисе Нью-Йоркского университета и решаете отправиться в Париж.
На самом высоком уровне важны место назначения, рейс и расписание. После принятия этого решения следующий уровень становится конкретнее: выйти из офиса, спуститься вниз, добраться до аэропорта и сесть на самолёт.
На самом нижнем уровне внимание снова переключается. Для спуска по лестнице нужна информация о поверхности, следующей ступеньке и движении тела. Детали, которые были несущественны при выборе трансатлантического рейса, внезапно становятся критически важными.
Та же проблема возникает в робототехнике.
Планировщик высокого уровня должен понимать цель задачи, пространственные взаимосвязи и долгосрочное направление движения. Контроллер низкого уровня нуждается в точной информации о непосредственном движении и конфигурации тела.
Если одно представление должно сохранять все детали на каждом временном масштабе, планирование становится неоправданно сложным.
Например, четвероногий робот может уже находиться в нужном месте, хотя положение его ног отличается от целевого изображения. Представление, которое чрезмерно акцентирует быстро меняющиеся детали положения ног, может ошибочно решить, что робот находится далеко от цели, несмотря на то что его положение, значимое для задачи, уже корректно.
Статья H-JEPA рассматривает эту проблему через более конкретный вопрос:
Может ли каждый уровень изучить информацию, важную для его собственного временного масштаба, и при этом обеспечить перевод плана высокого уровня в действия низкого уровня?
H-JEPA назначает каждому уровню иерархии три основных компонента:
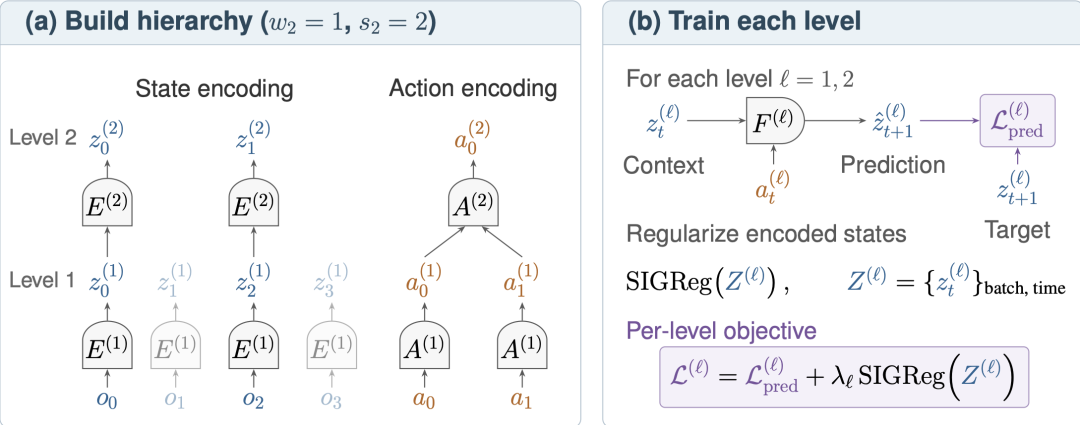
Кодировщик состояния извлекает латентное представление среды.
На нижнем уровне кодировщик работает непосредственно с визуальными наблюдениями. Верхние уровни получают представления нижних уровней и последовательно изучают всё более абстрактные версии состояния.
Это позволяет верхним уровням отбрасывать детали, которые быстро меняются, плохо предсказываются на длинных горизонтах или не имеют значения для долгосрочного планирования.
В экспериментах Visual AntMaze верхние уровни всё сильнее подавляют информацию о положении ног муравья, сохраняя при этом информацию о положении муравья и структуре лабиринта.
Именно такую абстракцию и должна изучать иерархия.
Кодировщик действий описывает эффект действий на каждом временном масштабе.
На нижнем уровне действия соответствуют относительно конкретным изменениям управления. На верхних уровнях несколько действий нижнего уровня сжимаются в более грубое представление того, как состояние изменяется за более длительный период.
Это даёт каждому слою собственное временное разрешение.
В описанной конфигурации один шаг предсказания на более высоком уровне охватывает больше шагов среды, чем уровень ниже него.
Предиктор объединяет текущее латентное состояние и закодированное действие, чтобы оценить будущее латентное состояние.
Таким образом, каждый уровень изучает собственную мировую модель, обусловленную действиями.
Ключевое отличие от плоской мировой модели заключается в том, что H-JEPA не требует от каждого уровня предсказывать состояние в одном общем латентном пространстве.
Вместо этого каждому уровню разрешено формировать представление, соответствующее его собственному горизонту.
Во время вывода планирование движется сверху иерархии вниз.
Сначала верхний уровень ищет грубый путь к конечной цели.
Предсказанное им промежуточное состояние затем становится подцелью для уровня ниже. Этот нижний уровень ищет более точный план, который достигает назначенной подцели, и процесс продолжается до тех пор, пока нижний уровень не выдаст примитивные действия.
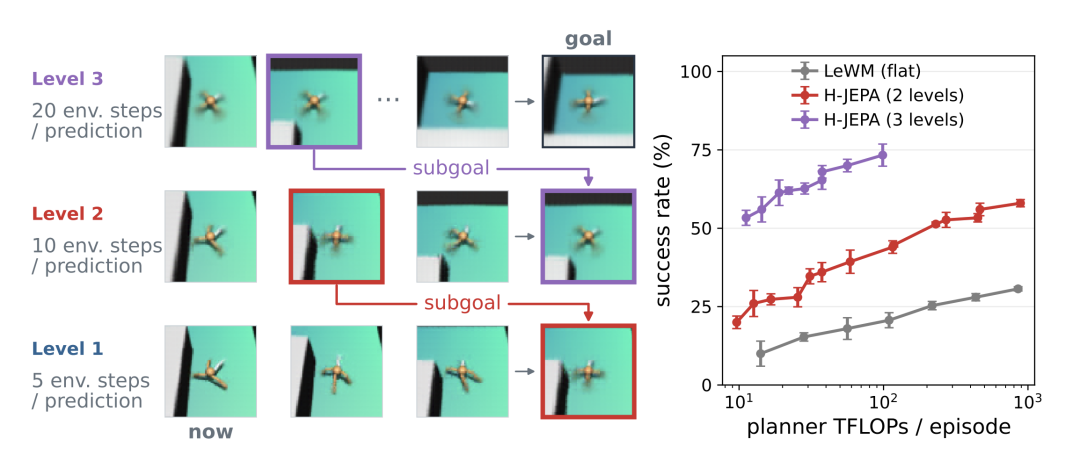
Так формируется процесс планирования от общего к частному:
После выполнения префикса действий система наблюдает новое состояние и планирует заново.
Такое повторное планирование позволяет иерархии реагировать на фактическую среду, а не придерживаться одного длинного плана без обратной связи.
Иерархия обучается сквозным образом.
Это означает, что уровни не обучаются как изолированные модули. Целевые функции верхних уровней могут влиять на кодировщики нижних уровней, позволяя всей иерархии представлений формироваться совместно.
Однако обучение мировых моделей подвержено классическому сбою: коллапсу представлений.
Если кодировщик отображает каждое входное состояние в один и тот же латентный вектор, предиктор может тривиально выдавать тот же вектор и получать низкую ошибку предсказания, не изучая ничего полезного о среде.
H-JEPA решает эту проблему с помощью SIGReg, или Sketchеd Isotropic Gaussian Regularization — изотропной гауссовой регуляризации на основе скетчей, предложенной ранее в работе LeJEPA Рэндаллом Балестриеро и Янном ЛеКуном.
SIGReg ограничивает распределение латентных представлений, чтобы разные наблюдения не схлопывались в одно и то же представление.
Предыдущая модель LeWorldModel применяла этот тип регуляризации к сквозному обучению мировой модели на основе пикселей. H-JEPA использует LeWorldModel как основу нижнего уровня, а затем добавляет над ней дополнительные уровни JEPA.
Это сохраняет основной принцип JEPA: предсказывать полезные представления будущего, а не реконструировать каждый будущий пиксель.
В статье H-JEPA оценивается в четырёх симулированных средах навигации и манипуляции:
Кроме того, оценивается офлайн-планирование на траекториях реального робота из набора данных DROID.
Visual AntMaze демонстрирует наиболее явное преимущество иерархии.
Согласно официальному репозиторию, трёхуровневая H-JEPA достигает 73,3% успеха планирования по сравнению с 18,0% у плоской базовой модели LeWorldModel.
Иерархия также улучшает компромисс между долей успешных решений и вычислительными затратами планировщика.
Это важно, поскольку иерархический планировщик полезен только в том случае, если добавление уровней не делает планирование чрезмерно дорогим.
В других симулированных средах иерархия также превосходит плоскую базовую модель, однако более глубокая структура не всегда лучше.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
В исходной статье Push-T выделяется как важный контрпример: двухуровневая модель работает лучше плоской базовой модели, тогда как добавление третьего или четвёртого уровня может снизить производительность.
Авторы статьи частично связывают это с длиной задач. Более короткие траектории дают меньше значимых примеров для очень высоких уровней, работающих на длинных горизонтах.
Это указывает на важное ограничение:
Иерархия полезна, когда задача действительно содержит структуру на нескольких временных масштабах. Механическое добавление уровней не гарантирует повышения производительности.
Данные о реальных роботах создают ещё одну проблему представлений.
В разнообразных видео чисто предсказательная целевая функция может уделять слишком много внимания стабильной информации о фоне, поскольку фон легко предсказывать. Движущийся робот, который на самом деле важен для управления, может получить меньше ёмкости представления.
Чтобы решить эту проблему, в экспериментах с DROID исследователи добавляют обучение на основе обратной динамики.
Модель обучается не только предсказывать будущие латентные состояния, но и определять действие, связывающее последовательные латентные состояния.
Это побуждает представление сохранять информацию о движении робота и управляемом состоянии.
На странице проекта H-JEPA сообщается, что изученный второй уровень повышает точность офлайн-планирования по сравнению с плоской базовой моделью и одновременно снижает вычислительные затраты планировщика.
Оценка DROID проводится офлайн: в статье сравниваются предсказанные траектории концевого эффектора с экспертными траекториями, а не заявляется успех задач реального робота в замкнутом контуре.
Это различие важно учитывать при интерпретации результатов.
Авторы опубликовали реализацию H-JEPA на GitHub.
Официальный репозиторий содержит код обучения и планирования для:
В нём также доступны скрипты для воспроизведения отдельных рисунков и таблиц из статьи.
Репозиторий контрольных точек на Hugging Face в настоящее время включает предварительно обученные модели плоской LeWorldModel, двух-, трёх- и четырёхуровневых вариантов H-JEPA, а также базовые модели HWM с общим пространством представлений для симуляционных задач и контрольные точки DROID.
Сопутствующий репозиторий набора данных H-JEPA содержит симуляционные данные, задачи оценки планирования, наборы данных для зондирования и данные, связанные с DROID, необходимые для опубликованного релиза.
Это делает работу чем-то большим, чем демонстрация только в статье: исследователи могут изучить реализацию, загрузить обученные модели и попытаться воспроизвести заявленные результаты планирования.
H-JEPA продолжает общее исследовательское направление, которое ЛеКун продвигает уже много лет.
JEPA расшифровывается как Joint-Embedding Predictive Architecture, или архитектура предсказания совместных вложенных представлений.
Стандартная языковая модель обучается, предсказывая будущие токены. Визуальная JEPA вместо этого изучает представления наблюдений и предсказывает целевые представления в латентном пространстве.
В мировых моделях, таких как H-JEPA, в процесс добавляются действия, чтобы модель могла предсказывать, как её внутреннее представление мира изменяется после выполнения действия.
Затем планировщик может сравнивать предсказанные последствия разных действий и искать путь к цели.
Это отражает давнюю позицию ЛеКуна: интеллект требует большего, чем генерация языка. Согласно его исследовательской программе, системы должны понимать мир, предсказывать последствия действий, помнить релевантное состояние и планировать во времени.
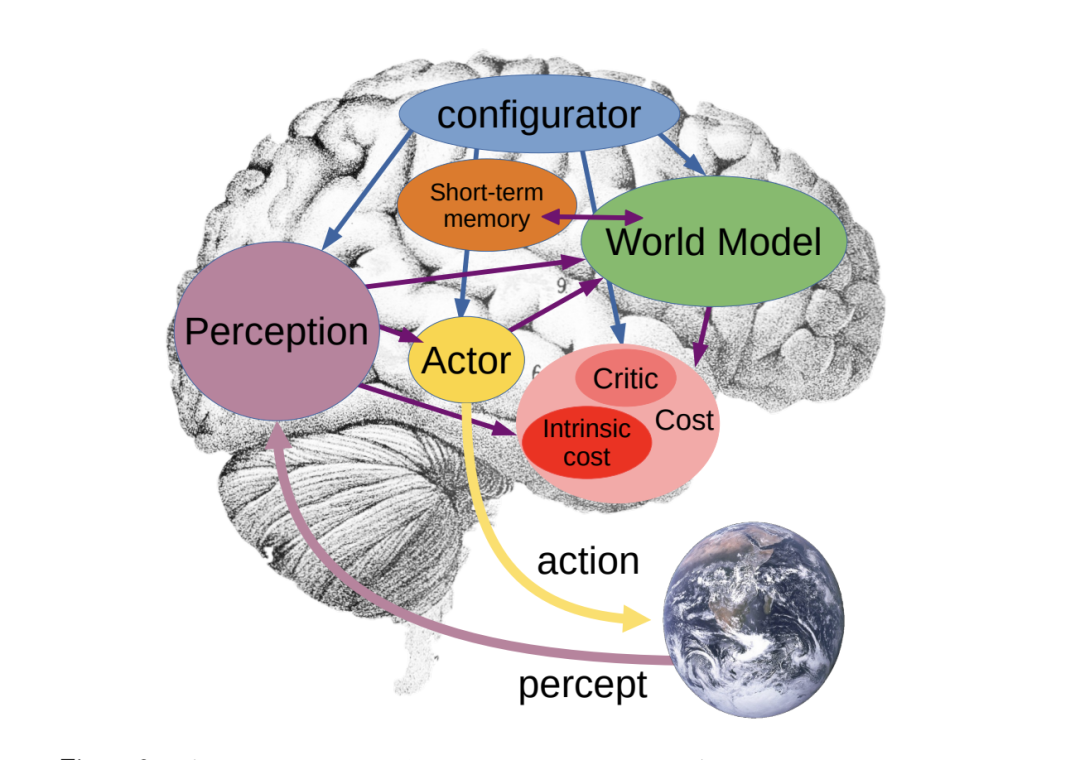
В исходной статье также упоминается неоднократная критика ЛеКуном идеи о том, что одного масштабирования больших языковых моделей обязательно будет достаточно для достижения интеллекта человеческого уровня. При этом он признавал, что инструменты на базе больших языковых моделей чрезвычайно полезны на практике.
Поэтому H-JEPA лучше понимать не как попытку немедленно заменить все языковые модели, а как конкретный эксперимент с альтернативной архитектурой, которую продвигает ЛеКун.
Теперь это исследовательское направление стало частью бизнес-стратегии AMI.
Согласно Reuters и другим публикациям того же периода, в марте 2026 года AMI привлекла 1,03 млрд долларов при оценке 3,5 млрд долларов до привлечения инвестиций.
В руководящую команду компании входят:
Майкл Раббат также является одним из авторов статьи H-JEPA.
AMI описывает свою цель как создание систем, которые понимают мир, поддерживают постоянную память, рассуждают и планируют, а также остаются управляемыми и безопасными.
На момент публикации исходной статьи BAAI компания по-прежнему представляла себя преимущественно через исследования, команду и набор сотрудников, а не через широко доступный публичный продукт.
Поэтому H-JEPA важна ещё и потому, что предоставляет конкретный технический результат, связанный с тезисом стартапа о мировых моделях.
В заключении исходного материала AMI сравнивается с другой известной компанией в области мировых моделей — World Labs, основанной Фэй-Фэй Ли.
28 сентября 2026 года AMD объявила о заключении окончательного соглашения о приобретении World Labs.
В документации AMD, поданной в SEC, стоимость сделки с оплатой исключительно акциями оценивается примерно в 8,2 млрд долларов с учётом обычных корректировок.
Компании выбрали разные организационные пути, но обе отражают растущую важность мировых моделей, пространственного интеллекта, робототехники, симуляции и физического ИИ.
AMI продолжает развивать собственную исследовательскую программу иерархических предсказательных моделей, тогда как World Labs движется к интеграции с крупной компанией в сфере вычислительных ресурсов для ИИ.
Для H-JEPA непосредственный вопрос носит скорее технический, чем корпоративный характер: насколько далеко иерархическое планирование в латентном пространстве сможет масштабироваться от симулированного управления и офлайн-видео роботов к более сложным замкнутым системам реального мира?
Это следующий тест архитектуры.
H-JEPA — это сквозная иерархическая мировая модель для визуального планирования. Она объединяет несколько JEPA, обусловленных действиями, чтобы верхние уровни предсказывали более отдалённое будущее и передавали латентные подцели нижним уровням.
Плоская мировая модель использует одно представление и один временной масштаб планирования. H-JEPA изучает отдельные латентные пространства на нескольких временных масштабах, позволяя верхним уровням сосредоточиться на медленно меняющейся структуре, значимой для задачи, а нижним уровням сохранять детали, необходимые для управления.
Официальный репозиторий на GitHub сообщает примерно о 73,3% успеха планирования для трёхуровневой H-JEPA против 18,0% у плоской базовой модели LeWorldModel. Иерархия также обеспечивает более эффективный компромисс между успешностью и вычислительными затратами планировщика.
SIGReg расшифровывается как Sketched Isotropic Gaussian Regularization. Она была представлена в LeJEPA для ограничения распределений латентных представлений и предотвращения коллапса представлений, при котором кодировщик отображает множество различных состояний почти в одно и то же вложенное представление.
Да. Официальный релиз кода на GitHub распространяется по лицензии MIT, а предварительно обученные контрольные точки доступны на Hugging Face. Связанный репозиторий набора данных H-JEPA опубликован по лицензии CC BY 4.0.
В статье подход расширяется на разнообразные видео с реальными роботами из DROID с использованием обучения на основе обратной динамики. Эти эксперименты оценивают точность офлайн-планирования, а не полноценный успех задач робота в замкнутом контуре, поэтому их не следует преувеличенно трактовать как автономное применение в реальном мире.
Нет. Статья показывает, что более глубокие иерархии помогают, когда задача содержит значимую структуру на нескольких временных масштабах, но очень глубокие иерархии могут ухудшать результаты на более коротких задачах, таких как Push-T, поскольку верхние уровни могут получать слишком слабый полезный обучающий сигнал.
Она продолжает концепцию JEPA и мировых моделей ЛеКуна: изучать компактные представления мира, предсказывать будущие латентные состояния вместо каждого пикселя и использовать эти предсказания для планирования. H-JEPA добавляет явную иерархию, чтобы разные уровни могли работать на различных временных масштабах и уровнях абстракции.
H-JEPA превращает идею мировой модели JEPA в явную иерархию планирования. Верхние уровни работают на более длинных горизонтах и с более абстрактными представлениями, а нижние уровни переводят эти планы во всё более конкретные подцели и действия.
Самый сильный результат наблюдается в Visual AntMaze: трёхуровневая H-JEPA достигает примерно 73% успеха планирования против 18% у плоской базовой модели LeWorldModel и одновременно повышает эффективность планирования. Работа также показывает, что иерархия не является автоматически полезной: от временного масштаба задачи и доступности данных зависит, принесут ли дополнительные уровни пользу.
Проект отличается необычно высокой воспроизводимостью для недавно опубликованной исследовательской работы: код, контрольные точки и наборы данных уже доступны публично.
Главный вклад H-JEPA заключается не просто в более высоком результате в лабиринте, а в конкретной демонстрации того, что мировые модели могут выигрывать от изучения разных представлений для разных горизонтов планирования.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



