For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness², также обозначаемый как Harness2, исследует практическую форму рекурсивного улучшения: изменение программной среды вокруг зафиксиро...
Harness², также обозначаемый как Harness2, исследует практическую форму рекурсивного улучшения: изменение программной среды вокруг зафиксированной языковой модели. Редактируемая среда выполнения включает промпты, защитные ограничения, память, навыки, инструкции по работе с инструментами, скрипты, субагентов и промежуточное программное обеспечение.
Исследование выполнено специалистами Google Cloud AI Research и Северо-Западного университета. Вместо обучения новой модели после каждой ошибки система изучает выполнение агентом задачи, тестирует изменения его оболочки и сохраняет сведения о том, какие изменения помогли.
Авторы сообщают, что один шаг улучшения повышает средний результат GLM-5 на WorkBuddy-Bench с 64,2 до 75,7 при использовании OpenCode. Это прирост на 11,5 балла в рамках конкретной оценки, а не улучшение, гарантированное для любой модели или приложения.
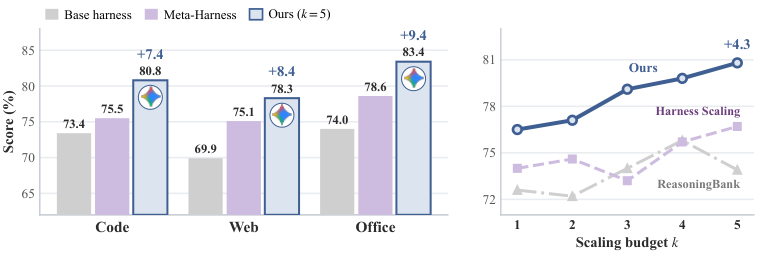
Рисунок исследовательской команды, воспроизведенный в отчете QbitAI/BAAI.
В основе работы лежат две проблемы.
Harness2 отделяет оболочку выполнения текущей задачи от процесса ее улучшения. Следующая задача начинается с общей базовой оболочки; система улучшения выборочно использует предыдущие данные, а не бездумно переносит все прежние правила.
Сначала система записывает эталонное выполнение с использованием исходной оболочки. Затем она применяет эту трассировку, чтобы выявить слабые места и протестировать возможные исправления.
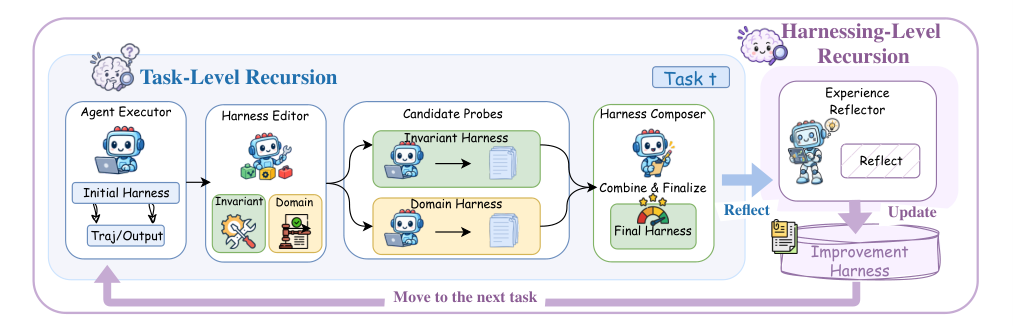
Этап улучшения состоит из трех стадий:
Сравнение поведения заменяет недоступную эталонную обратную связь во время адаптации. Оно не является безошибочным механизмом проверки окончательной корректности. Внешняя оценка на бенчмарках по-прежнему важна для измерения эффективности метода.
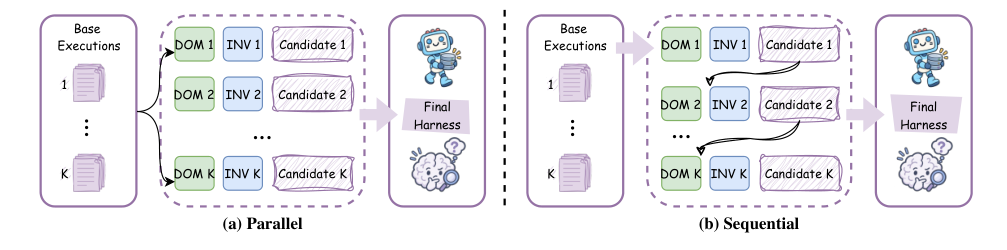
Метод может исследовать больше вариантов с помощью параллельной рекурсии или выполнять последовательные доработки с помощью последовательной рекурсии. При параллельном бюджете k он проверяет k общих и k предметных кандидатов, а затем создает k комбинаций. Большее число кандидатов требует больше вычислений.
После выполнения задачи отражатель опыта изучает эталонную трассировку, предложенные изменения, результаты проверки и решения по объединению. Он записывает повторно используемые компоненты и выводы, в том числе заметки в EXPERIENCE.md.
Следующая задача получает базовую оболочку выполнения, но процесс редактирования может извлекать эти прежние выводы. Сохраняется знание о том, когда исправление полезно, а не предположение, что полная конфигурация предыдущей задачи должна стать постоянной.
Параметры модели остаются неизменными. Это адаптация среды выполнения с помощью файлов и данных выполнения, а не демонстрация автономного обучения весов модели.
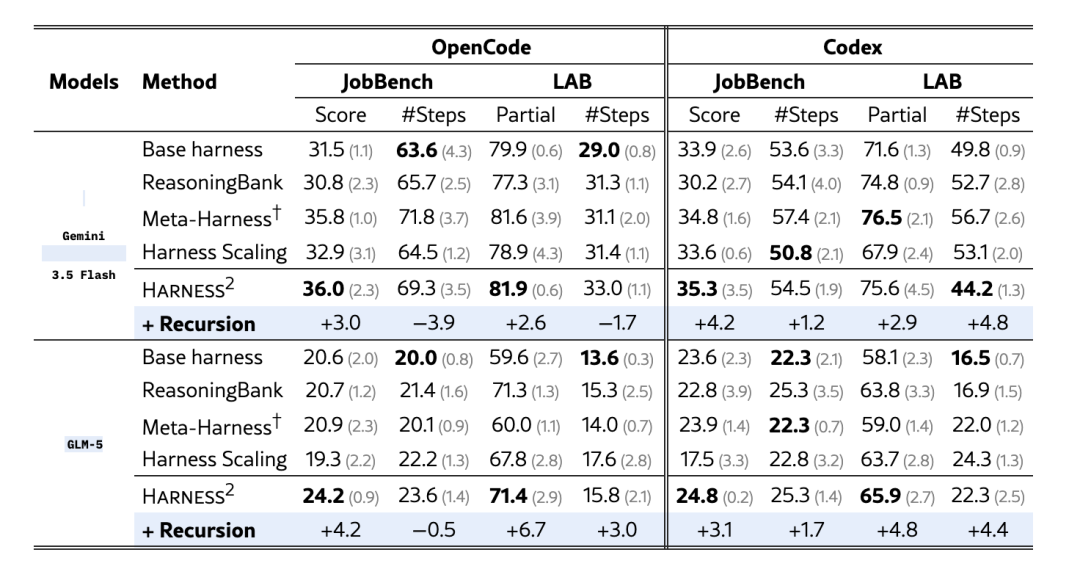
В исследовании оцениваются результаты WorkBuddy-Bench по программированию, веб-задачам и офисным документам, профессиональные задачи JobBench и бенчмарк юридических агентов Harvey. Используются GLM-5 и Gemini 3.5 Flash с OpenCode и Codex в качестве оболочек выполнения.
Редактором по умолчанию является Claude Opus 4.8 в OpenCode. Поэтому ключевые результаты относятся к системе улучшения, работающей вокруг исполнителя; их не следует описывать как бесплатное увеличение возможностей самого исполнителя.
| Модель-исполнитель | Исходная оболочка | Средний базовый результат WorkBuddy | Один шаг Harness2 | Прирост |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64,2 | 75,7 | 11,5 балла |
| GLM-5 | Codex | 64,4 | 75,3 | 10,9 балла |
| Gemini 3.5 Flash | OpenCode | 72,4 | 77,5 | 5,1 балла |
| Gemini 3.5 Flash | Codex | 74,5 | 77,5 | 3,0 балла |
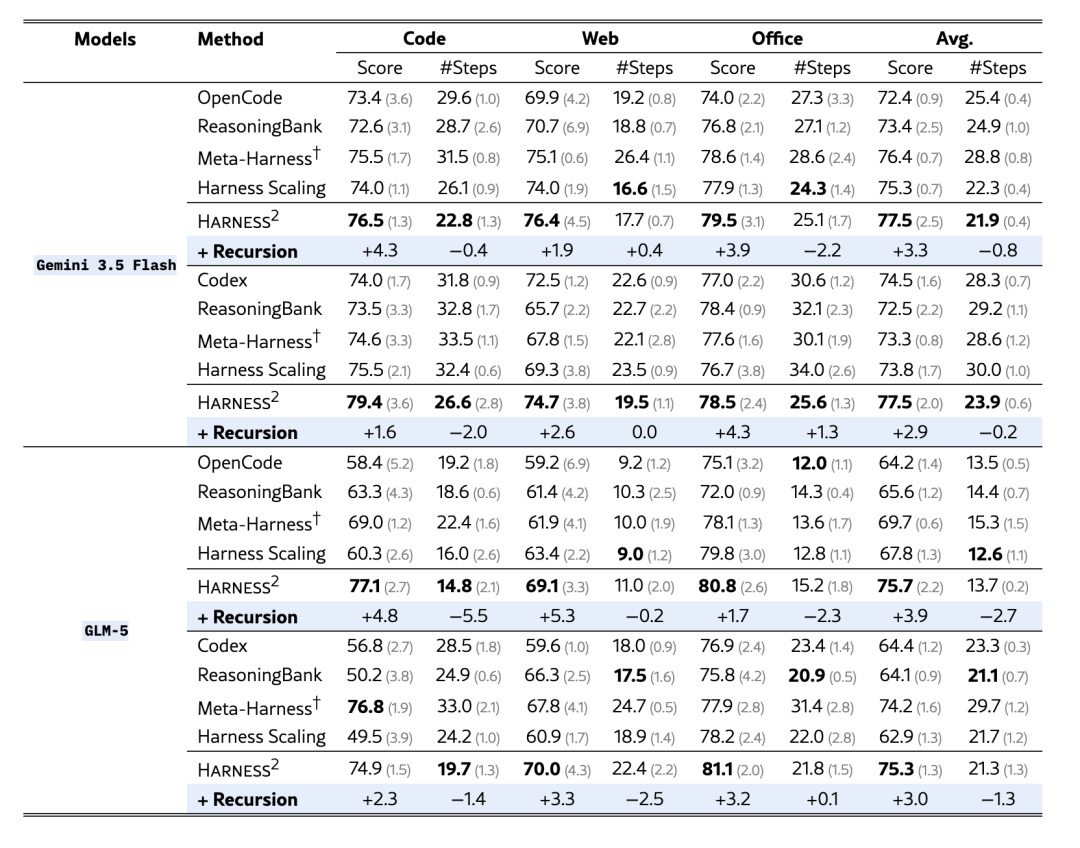
В этом сравнении GLM-5 с улучшенной оболочкой превосходит соответствующий базовый результат немодифицированной Gemini. Это показывает, что дизайн среды выполнения может влиять на рейтинг моделей; однако это не доказывает, что GLM-5 сильнее на каждой задаче.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
В статье сообщается о приросте до 4,5 балла за один шаг на JobBench и до 11,8 процентного пункта на LAB Partial, то есть по доле пройденных отдельных критериев. Partial отличается от доли задач, удовлетворяющих всем критериям.
Увеличение параллельного бюджета до k=5 дает дополнительно до 3,9 балла WorkBuddy, 4,2 балла JobBench и 6,7 процентного пункта LAB Partial по сравнению с одним шагом. В основных таблицах приведены средние значения и стандартные отклонения по трем запускам с перемешанным порядком задач.
Полезен также эксперимент с переносом. Библиотека, накопленная на JobBench, повышает результат одношагового улучшения WorkBuddy на 0,6 балла в программировании, 0,5 балла в веб-задачах и 2,9 балла в офисных задачах без дополнительных проверок в рамках этого сравнения.
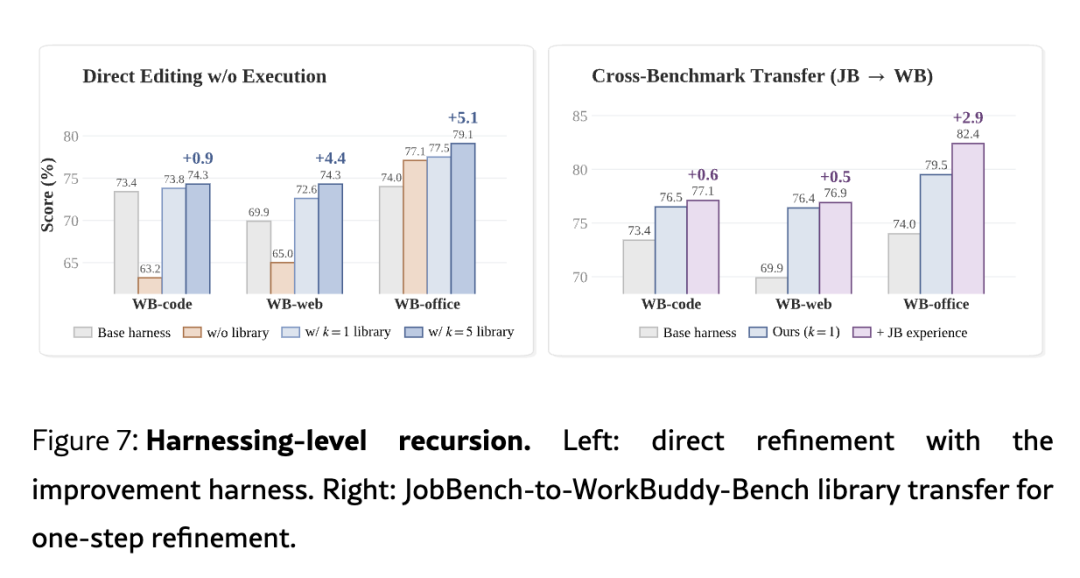
Эти результаты подтверждают ценность выборочного повторного использования опыта улучшений. Они не показывают, что каждое накопленное правило переносится, и не отменяют необходимость проверять принятую оболочку на фактическом распределении задач.
В статье указаны девять авторов: Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee и Tomas Pfister. В исходных профилях Xu представлен как докторант Северо-Западного университета, а Chen и CuiZhu — как исследователи Google Cloud.
Публичный репозиторий поддерживает обе оболочки выполнения и оба режима рекурсии. В нем указаны Linux, Python 3.12 и uv; бенчмарки с использованием моделей имеют дополнительные зависимости и требуют оплаты API. Для WorkBuddy необходим Docker, а LAB требует такие инструменты, как Pandoc и Poppler.
В README также предупреждается, что доступ исполнителя к сети не ограничен, а песочница выполнения Codex в этой конфигурации отключена. Перед оценкой результатов пользователи бенчмарков должны настроить ограничения, препятствующие доступу к ответам и критериям оценки. Улучшения среды выполнения из статьи следует рассматривать вместе с этими условиями выполнения и оценки.
Он изменяет среду выполнения вокруг языковой модели, включая промпты, инструменты, память и навыки. Веса исходной модели остаются неизменными.
Рекурсия на уровне задачи тестирует и объединяет исправления для текущей задачи. Рекурсия на уровне управления оболочкой сохраняет данные и повторно используемые выводы для улучшения последующих решений по редактированию.
В методе адаптации используются различия между трассировками выполнения, а не проверяющий механизм с эталонным ответом. Это позволяет получать данные даже при отсутствии разметки, но не гарантирует корректность созданного результата.
Нет, это заявленный в исследовании средний прирост GLM-5/OpenCode на WorkBuddy. Для других сочетаний моделей, оболочек и бенчмарков приросты отличаются.
Он добавляет запуски кандидатов и работу по улучшению. В статье производительность анализируется вместе с общим объемом вычислений, включая токены выполнения и улучшения.
В репозитории Docker указан как требование для WorkBuddy-Bench. Для локальной детерминированной демонстрации и других бенчмарков требования отличаются, поэтому следует соблюдать инструкции выбранного рабочего процесса.
Harness2 объединяет эксперименты, ориентированные на конкретную задачу, с библиотекой выводов об улучшении сред выполнения агентов. Заявленные результаты показывают, что промпты, работа с инструментами и структура выполнения могут существенно менять результаты даже при неизменных весах модели.
Данные подтверждают ценность совершенствования оболочки в протестированных условиях, при этом ограничения вычислений, проверки и переноса остаются явно обозначенными.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



