For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
Перенос ИИ-нагрузки на локальное устройство требует не только производительного ускорителя. Разработчикам нужны средства для подготовки моде...
Перенос ИИ-нагрузки на локальное устройство требует не только производительного ускорителя. Разработчикам нужны средства для подготовки моделей, их эффективного запуска, связывания нескольких компонентов и сопровождения готового продукта.
Последнее объявление Houmo об экосистеме посвящено именно этому программному уровню. Согласно предоставленному отчёту, компания планирует поэтапно выпустить свой стек ИИ-ПО: к январю 2027 года должны быть опубликованы 15 проектов. Уже доступны несколько репозиториев, включая примеры моделей, инструменты квантования и адаптации знакомых фреймворков инференса.
Различие между дорожной картой и доступным сегодня кодом имеет значение. План открыть полный стек не означает, что каждый компонент уже опубликован или что все зависимости среды выполнения уже устранены.
В отчёте стек организован в четыре уровня:
| Уровень | Роль в развёртывании |
|---|---|
| Подготовка модели | Квантование, компиляция, проверка точности и преобразование в поддерживаемый формат |
| Фреймворк инференса, операторы и среда выполнения | Исполнение и планирование на оборудовании Houmo |
| Отраслевые наборы, пайплайны и промежуточное ПО | Координация между моделями и компонентами приложения |
| Развёртывание и эксплуатация | Обновления, мониторинг и управление на развёрнутых устройствах |
Ассистент для встреч показывает, почему эти уровни должны работать вместе. Распознавание речи должно передавать данные языковой модели, языковая модель должна формировать полезную запись, а приложение — сохранять или отображать её. У каждого этапа есть собственные требования к памяти, задержке и совместимости.
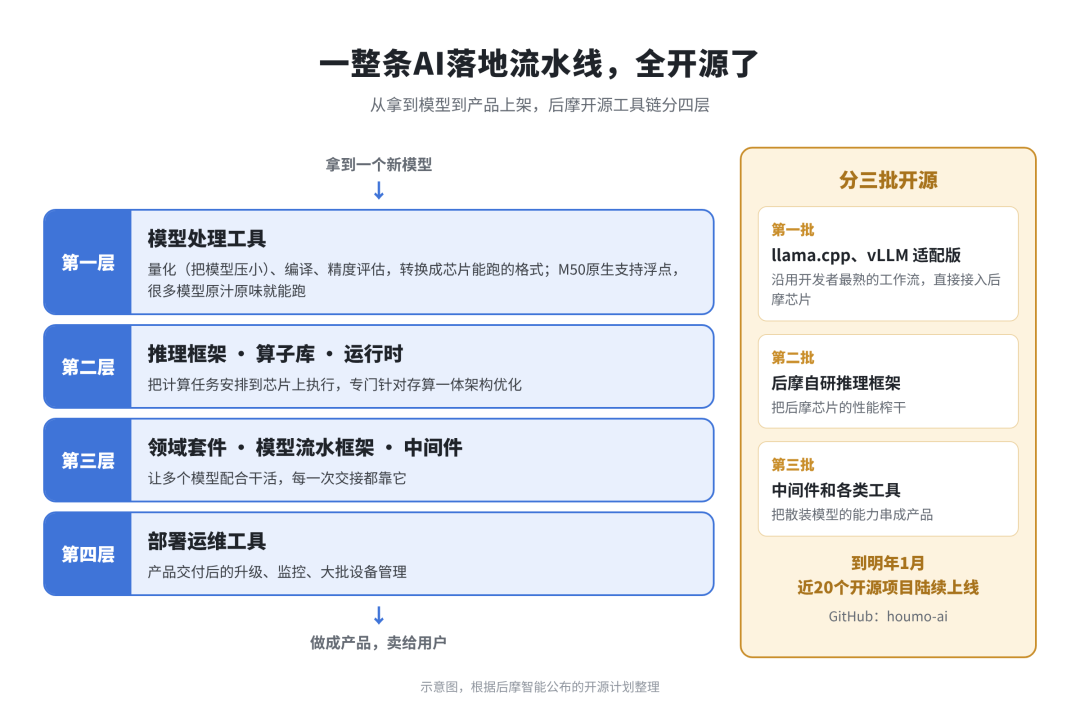
Схема программного стека из отчёта Xinzhiyuan/BAAI; исходные подписи на ней приведены на китайском языке.
Согласно сообщаемой последовательности выпуска, сначала публикуются адаптации llama.cpp и vLLM, затем собственный фреймворк инференса Houmo, а после — промежуточное ПО и другие инструменты. Более широкая дорожная карта также включает инфраструктуру для управления ускорителями и кластерами.
В публичном репозитории postmo-modelzoo описаны примеры, охватывающие квантование, компиляцию, оценку точности, измерение производительности и развёртывание приложений. Категории моделей включают распознавание речи, генерацию речи, языковые модели, визуально-языковые модели, эмбеддинги, OCR, сегментацию и генерацию изображений.
Среди других видимых репозиториев — postmo-quantflow, postmo-gptqmodel, vllm-postmo, а также форки Houmo проектов llama.cpp и vLLM. Разработчикам следует проверять README и актуальную ветку каждого репозитория, а не предполагать идентичность процедур установки или уровней поддержки.
README с примерами моделей указывает несколько конкретных ограничений:
houmo-tcim-runtime и houmo-drv.Эти требования важны для планирования. Открытый репозиторий с примерами предоставляет проверяемый интеграционный код, но не является независимой от оборудования средой исполнения.
Источник сообщает, что с M50 связаны более 100 клиентов и свыше 150 запланированных оконечных продуктов. Эти показатели описывают заявленный конвейер экосистемы, а не подтверждённые поставки.
В отчёте Lenovo P7 описывается как ИИ-компьютер массой около 300 граммов с максимальной заявленной мощностью системы 30 Вт. Сообщается о локальной работе модели с 122 млрд параметров со скоростью 50 токенов в секунду и поддержкой контекста 128K.
Эти показатели следует рассматривать вместе с отсутствующими условиями тестирования. В статье недостаточно сведений об архитектуре модели, точности, нагрузке и конфигурации измерений, чтобы считать их общей гарантией производительности. В частности, одно только число параметров не показывает, какой объём памяти требуется для развёртывания.
Сам M50 описывается как устройство с производительностью 160 TOPS INT8, типичным энергопотреблением 10 Вт и поддержкой до 48 ГБ памяти LPDDR5/5X. Мощность ускорителя, совокупная мощность системы, теоретическая пропускная способность и скорость генерации токенов измеряют разные величины.
Среди других заявленных продуктов упоминаются версия M50 устройства Truffle 1 от Deepshard, HomeAgent HA100 Pro от Ugreen и ClawHouse X1. Их примеры сосредоточены на локальной памяти, обработке домашнего медиаконтента и интерфейсах персональных агентов. Подключённые сервисы, такие как электронная почта, по-прежнему зависят от аутентификации и сетевого доступа, даже если модель выполняется локально.
В отчёте описывается ноутбук Great Wall N90 Pro с Kylin V11, запускающий 35B-модель офлайн со скоростью 30 токенов в секунду. Также в нём рассматриваются робот-компаньон, использующий локальную обработку для восприятия и памяти, а также образовательное устройство на базе ускорительных карт LM5040, каждая из которых объединяет четыре чипа M50.
Заявленные для образовательной системы показатели вычислительной мощности и памяти относятся к собранной машине, а не к одному M50. Читателям, сравнивающим продукты, следует запрашивать фактическое количество карт, топологию памяти, точность вычислений и измеренную рабочую нагрузку.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
В обсуждении архитектуры различаются модели типа mixture-of-experts и плотные модели. Модель MoE может активировать подмножество экспертов для одного токена, но при этом всё равно требует хранения более широкого набора параметров. Плотные модели обычно задействуют большую долю параметров на каждом шаге, поэтому трафик памяти становится важным фактором.
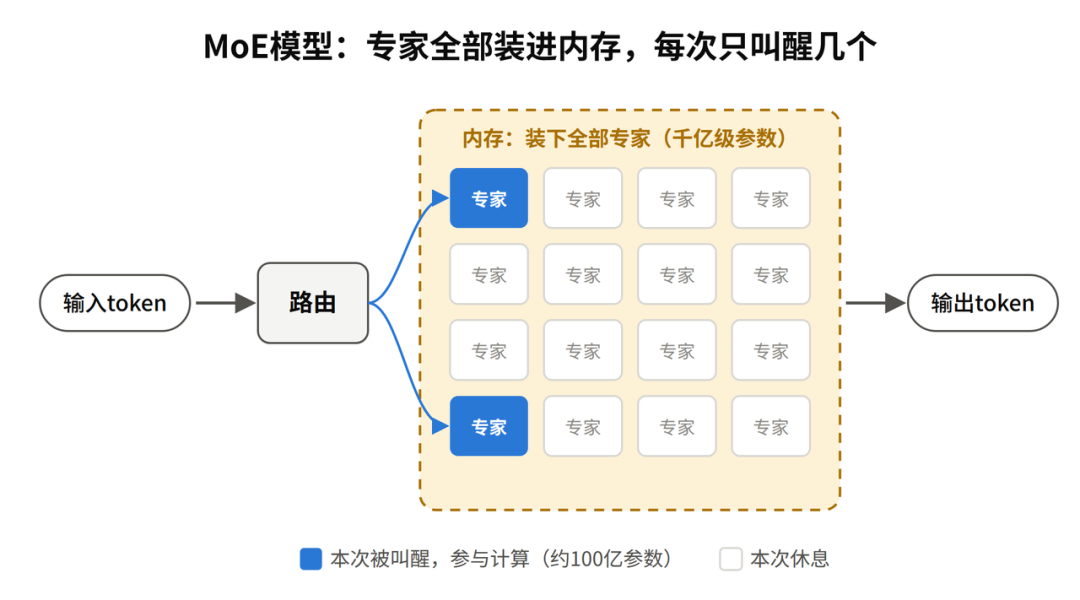
Иллюстрация MoE из исходного отчёта; оригинальные подписи поясняют хранимых и активированных экспертов.
Houmo представляет два направления разработки: 2D compute-in-memory, делающее акцент на ёмкости и вычислениях с внешней памятью, и 3D compute-in-memory, делающее акцент на пропускной способности благодаря многослойной конструкции. В отчёте вычисления на базе SRAM в логическом слое описываются как отличительная особенность последнего подхода.
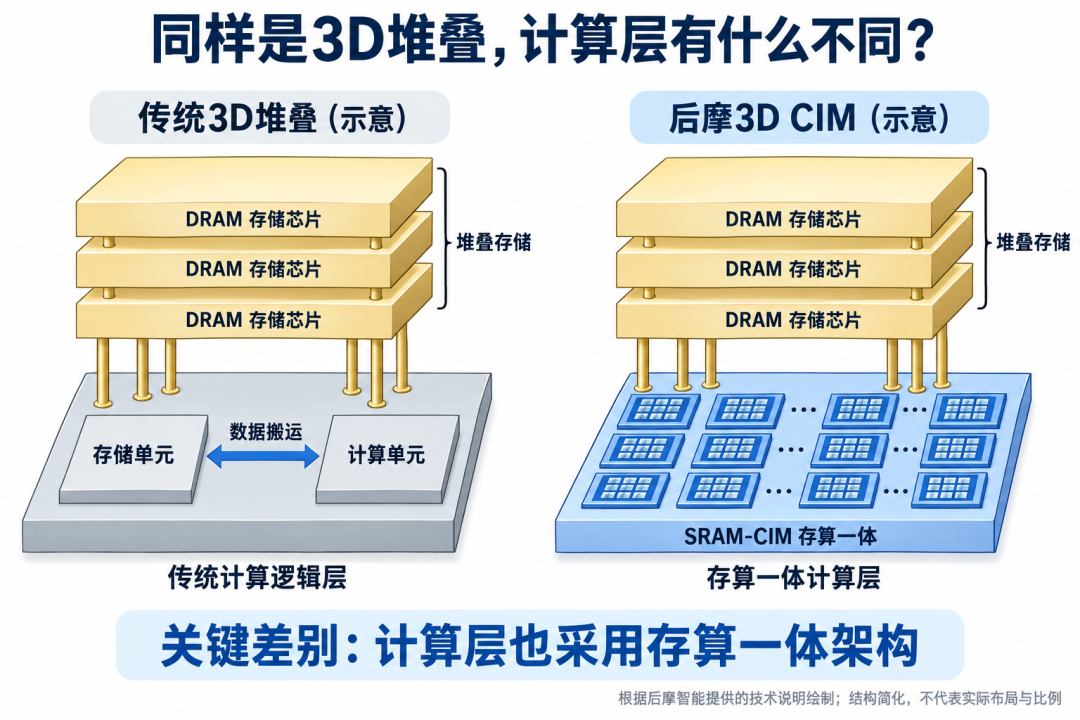
Сравнение архитектур воспроизведено по отчёту Xinzhiyuan/BAAI и не является независимым бенчмарком.
Сравнения компании по площади и энергопотреблению зависят от того, с чем именно проводится сравнение. Их не следует применять к каждому чипу или модели без раскрытых условий измерения. Будущие упоминания Flash или RRAM также описывают направление разработки, а не гарантируют доступность текущих продуктов.
Источник связывает это объявление с более ранней работой основателя и генерального директора Цяна У в области GPGPU и OpenCL. С практической точки зрения публикация инструментов позволяет разработчикам изучать поведение интеграции, адаптировать примеры и вносить исправления.
Такой доступ может сократить объём повторяющейся работы у производителей устройств. Однако он не устраняет необходимость тестировать качество, тепловые характеристики, использование памяти, лицензирование, офлайн-работу и сценарии восстановления в конечном продукте. Воспроизводимый пример на целевом оборудовании — более надёжная отправная точка, чем число параметров из заголовка.
M50 — это периферийный ИИ-ускоритель, используемый в описанных в отчёте сценариях на локальных устройствах. В качестве примеров приводятся агентные компьютеры, ноутбуки, домашние системы, роботы и устройства для периферийного инференса.
В отчёте описан поэтапный план, рассчитанный до января 2027 года. Несколько репозиториев уже являются публичными, однако разработчикам следует проверять фактический статус выпуска и лицензию каждого компонента.
Репозиторий включает инструменты подготовки и оценки с различными требованиями к платформе. Его примеры инференса требуют поддерживаемого оборудования Houmo и библиотек среды выполнения; для квантования больших моделей также необходим GPU.
Локальный инференс может работать без облачного сервиса модели, если необходимые ресурсы установлены. Задачи, связанные с действующей электронной почтой, сообщениями или другими онлайн-сервисами, всё равно требуют подключения и авторизации.
Нет. TOPS — это показатель пропускной способности операций при заданной точности, тогда как скорость генерации токенов зависит от архитектуры модели, трафика памяти, точности и поведения ПО. Сравнивайте измеренные результаты для одной и той же модели и рабочей нагрузки.
Нет. В README указано, что большинство сторонних наборов данных необходимо получать отдельно и использовать на их собственных условиях. Лицензия репозитория не предоставляет коммерческие права на все упомянутые данные или ресурсы моделей.
Объявление Houmo призвано сделать путь от подготовки модели до работающего периферийного продукта более удобным для повторного использования. Публичные репозитории уже предлагают полезные примеры, тогда как более широкий стек остаётся планом поэтапного выпуска.
Заявленные устройства на M50 демонстрируют несколько возможных форматов развёртывания, но практическое решение всё ещё зависит от конкретных моделей, оборудования и требований среды выполнения. Начните с поддерживаемого примера и измерьте полную рабочую нагрузку продукта.
Начните с одной фразы и получите полноценный сайт за считанные минуты.
