For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
Всего за несколько недель TypeSafe AI превратилась из малоизвестного стартапа в одну из самых обсуждаемых инфраструктурных компаний в сфере ...
Всего за несколько недель TypeSafe AI превратилась из малоизвестного стартапа в одну из самых обсуждаемых инфраструктурных компаний в сфере ИИ.
Теперь компания объявила о раунде Series A на $870 млн при оценке после привлечения инвестиций в $7,5 млрд.
При любых обстоятельствах это было бы заметным событием. Но необычность этой истории связана с продуктом, который стоит за таким стремительным ростом: Jev — модель, которая не пытается быть чат-ботом, не генерирует длинные тексты и в первую очередь не предназначена для написания кода.
Её задача гораздо уже.
Она принимает решения.
Типичный запрос к Jev выглядит скорее так:
Учитывая это состояние,
какой вариант должна выбрать программа?
а не так:
Напишите подробное объяснение.
TypeSafe называет Jev моделью System One — моделью, предназначенной для быстрых, ограниченных и структурированных решений, которые программное обеспечение может использовать напрямую.
Вместо свободного текста Jev возвращает, например:
Такая узкая специализация сделала Jev достаточно дешёвой и быстрой для работы внутри высоконагруженных программных процессов, где обычная передовая LLM была бы избыточно медленной или дорогой.
А реакция рынка оказалась чрезвычайно сильной.
TypeSafe AI была основана в 2024 году в Сан-Франциско.
До запуска Jev компания около двух лет работала в скрытом режиме.
Публичный прорыв произошёл 15 сентября 2026 года, когда TypeSafe представила свою первую модель System One и объяснила подход к её обучению: обучение с подкреплением для калиброванных решений, или RLCD.
В исходном материале отмечается, что ранее TypeSafe объявила о посевном раунде на $40 млн примерно во время запуска Jev. Менее чем через месяц компания объявила о значительно более крупном раунде Series A.
Официальная публикация TypeSafe о финансировании подтверждает следующие данные:
| Показатель | Подтверждённая информация |
|---|---|
| Раунд Series A | $870 млн |
| Оценка после привлечения инвестиций | $7,5 млрд |
| Ведущий инвестор | Andreessen Horowitz |
| Другие названные участники | Sequoia Capital, DCVC, частные инвесторы |
| Новый член совета директоров | Martin Casado |
Компания планирует использовать новый капитал, чтобы:
Важно, что инвесторы делают ставку не только на очередную универсальную передовую модель.
Они инвестируют в другую категорию моделей.
Основная идея Jev проста: многим программным системам не нужны абзацы.
Им нужно решение.
Например:
Традиционные LLM могут отвечать на такие вопросы, но обычно делают это посредством авторегрессионной генерации текста.
TypeSafe утверждает, что такой подход неэффективен, если приложение уже знает форму ответа.
Архитектура Jev выглядит так:
Структурированное состояние
      ↓
Типизированные вопросы
      ↓
Параллельное вычисление решения
      ↓
Вероятности + ограниченные результаты
      ↓
Приложение выбирает ветвь на основе результата
TypeSafe описывает это как интеллект, ориентированный на машины: модель оптимизирована для встраивания в код, а не для создания текста, который должен читать человек.
Сейчас TypeSafe указывает для Jev такие цены:
Вход:  $0,042 / 1 млн токенов
Выход: бесплатно / не тарифицируется
Эта цена значительно ниже, чем у большинства универсальных передовых моделей.
Причина заключается в архитектуре.
Jev не генерирует произвольный текст токен за токеном. TypeSafe заявляет, что её сэмплер возвращает ограниченные результаты решения параллельно.
Компания указывает сквозную задержку в диапазоне примерно 70–500 мс для своего сервиса и утверждает, что Jev может быть в 40–200 раз быстрее на сопоставимых задачах, соответствующих модели System One.
Эти показатели основаны на опубликованной TypeSafe оценке и должны рассматриваться как заявления поставщика для того типа задач, под который разработана Jev.
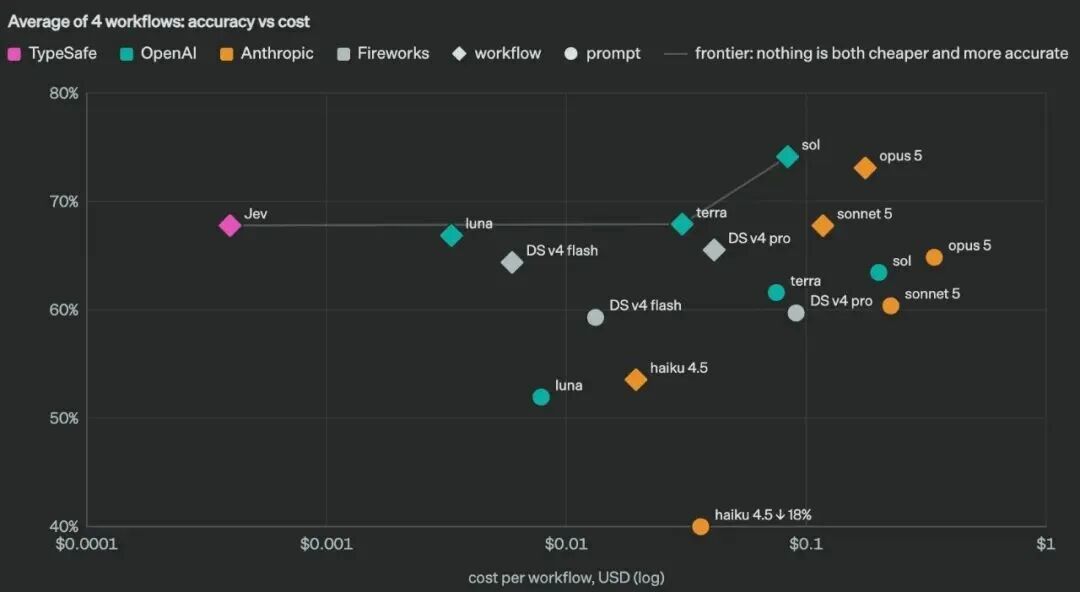
Одно из наиболее сильных утверждений TypeSafe состоит в том, что Jev не допускает ошибок типов.
Это утверждение требует точной интерпретации.
Оно означает, что если приложение объявляет схему ограниченного результата, Jev возвращает значение, соответствующее этому контракту вывода.
Например:
Допустимый ответ:
- одобрить
- проверить
- отклонить
Jev не должна внезапно возвращать:
Вот эссе из пяти абзацев о моём рассуждении...
Для промышленного программного обеспечения это важное свойство надёжности.
Но безопасность типов не означает, что семантическое решение всегда будет правильным.
Модель может вернуть корректное значение reject и при этом принять неверное бизнес-решение.
Поэтому Jev также возвращает вероятности и информацию об уверенности, позволяя приложению задавать такие пороги:
уверенность >= 0.95
→ автоматизировать

0.70 <= уверенность < 0.95
→ дополнительная проверка

уверенность < 0.70
→ проверка человеком
Таким образом, полезность модели зависит одновременно от качества классификации и её калибровки.
Самый сильный независимый сигнал о внедрении из исходной статьи связан с Vercel.
Vercel добавила Jev в AI Gateway вскоре после запуска и отслеживала, как быстро платные команды начали её использовать.
По данным Vercel, Jev достигла показателя почти 13% платных команд за 24 часа.
На тот момент это было более чем вдвое выше охвата любой предыдущей модели, запущенной в истории AI Gateway.
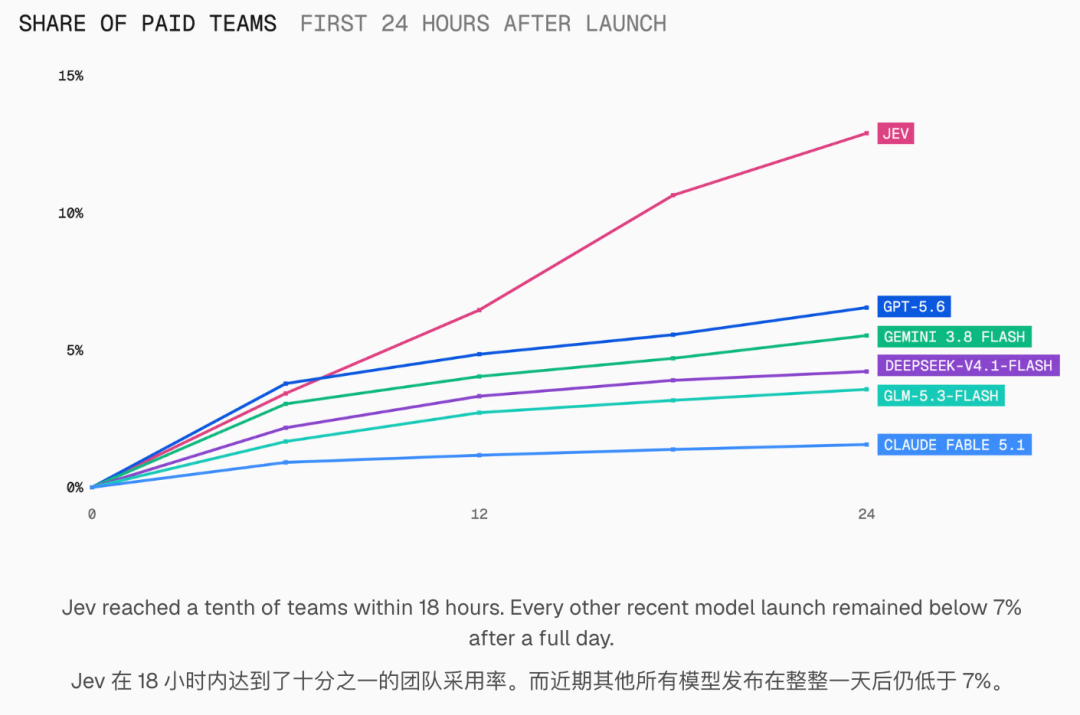
Vercel также отметила, что Jev обошла каждую модель для сравнения в течение первых 12 часов и продолжила увеличивать отрыв в первый день.
Это важно, потому что использование Jev отличается от обычного применения чат-ботов.
Человек может несколько раз попробовать новый чат-бот, а затем перестать им пользоваться.
Модель, встроенная в программное обеспечение, может непрерывно получать запросы.
Это создаёт совершенно иной сценарий использования:
Чат-бот для человека:
пользователь открывает приложение
→ отправляет сообщение
→ ждёт
→ закрывает приложение

Модель принятия решений в программе:
поступает запрос
→ запускается модель принятия решений
→ приложение выбирает ветвь
→ процесс повторяется весь день
Исходная статья передаёт это простой фразой:
Люди спят. Код — нет.
В исходной статье также приводится заявление TypeSafe и инвесторов о том, что Jev обработала примерно один триллион токенов за три дня после запуска.
Позже TypeSafe описала этот трафик как устойчивый, а не как единоразовый всплеск.
Теперь в публикации о раунде Series A компания заявляет, что примерно треть компаний из списка Fortune 500 использует или интегрирует Jev, а клиенты уже сэкономили миллионы долларов на производственных расходах.
Это собственные бизнес-метрики TypeSafe, а не данные независимого аудита, однако они помогают объяснить, почему инвесторы восприняли Jev как нечто большее, чем вирусную демонстрацию для разработчиков.
Характер использования указывает на спрос со стороны машин и программ.
После встраивания Jev в такие процессы, как:
её можно вызывать каждый раз, когда окружающее программное обеспечение доходит до соответствующей ветви.
Именно для такой нагрузки TypeSafe и разрабатывала модель.
История происхождения Jev необычно симметрична.
Сооснователь и генеральный директор TypeSafe Diogo Almeida ранее работал в Google Brain и OpenAI.
На собственной странице команды TypeSafe называет его одним из соавторов RLHF и InstructGPT — проектов, которые помогли привести к созданию ChatGPT и GPT-4.
В OpenAI Almeida работал над методами, позволившими превратить исходные языковые модели в системы, способные следовать инструкциям и естественно взаимодействовать с людьми.
После ухода из OpenAI он всё больше сомневался в том, что чат должен быть интерфейсом по умолчанию для интеллекта внутри программного обеспечения.
В публикации TypeSafe о запуске Jev он сформулировал этот сдвиг так: если модели стали чрезвычайно эффективны в разговоре, почему автоматизация не развивалась с такой же скоростью?

Чат-бот оптимизирован для гибкости.
Такая гибкость ценна, когда результат читает человек.
Но промышленному программному обеспечению часто нужно обратное:
Позиция TypeSafe заключается в том, что универсальная генерация языка часто является чрезмерно мощной абстракцией для подобных задач.
Вместо того чтобы просить передовую модель создать структурированный ответ, а затем проверять текст, Jev предназначена для непосредственного принятия ограниченного решения.
Слоган компании передаёт эту философию:
Создавайте промышленный продукт, а не Бога.
Формулировка намеренно провокационна, но лежащая в её основе идея практична: оптимизировать ИИ-продукты под надёжную работу в производственной среде, а не рассматривать каждый продукт как шаг к одной универсальной модели.
TypeSafe называет свой метод обучения обучением с подкреплением для калиброванных решений (RLCD).
Компания противопоставляет его двум знакомым подходам:
| Направление обучения | Основная цель оптимизации |
|---|---|
| RLHF | Ответы, которые предпочитают люди |
| RLVR | Проверяемые результаты рассуждений |
| RLCD | Калиброванные структурированные решения |
В случае Jev калибровка имеет центральное значение.
Если модель говорит 0.90, цель состоит в том, чтобы события, которым присвоена примерно такая уверенность, действительно оказывались правильными примерно в 90% случаев на подходящем распределении оценки.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Для проектирования автоматизированных процессов это гораздо полезнее, чем одна некалиброванная метка.
Затем приложение может превратить неопределённость модели в правило:
высокая уверенность
→ автоматизировать

средняя уверенность
→ запросить другую модель или применить дополнительные правила

низкая уверенность
→ передать человеку
Это одна из причин, по которой модели принятия решений привлекательны для высоконагруженных систем.
Они не устраняют неопределённость.
Они делают неопределённость более удобной для использования программным обеспечением.
В исходной статье также подчёркивается скептическое отношение Almeida к публичной конкуренции по бенчмаркам.
TypeSafe публикует оценки, но в материалах о запуске уделяет необычно много внимания ограничениям.
Например, компания прямо отмечает, что:
Это важное различие.
TypeSafe по-прежнему активно продвигает свою модель, но не утверждает, что Jev должна повсеместно заменить передовые LLM.
Собственная документация компании разводит продукты следующим образом:
Генеративная LLM
→ писать, рассуждать, объяснять, программировать, вести диалог

Модель принятия решений
→ классифицировать, маршрутизировать, оценивать, проверять, задавать условия, расставлять приоритеты
Обе модели могут работать вместе в одной системе.
Руководство TypeSafe не ограничивается Almeida.
На официальной странице команды указаны:
В более широкую команду входят специалисты из OpenAI, Google Brain, Meta/FAIR, Stripe, Airbnb, Plaid и Docker.
Такой опыт помогает объяснить акцент продукта.
Jev посвящена не созданию нового потребительского интерфейса, а разработке инструмента, который разработчики могут глубоко встроить в инфраструктуру.
Быстрое внедрение Jev имело и второй эффект.
Категория была подтверждена настолько быстро, что крупные инфраструктурные и модельные компании начали выпускать конкурирующие продукты уже через несколько недель.
Именно этим сдвигом заканчивается исходная статья.
Microsoft объявила о Microsoft-Decision-1 — модели, специально созданной для структурированной оценки решений.
Модель основана на Qwen3.5-9B и доступна через Microsoft Foundry в режиме публичной предварительной версии.
Она поддерживает такие задачи, как:
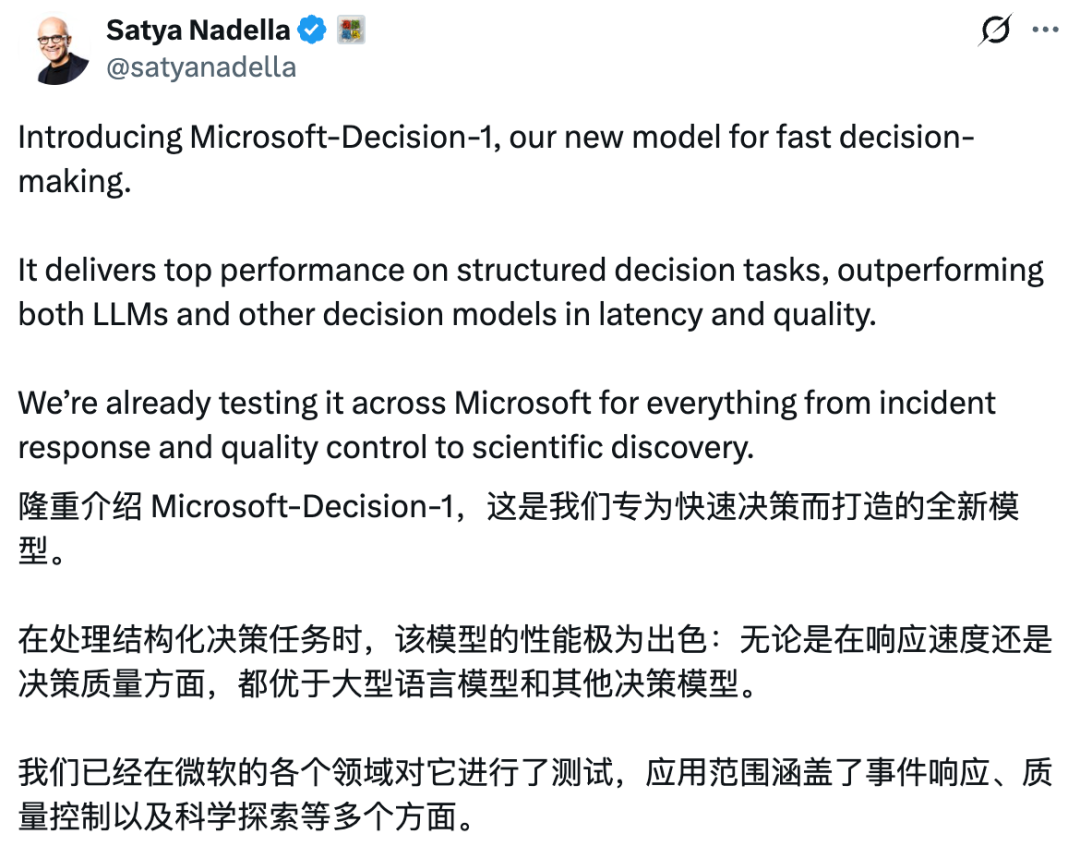
Если задан фиксированный набор вариантов, Microsoft-Decision-1 возвращает калиброванные вероятностные оценки для этих вариантов.
Microsoft сообщает, что модель показала наивысшую точность в сравнении по 36 бенчмаркам, охватывающем почти 150 000 вопросов, и утверждает, что в собственной оценке она была значительно быстрее GPT-6 Sol.
Эти показатели являются результатами собственных бенчмарков Microsoft, поэтому разработчикам следует проверять модель на собственных задачах, прежде чем считать их универсальным рейтингом производительности.
OpenAI двинулась в том же направлении, выпустив Decisions API в публичной бета-версии 6 октября 2026 года.
API работает на базе GPT-6 Luna и принимает текст, изображения или оба типа данных одновременно.
Он поддерживает три типа структурированных вопросов:
| Тип | Результат |
|---|---|
| Предикат | Вероятность истинности условия |
| Выбор | Один вариант из предложенных, а также вероятности |
| Оценка | Взвешенная по вероятности оценка по упорядоченным уровням |
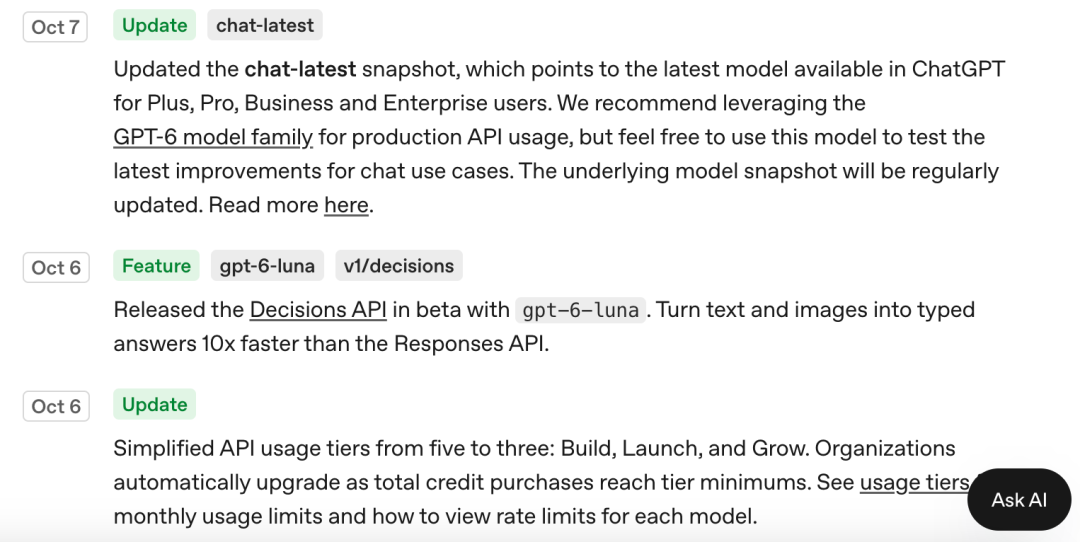
OpenAI заявляет, что специализированный API может возвращать решения примерно в 10 раз быстрее, чем GPT-6 Luna через Responses API, для соответствующего типа задач.
Цены в бета-версии устроены необычно просто:
Вход: $0,10 / 1 млн токенов
Выход: плата за выходные токены отсутствует
Чтение кэша: плата отсутствует
Запись в кэш: плата отсутствует
Ключевое отличие от Jev заключается в архитектуре.
Jev — это специально созданное семейство моделей System One от TypeSafe.
Decisions API OpenAI предоставляет специализированный интерфейс принятия решений поверх GPT-6 Luna.
Однако с точки зрения разработчика приложения обе технологии решают похожую задачу:
состояние на входе
→ ограниченное типизированное решение на выходе
Cloudflare вступила в гонку ещё раньше, объявив о Clef и Clef-flash 1 октября.
Обе модели принятия решений доступны в Workers AI, а Cloudflare также открыла их веса по лицензии Apache 2.0.
Они используют совместимую с Jev форму API, благодаря чему их проще подключать к процессам, построенным вокруг запросов принятия решений в стиле System One.
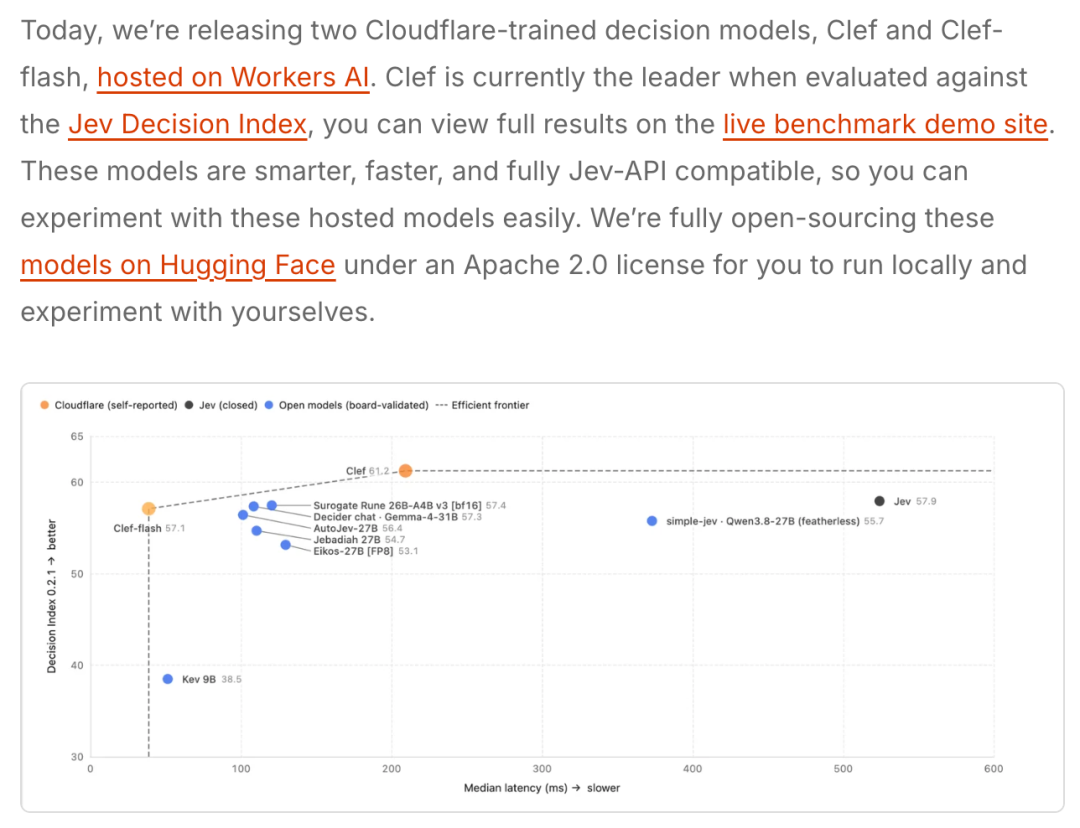
Cloudflare приводит следующие данные:
| Модель | Размер | Контекст | Основной фокус |
|---|---|---|---|
| Clef | 27B | 64K | Более высокое качество решений |
| Clef-flash | 9B | 64K | Очень низкая задержка |
В собственной тестовой серии Cloudflare Clef или Clef-flash лидировали в 7 из 10 выделенных бенчмарков принятия решений, тогда как Jev оставалась сильнее в некоторых отдельных задачах, таких как When2Call и BRIGHT.
Cloudflare также сообщила о следующих медианных задержках:
Clef:       209,3 мс
Clef-flash: 38,8 мс
Jev:        524,1 мс
И снова: эти показатели получены в среде оценки Cloudflare.
Они служат полезным конкурентным ориентиром, но не являются универсальной гарантией задержки для каждого варианта развёртывания.
Главная мысль исходной статьи заключается не только в том, что Jev привлекла огромный раунд.
Она заключается в том, что категория моделей почти мгновенно прошла путь от необычной до переполненной конкурентами.
За несколько недель на рынке появились:
Каждая реализация отличается, но все они основаны на общем выводе:
Не каждому запросу ИИ нужен генеративный текст.
Многие производственные задачи больше похожи на интеллектуальные операторы if.
Например:
если вероятность мошенничества > 0.98:
    заблокировать()
иначе если вероятность мошенничества > 0.70:
    проверить()
иначе:
    разрешить()
Сложность заключается не в написании ветвления.
Сложность — в получении полезной и калиброванной вероятности из неструктурированного контекста реального мира.
Модели принятия решений пытаются сделать такую возможность достаточно дешёвой, чтобы использовать её повсеместно.
На первый взгляд специализированные модели принятия решений выглядят угрозой для универсальных LLM.
На практике они могут увеличить общее потребление ИИ.
Универсальный агент может использовать модель принятия решений в высокочастотных контрольных точках:
Запрос пользователя
→ модель принятия решений выбирает маршрут
→ LLM выполняет сложное рассуждение только при необходимости
→ модель принятия решений оценивает результат
→ процесс продолжается или передаётся на следующий уровень
Это позволяет разработчикам резервировать дорогостоящее рассуждение для тех частей процесса, которым оно действительно необходимо.
Всё остальное можно обрабатывать более дешёвыми моделями с ограниченным результатом.
В итоге общее число обращений к ИИ может вырасти, а не сократиться.
Эта идея согласуется с названием Jev: TypeSafe говорит, что оно отсылает к экономисту Уильяму Стэнли Джевонсу и парадоксу Джевонса, согласно которому повышение эффективности может увеличить общее потребление, поскольку снижение стоимости открывает новые варианты использования.
В инфраструктуре ИИ та же логика может выглядеть так:
более дешёвые решения
→ больше решений становятся экономически оправданными
→ больше программ получают точки управления на базе ИИ
→ общее использование машинного интеллекта растёт
Jev — первая модель System One от TypeSafe AI, предназначенная для быстрых структурированных решений, а не для генерации свободного текста. Она принимает состояние приложения и типизированные вопросы, а возвращает ограниченные ответы с вероятностями и информацией об уверенности.
Сейчас TypeSafe указывает цену $0,042 за миллион входных токенов и не тарифицирует выходные токены. Эта цена относится к структурированному интерфейсу принятия решений Jev, а не к универсальной модели генерации текста.
Самое сильное формальное утверждение TypeSafe касается безопасности типов результата: ограниченная схема не позволяет модели выдавать произвольный некорректно сформированный результат. Это не означает, что каждое семантическое решение будет правильным. Поэтому по-прежнему важны калибровка, пороги, оценка и проверка человеком.
Vercel сообщает, что почти 13% платных команд использовали Jev в течение 24 часов после запуска в AI Gateway. Vercel назвала её самой быстро внедряемой моделью в истории AI Gateway на тот момент.
Decisions API — это конечная точка OpenAI в публичной бета-версии на базе GPT-6 Luna. Она принимает текстовые и визуальные данные и возвращает вероятности предикатов, варианты выбора или оценки. OpenAI заявляет примерно о десятикратном снижении задержки по сравнению с использованием GPT-6 Luna через Responses API для таких задач принятия решений.
Microsoft-Decision-1 — структурированная модель принятия решений, доступная в публичной предварительной версии Microsoft Foundry. Она основана на Qwen3.5-9B и предназначена для классификации, маршрутизации, ранжирования, оценки, проверки и управления процессами.
Cloudflare описывает Clef и Clef-flash как модели принятия решений с открытым исходным кодом или открытыми весами и выпустила их по лицензии Apache 2.0. Они также размещаются через Workers AI и используют стиль API System One, совместимый с Jev.
Обычно нет. Модели принятия решений лучше подходят для ограниченных высокочастотных решений, тогда как универсальные LLM по-прежнему сильнее в генерации, объяснении, сложном рассуждении и открытом использовании инструментов. Во многих промышленных системах будут использоваться обе категории моделей.
Раунд Series A TypeSafe AI на $870 млн важен потому, что подтверждает перспективность не только одного стартапа. Он подтверждает целую категорию моделей: быстрые, ограниченные и машиночитаемые системы принятия решений, предназначенные для глубокой интеграции в промышленное программное обеспечение.
Быстрое внедрение Jev в Vercel, низкая цена входных токенов, структурированные результаты и акцент на калибровке объясняют интерес разработчиков. Однако наиболее сильные заявления о производительности по-прежнему нужно рассматривать в контексте: некоторые из них исходят непосредственно от TypeSafe, тогда как Vercel, Cloudflare, Microsoft и OpenAI публикуют собственные измерения, полученные в разных условиях.
Самый важный рыночный сигнал — скорость появления конкурентов. За несколько недель Microsoft, OpenAI и Cloudflare выпустили продукты, предназначенные для решения одной и той же базовой задачи.
Главным достижением Jev может быть не один бенчмарк и не один раунд финансирования, а доказательство того, что значительной части промышленного ИИ вообще не нужно разговаривать.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



