Microsoft сообщает, что новая конфигурация её мультимодельной, мультиагентной системы MDASH достигла 95,95% успеха на CyberGym. Эта система ...
Microsoft сообщает, что новая конфигурация её мультимодельной мультиагентной системы MDASH достигает 95,95% успеха на CyberGym. Система предназначена для выявления, проверки, приоритизации и устранения уязвимостей программного обеспечения.
Эта цифра впечатляет. В исходной статье CyberGym сообщалось, что самая сильная протестированная комбинация — OpenHands с Claude 3.7 Sonnet — воспроизвела лишь 11,9% уязвимостей бенчмарка в первой опубликованной оценке.
Последний результат Microsoft значительно выше. Однако наиболее важная часть этого анонса заключается не в том, что новая модель просто стала мощнее.
Оценка 95,95% получена целостной системой безопасности, объединяющей:
Microsoft резюмирует этот подход тремя словами:
Модель
Данные
Инфраструктура
Модель обеспечивает интеллект. Данные дают интеллекту контекст безопасности. Инфраструктура превращает выходные данные модели в воспроизводимые и проверяемые рабочие процессы.
Это различие важно, потому что корпоративные команды безопасности не покупают ответы на бенчмарки. Им нужна система, способная работать непрерывно, контролировать ложные срабатывания, подтверждать реальность обнаруженных проблем и помогать превращать результаты в исправления безопасности.
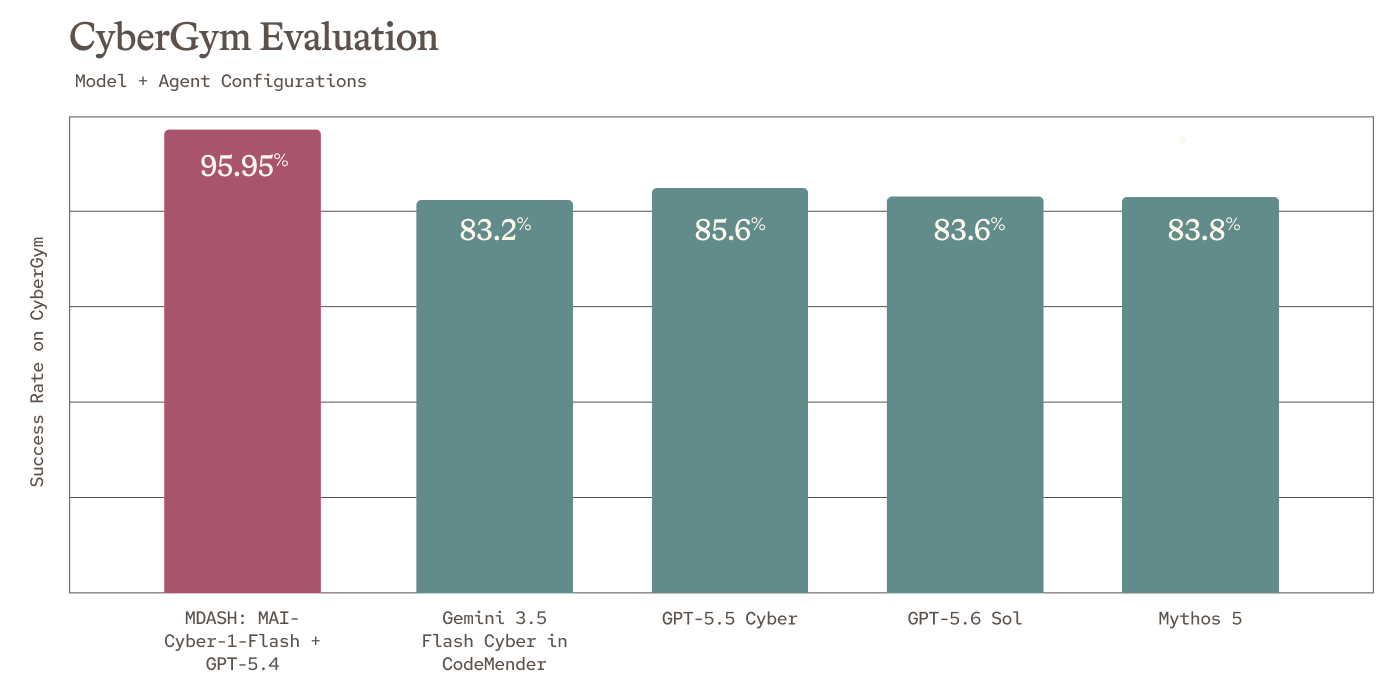
Опубликованный Microsoft график CyberGym сравнивает пять конфигураций моделей и агентов:
| Конфигурация системы или модели | Успех на CyberGym по данным Microsoft |
|---|---|
| MDASH: MAI-Cyber-1-Flash + GPT-5.4 | 95,95% |
| GPT-5.5 Cyber | 85,6% |
| Mythos 5 | 83,8% |
| GPT-5.6 Sol | 83,6% |
| Gemini 3.5 Flash Cyber в CodeMender | 83,2% |
Конфигурация MDASH опережает второе место на графике Microsoft более чем на десять процентных пунктов.
Microsoft также сообщает, что стоимость этой конфигурации примерно на 50% ниже, чем у предыдущей самой сильной настройки MDASH (с использованием GPT-5.4, GPT-5.4 mini и GPT-5.3 Codex).
Таким образом, сравнение ведётся по двум измерениям:
Сканирование безопасности — не разовая задача. Крупным организациям может потребоваться проверять миллионы строк кода, повторять сканирование после каждого изменения, проверять подозрительные уязвимости, перетестировать патчи и отслеживать постоянно меняющийся состав программных активов.
Конфигурация с исключительно мощной, но слишком дорогой при частом использовании моделью может дать меньше реальной защиты, чем менее крупная модель, встроенная в более качественную систему маршрутизации и проверки.
Microsoft сообщает, что MAI-Cyber-1-Flash спроектирована для обработки до 90% задач в рабочем процессе MDASH.
Самые сложные 10% задач могут маршрутизироваться на более крупную модель, которую Microsoft обозначает в опубликованной конфигурации как GPT-5.4.

Эту стратегию можно описать так:
Типовые и частые задачи безопасности
→ MAI-Cyber-1-Flash

Исключительно сложные задачи
→ GPT-5.4
Это не означает, что MAI-Cyber-1-Flash самостоятельно устраняет 90% уязвимостей.
Цифра 90% относится к доле задач, которые небольшая модель спроектирована обрабатывать в рамках маршрутизированного рабочего процесса. Полный результат MDASH по-прежнему зависит от маршрутизатора задач, более крупной модели, специализированных агентов, проверки, генерации доказательств, дедупликации, инструментов безопасности, среды выполнения и системного контроля.
Небольшая модель снижает среднюю стоимость рабочего процесса, но не устраняет потребность в более сильной модели в наиболее сложных случаях.
Microsoft описывает MAI-Cyber-1-Flash как свою первую модель, специализированную для кибербезопасности.
Официальная карточка модели содержит:
| Спецификация | MAI-Cyber-1-Flash |
|---|---|
| Архитектура | Разрежённый смешанный эксперт Transformer |
| Всего параметров | 137B |
| Активных параметров | 5B |
| Длина контекста | 256K |
| Входные данные | Текст |
| Выходные данные | Текст |
| Базовая модель | MAI-Code-1-Flash |
| Основная среда | Microsoft MDASH |
| Дата выпуска | 27 июля 2026 г. |
| Доступность | Частная предварительная версия Azure AI Foundry для одобренных клиентов MDASH |
Модель представляет собой специализированную доработку MAI-Code-1-Flash под задачи кибербезопасности.
Она предназначена для рабочих процессов, включающих выявление уязвимостей, проверку, приоритизацию, классификацию, поддержку исправлений и корпоративное сканирование кода.
Это не публичная универсальная модель для кибербезопасности.
Карточка модели Microsoft указывает, что доступ ограничен избранными клиентами MDASH и требует дополнительного согласования, поскольку расширенные возможности кибербезопасности относятся к технологиям двойного назначения.
Модель также специально разработана для интеграции с MDASH, а не как самостоятельная загружаемая модель или открытый публичный API.
MAI-Cyber-1-Flash имеет 137 миллиардов параметров, но активирует лишь около 5 миллиардов на каждый токен.
Такая разрежённая архитектура смешанных экспертов позволяет модели иметь больший общий объём знаний, сохраняя при этом относительно небольшие вычислительные затраты при инференсе.
Однако более важная оптимизация заключается в специализации.
Универсальные前沿ные модели должны поддерживать письмо, математику, исследования, программирование, диалог, планирование, мультимодальные задачи и работу с инструментами. Специализированная модель может сконцентрировать больше обучения и пост-обучения в одной области применения.
Для MAI-Cyber-1-Flash эта область включает исполняемые среды безопасности и управление уязвимостями.
Рабочие процессы.
Когда модель многократно сталкивается с задачами, схожими с её обучающей и оценочной средой, специализация повышает соотношение цены и качества.
Системе по-прежнему нужен резервный вариант, поскольку сложные или нетипичные случаи могут выходить за пределы возможностей специализированной модели.
Это порождает практичную мультимодельную архитектуру:
Недорогая специализированная модель — за счёт широты охвата
+
前沿ная модель — для исключительных случаев
+
Система проверки — для обеспечения доверия
Карточка модели содержит особенно полезное сравнение на уровне системы.
Microsoft сообщает, что предыдущая конфигурация MDASH набирала 88,4% на CyberGym.
После замены 80% существующих обращений к моделям в рабочем процессе на MAI-Cyber-1-Flash результат вырос до 95,95%.
Стоимость также снизилась примерно вдвое по сравнению с предыдущей самой сильной конфигурацией.
Этот результат оспаривает распространённое предположение:
Более дешёвая модель обязательно означает более низкое качество.
Возможно, это справедливо при сравнении моделей, работающих независимо над одной и той же задачей. Но внутри маршрутизированной системы это не всегда так.
Специализированная модель может показывать более стабильные результаты на типовых задачах благодаря целевому обучению. Маршрутизатор может сохранять дорогие前沿ные модели для сценариев, где они создают наибольшую ценность.
Конечный результат зависит от правильных ответов на три вопроса:
Маршрутизация моделей становится частью качества продукта.
Карточка модели Microsoft также сообщает
MAI-Cyber-1-Flash в независимых оценках в рамках других кибербезопасностных бенчмарков.
Эти результаты, относящиеся только к самой модели, не эквивалентны показателю MDASH в CyberGym.
Карточка модели приведена ниже:
| Бенчмарк | Независимый результат MAI-Cyber-1-Flash |
|---|---|
| CVEBench | 0.314 |
| CyberSecEval4 Threat Intelligence | 0.553 |
| CyberSecEval4 Malware Analysis | 0.33 |
| CRSBench | 0.651 (POV=1200) |
| ExploitGym Kernel | 0 |
| ExploitGym Userland | 0 |
| ExploitGym Browser | 0 |
Эти данные демонстрируют важность различения на уровне системы.
Маленькая модель не является всесторонне лидирующей во всех кибер-бенчмарках. Её наиболее сильные опубликованные результаты получены при работе внутри MDASH во взаимодействии с другими моделями, агентами, инструментами, данными и этапами верификации.
Это подтверждает ключевое сообщение Microsoft:
Модель — это компонент.
Система — это продукт.
MDASH — это мультимодельная, мультиагентная система Microsoft для обнаружения и устранения уязвимостей.
Microsoft сообщает, что её эксперты по безопасности создали в системе более 100 специализированных агентов.
Разные агенты отвечают за различные этапы рабочего процесса, включая локализацию кода, поиск кандидатов, рассуждение об уязвимостях, верификацию, построение доказательств, классификацию, дедупликацию, исправление, работу с патчами и сопоставление результатов между собой.
Упрощённая схема работы системы выглядит примерно так:
Контекст кода и безопасности
        ↓
Агент поиска кандидатов
        ↓
Агент верификации
        ↓
Дебаты и сопоставление
        ↓
Дедупликация
        ↓
Генерация PoC
        ↓
Поддержка патчей или исправлений
Ручная проверка и контролируемые операции
Конкретная внутренняя реализация является проприетарной, но Microsoft изложила несколько важных принципов проектирования.
Microsoft утверждает, что MDASH отделяет части конвейера (такие как таргетирование, верификация, дедупликация и доказательства) от какой-либо одной модели.
Это упрощает замену и сравнение моделей.
Когда появляется новая модель, система может провести A/B-тестирование с текущим набором моделей.
Предыдущие инвестиции организации остаются в силе:
Это снижает зависимость от одного поставщика или контрольной точки модели.
Это также делает возможным постоянное улучшение. Лучшая модель для одного этапа не обязательно является лучшей для другого.
Обнаружение некоторых уязвимостей требует не только чтения исходного кода.
Системе может потребоваться собрать проект, создать триггерные входные данные, запустить уязвимую версию, запустить пропатченную версию, проверить сбои, запросить базы данных анализа кода, сравнить контрольные потоки и убедиться, что поведение воспроизводимо.
Microsoft сообщает, что MDASH может использовать специализированные доменные плагины и системы анализа кода.
В её майском анонсе обсуждался плагин верификации для уязвимостей в общей файловой системе журналов, а также указывалось на возможность использования баз данных CodeQL.
Модели не обязаны выполнять все действия с помощью свободного текста.
Для задач, которые лучше решаются программным обеспечением, инструменты могут обеспечивать детерминированные возможности.
Модель безопасности может генерировать правдоподобные, но на самом деле ошибочные описания уязвимостей.
Если система пересылает каждый предположительный результат разработчикам, это вызывает усталость от оповещений.
Операционная ценность заключается в доказательстве того, что находка реальна.
Полезные доказательства могут включать:
Именно поэтому такие бенчмарки, как CyberGym, имеют значение.
Он оценивает не только убедительность письменных объяснений.
Он проверяет, действительно ли сгенерированное доказательство способно воспроизвести целевое поведение.
CyberGym — это масштабный бенчмарк, созданный исследователями, связанными с Калифорнийским университетом в Беркли.
Текущий публичный проект содержит 1507 реальных экземпляров уязвимостей из 188 программных проектов.
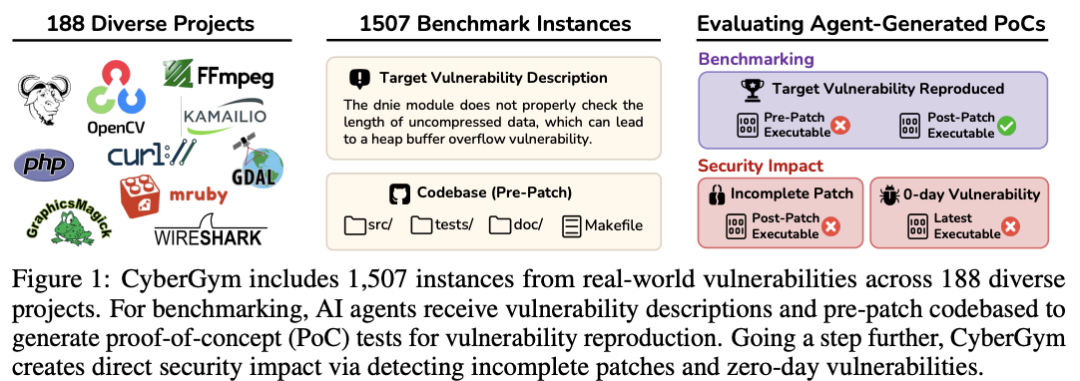
В основной настройке генерации PoC агент получает:
Агент должен сгенерировать концептуальное доказательство (PoC), которое может вызвать эту уязвимость.
Затем бенчмарк оценивает поведение
в отношении уязвимой и пропатченной версий.
Успешное воспроизведение обычно должно удовлетворять ожидаемому сравнению:
Версия до патча:
PoC вызывает целевую уязвимость.

Версия после патча:
Тот же PoC больше не вызывает уязвимость.
CyberGym использует реальные уязвимости из крупных проектов с открытым исходным кодом, включая экосистему OSS-Fuzz.
Его архитектура на основе выполнения делает его более строгим, чем бенчмарки, которые лишь требуют от модели классифицировать код или писать объяснения.
Число 95.95% требует внимательной интерпретации.
Основная настройка CyberGym предоставляет агенту описание уязвимости.
Агент не обязательно начинает с полностью неизвестной кодовой базы, не имея никаких подсказок о существовании уязвимости.
Таким образом, бенчмарк измеряет одну из форм воспроизведения известных уязвимостей.
Это не означает напрямую:
Тем не менее, бенчмарк требует серьёзной работы. Агент должен ориентироваться в реальной кодовой базе, находить соответствующее поведение, создавать действенный триггер, собирать или запускать программное обеспечение и проверять результаты.
Корректная формулировка такова:
Заявленный балл — это частота успешного воспроизведения уязвимостей в конфигурации оценки CyberGym, используемой Microsoft.
В первой версии оригинальной статьи CyberGym сообщалось, что самая сильная тестовая комбинация — OpenHands с Claude 3.7 Sonnet — достигла 11.9% частоты воспроизведения.
Более поздние пересмотры бенчмарка, агентные фреймворки, поколения моделей и системный дизайн значительно улучшили результаты.
Показатель Microsoft в 95.95% демонстрирует, насколько быстро сочетание моделей и инструментальных фреймворков прогрессирует.
Однако это сравнение не следует воспринимать как чисто модельное улучшение.
Эти системы различаются по поколениям моделей, агентным фреймворкам, промптам, инструментам, верификации, вычислительным бюджетам, стоимости, маршрутизации задач, версиям бенчмарков, инфраструктуре и стратегиям повторных попыток.
Прогресс реален, но это прогресс на уровне системы.
В исходной статье отмечается, что на момент публикации результат Microsoft в 95.95% ещё не был отражён в публичной таблице лидеров CyberGym.
Более ранняя конфигурация Microsoft от мая сообщала о примерно 88.4%–88.45%, и ранее была публично опубликована как лидер бенчмарка.
Новые данные в 95.95% были опубликованы Microsoft в анонсе MAI-Cyber-1-Flash, в карточке модели, а также в анонсе Microsoft Project Perception.
До появления внешних записей в таблице лидеров или независимых воспроизведений это следует описывать как результат, заявленный Microsoft.
Это не делает результат бессмысленным. Это означает, что читатели должны различать:
Оценки, заявленные поставщиком
и
публично воспроизведённые независимые результаты
Это различие особенно важно в быстро меняющихся сравнениях бенчмарков.
Microsoft
рассматривает свои исторические данные по безопасности как своё самое глубокое преимущество.
Компания сообщает, что ежедневно обрабатывает более 100 триллионов сигналов безопасности и имеет операционную аналитику от 1.6 миллиона клиентов.
Её видимость в области безопасности охватывает идентификацию, конечные точки, облако, сеть, данные, браузеры и приложения.
Ценность не только в количестве событий.
Компания способна связывать действия в области безопасности с результатами:
Какие патчи решили проблему.
Это формирует замкнутый цикл обратной связи.
Инцидент безопасности
→ Расследование
→ Проверка
→ Исправление
→ Наблюдаемые результаты
→ Более качественные данные и отдача
→ Улучшенные модели и агенты
Конкуренты могут получить аналогичные базовые модели.
Но невозможно в одночасье воспроизвести операционную историю, проверенную десятилетиями.
Данные обретают ценность только тогда, когда большие массивы превращаются в обучающий контекст, контекст оценки и операционный контекст.
Сырые сигналы безопасности могут быть избыточными, зашумленными, неполными, специфичными для клиента, чувствительными, содержать неверные метки, быть смещёнными в сторону видимых атак или не содержать конечных результатов.
Конвейер данных должен связывать события с доверенными метками и результатами.
Например:
Сработало оповещение
→ Расследование аналитика
→ Подтверждена уязвимость
→ Развёрнут патч
→ Эксплуатация уязвимости больше не работает
Эта последовательность ценнее, чем отдельное оповещение.
Ров создаётся данными плюс их обработкой, обратной связью, оценкой и доступом к операциям безопасности.
Трёхчастная структура Microsoft даёт полезный подход к оценке любой корпоративной системы ИИ для безопасности.
Вопросы включают:
Вопросы включают:
Вопросы включают:
Система с мощной моделью, но слабыми данными и отсутствием проверки может генерировать впечатляющие, но ненадёжные отчёты.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Хорошо спроектированная система может сделать меньшие модели более полезными, поручая им правильные задачи и проверяя их работу.
Microsoft считает, что при непрерывном сканировании безопасности стоимость токенов становится ключевым ограничением.
Рассмотрим упрощённую нагрузку:
10 миллионов задач анализа кода в месяц
Если каждая задача выполняется самой дорогой передовой моделью, система может не справиться с полным охватом.
Дизайн маршрутизации меняет среднюю стоимость:
90% недорогих специализированных моделей
+
10% дорогих передовых моделей
На практике
Экономика также зависит от длины ввода, длины вывода, вызовов инструментов, повторных попыток, выполнения в песочнице, индексации кода, проверки, ручного анализа, инфраструктуры и хранения данных.
Плата за токены модели — лишь одна из составляющих.
Тем не менее, механизм маршрутизации создаёт мощную возможность для оптимизации, поскольку дорогие модели используются избирательно.
Бенчмарки могут сравнивать отдельные модели в единой тестовой среде.
Продукту нужна оптимизация полного рабочего процесса.
Лучшая система может использовать модель, которая не занимает первое место в отдельных рейтингах, если эта модель обеспечивает лучшую скорость, стоимость, специализацию, предсказуемость, работу с инструментами, эффективность контекста, безопасностную калибровку и совместимость с тестовой средой.
Это похоже на другие производственные системы.
База данных не выбирает один и тот же алгоритм для каждого запроса. Облачный планировщик не размещает каждую нагрузку на самой большой машине. Система безопасности не должна отправлять каждую задачу самой дорогой модели.
Модели кибербезопасности несут особые риски для безопасности.
Та же способность, которая помогает защитникам проверять уязвимости, может помочь атакующим их эксплуатировать.
Поэтому Microsoft ограничила доступ к MAI-Cyber-1-Flash.
В карточке модели указано:
Microsoft заявляет, что модель откалибрована с приоритетом безопасности, оценена командой Microsoft AI Red Team, протестирована с помощью автоматизированных противоборствующих учений, проверена экспертами по безопасности и оценена независимой третьей стороной.
По заявлению, независимая оценка не выявила проблем серьёзного уровня.
Это не доказывает, что модель не имеет рисков. Это объясняет, почему компания начинает с ограниченного развёртывания, а не с неограниченного публичного выпуска.
В карточке модели Microsoft перечислены несколько ограничений.
Модель в основном обучена и оценена на английском языке. На других языках производительность может быть ниже.
Как и другие языковые модели, она может генерировать неточный, неполный или ошибочный код и текст. Выходные данные требуют проверки и верификации.
Модель намеренно откалибрована на осторожное поведение. Когда легитимные защитные запросы неоднозначны или похожи на вредоносную деятельность, защитные механизмы могут срабатывать.
Модель разработана для MDASH. Отдельные результаты не отражают возможности полной системы.
Использование за пределами одобренных защитных операций не поддерживается.
В майском анонсе MDASH компания Microsoft привела примеры из реальных исследований безопасности.
Компания сообщила, что протестировала тестовую платформу на 21 неопубликованном примере драйвера с намеренно внедрёнными уязвимостями. Она заявила, что в контролируемых тестах MDASH выявила все 21 уязвимость с нулевым числом ложных срабатываний.
Microsoft также сообщила, что MDASH помогла выявить 16 CVE, выпущенных в мае.
Вторник патчей Windows в 2026 году.
Это собственные заявления Microsoft о продуктах и исследованиях.
Они более релевантны для развёртывания, чем результаты бенчмарков, поскольку касаются приватного кода, реальных инженерных процессов, проверки уязвимостей, процессов патчинга и проверок командами безопасности.
В то же время выбранные примеры не устанавливают универсальный уровень ложных срабатываний или успешности для всех кодовых баз.
Microsoft представила Project Perception как масштабную агентную систему безопасности.
Её цель — перейти от ИИ, помогающего защитникам, к ИИ, способному взять на себя больше рабочих процессов безопасности, сохраняя при этом ключевые решения под контролем человека.
Project Perception координирует три категории агентов:
| Категория агента | Основные обязанности |
|---|---|
| Красный агент | Моделирует мышление атакующего, выявляет возможные пути вторжения |
| Синий агент | Проводит расследования, рассуждает на основе контекста, обнаруживает и триажирует значимые риски |
| Зелёный агент | Исправляет, укрепляет систему и снижает поверхность атаки |
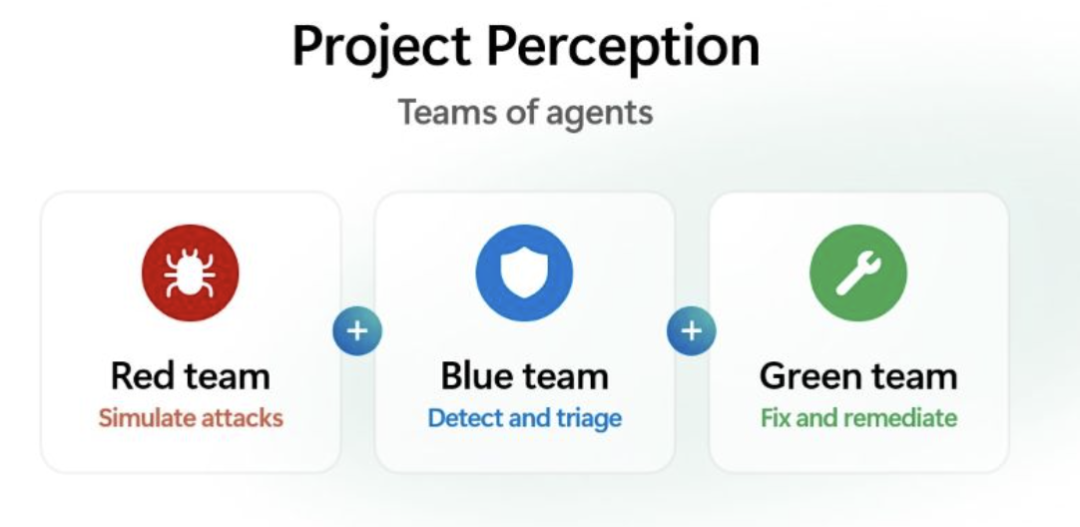
Эти три роли образуют цикл:
Красный агент находит путь
→ Синий агент проверяет и определяет приоритеты
→ Зелёный агент выполняет исправление
→ Система наблюдает результаты
→ Будущие возможности защиты улучшаются
Microsoft заявляет, что Project Perception перешёл в публичную предварительную версию 3 августа 2026 года.
Microsoft описывает систему как несколько взаимосвязанных уровней.
Система наблюдает за конечными точками, идентификацией, облаком, приложениями и другими частями цифровых активов.
Сырые сигналы преобразуются в связанное представление активов, идентификаций, отношений, политик, рисков, действий и исторических событий.
Платформа использует мультимодельную стратегию, включая специализированные сетевые модели, такие как MAI-Cyber-1-Flash.
Координационная платформа управляет моделями, агентами, инструментами, рабочими процессами, тестами, разрешениями и средствами контроля.
Красные, синие и зелёные агенты выполняют специализированную работу по безопасности.
Исполнители преобразуют решения в реальные действия в интегрированных продуктах безопасности.
Эта архитектура выходит далеко за рамки чат-бота. Она направлена на создание постоянно действующей операционной системы безопасности.
Люди по-прежнему несут ответственность за ключевые решения
Microsoft прямо заявляет, что человек сохраняет контроль над операциями с высоким уровнем воздействия.
На странице Project Perception разделение обязанностей описано следующим образом:
Агенты выполняют работу.
Люди принимают решения.
Защитник задаёт цели, стратегии, границы защиты, требования к утверждению, область действия и приоритеты реагирования.
Операции с высоким уровнем воздействия по-прежнему требуют одобрения человека.
Это необходимо, поскольку само исправление уязвимости может нанести вред.
Автоматизированные системы могут отключить легитимные учётные записи, заблокировать производственный трафик, удалить критически важные файлы,
изолировать бизнес-систему, развернуть ошибочный патч или нарушить работу сервисов.
Стоимость ошибочного действия может превышать стоимость пропущенного обнаружения.
Microsoft описывает Security Copilot как диалоговый интерфейс с искусственным интеллектом.
Project Perception позиционируется как более широкая агентная система.
| Концепция продукта | Роль |
|---|---|
| Security Copilot | ИИ, оказывающий помощь через генеративный интерфейс |
| Project Perception | ИИ-агенты, которые непрерывно рассуждают и действуют в рамках рабочих процессов безопасности |
Оба продукта предназначены для совместной работы.
Человек может использовать Copilot для понимания и управления работой, в то время как агенты Perception берут на себя выполнение более длительных операционных процессов.
Microsoft сообщает, что Project Perception использует ценообразование на основе потребления, измеряемое в единицах вычислений безопасности (SCU).
Различные агенты потребляют разные объёмы ресурсов в зависимости от интенсивности выполняемых задач.
Это делает эффективность моделей и рабочих процессов критически важной с экономической точки зрения.
Красные командные учения, быстрая триажная обработка и долгосрочные рабочие процессы исправления могут потреблять разные объёмы ресурсов.
Стратегия мультимодельной маршрутизации, используемая в MDASH, соответствует этой более широкой модели ценообразования.
Если рутинную работу можно поручить меньшим специализированным моделям, тот же бюджет может покрыть больше задач по защите.
Доступ к передовым моделям становится всё менее дефицитным.
Организации всё чаще могут вызывать мощные публичные модели через API.
Дефицитным может стать система, способная определить, соответствуют ли заявления моделей о безопасности действительности.
Такая система требует исполняемой среды, инфраструктуры сборки, контроля версий, генерации доказательств, сравнения патчей, базы знаний по безопасности, песочниц, дедупликации, ручной проверки и отслеживания доказательств.
В сфере безопасности красивых объяснений без доказательств часто недостаточно.
Барьер смещается с:
Доступа к мощным моделям
на:
Надёжный процесс проверки и внедрения результатов работы моделей
Не используйте автоматически самую дорогую модель для каждой операции.
Создайте наборы для оценки и определите, какие задачи могут быть надёжно выполнены меньшими специализированными моделями.
Один агент или модель может генерировать кандидатные результаты. Другой агент, инструмент или детерминированный тест должен их проверять.
Где возможно, требуйте воспроизводимых тестов, а не принимайте текстовые утверждения.
Автоматизируйте сбор, анализ и верификацию. Держите разрушительные или влияющие на производство операции за шлюзами одобрения.
Только цена токенов — неверный показатель.
Дешёвая модель, дающая множество ложных срабатываний, может оказаться дороже с точки зрения эксплуатации.
Полезные метрики включают стоимость одного подтверждённого дефекта, время верификации, долю ложных срабатываний, время ручной проверки, уровень принятия патчей и уровень регрессий.
Поколения моделей быстро сменяют друг друга.
Сохраняйте определения задач, инструменты, верификацию и средства контроля безопасности пригодными для повторного использования при замене базовой модели.
Фиксируйте результаты, а не только предупреждения.
Система должна учиться на том, какие обнаружения являются истинными, а какие меры исправления — эффективными.
В репозитории CyberGym предупреждают о недопустимости размещения сервиса в открытом интернете.
Microsoft также описывает песочницу и сетевую изоляцию для тестирования.
Воспроизведение уязвимостей должно проводиться в контролируемой инфраструктуре.
Серьёзная оценка не должна ограничиваться одним headline-показателем.
Показатель 95,95% важен, но его не следует обобщать за пределами набора доказательств.
Результат получен совместно MDASH, несколькими агентами, двумя уровнями моделей, инструментами и данными.
Результат опубликован Microsoft. Независимое воспроизведение и проверка по-прежнему ценны.
CyberGym измеряет чётко определённую задачу воспроизведения уязвимости.
Поведение при ложных срабатываниях в производственной среде требует отдельного измерения.
Microsoft сохраняет ручное одобрение для критических операций.
MAI-Cyber-1-Flash доступна только в частной предварительной версии для одобренных клиентов MDASH.
Результаты могут различаться в зависимости от языка, категории уязвимостей, кодовой базы, инструментов и структуры бенчмарка.
MDASH — это мультимодельная мультиагентная система Microsoft для обнаружения, проверки, определения приоритетов и исправления уязвимостей в программном обеспечении. Она объединяет специализированных агентов, несколько моделей, инструменты анализа кода, генерацию доказательств, верификацию и корпоративные средства контроля безопасности.
MAI-Cyber-1-Flash — это специализированная разреженная MoE-модель Microsoft для кибербезопасности. Официальная карточка модели указывает 137 миллиардов общих параметров, 5 миллиардов активных параметров, контекстное окно в 256K и ограниченный доступ.
Она предоставляется через MDASH в частной предварительной версии Azure AI Foundry.
Нет. Результат 95,95% относится к полной конфигурации MDASH с использованием MAI-Cyber-1-Flash, GPT-5.4, агентов, инструментов, данных и процесса верификации. Самостоятельные результаты из карточки модели Microsoft на других сетевых бенчмарках отличаются и ниже.
Microsoft заявила, что MAI-Cyber-1-Flash разработана для обработки до 90% задач в маршрутизированном рабочем процессе MDASH. Это не означает, что модель самостоятельно обнаруживает или исправляет 90% всех уязвимостей.
CyberGym в основном оценивает, может ли агент на основе описания уязвимости и кодовой базы до применения патча сгенерировать воспроизводимое доказательство концепции (PoC) для известной реальной уязвимости. Это PoC затем тестируется против уязвимой и исправленной версий.
Этот показатель опубликован Microsoft в объявлении и карточке модели. На момент, описанный в исходной статье, результат не был обновлён в публичных таблицах лидеров бенчмарков, и его следует рассматривать как данные, заявленные самим поставщиком.
Нет публичных записей о загрузке модели. Microsoft указывает, что модель доступна только выбранным клиентам MDASH через частную предварительную версию Azure AI Foundry
Предоставляется клиентом и подлежит проверке и утверждению.
Project Perception — это более широкая агентная система безопасности Microsoft. Она координирует работу красных, синих и зелёных агентов, охватывая рабочие процессы обнаружения, расследования, устранения и укрепления защиты, при этом ключевые решения остаются за человеком.
com/en-us/security/blog/2026/05/12/defense-at-ai-speed-microsofts-new-multi-model-agentic-security-system-tops-leading-industry-benchmark/: технический обзор Microsoft о фреймворке, верификационной архитектуре, исследованиях безопасности и первоначальных результатах CyberGym.
Microsoft сообщает, что после интеграции MAI-Cyber-1-Flash и маршрутизации наиболее сложных случаев на GPT-5.4 система MDASH достигла 95,95% успеха на CyberGym. Компания также сообщает о снижении затрат на 50% по сравнению с предыдущей наиболее производительной конфигурацией моделей.
Этот результат не принадлежит одной модели. Он получен от многомодельной системы безопасности, включающей более 100 агентов, исторические данные о безопасности, специализированные инструменты, генерацию доказательств, верификацию, дедупликацию, песочницы и ручную оркестрацию.
CyberGym в первую очередь тестирует способность воспроизводить известные уязвимости на основе описаний и кода до исправления. Таким образом, этот показатель демонстрирует высокую производительность воспроизведения уязвимостей на данном бенчмарке, а не универсальное обнаружение уязвимостей нулевого дня или автоматизированный уровень устранения.
Project Perception распространяет ту же системную философию за пределы сканирования кода: красные агенты выявляют риски, синие агенты расследуют риски, зелёные агенты устраняют риски, при этом ключевые решения остаются в руках человека.
Главный вывод заключается в том, что передовое превосходство в кибербезопасности смещается от приобретения одной мощной модели к способности маршрутизировать, проверять и эксплуатировать несколько моделей в рамках доверенной системы безопасности.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



