For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 переносит модель смеси экспертов с 35 миллиардами параметров на локальные устройства, включая телефоны. ModelBest и OpenBMB со...

MiniCPM-V 4.7 переносит модель смеси экспертов с 35 миллиардами параметров на локальные устройства, включая телефоны. ModelBest и OpenBMB сообщают о скорости более 13 генерируемых токенов в секунду при использовании около 3 ГБ памяти на iPhone 17 Pro Max благодаря оптимизированному стеку развертывания.
Эта цифра требует контекста. Она не означает, что полная модель на 35B помещается в загрузку размером 3 ГБ или что любой телефон с 3 ГБ оперативной памяти может запускать её на заявленной скорости. Модель передаёт веса экспертов из хранилища и использует планирование, квантизацию и оптимизации инференса, чтобы поддерживать небольшой активный рабочий набор.
Выпуск включает два основных варианта:
| Вариант | Архитектура | Предназначение |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE с 35B общих параметров и примерно 3B активных параметров на токен | Более сильное локальное понимание изображений, документов, нескольких изображений и видео |
| MiniCPM-V 4.7 1B | Небольшая плотная модель; QbitAI описывает её как модель примерно с 1,3B параметров | Визуальные задачи с меньшими ресурсами, OCR и извлечение данных из документов |
Модель 35B-A3B — первая MoE в серии MiniCPM-V. Проект анонсировал версию 4.7 12 октября 2026 года, а 15 октября выпустил головы спекулятивного декодирования DSpark для обоих вариантов.
Репозиторий указывает поддержку развертывания на iOS, Android и HarmonyOS. Также он описывает поддержку платформ Intel, AMD, Arm, Rockchip и Houmo. Фактическая производительность зависит от устройства, формата модели, бэкенда инференса и настроек, поэтому поддержку платформ не следует интерпретировать как одинаковую скорость на разном оборудовании.
Официальная таблица оценки 35B-A3B приводит следующие результаты в режиме Instruct:
| Бенчмарк | 4× визуальное сжатие | 16× визуальное сжатие |
|---|---|---|
| MMBench | 91,72 | 90,87 |
| MMStar | 80,67 | 80,13 |
| MMMU | 80,22 | 80,00 |
| MathVista | 88,00 | 87,30 |
| OCRBench | 91,20 | 90,40 |
| OmniDocBench v1.6 | 94,24 | 93,25 |
| Video-MME, без субтитров | 76,40 | 74,70 |
| LongVideoBench | 68,90 | 67,60 |

Источник: OpenBMB, репозиторий MiniCPM-V. В его таблице объединены публичные отчёты и локальные оценки команды с использованием официальных контрольных точек в режиме Instruct.
Таблица показывает относительно небольшое снижение результатов на ряде задач при переходе к более сильному визуальному сжатию. Например, MMBench снижается на 0,85 пункта, а OCRBench — на 0,80. Потери в других задачах выше, поэтому разработчикам всё равно нужно проверять, важны ли для их рабочей нагрузки мелкий текст, графики или визуальные детали.
Это результаты оценки модели, а не доказательство того, что мобильная конфигурация воспроизводит каждый показатель или что любое пользовательское изображение будет интерпретировано корректно. Они полезны как ориентиры при выборе того, что тестировать.
MoE снижает вычислительные затраты, активируя только выбранных экспертов для токена. Однако она не устраняет необходимость хранить остальных экспертов, поскольку последующие токены и слои могут выбирать других.
На телефоне с ограниченной памятью размещение таких весов во флеш-хранилище делает модель доступной, но постоянное ожидание данных из хранилища может замедлять декодирование. Ограничение маршрутизации фиксированным подмножеством экспертов уменьшает загрузку, но меняет набор экспертов, доступных модели. Вместо этого MiniCPM-V 4.7 пытается перекрыть загрузку вычислениями, сохраняя фактические решения маршрутизатора.
Lookahead Expert Scheduling, или LES, прогнозирует, какие эксперты, вероятно, понадобятся следующему слою, и предварительно загружает их веса. Когда реальный маршрутизатор выбирает экспертов, движок сначала вычисляет выбранных экспертов, которые уже доступны, одновременно загружая остальные необходимые.
Прогноз меняет порядок подготовки и выполнения. Он не заменяет решение маршрутизации модели: эксперты, пропущенные прогнозом, всё равно загружаются и вычисляются. Это различие объясняет, почему метод может повышать скорость, не полагаясь на постоянно сокращённый пул экспертов.
Официальное руководство объединяет LES с детальной послойной квантизацией. Меньшие веса экспертов сокращают передачу данных между хранилищем и памятью, а оптимизированная компоновка делает загрузку эффективнее. Команда сообщает о пятикратном улучшении декодирования на реальных устройствах благодаря своей работе по оптимизации на устройстве; это результат для протестированной конфигурации, а не универсальный множитель.
DSpark добавляет черновую модель, которая предлагает токены для проверки основной моделью. В выпуске предусмотрены специальные черновые головы для обоих размеров. Это ещё один компонент оптимизированного стека, поэтому не следует предполагать, что стандартная контрольная точка в универсальном бэкенде достигнет той же скорости.
В части зрения модель использует раннее сжатие внутри визуального энкодера на основе LLaVA-UHD v4. Раннее объединение визуальных токенов сокращает работу на последующих слоях энкодера. Выбираемые настройки 4× и 16× отражают компромисс между визуальной детализацией и стоимостью инференса.
Документация официального мобильного приложения даёт гораздо более ясное представление о полном развертывании:
| Элемент мобильного развертывания | Задокументированное требование или размер |
|---|---|
| Проверенный телефон для 35B-A3B | iPhone 17 Pro Max с 12 ГБ ОЗУ |
| Рекомендуемый объём ОЗУ устройства для демо 35B-A3B | Не менее 12 ГБ |
| Полная загрузка модели 35B-A3B | Примерно 16,6 ГБ |
| Рекомендуемое свободное хранилище | Примерно 17 ГБ для файлов модели |
| Хранилище экспертов | Отдельная директория experts/, содержащая 40 шардов и манифест |
| Контекстное окно демо по умолчанию | 4K токенов |
Разделённый мобильный пакет отличается от стандартного GGUF с целой моделью. Его основной файл -les зависит от соответствующей директории экспертов, а приложение проверяет согласованность файлов. Более крупные контекстные окна увеличивают память KV-кеша, тогда как меньший кеш экспертов на устройствах с меньшим объёмом ОЗУ может значительно замедлять генерацию.
Небольшой объём рабочей памяти не отменяет потребность в существенном объёме быстрого локального хранилища.
Статья QbitAI демонстрирует локальные примеры на телефоне и планшете, а затем отдельные API-тесты. Сохранять это различие важно: результат API не доказывает, что та же задача выполнялась офлайн на телефоне.
В начальной демонстрации на iPhone модель исследует диаграмму Минарда о русской кампании Наполеона. Получив вопрос о самой низкой температуре и её дате, она определяет −30° по Реомюру 6 декабря 1812 года и переводит значение в −37,5 °C по формуле °C = °Ré × 1,25.
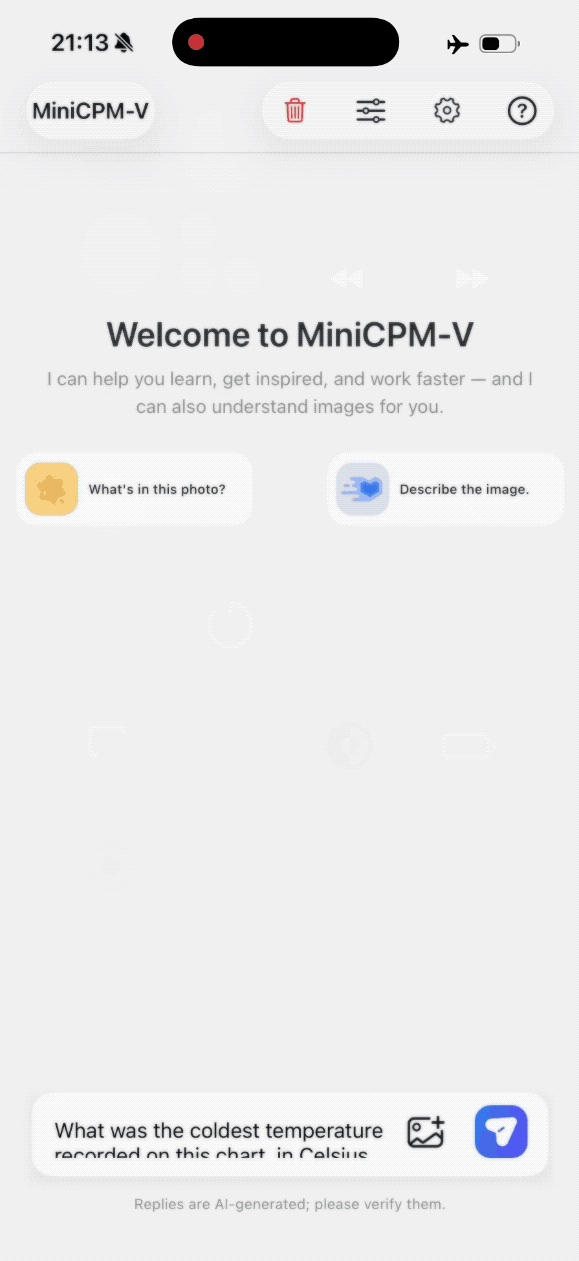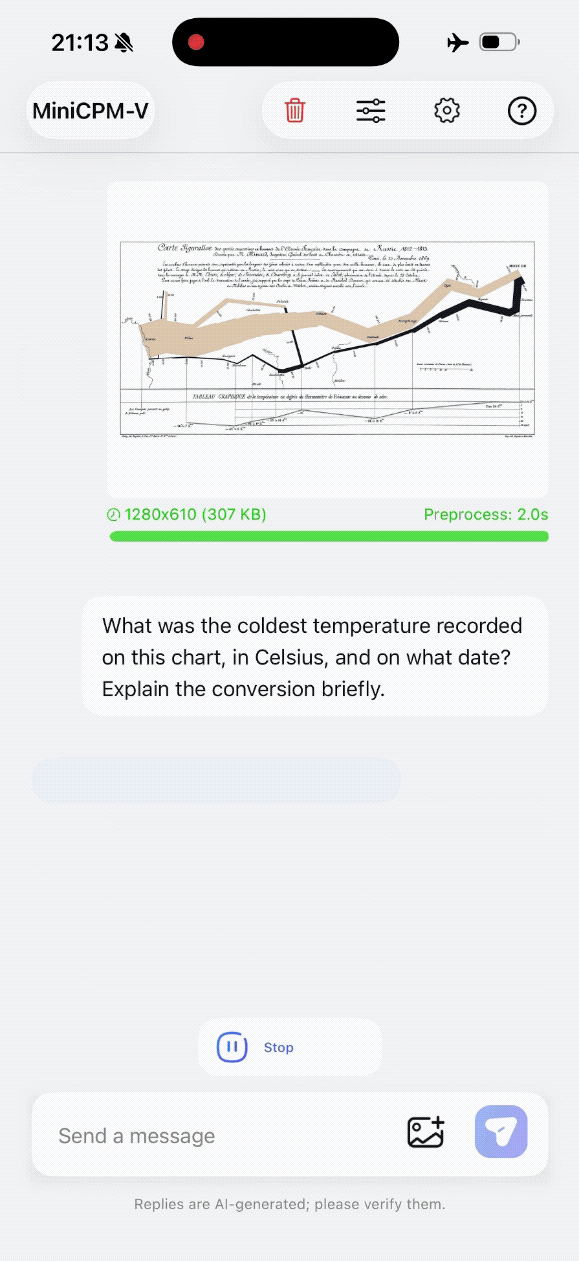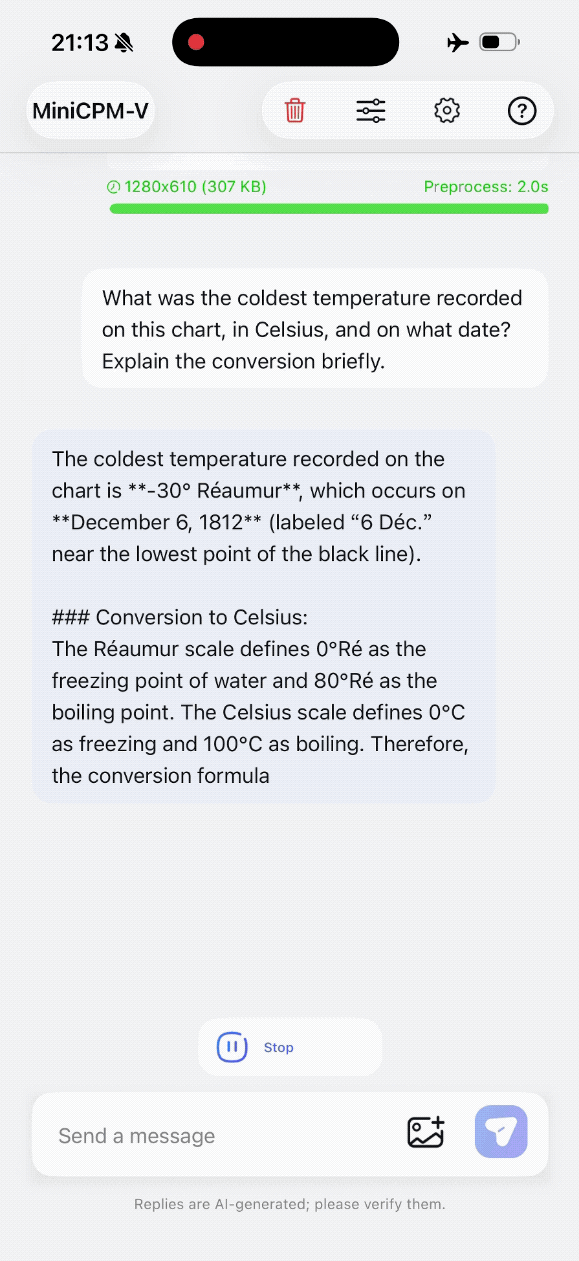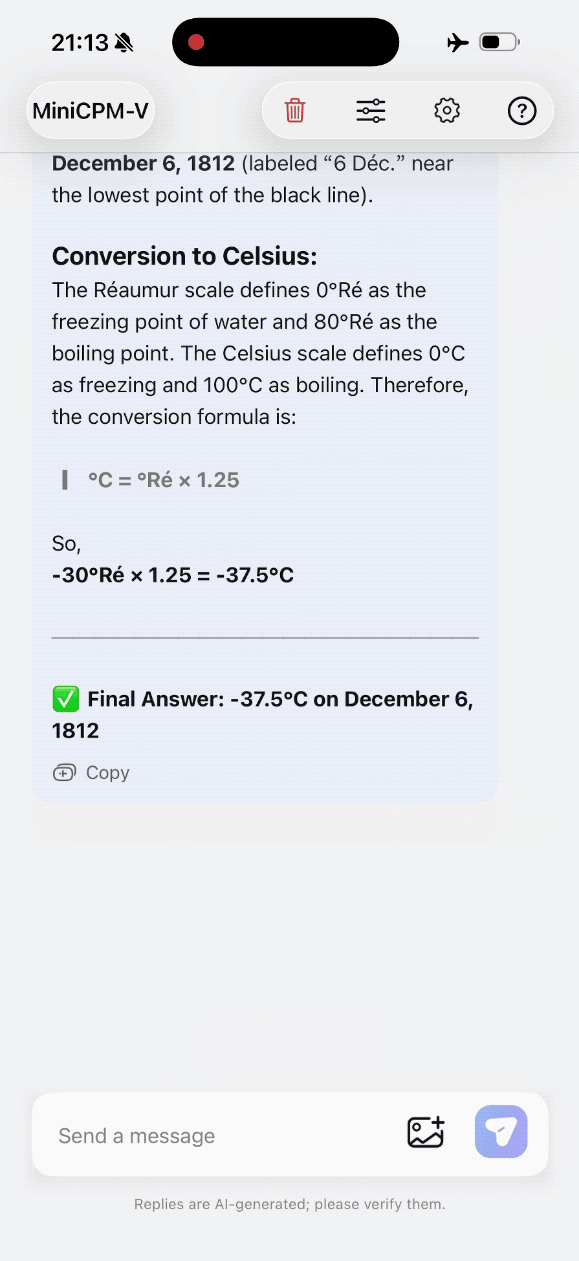
Источник: QbitAI через BAAI; анимированная запись экрана телефона. Источник также сообщает тот же ответ на iPad M4.
Этот пример проверяет не только распознавание текста. Модель должна прочитать диаграмму, сопоставить дату с релевантной точкой, распознать температурную шкалу и выполнить преобразование.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Другой пример объединяет мощности бытовых приборов и время их использования с месячным счётом на 420 кВт⋅ч стоимостью ¥126. Представленный результат оценивает потребление перечисленных приборов в 213,63 кВт⋅ч, или примерно 50,9% счёта, и определяет сокращение использования кондиционера как лучший из трёх предложенных планов экономии.
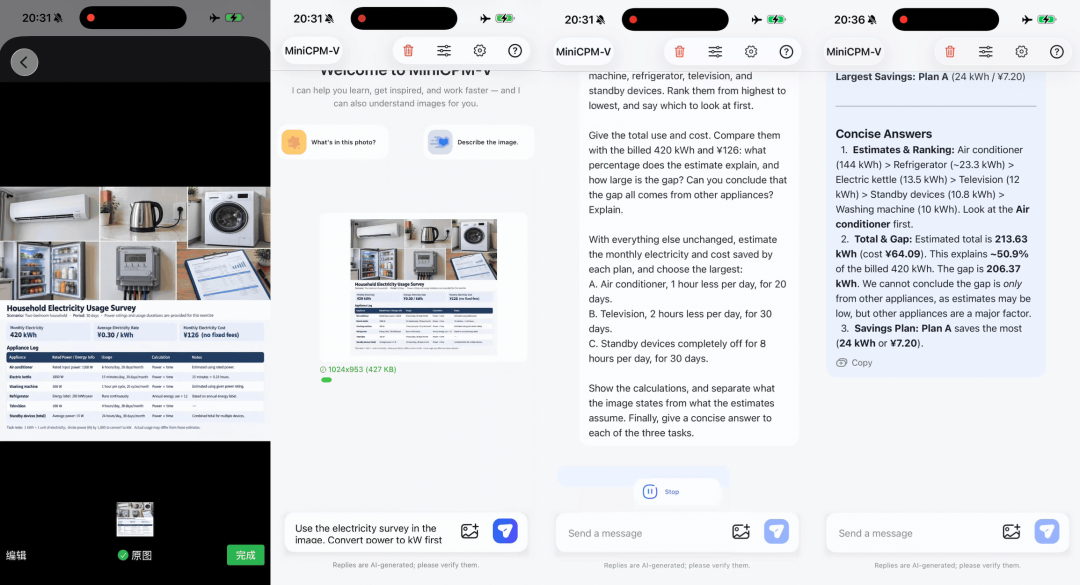
Источник: QbitAI через BAAI. Представленный ответ рассматривает необъяснённое потребление как неопределённое, а не автоматически относит его к другим приборам.
Эта оговорка полезна: оценочные часы работы, фактическая потребляемая мощность и неучтённые устройства могут влиять на сравнение со счётом. Один лишь корректный арифметический итог не устанавливает причину оставшегося потребления.
Меньшая модель показана преобразующей страницу научной статьи в Markdown, включая заголовки, таблицу и математическую нотацию. QbitAI сообщает, что демонстрация заняла менее половины минуты.
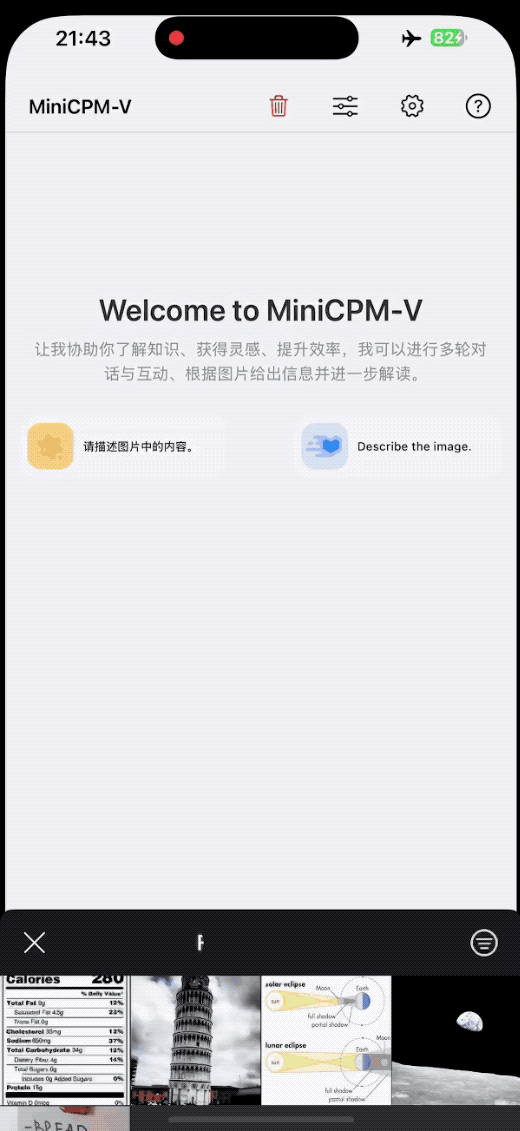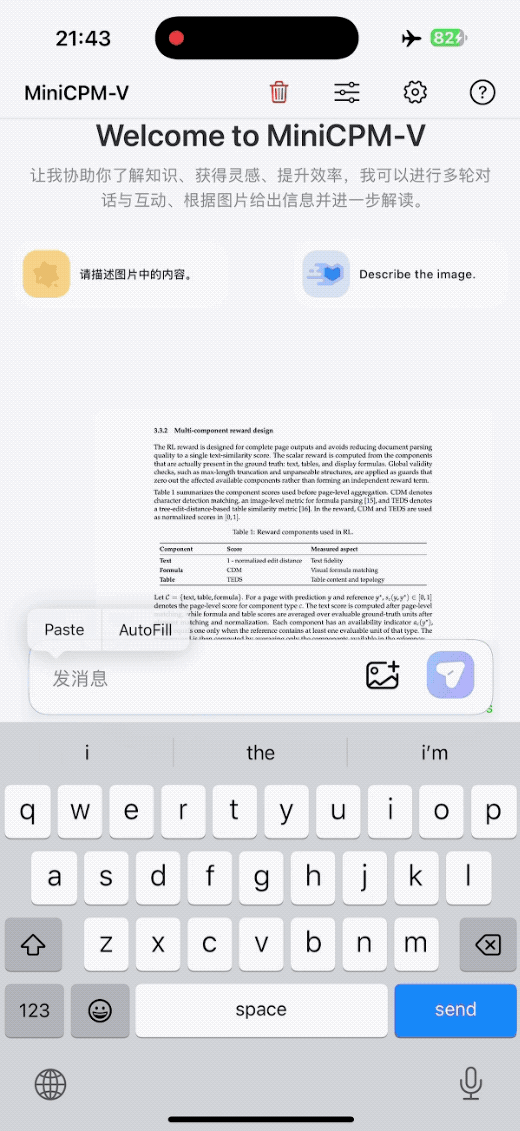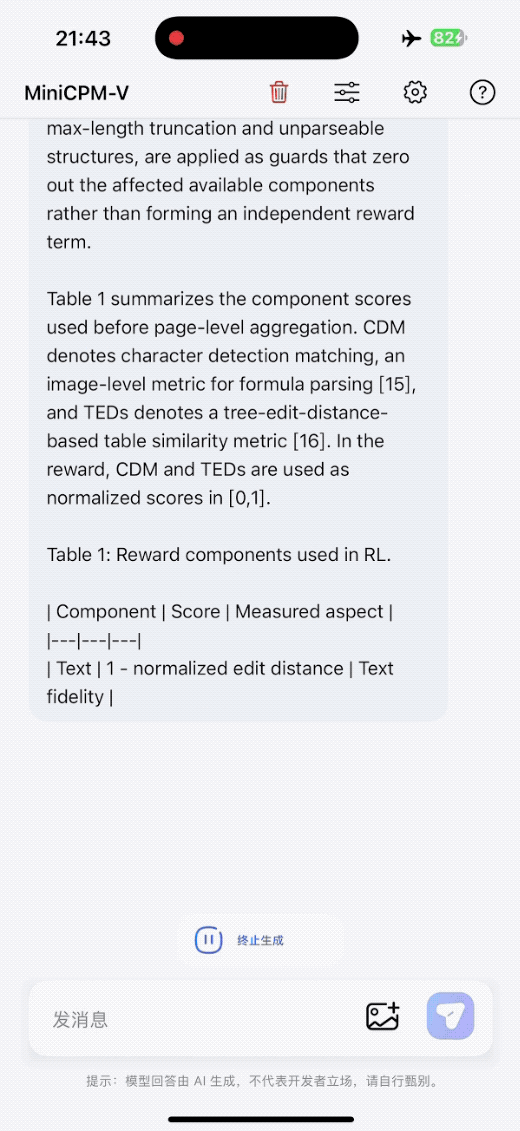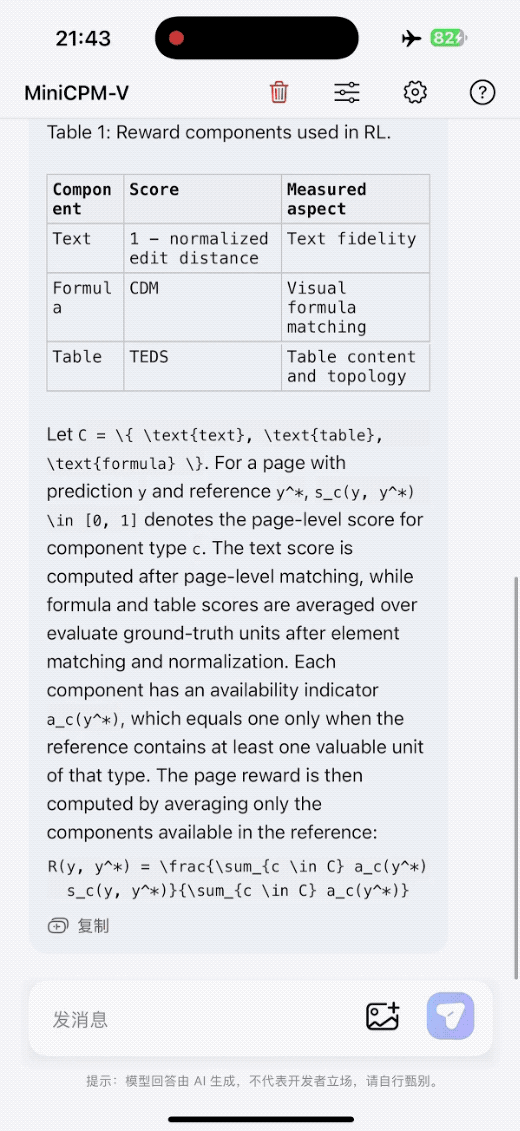
Источник: QbitAI через BAAI; анимированная локальная демонстрация работы с документом.
В отдельных API-тестах статья сообщает о расчёте чека: ¥86,40 минус ¥8 скидок, что соответствует оплате ¥78,40. Также описывается задача о правилах парковки, которая проверяет 90-минутную стоянку с учётом ограничений на время уборки, двухчасового лимита, исключений для жителей и условий повторного въезда. Это иллюстративные тесты, а не систематическое исследование точности.
Связанный выпуск рассматривает проблему забывания при кастомизации. Self-Replay Fine-Tuning генерирует ответы общего домена исходной модели, фильтрует их по качеству и смешивает сохранённые примеры с данными новой задачи во время стандартного контролируемого дообучения.
Метод изменяет обучающие данные, а не архитектуру модели или функцию потерь. Примеры повторного воспроизведения можно сгенерировать до обучения и использовать повторно, сокращая потребность в новых онлайн-роллаутах во время каждого запуска.
Публикация OpenBMB сообщает об обнадёживающих результатах сохранения знаний в экспериментах по подсчёту и OCR документов, включая тесты на более ранних моделях MiniCPM и других семействах моделей. Эти результаты не следует представлять как безусловную гарантию для каждого дообучения версии 4.7. Охват промптов, качество фильтрации и соотношение данных задачи к повторно воспроизводимым данным остаются экспериментальными параметрами.
Репозиторий мобильного приложения предоставляет демо для iOS, Android и HarmonyOS. Для мобильного пути MoE встроенный менеджер моделей загружает соответствующий основной файл, визуальный проектор и шарды экспертов; репозиторий предупреждает, что обычные неразделённые настольные GGUF-файлы не взаимозаменяемы с этим мобильным пакетом.
Для других развертываний руководство 4.7 перечисляет SGLang, vLLM, llama.cpp и Ollama, а также SWIFT и LLaMA-Factory для дообучения. В нём даны ссылки на варианты квантизации, включая GGUF, BNB, AWQ, GPTQ и FP8. Выбирайте артефакт для целевой среды выполнения, а не рассматривайте каждый поддерживаемый формат как готовую мобильную модель.
Офлайн-инференс начинается после локальной установки необходимых приложения и файлов модели. Это устраняет необходимость отправлять каждый запрос инференса в облачную модель, но оставляет разрешения приложения, обработку локальных данных, хранилище и производительность оборудования практическими вопросами развертывания.
Это выпуск мультимодальных моделей от ModelBest и OpenBMB с MoE-вариантом 35B-A3B и небольшими вариантами 1B. Он поддерживает задачи, связанные с изображениями, документами, несколькими изображениями и видео.
Проект демонстрирует оптимизированное развертывание 35B-A3B на iPhone 17 Pro Max. Он хранит в памяти меньший рабочий набор, передавая экспертов из локального хранилища, вместо загрузки всех 35B параметров в ОЗУ одновременно.
Нет. Официальное мобильное демо указывает общий объём загрузки пакета 35B-A3B примерно в 16,6 ГБ и рекомендует около 17 ГБ свободного хранилища. Проверенный iPhone оснащён 12 ГБ оперативной памяти.
Нет. LES прогнозирует экспертов для предзагрузки и сначала планирует тех, кто уже доступен. Фактический маршрутизатор модели по-прежнему выбирает экспертов для вычисления, включая тех, кого прогноз не охватил.
Да, локальные демо выполняют инференс на устройстве после загрузки или установки необходимых файлов. Примеры API в источнике являются отдельными тестами и не должны смешиваться с офлайн-работой.
Нет, демо требует соответствующий разделённый пакет с основным файлом -les, визуальным проектором и шардами экспертов. Документация приложения объясняет, почему стандартные GGUF с целой моделью не обеспечивают такое же поведение при развертывании на телефоне.
MiniCPM-V 4.7 объединяет разреженные вычисления с потоковой передачей экспертов, упреждающим планированием, квантизацией и визуальным сжатием, чтобы сделать более крупную мультимодальную модель практичной на отдельных локальных устройствах. Демонстрации охватывают интерпретацию графиков, преобразование документов и повседневные расчёты, а опубликованные бенчмарки дают отправные точки для оценки.
Ключевое ограничение развертывания заключается в разнице между рабочей памятью, общим объёмом ОЗУ устройства и сохранёнными весами. Результат на телефоне заслуживает доверия как конкретная оптимизированная конфигурация, но не является обещанием, что полная модель на 35B помещается в 3 ГБ или работает одинаково хорошо на каждом устройстве.
Начните с одной фразы и получите полноценный сайт за считанные минуты.