Модели генерации видео быстро развиваются, но большинство из них по-прежнему работают как генераторы кадров. Они создают клип, а затем предо...
Модели генерации видео развиваются стремительно, но большинство из них по-прежнему остаются на уровне генераторов исходного материала. Они создают фрагмент, а затем креатор самостоятельно обрабатывает субтитры, типографику, переходы, цветокоррекцию, музыку, ритм и визуальные эффекты в другом приложении для монтажа.
MiniMax H3 создан именно для изменения этого рабочего процесса.
H3, выпущенный 31 июля 2026 года, представляет собой универсальную мультимодальную видеомодель, которая принимает на вход текст, изображения, видео и аудио в одном контексте. Она может генерировать синхронизированное видео со стереозвуком длительностью от 4 до 15 секунд, с выходным разрешением до 768p или максимум 2K.
MiniMax заявляет, что модель предназначена для участия в полном цикле создания контента, а не только для генерации исходных материалов. Целевые сценарии применения включают рекламу, брендинг, электронную коммерцию, дизайн продуктов, UI и UX, игры, динамические постеры, вступительные заставки и контент для социальных сетей.
MiniMax позиционирует H3 как модель с открытым весом, универсальную мультимодальную видеомодель.
В исходном отчёте этот сдвиг описывается как наступление «момента программирования» для генерации видео. Эта метафора не буквальна, но сама идея ценна: создатели всё чаще могут описывать желаемый результат, предоставлять референсные материалы, проверять вывод и итерировать с помощью инструкций на естественном языке, не выстраивая каждый слой вручную.
Статус открытого веса: MiniMax изначально заявляла, что веса будут опубликованы в течение нескольких дней. Официальная базовая контрольная точка H3-Base теперь доступна на Hugging Face и распространяется по лицензии сообщества MiniMax H3. Однако H3-Context-IR, H3-Regenerate-2K и реализация разреженного внимания не полностью включены в первоначальный выпуск весов.
Первоначальные впечатляющие примеры — это не простые кинематографические кадры. Они включают динамическую типографику, эффекты ручной отрисовки, графику продуктов, анимированные вступительные заставки, музыку, диалоги и переходы.
Всё это обычно рассматривается как отдельные задачи постпродакшена.
Традиционный рабочий процесс мог выглядеть так:
H3 пытается смоделировать множество таких решений в едином процессе.
Одна подсказка может описывать визуальный стиль, последовательность кадров, ритм, экранный текст, режиссуру актёрской игры, звуковой ландшафт и переходы. Референсные файлы могут предоставлять персонажей, продукты, движения, стиль операторской работы, звук, саундтрек или ритм монтажа.
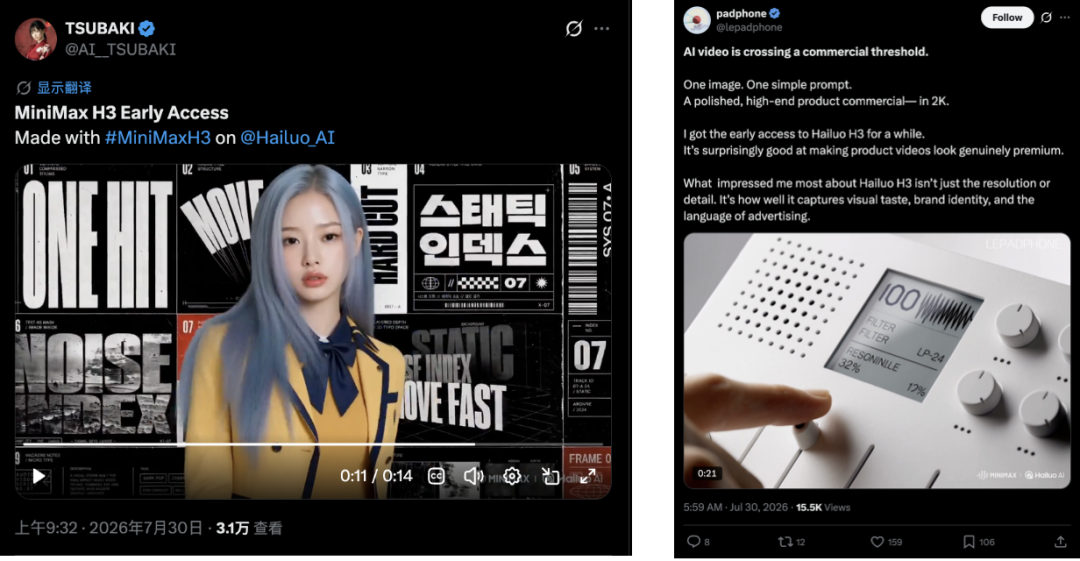
Ранние тестировщики использовали H3 для создания стилизованных видео с персонажами и изысканной рекламы продуктов.
Это не означает, что профессиональное монтажное ПО устарело. Более длинные проекты по-прежнему требуют точного контроля над таймлайном, управления активами, внесения правок, юридических проверок и доставки в различных форматах.
Ключевое изменение в том, что модель теперь может за одну генерацию создавать материалы для коротких видео, которые намного ближе к готовому продукту.
Автор оригинала протестировал H3 через интерфейс Hailuo от MiniMax.
Первый эксперимент — закулисное видео о вымышленной мужской группе, главные роли в которой исполнили известные личности из ИИ-индустрии. Текстовая подсказка описывала ожидаемый тон и стиль монтажа, а H3 генерировала визуальную последовательность.
Затем автор протестировал видео в стиле презентации в духе Apple. Были добавлены лишь короткие стилевые теги, однако результат включал полупрозрачные стеклянные эффекты, градиенты, динамическую графику и презентационный ритм.
Более сложный тест использовал длинную подсказку с описанием трейлера из шести кадров. Каждый кадр имел собственное эмоциональное направление, режиссёрские указания и ритм.
Согласно отчёту, H3 точно следовала последовательности кадров, создав чётко разделённый быстрый монтаж, а не сжав все инструкции в один обобщённый фрагмент.
Такие задачи одновременно проверяют множество способностей:
Результаты по-прежнему остаются субъективной демонстрацией, а не контролируемым бенчмарком. Один успешный пример в соцсетях не гарантирует, что каждая длинная подсказка сработает с первого раза.
Тем не менее, по сравнению со старыми видеосистемами, которые ожидали лишь коротких визуальных описаний, модель явно лучше приспособлена для структурированных творческих инструкций.
Текст исторически был одним из самых уязвимых элементов в AI-генерации видео.
Моделям изображений достаточно корректно отобразить одно слово в одном кадре. Видеомодели должны сохранять одни и те же глифы в десятках кадров, пока объектив, поверхности, освещение и окружающая сцена непрерывно движутся.
Любая мелкая ошибка в одном кадре может привести к мерцанию, орфографическим ошибкам или нестабильной типографике.
Первоначальные тесты показали, что H3 достигла приемлемого уровня в следующих областях:
В официальных материалах MiniMax точный рендеринг текста и брендов также назван ключевой возможностью.
Модель не гарантирует идеальный текст при каждой генерации. Мелкий шрифт, длинные предложения, необычные шрифты и сложные движения всё ещё могут приводить к сбоям.
Более ценным в H3 является то, что она, похоже, моделирует взаимосвязь между текстом и сценой.
В одном примере текст, связанный с бриллиантовым ожерельем, отражал освещение и глубину, а не был простой плоской накладкой. Это ближе к визуальному композитингу, чем к обычному размещению субтитров.
Для коммерческих команд надёжная типографика часто ценнее, чем эффектные кинематографические движения камеры. Реклама, продуктовые релизы, контент для соцсетей — всё это зависит от читаемой информации.
H3 генерирует аудио и видео совместно.
Официальная карточка модели гласит:
Языки диалогов, поддерживаемые MiniMax:
Другие языки также могут работать, но качество будет различаться.
В оригинальной статье также указано, что пользователи могут предоставлять аудио в качестве референса. H3 может комбинировать голосовые фрагменты, музыку или другие аудиоматериалы, а также изображения и видео в качестве ориентиров.
В текущем API аудио не может быть единственным референсным входом — необходимо также предоставить изображение или видео.
Эта интеграция важна, поскольку сгенерированная речь должна соответствовать ритму и эмоциям сцены. Закадровый голос, добавленный на постпродакшене, может звучать правильно, но всё же рассинхронизироваться с движениями лица, ритмом или сменами кадров.
Нативная аудиовизуальная конструкция H3 призвана удерживать эти элементы в согласовании.
MiniMax тарифицирует H3 на основе длительности генерируемого видео.
Текущие международные тарифы с оплатой по факту:
| Выходные данные | Цена |
|---|---|
| Видео 2K | 0,13 доллара за секунду |
| Видео 768p | 0,08 доллара за секунду |
| Повторная генерация с 768p до 2K | 0,05 доллара за секунду вывода |
| Вход H3-Context-IR | 0,90 доллара за миллион токенов |
| Выход H3-Context-IR | 3,60 доллара за миллион токенов |
По текущим тарифам, прямая генерация 10-секундного ролика стоит примерно:
| Разрешение |
Приблизительная стоимость вывода |
|-|-|
| 768p | 0,80 долл. США |
| 2K | 1,30 долл. США |
Биллинг справочных входных данных осуществляется по отдельным правилам:
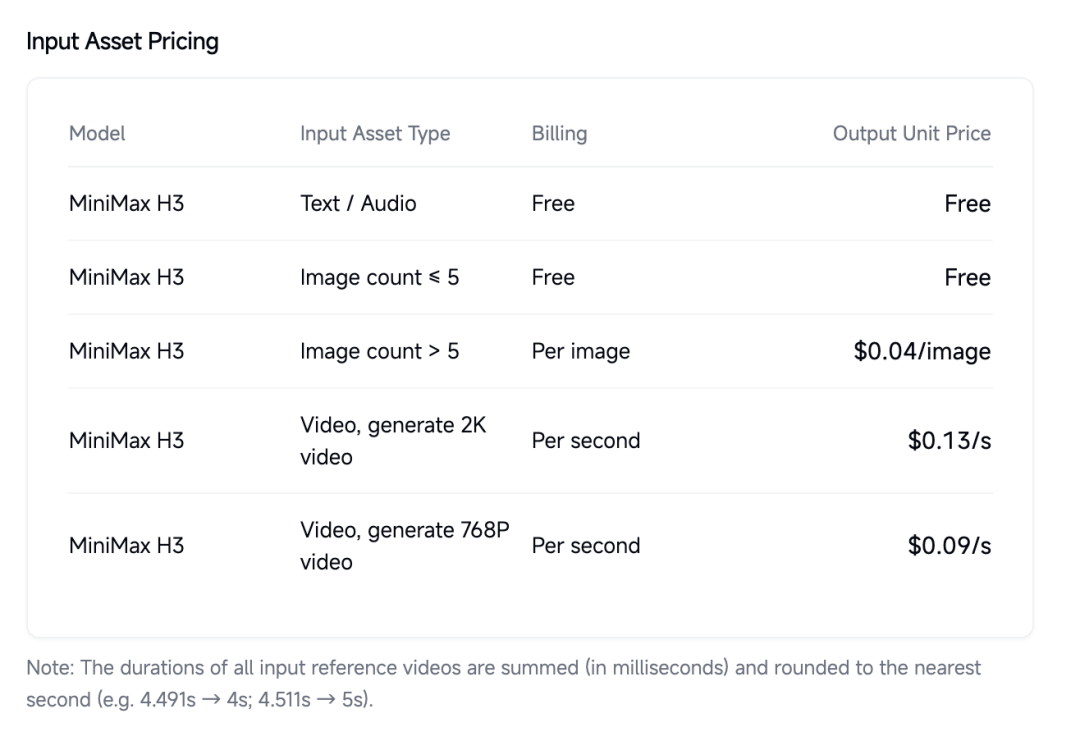
В исходной статье были приведены первоначальные входные материалы H3 и цены на вывод.
На приведённом выше скриншоте указано, что генерация в 768p стоит 0,09 долл. США за секунду. На текущей глобальной странице цен MiniMax этот показатель теперь указан как 0,08 долл. США за секунду, поэтому актуальным источником информации следует считать официальную документацию в реальном времени.
MiniMax утверждает, что при разрешении 2K стоимость H3 составляет менее трети стоимости основных конкурентов, а при разрешении 768p — менее половины стоимости популярных моделей 720p.
Сравнение основано на конкурентах и настройках, выбранных MiniMax. Фактическая стоимость каждого готового видео зависит от количества попыток, справочных материалов, длины фрагмента, повторной генерации и того, можно ли использовать первый результат напрямую.
Artificial Analysis в настоящее время ставит MiniMax H3 на первое место в своём рейтинге видеоредактирования со звуком.
На момент написания этого документа рейтинг выглядит следующим образом:
| Место | Модель | Elo | Цена API |
|---|---|---|---|
| 1 | MiniMax H3 | 1 129 | 7,80 долл. США/мин |
| 2 | Gemini Omni Flash | 1 122 | 6,00 долл. США/мин |
| 3 | HappyHorse-1.0 | 1 096 | 27,04 долл. США/мин |
| 4 | Wan 2.7 | 1 080 | 16,90 долл. США/мин |
| 5 | Dreamina Seedance 2.0 720p | 1 037 | 5,57 долл. США/мин |
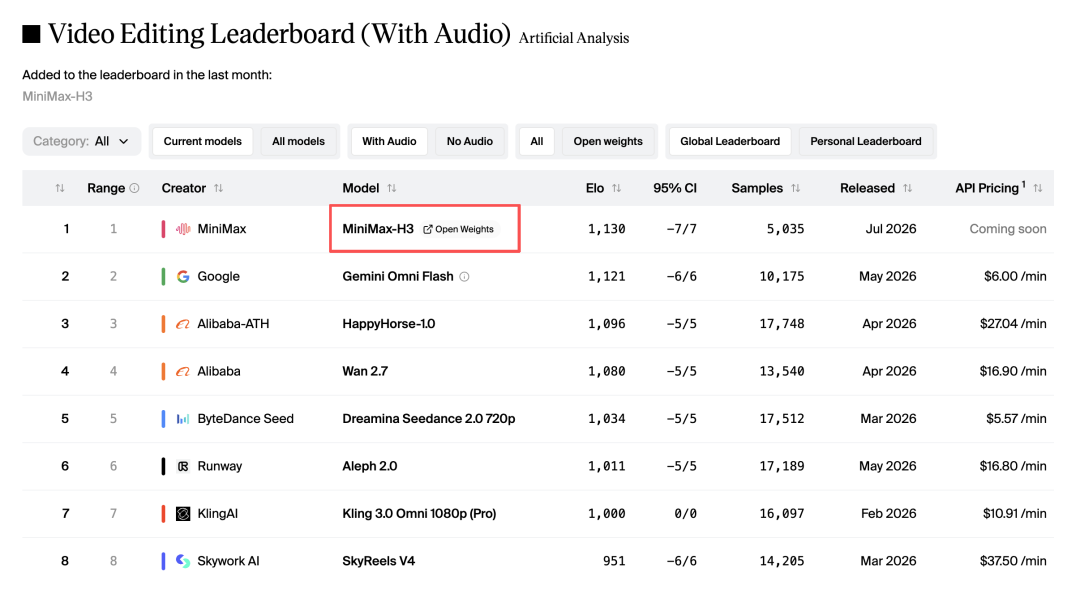
В исходной статье H3 помещён на первое место в рейтинге видеоредактирования Artificial Analysis.
H3 также занимает ведущие позиции в тестах генерации видео из текста и изображений.
Результаты рейтинга могут меняться по мере добавления новых моделей и голосов. Они отражают коллективные предпочтения на определённом наборе промптов и не должны рассматриваться как доказательство того, что модель подходит для всех производственных процессов.
Тем не менее этот результат заслуживает внимания, поскольку H3 сочетает высокую оценку за редактирование с публично опубликованными базовыми весами, тогда как многие ведущие видеомодели остаются закрытыми.
H3 не рассматривает текст, изображения, видео и аудио как независимые модальности ввода.
Он принимает их как единый мультимодальный контекст и пытается понять связь между этими материалами и запрашиваемым выводом.
Например, промпт может попросить H3:
Официальный API в настоящее время поддерживает:
| Тип референса | Ограничение |
|---|---|
| Изображения | до 9 |
| Видеофрагменты | до 3 |
| Аудиофрагменты | до 3 |
| Общее количество смешанных файлов | до 12 |
Справочные видео- и аудиофрагменты должны иметь длину от 2 до 15 секунд, а максимальная суммарная длительность для каждого типа медиа составляет 15 секунд.
Лимит промпта — 7 000 символов.
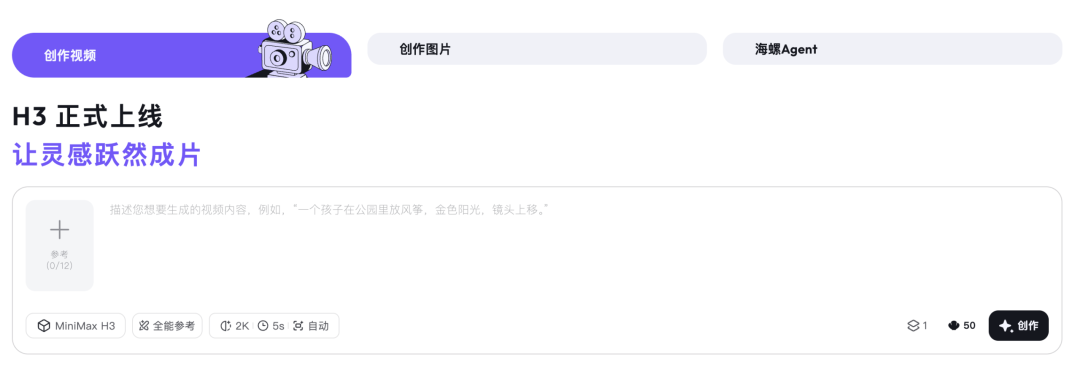
Интерфейс Hailuo объединяет промпт, мультимодальные референсы, разрешение, длительность и соотношение сторон.
Такая конструкция делает справочные материалы более важными, чем написание очень длинных промптов.
Текст может описать желаемый эффект освещения, но справочное изображение передаёт тот же визуальный эффект более непосредственно. Текстовое описание может объяснить действие, но справочное видео показывает точную синхронизацию.
Ценность модели заключается в интерпретации того, как эти референсы следует перекомбинировать, а не просто копировать их.
В исходной статье подчёркивается небольшая, но практичная функция продукта: загруженные материалы отображаются в панели недавно использованных.
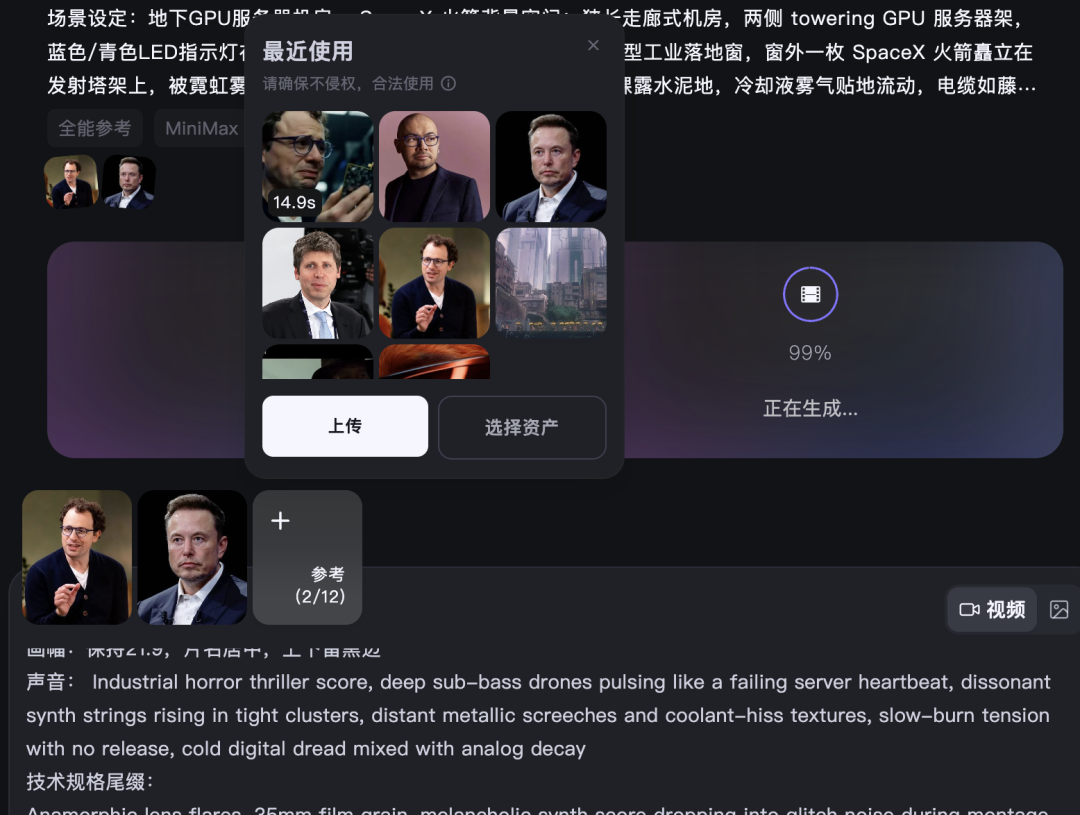
Ранее загруженные изображения и справочные материалы можно повторно использовать из панели недавних материалов.
Это практично для рабочих процессов, в которых многократно используются одни и те же персонажи, продукты, логотипы, фирменные цвета, голоса, визуальные стили, места или динамические референсы.
Это снижает необходимость загружать и систематизировать одни и те же файлы при каждой генерации.
MiniMax описывает H3 как систему, построенную вокруг обобщения задач, а не как набор отдельных экспертных моделей.
Ранние системы генерации обычно разделяли творческую работу на изолированные задачи, такие как текст-в-видео, изображение-в-видео, генерация первого и последнего кадров, референс персонажа, стилевой референс, перенос движения, звуковой референс, видеоредактирование, генерация звуковых эффектов и музыки.
H3 обучен выражать эти взаимосвязи в рамках единой мультимодальной системы с помощью естественного языка.
Полный онлайн-рабочий процесс H3 состоит из трёх основных модулей:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Мультимодальный ввод
      ↓
H3-Context-IR
      ↓
H3-Base (768p)
      ↓
H3-Regenerate-2K
      ↓
Итоговое видео (со стереозвуком)
H3-Context-IR — это управляемая система предобработки и оркестрации.
Она анализирует взаимосвязи между текстом, изображениями, видео и аудио, а затем генерирует структурированное промежуточное представление, которое может использовать H3-Base.
Эта система способна выполнять разбор инструкций, кросс-модальную корреляцию, временной анализ, декомпозицию сцен, моделирование связей аудио и видео, дополнение промпта недостающими деталями и сложные логические рассуждения.
В техническом блоге MiniMax отмечается, что для части исходных материалов требуется около 100 000 токенов вычислительных операций, прежде чем они будут преобразованы в среднее контекстное представление объёмом примерно 4 000 токенов.
H3-Context-IR не входит в первоначальную версию открытых весов, поскольку он опирается на несколько управляемых моделей и сервисов.
MiniMax предоставляет эту функцию через API и публикует руководство по промптам для команд, которые хотят создать собственную систему предобработки.
H3-Base генерирует видео и стереозвук в разрешении 768p.
Различные входные модальности кодируются через соответствующие энкодеры или VAE, упаковываются в единую мультимодальную последовательность и затем подаются в H3-Omni Transformer.
Опубликованные модели включают два контрольных точки для конкретных задач:
| Контрольная точка | Основная задача |
|---|---|
| H3-Base-FL2VA | Текст в видео, а также первый и последний кадры в видео |
| H3-Base-Ref2VA | Генерация аудио и видео на основе референса |
Обе контрольные точки используют точность BF16.
Рабочий процесс 2K в H3 — это не традиционный инструмент суперразрешения.
Результат 768p и исходный мультимодальный контекст подаются обратно в H3, что позволяет модели заново генерировать вывод в более высоком разрешении.
MiniMax называет это внутриконтекстной регенерацией.
Традиционные системы суперразрешения пытаются восстановить недостающие детали из видео низкого разрешения. H3 может повторно использовать исходный промпт и референсную информацию, что может помочь точнее восстанавливать мелкий текст, детали продукта и информацию о сцене.
H3-Regenerate-2K не включён в первоначальную версию открытых весов. Сейчас он доступен через управляемый рабочий процесс MiniMax и API.
MiniMax выделяет четыре ключевые технологии, лежащие в основе системы.
В традиционных видеопромптах текстовая инструкция описывает целевой фрагмент.
В H3 же
субтитры также должны объяснять, как каждый референс соотносится с выходом, взаимосвязи между референсами, какое действие должно происходить из какого видео, чей голос принадлежит какому персонажу, как аудио меняется между кадрами и какой контент следует сохранить или отредактировать.
Язык — это мост, соединяющий эти мультимодальные связи.
MiniMax создал специализированные модели и конвейер полимодального понимания для генерации такого представления.
H3 использует отдельные латентные пространства для видео и аудио.
Визуальный VAE — это темпорально-каузальный видеоавтоэнкодер с 16-кратным пространственным сжатием, 4-кратным временны́м сжатием, 24 латентными каналами и дополнительной обработкой блоков перед Transformer.
MiniMax сообщает, что новый VAE обеспечивает 4-кратное улучшение эффективной длины последовательности по сравнению с его ранними методами, снижая затраты на обучение и инференс, а также способствуя поддержке нативной генерации 2K.
Аудио VAE сначала обрабатывает левый и правый стереоканалы независимо, а затем рекомбинирует их. Он сжимает аудио 32 кГц в латентные токены по 40 Гц на канал.
H3-Omni Transformer — это плотный однонаправленный Transformer.
В официальной карточке модели указано:
MiniMax поясняет, что выходные данные модуляции AdaLN можно предварительно вычислить и закэшировать, поэтому для инференса не требуется загружать эти параметры.
Модель разделяет задачи понимания и генерации во время обучения, чтобы лучше справляться с большими изменениями длины мультимодальных последовательностей. MiniMax сообщает, что это повышает сквозную пропускную способность обучения почти на 30%.
H3 использует нативное разреженное внимание при обучении для снижения затрат на длинные мультимодальные последовательности.
Первоначальная версия открытых весов в настоящее время использует полное внимание для инференса. MiniMax заявляет, что реализация разреженного внимания будет выпущена в будущем обновлении.
Это различие важно для локального развёртывания, поскольку текущая доступная реализация может требовать больше вычислительных ресурсов, чем оптимизированный внутренний стек обслуживания MiniMax.
MiniMax опубликовал веса H3-Base на Hugging Face под лицензией сообщества MiniMax H3.
Репозиторий включает H3-Base-FL2VA, H3-Base-Ref2VA, файлы процессора, файлы токенизатора, текстовый энкодер, веса Omni Transformer, визуальный и аудио VAE, примеры скриптов, инструкции по развёртыванию и воспроизводимые примеры 768p.
Контрольные точки используют полные предобученные веса Qwen3-VL-32B в качестве энкодера H3, а скрытое состояние 50-го слоя подаётся в H3-Omni Transformer.
Модель можно загрузить следующей командой:
hf download MiniMaxAI/MiniMax-H3 --local-dir MiniMax-H3
MiniMax перечисляет SGLang, vLLM, Diffusers и ComfyUI как поддерживаемые или рекомендуемые фреймворки для инференса.
Его пример SGLang использует четыре GPU:
sglang serve \
  --model-path MiniMaxAI/MiniMax-H3 \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \

--host 0.0.0.0 \
  --port 30010 \
  --model-variant fl2va
Это официальный пример, а не универсальное минимальное требование. Фактическая память и производительность зависят от контрольной точки, длительности, разрешения, реализации и оборудования.
Называть H3 просто «полностью открытым исходным кодом» может ввести в заблуждение.
Опубликованные веса H3-Base довольно значительны и поддерживают локальную генерацию 768p. Однако:
Команды должны внимательно изучить лицензию и архитектурные описания перед планированием коммерческого развёртывания.
Для частных брендовых активов этот релиз по-прежнему создаёт значимые возможности. Предприятия могут исследовать, дообучать и развёртывать базовую модель в рамках условий лицензии, не отправляя каждый исходный актив на сторонний генеративный интерфейс.
Официальный API поддерживает три основные режима генерации:
Генеративный рабочий процесс работает в асинхронном режиме:
task_id.Разработчики также могут использовать официальный CLI MiniMax:
npm install -g mmx-cli
mmx auth login
mmx video generate \
  --model MiniMax-H3 \
  --prompt "A polished product commercial with animated typography"
Для мультимодального рабочего процесса с референсами:
mmx video generate \
  --model MiniMax-H3 \
  --prompt "Keep the same character and follow the reference motion" \
  --reference-image character.png \
  --reference-video motion.mp4
Перед использованием в производственной среде следует ознакомиться с документацией CLI и API, поскольку ограничения ввода, тарификация и поддерживаемые параметры могут меняться.
H3 не устраняет все задачи постпродакшена.
Профессиональный маркетинговый проект может по-прежнему требовать покадрового точного монтажа, утверждения у клиента, лицензированной музыки, юридических проверок и проверки авторских прав, точного соответствия бренду, непрерывности длинных сцен, экспорта в нескольких соотношениях сторон, режиссуры живых актёров и доставки с управлением цветом.
H3 меняет отправную точку.
Вместо немого материала создатель получает короткий актив с монтажом, звуком, типографикой, озвучкой, эффектами и узнаваемым визуальным направлением.
Это делает модель особенно полезной для:
Концептуальное видео
Модель также показывает, что генерация видео становится всё менее привязанной к конкретным задачам. Единая система может всё лучше интерпретировать набор творческих материалов и выполнять более полный творческий бриф.
MiniMax H3 — это универсальная мультимодальная система генерации и редактирования видео. Она принимает на вход текст, изображения, видео и аудио и может создавать видео длительностью от 4 до 15 секунд с синхронизированным стереозвуком.
Да. Управляемый API поддерживает вывод в 2K. Полный процесс сначала использует H3-Base для генерации результата в 768p, а затем применяет H3-Regenerate-2K для повторной генерации видео в более высоком разрешении с сохранением исходного контекста.
MiniMax выпустил веса H3-Base в соответствии со своей лицензией для сообщества. Полная онлайн-система не полностью открыта, поскольку H3-Context-IR, H3-Regenerate-2K и разреженный инференс внимания не полностью включены в первоначальный релиз.
Да, опубликованные контрольные точки H3-Base можно развернуть локально для генерации в 768p. MiniMax предоставляет примеры для SGLang, а также ссылки на рабочие процессы vLLM, Diffusers и ComfyUI, но модель требует значительных ресурсов GPU.
Текущая глобальная цена составляет 0,13 доллара США за секунду генерации в разрешении 2K и 0,08 доллара за секунду в 768p. Ссылочные изображения сверх первых пяти, ссылочные видео, повторная генерация и H3-Context-IR могут привести к дополнительным расходам.
Да. H3 совместно генерирует видео и нативное стереоаудио с частотой 32 кГц, включая диалоги, музыку и звуковые эффекты.
API поддерживает до девяти изображений, трёх видео и трёх аудиоклипов, всего до 12 смешанных файлов. Также существуют ограничения по длительности и размеру файлов.
MiniMax разработал H3 для рекламы, брендинга, электронной коммерции, дизайна продуктов, UI и UX и других коммерческих целей. Командам следует по-прежнему проверять выходные данные, подтверждать права на все входные материалы и ознакомиться с лицензией сообщества и условиями платформы.
Цены: текущие цены на генерацию H3, ссылочные входные данные, повторную генерацию и Context-IR.
MiniMax H3 выводит ИИ-видео на новый уровень — от простой генерации отдельных клипов к интеграции в одной системе визуальной генерации, логики монтажа, оформления субтитров, диалогов, звуковых эффектов, музыки и мультимодальных ссылок.
Управляемая версия может генерировать видео длительностью от 4 до 15 секунд со встроенным нативным стереозвуком и разрешением до 2K. В настоящее время она занимает первое место в рейтинге редактирования видео Artificial Analysis и доступна через глобальный API MiniMax по цене 0,13 доллара за секунду генерации в 2K.
MiniMax выпустил контрольные точки H3-Base, поддерживающие локальную генерацию в 768p и последующую разработку. Однако, поскольку Context-IR, повторная генерация в 2K и разреженный инференс внимания ещё не полностью открыты, полный управляемый рабочий процесс остаётся частично закрытым.
Ключевое изменение H3 заключается не просто в создании более качественных изображений, а в переходе от генерации одного клипа к пониманию и выполнению полного брифа на создание короткого видео.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



