For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Запуск Meta Muse Wonder дал два совершенно разных вида доказательств: высокие результаты в бенчмарках и демонстрации разработчиков, которые ...
Запуск Meta Muse Wonder дал два совершенно разных вида доказательств: высокие результаты в бенчмарках и демонстрации разработчиков, которые иногда выглядели значительно менее убедительно. Китайский материал Xinzhiyuan, перепечатанный на BAAI Hub, превращает этот разрыв в резкую критику оптимизации, ориентированной на бенчмарки.
Разногласия заслуживают внимательного изучения, однако неудачная демонстрация не доказывает мошенничество. Для справедливой оценки необходимы точный вариант модели, тестируемая задача, агентное ПО, работающее вокруг модели, и источник каждого результата.
Источник описывает, как разработчики сравнивали результаты браузерных или 3D-игр и сочли Wonder разочаровывающей на фоне конкурирующих моделей. Эти демонстрации легко проверить: зрители могут увидеть, работает ли движение, ведёт ли себя камера разумно и похожа ли сцена на запрошенный результат.
Источник также цитирует Александра Вана из Meta, который заявил, что команда не обучала модель специально на демонстрационных 3D-играх, и призвал разработчиков попробовать реальную работу с кодом. Это высказывание передано Xinzhiyuan; его не следует превращать в универсальное объяснение для каждой неудачной задачи по программированию.
Демонстрации игр остаются значимым доказательством. Они проверяют реальное сочетание генерации кода, визуальной оценки, взаимодействия и отладки. Их ограничение — в масштабе: один промпт и один запуск не могут установить производительность при сопровождении репозиториев, работе в терминале или длительных программных проектах.
Основной анонс Meta представляет Muse Wonder и Muse Wonder Full как модели для персональных и профессиональных агентов. Wonder доступна через Meta Model API и Muse Code; Full доступна подписчикам Muse Code.
В анонсе Active Memory определяется как сохранение важного контекста между разговорами и его извлечение, когда он релевантен. Active Focus описывает устойчивое продвижение к цели, включая попытки альтернативных подходов, адаптацию к новой информации, запрос уточнений и проверку перед важными действиями.
Эти описания помогают понять, что Meta пытается улучшить. Это заявления о продукте и оценке, а не гарантии того, что агент выполнит каждую порученную задачу.
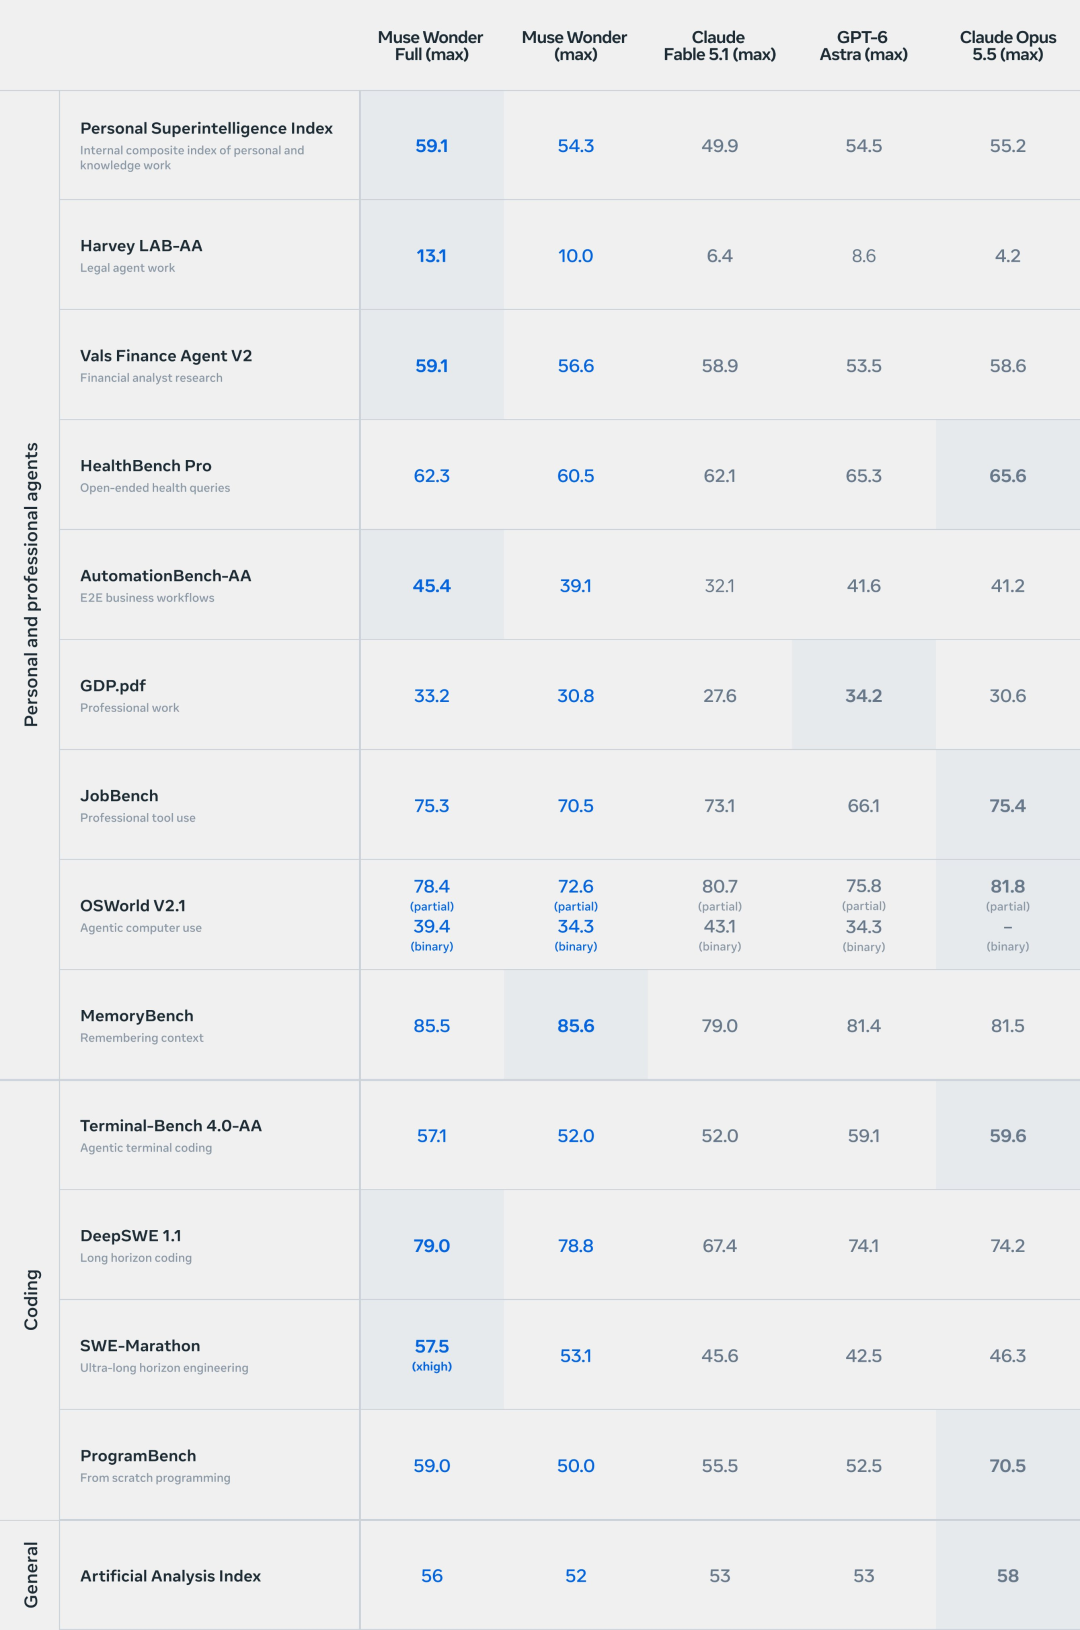
Опубликованная Meta сравнительная таблица, воспроизведённая Xinzhiyuan на BAAI Hub. Значения относятся к конфигурациям и условиям оценки, указанным в материалах запуска.
Таблица не показывает универсального победителя. Её результаты по кодингу значительно различаются в зависимости от задачи:
| Оценка | Muse Wonder Full | Claude Opus 5.5 | Направление сравнения |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full получает более высокий балл |
| SWE-Marathon | 57.5 | 46.3 | Full получает более высокий балл в заявленной конфигурации |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus получает более высокий балл |
| ProgramBench | 59.0 | 70.5 | Opus получает более высокий балл |
Сопроводительные материалы Meta также сообщают о сильных сторонах в памяти и агентных рабочих процессах, наряду с областями, где лидируют другие модели. Наличие сильного результата в длительной работе с ПО не означает наилучшую производительность при создании приложения с нуля.
Условия оценки особенно важны для SWE-Marathon. В карточке модели Meta описано, что конкуренты запускались через Codex и Claude Code, тогда как выделенный результат Wonder Full использует конфигурацию xhigh. Это значимые результаты на уровне продукта, однако они не являются единым контролируемым экспериментом с одинаковой агентной средой для каждой модели.
В блоге Meta о запуске прямо обсуждается разрыв между знакомыми бенчмарками и незнакомыми задачами. Анализ сравнивает производительность внутри распределения и вне распределения по мере увеличения вычислений во время тестирования, утверждая, что более сильная базовая модель Wonder Full улучшает перенос достижений постобучения на другие задачи.
Это релевантное техническое доказательство позиции Meta. Однако это всё же оценка, выбранная и представленная разработчиком модели, и она не разрешает каждую претензию к результату, созданному разработчиком.
Аналогично, сообщения о разочаровывающей демонстрации игры не доказывают загрязнение бенчмарков или фальсификацию. Для подтверждения таких утверждений потребовались бы более прямые доказательства о данных, методах или манипулировании результатами, чем предоставляет исходная статья.
Независимый обзор Artificial Analysis сообщает оценки Intelligence Index v4.3, равные 56 для Wonder Full и 52 для Wonder при максимальном уровне рассуждений. Следовательно, пользователь API, тестирующий обычную Wonder, оценивает другое предложение из линейки запуска, а не модель Full, возглавляющую несколько таблиц.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Artificial Analysis указывает контекстное окно в один миллион токенов для каждого варианта. Для Wonder сервис сообщает $4 за миллион входных токенов, $0.20 за кэшированный вход и $20 за выходные токены. Его оценка в $4.52 на одну задачу Intelligence Index является стоимостью, зависящей от конкретной оценки, а не фиксированной ценой для любого пользовательского запроса.
Источник также критикует отсутствие публичного выпуска весов с открытым доступом. Ни проверенный анонс запуска, ни описание доступа не предусматривают загружаемый выпуск весов Wonder, поэтому разработчикам не следует предполагать, что доступен локальный самостоятельный хостинг.
Meta сообщает, что Wonder обучалась в её дата-центре Prometheus гигаваттного масштаба. Статья BAAI связывает запуск с высказываниями Марка Цукерберга и Вана о масштабе инвестиций в ИИ-инфраструктуру и роли персональных агентов в коммерции.
Эти высказывания описывают более широкую стратегию. Их не следует преобразовывать в подтверждённую цифру затрат на обучение именно этой модели. Аналогично, пример агентов, ведущих переговоры или покупающих услуги, — это видение поведения продукта, а не доказательство того, что каждый такой рабочий процесс уже развёрнут.
Следующий полезный шаг — воспроизводимое тестирование: сохраняйте требования неизменными, указывайте вариант модели и настройку рассуждений, документируйте среду и измеряйте выполненную работу. Это позволяет надёжнее выявлять и сильные, и слабые стороны, чем один громкий балл или одна заметная неудача.
Нет. Они могут показывать слабую производительность на продемонстрированных задачах, но доказательство мошенничества в бенчмарках требует отдельных свидетельств о методах оценки, данных или манипулировании результатами.
Это разные предложения в линейке моделей с различными путями доступа при запуске. Artificial Analysis сообщает 52 для Wonder и 56 для Full при максимальном уровне рассуждений в Intelligence Index v4.3.
Приведённая таблица даёт разные ответы для разных оценок программирования. Full лидирует в DeepSWE 1.1 и в заявленной конфигурации SWE-Marathon, тогда как Opus лидирует в Terminal-Bench 4.0-AA и ProgramBench.
Только с оговоркой о конфигурации. В карточке модели Meta описано, что конкуренты использовали свои продукты для кодинга, поэтому наряду с базовыми моделями на результат могут влиять различия в поведении агентов и инструментах.
Обзор запуска от Artificial Analysis сообщает $4 за миллион входных токенов, $0.20 за миллион кэшированных входных токенов и $20 за миллион выходных токенов. Перед внедрением в продакшен проверьте актуальные условия тарификации у поставщика.
Публичная загрузка весов не была подтверждена материалами запуска, которые были проверены. Документированные способы доступа — API и Muse Code для Wonder, а для Full — доступ по подписке Muse Code.
Результаты запуска Muse Wonder показывают линейку моделей с высокими показателями агентов и программной инженерии, неравномерными результатами в разных категориях кодинга и разными путями доступа для обычного варианта и варианта Full.
Полезный вывод зависит от задачи: проверяйте точную модель и тестируйте выполненную работу, прежде чем принимать как заявление об универсальной победе, так и обвинение в мошенничестве.
Начните с одной фразы и получите полноценный сайт за считанные минуты.