For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
Запуск Meta Muse Wonder выводит две близко названные модели в конкурентное поле. Поэтому первый вопрос оказывается необычно практичным: вы р...
Запуск Meta Muse Wonder выводит две близко названные модели в конкурентное поле. Поэтому первый вопрос оказывается необычно практичным: вы рассматриваете Muse Wonder или Muse Wonder Full?
По данным Artificial Analysis, в Intelligence Index v4.3 модель Wonder получила 52 балла, а Wonder Full — 56 баллов; обе оценки приведены при максимальном уровне усилий рассуждения. Китайская статья, опубликованная повторно на BAAI Hub, акцентирует внимание на том, что Full опережает заявленный результат Gemini 4 Argon в 53 балла. Это сравнение бенчмарков для конкретных конфигураций моделей, а не доказательство того, что какой-либо вариант Wonder побеждает во всех реальных задачах.
В официальном анонсе Meta говорится, что Muse Wonder доступна через Meta Model API и Muse Code. Muse Wonder Full доступна подписчикам Muse Code. Компания сообщает, что позднее Wonder будет поддерживать возможности в её ассистенте Muse, начиная с подписчиков.
| Модель | Intelligence Index v4.3, максимальный уровень усилий | Описанный Meta доступ на момент запуска |
|---|---|---|
| Muse Wonder | 52 | Meta Model API и Muse Code |
| Muse Wonder Full | 56 | Подписка Muse Code |
Эти различия важны при попытке воспроизвести опубликованный результат. Доступ к Wonder через API — не то же самое, что оценка Full через продукт для программирования.
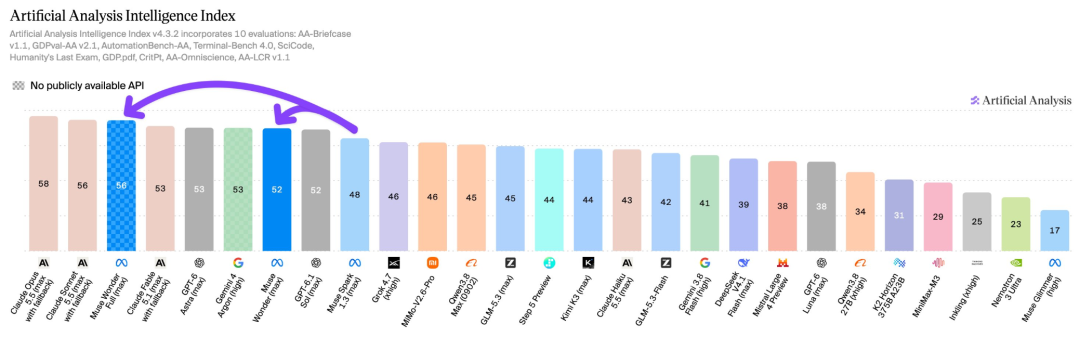
Диаграмма: Artificial Analysis, воспроизведённая и аннотированная в отчёте QbitAI на BAAI Hub. Она отражает сравнение, приведённое источником на момент публикации.
Artificial Analysis также сообщает о контекстных окнах в один миллион токенов для обоих вариантов. В его анализе запуска указаны API-цены Wonder: 4 доллара за миллион входных токенов, 0,20 доллара за миллион кэшированных входных токенов и 20 долларов за миллион выходных токенов. Для Full в этом анализе не указана цена за токены, поскольку на момент запуска доступ к ней предоставлялся через продукт по подписке.
Статья BAAI подчёркивает более ограниченный доступ к Gemini 4 Argon на момент публикации. Условия доступности могут быстро меняться, поэтому это историческое сравнение не следует трактовать как обещание текущих правил доступа у какого-либо из поставщиков.
Meta представляет Wonder как семейство моделей для персональных и профессиональных агентов. В её анонсе две повторяющиеся возможности имеют отдельные названия.
Активная память связана с сохранением важной информации между разговорами и извлечением деталей, релевантных новой задаче. Для персонального ассистента это может означать использование уже известного предпочтения без необходимости каждый раз просить пользователя повторять его.
Активная концентрация связана с продолжением движения к цели, когда первая попытка оказывается неудачной. Meta описывает поиск альтернативных подходов, адаптацию к новой информации, запрос уточнений при необходимости и проверку перед важными действиями.
Для программирования необходимы оба типа поведения. Агенту может потребоваться сохранять исходное ограничение, проходя через несколько циклов правок, сбоев тестов и доработок. По словам Meta, модели Wonder обучались на разнообразных задачах, требующих продолжительной работы, с опорой на подход к масштабированию, использованный для Muse Spark.
Источник противопоставляет высокие результаты в бенчмарках программной инженерии неоднозначным отзывам о демонстрациях 3D-игр. Это разные типы нагрузки, даже если в обоих случаях модель должна писать код.
DeepSWE 1.1 тестирует работу с существующим программным обеспечением, тогда как ProgramBench относится к созданию программ с нуля. В таблице сравнения из материалов Meta о запуске указаны 59,0 для Wonder Full и 70,5 для Claude Opus 5.5 в ProgramBench. Следовательно, модель может лидировать в одном типе инженерных задач и отставать в другом.
В исходном отчёте также описаны разработчики, предпочитавшие Opus для демонстрации Unity, и другой разработчик, сообщивший об успешном запуске Wonder Full. Это отдельные наблюдения с разными промптами, средами и критериями успеха. Их расхождение — повод изучить настройку задачи, а не усреднять отдельные отзывы в универсальный рейтинг.
Ещё одно уточнение важно для длительных тестов программного обеспечения: в карточке модели Meta указано, что её сравнение SWE-Marathon использует кодовых агентов конкурирующих поставщиков, включая Codex и Claude Code. Это делает результат релевантным для сквозного сравнения продуктов, но не является контролируемым сравнением, в котором каждая модель использует одну и ту же агентную среду.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Такой подход даёт практическое дополнение к заголовочному бенчмарку. Модель, которая создаёт менее впечатляющую игровую демонстрацию, всё равно может быть полезна для задач сопровождения, а высокий индексный балл не оправдывает неработающий результат.
Это полный вариант в семействе моделей Meta Muse Wonder. В анонсе запуска Meta указывает его доступность для подписчиков Muse Code, тогда как обычный вариант Wonder также имеет API-доступ.
В приведённом источником сравнении Intelligence Index на момент запуска Wonder Full получила 56 баллов, а Gemini 4 Argon — 53. Это описывает конкретный индекс и показанные конфигурации, а не результат для всех задач и оценок.
В анонсе Meta различаются два пути доступа. Wonder указана для API и Muse Code, а Full — для подписчиков Muse Code.
В материалах Artificial Analysis о запуске указаны 4 доллара за миллион входных токенов, 0,20 доллара за кэшированный вход и 20 долларов за выходные токены. Это цены, заявленные на момент публикации, поэтому перед развёртыванием проверьте условия биллинга поставщика.
Активная память связана с извлечением полезной информации из предыдущих разговоров. Активная концентрация связана с устойчивым выполнением задачи, включая поиск другого подхода при возникновении препятствия.
Они показывают слабость в конкретных задачах и настройках. Более широкая оценка программирования также включает сопровождение репозиториев, отладку, использование инструментов и выполнение требований в длительных рабочих процессах.
Высокие оценки Wonder Full на момент запуска делают её релевантным вариантом для требовательной агентной работы. Обычная модель Wonder имеет другой балл и иной путь доступа, поэтому название варианта должно сопровождать любое утверждение о производительности.
Используйте рейтинги бенчмарков, чтобы выбрать кандидата для тестирования, а затем сравните точную модель на работе, которую она должна выполнить для вас.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



