For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/openai-28-day-sprint-day-1-gpt-6-speed-bo-37dfc44c.md.
OpenAI начала октябрь с необычного публичного обязательства Тибо «Tibo» Соттьо, который руководит работой над продуктами Codex и ChatGPT.
OpenAI начала октябрь с необычного публичного обязательства Тибо «Tibo» Соттьо, который руководит работой над продуктами Codex и ChatGPT.
В течение 28 дней команда заявила, что будет ежедневно делать одно из двух: выпускать понятное улучшение, важное для большинства пользователей Codex или ChatGPT Work, либо предоставлять полный сброс лимитов использования.
Первое обновление вышло 5 октября 2026 года. OpenAI сообщила, что примерно на 50% оптимизировала стандартную скорость ответов GPT-6 Astra и GPT-6.1 Sol для подписчиков в продуктах OpenAI и у поддерживаемых партнёров, использующих Sign in with ChatGPT.
Это звучит как очевидное улучшение. Но реакция оказалась сложнее.
Объявление об ускорении совпало ещё с тремя изменениями, важными для продвинутых пользователей: OpenAI представила новый визуальный рекламный формат для ChatGPT, опубликовала свой план внедрения текстовых водяных знаков в ЕС и изменила экономику старших подписок Pro. Затем новый отчёт SemiAnalysis заявил, что подписки Anthropic сейчас дают существенно больше эквивалентной API-ценности для некоторых распространённых уровней моделей.
В результате первый день выглядел не столько как безоговорочная победа, сколько как срез компромиссов, которыми OpenAI пытается управлять: более быстрые модели, растущие инфраструктурные расходы, новая монетизация, соблюдение требований регулирования и пользователи, всё чаще сравнивающие каждый лимит и токен с предложениями конкурентов.
28-дневный спринт начался с простого правила.
Тибо заявил, что в следующие 28 дней OpenAI будет либо выпускать одно улучшение, явно актуальное для большинства пользователей Codex и Work, либо предоставлять полный сброс.
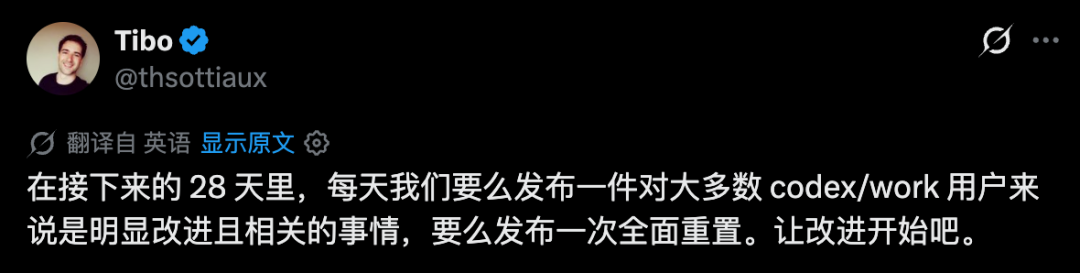
Команда также сузила ближайшие приоритеты до нескольких направлений:
Это обязательство прозвучало после периода особенно заметного недовольства скоростью моделей, сбоями и меняющимися лимитами использования.
Для дня 1 OpenAI выбрала производительность инференса.
Первым выпущенным изменением стала оптимизация стандартной скорости для GPT-6 Astra и GPT-6.1 Sol.
В текущей статье Справочного центра OpenAI это улучшение описывается как приблизительное увеличение скорости генерации текста на 50% при настройке стандартной скорости.
Изменение применяется, когда модели используются по подписке ChatGPT в продуктах OpenAI или в поддерживаемых партнёрских приложениях, аутентифицируемых через Sign in with ChatGPT, включая, например, OpenCode, Pi, Amp и Devin.
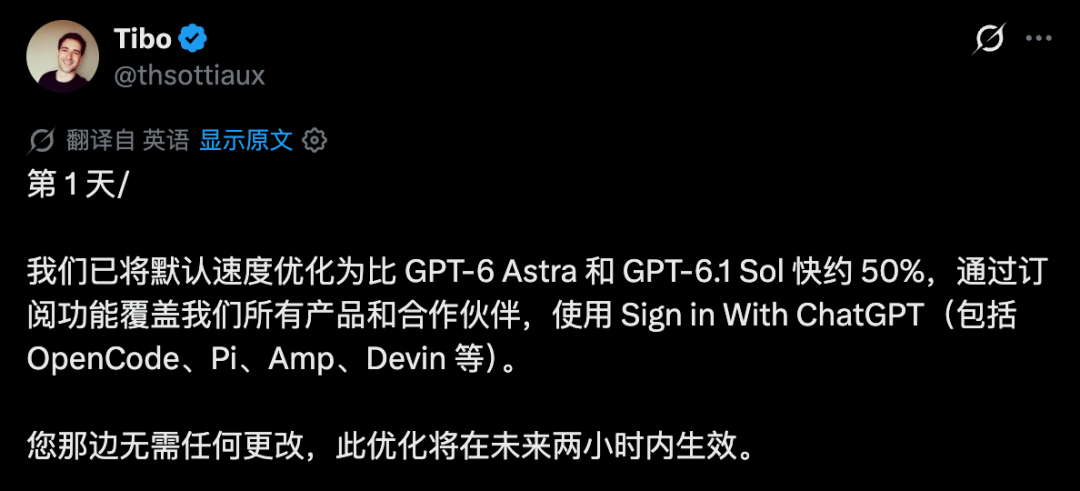
Пользователю не нужно включать Fast или Ultrafast, чтобы получить эту оптимизацию стандартной скорости.
Трекер сообщества OpenAI описал это изменение как рост стандартной скорости вывода примерно с 30 токенов в секунду до 50 токенов в секунду.
К этому показателю необходимо добавить важную оговорку: более быстрая генерация токенов не означает, что вся задача в Codex или Work завершится на 50% раньше.
Агентные задачи часто тратят время на такие действия, как:
Если генерация текста моделью составляет лишь часть общего времени выполнения, сквозная задержка может сократиться значительно меньше, чем предполагает заявленный процент.
GPT-6.1 Sol уже вызывала жалобы на задержки вскоре после запуска 29 сентября.
Источник BAAI отмечает, что некоторые пользователи считали даже ответы в режиме Fast медленнее ожидаемого в периоды высокой нагрузки. Тибо публично признал необычно высокую нагрузку и сообщил, что производительность сервиса восстанавливается, а затронутым платным пользователям предлагаются сбросы лимитов использования.
Это помогает объяснить, почему оптимизация инференса стала первым пунктом 28-дневной программы.
В день 1 OpenAI не добавляла новую модель. Компания сделала более быстрыми модели, которыми люди уже пользовались.
Объявление об ускорении не было единственной новостью OpenAI той недели.
5 октября OpenAI объявила новый визуальный рекламный формат для ChatGPT.
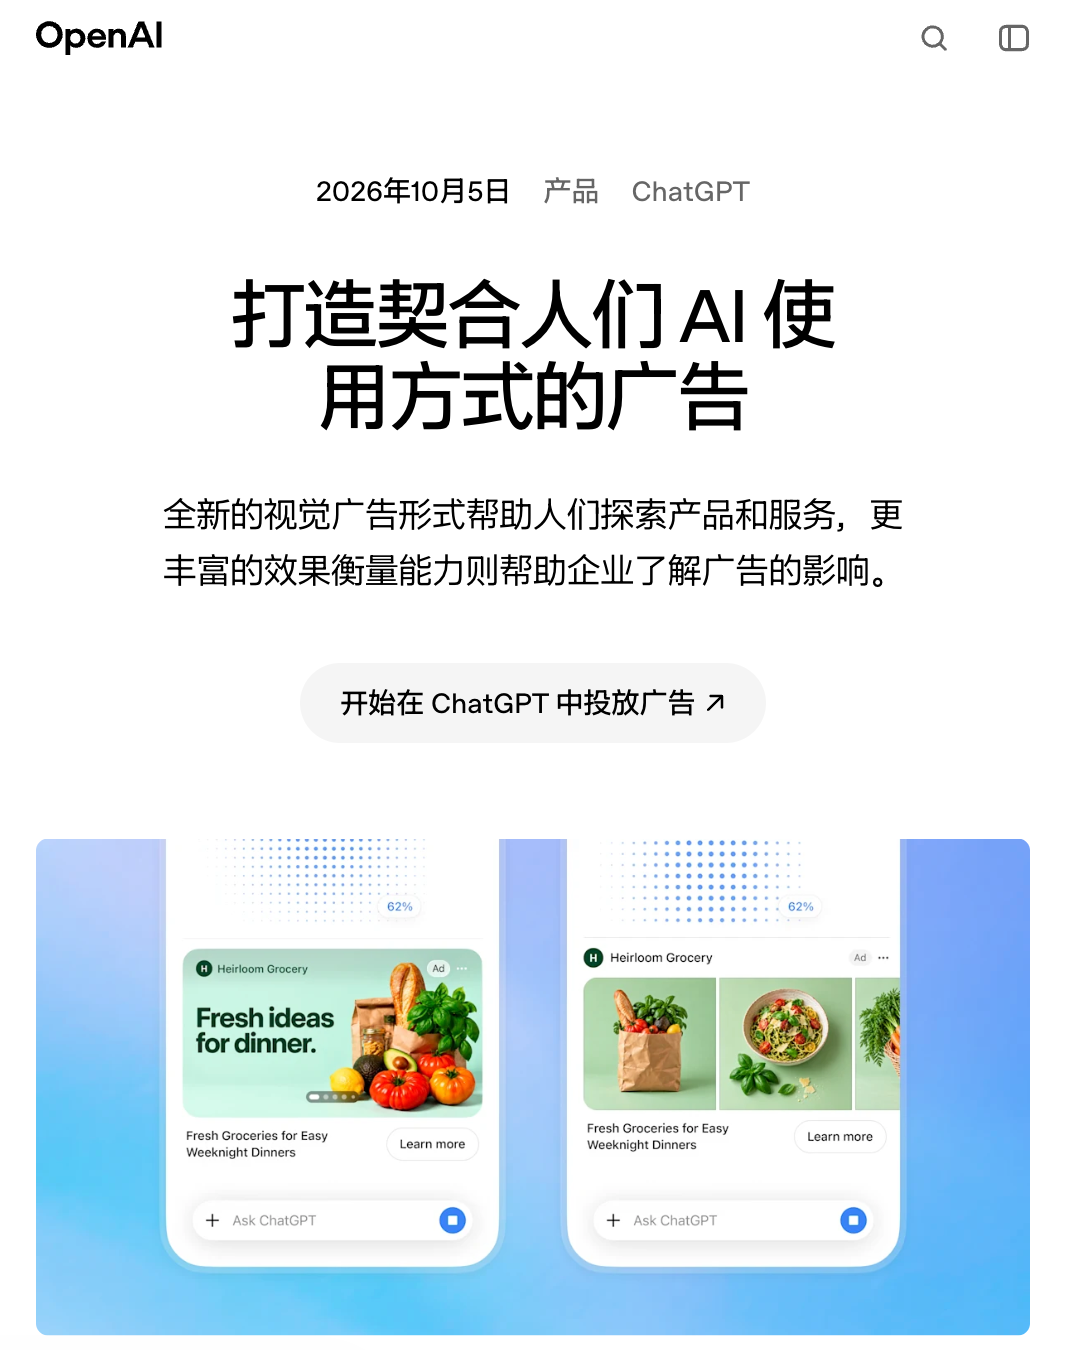
Этот формат предназначен для показа вдохновляющих продуктовых материалов, сценариев использования продуктов или других брендовых изображений, пока люди изучают товары и услуги в ChatGPT.
Первый тест имеет более узкий охват, чем предполагают некоторые заголовки.
OpenAI сообщает, что первоначальное развёртывание:
Компания также заявляет, что реклама будет чётко маркироваться и останется отделённой от генерируемого изображения.
По данным OpenAI, реклама не влияет на ответы ChatGPT.
Объявление выходит за рамки нового визуального рекламного блока.
OpenAI создаёт более широкую систему измерения рекламы с партнёрами по атрибуции, данным о конверсиях, инкрементальности и пригодности брендов для рекламного размещения.
Среди названных OpenAI партнёров есть такие сервисы, как:
OpenAI сообщает, что ChatGPT теперь охватывает 1,2 миллиарда человек каждую неделю, поэтому реклама становится значимой дополнительной бизнес-моделью наряду с подписками.
Заявленные компанией принципы остаются следующими: ответы должны оставаться независимыми, пользовательские беседы должны оставаться конфиденциальными для рекламодателей, а люди должны сохранять контроль над своим рекламным опытом.
Второе объявление было посвящено происхождению контента, а не монетизации.
OpenAI опубликовала план соблюдения требований прозрачности Закона ЕС об ИИ путём внедрения статистического текстового водяного знака под названием textGrain.
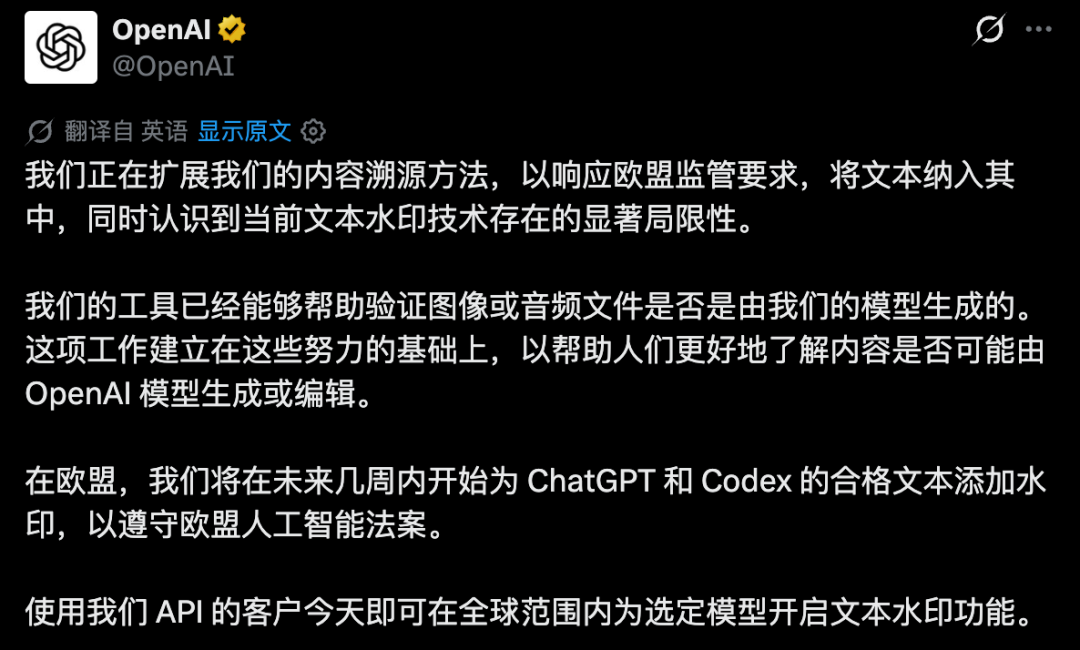
Этот водяной знак не является скрытым символом Unicode, невидимым пробелом или метаданными.
Вместо этого textGrain тонко влияет на то, как модель выбирает между возможными словами или фрагментами слов. В достаточно длинном тексте этот выбор создаёт статистический сигнал, который может искать детектор.
У OpenAI предусмотрены два разных пути развёртывания:
| Продуктовый путь | Статус водяных знаков |
|---|---|
| ChatGPT и Codex в ЕС | Развёртывание в ближайшие недели для подходящих текстовых ответов |
| OpenAI API по всему миру | Подключение по желанию для отдельных моделей; по умолчанию выключено |
| Публичный детектор | На запуске не будет общедоступным |
| Доступ для исследователей / экспертов | Доступен по заявке в индивидуальном порядке |
Исходная статья корректно связывает этот шаг с Законом ЕС об ИИ, но важно не описывать водяной знак как глобальную настройку ChatGPT по умолчанию на старте.
OpenAI прямо заявляет, что первоначальное развёртывание для ChatGPT и Codex действует только в ЕС.
OpenAI необычно прямо говорит о том, что водяной знак не может доказать.
Обнаруженный водяной знак не устанавливает:
Отсутствие обнаруженного водяного знака также не доказывает авторство человека.
Собственная оценка OpenAI показывает почему. При целевом уровне ложноположительных результатов в 1% обнаружение становится надёжнее на более длинных свободно сформулированных текстах, тогда как короткий, сильно ограниченный, переведённый или отредактированный текст может быть значительно труднее классифицировать.
Компания сообщает, что замена даже умеренной доли слов синонимами может существенно ослабить сигнал.
Поэтому textGrain — это сигнал происхождения, а не безошибочный детектор авторства.
Если реклама и водяные знаки раздражали часть пользователей, экономика подписок была более непосредственно важна для разработчиков, активно использующих Codex и агентные рабочие процессы.
5 октября независимая исследовательская компания в области полупроводников и ИИ-инфраструктуры SemiAnalysis опубликовала отчёт, измеряющий практические лимиты основных ИИ-подписок.
Отчёт пытается оценить эквивалентную API-ценность, а не просто сравнить ежемесячные цены.
SemiAnalysis измеряет, как быстро расходуются счётчики использования подписок при контролируемых нагрузках, оценивает, сколько токенов входит в окна использования плана, а затем переводит эти лимиты в ценность на основе соответствующих API-цен.
Эта методология полезна, но всё же представляет собой аналитическую модель, созданную SemiAnalysis, а не официальную оценку планов от OpenAI или Anthropic.
SemiAnalysis утверждает, что потребительские подписки сильно субсидируются по сравнению с прямым использованием API.
Для Anthropic её приблизительная модель оценивает, что на подписки приходится около 10% выручки, при этом они потребляют более 40% вычислительных ресурсов инференса.
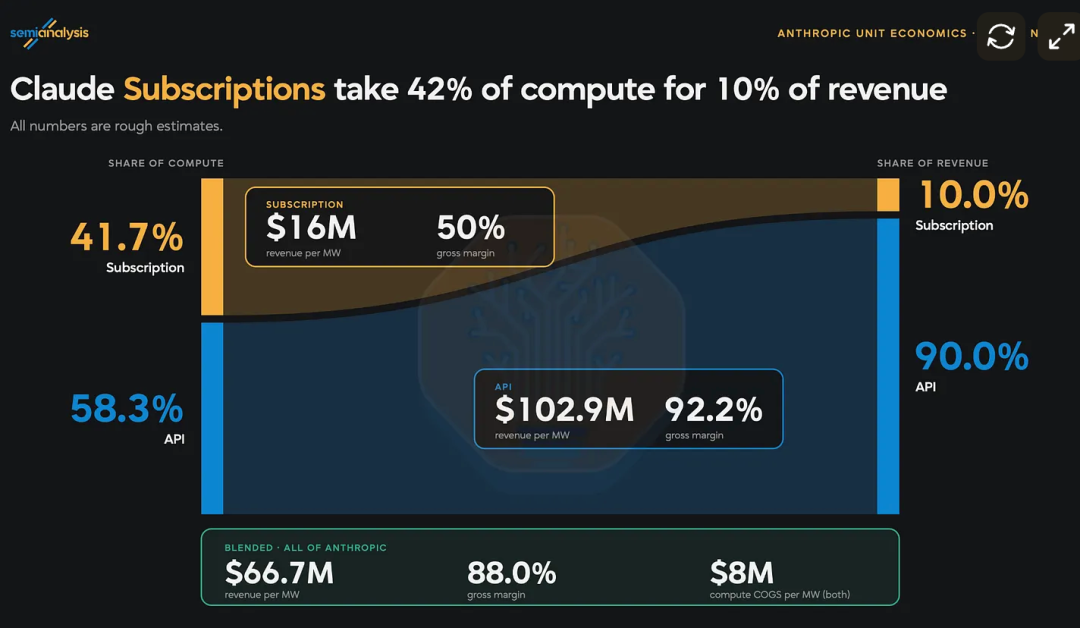
Компания оценивает, что это сокращает смешанную выручку на мегаватт примерно на 36 миллионов долларов по сравнению с более ориентированной на API структурой нагрузки.
Точная экономика — это оценки, а не финансовые раскрытия компаний.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Но более широкое давление легко понять: фиксированные ежемесячные подписки стимулируют интенсивное использование, в то время как инференс передовых моделей остаётся дорогим.
Это создаёт постоянное напряжение между щедрыми лимитами использования и устойчивой маржинальностью.
Теперь OpenAI предлагает три ежемесячных уровня Pro:
| План | Ежемесячная цена | Astra Ultrafast |
|---|---|---|
| Pro 100 | $100 | Нет |
| Pro 200 | $200 | Нет |
| Pro 500 | $500 | Да |
Pro 500 был запущен 29 сентября и включает наибольший объём использования среди трёх Pro-планов, а также доступ к Astra Ultrafast в ChatGPT Work и Codex.
OpenAI также снизила включённый лимит для вновь приобретаемых подписок Pro 200. Клиенты, имеющие право на сохранение прежних условий, могут оставить предыдущий лимит до 29 октября 2026 года.
Это изменение реально и задокументировано OpenAI.
Вклад SemiAnalysis состоит в измерении того, какой объём практического использования моделей, по-видимому, содержат эти уровни.
По данным компании, обновлённый план OpenAI Pro 200 предоставляет примерно половину прежней эквивалентной API-ценности в рамках её методологии тестирования.
В отчёте также говорится, что новый уровень за $500 предлагает лишь примерно на 21% больше использования GPT-6 Astra, чем старый сохранённый уровень за $200, хотя Pro 500 даёт отдельное преимущество Astra Ultrafast.
Поэтому новый план за $500 сложно оценить одним числом: его ценность отчасти зависит от того, важна ли пользователю максимальная пропускная способность, а не только объём токенов.
Наиболее обсуждаемая диаграмма сравнивает GPT-6.1 Sol с Claude Opus 5.5 в агентной нагрузке.
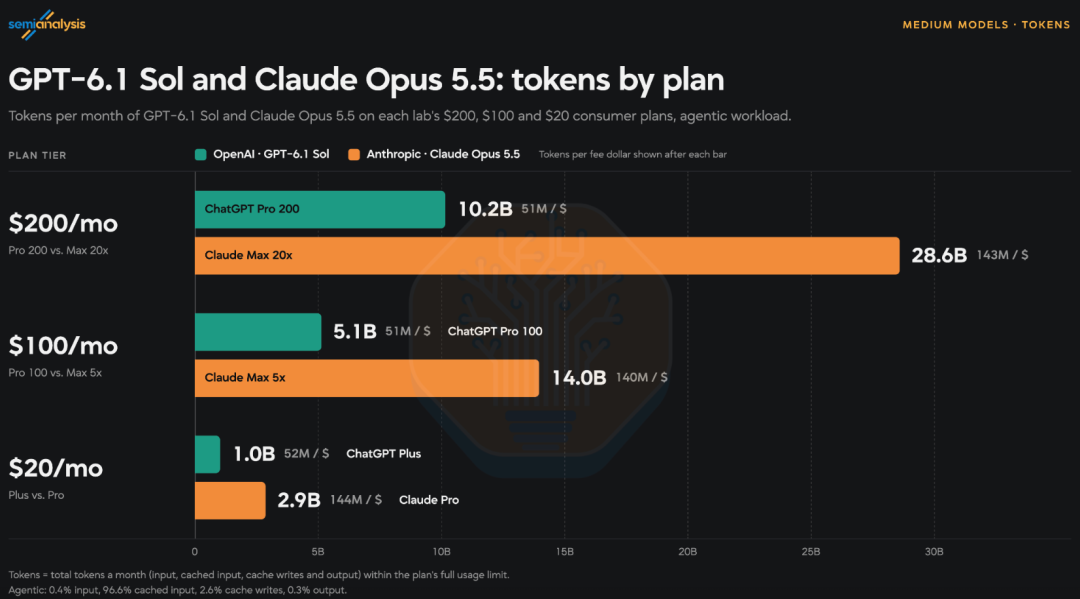
SemiAnalysis приходит к выводу, что Anthropic предлагает примерно в 5 раз больше эквивалентной API-ценности в этом сравнении среднего уровня.
Это не означает, что любая подписка Claude в пять раз лучше для каждого пользователя.
Результат зависит от:
Сама SemiAnalysis отмечает, что эффективность токенов трудно надёжно измерить и что эквивалентная API-ценность может вводить в заблуждение, если API-цены не соответствуют практической полезности.
Тем не менее отчёт даёт разработчикам конкретную причину сравнивать подписки по фактическим рабочим нагрузкам, а не только по маркетинговым названиям.
После объявления об ускорении в день 1 некоторые пользователи начали самостоятельно измерять новую стандартную пропускную способность.
Один широко распространённый результат показал, что GPT-6.1 Sol в режиме Standard в среднем достигала около 31,7 токена в секунду за один период измерения, а в более недавнем коротком окне показатель был ближе к середине диапазона 30 токенов в секунду.
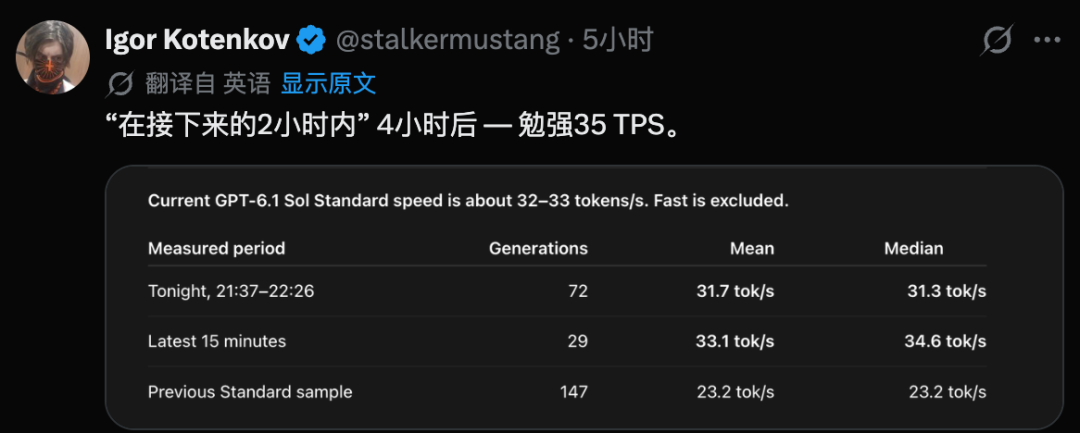
Это было ниже показателя примерно 50 токенов в секунду, связанного с объявлением о развёртывании.
Это не обязательно означает, что оптимизация не сработала.
Наблюдаемая скорость может различаться в зависимости от:
Собственный Справочный центр OpenAI указывает, что поддержка сейчас не может проверить улучшение скорости для конкретной учётной записи.
Поэтому официальное заявление следует воспринимать как оптимизацию на уровне платформы, а не как гарантию фиксированной пропускной способности для каждого запроса.
Ещё одна реакция в исходной статье была более скептической: некоторые пользователи утверждали, что GPT-6.1 Sol уже значительно замедлилась после запуска, поэтому увеличение скорости в день 1 воспринималось как восстановление утраченной производительности, а не как действительно новая возможность.
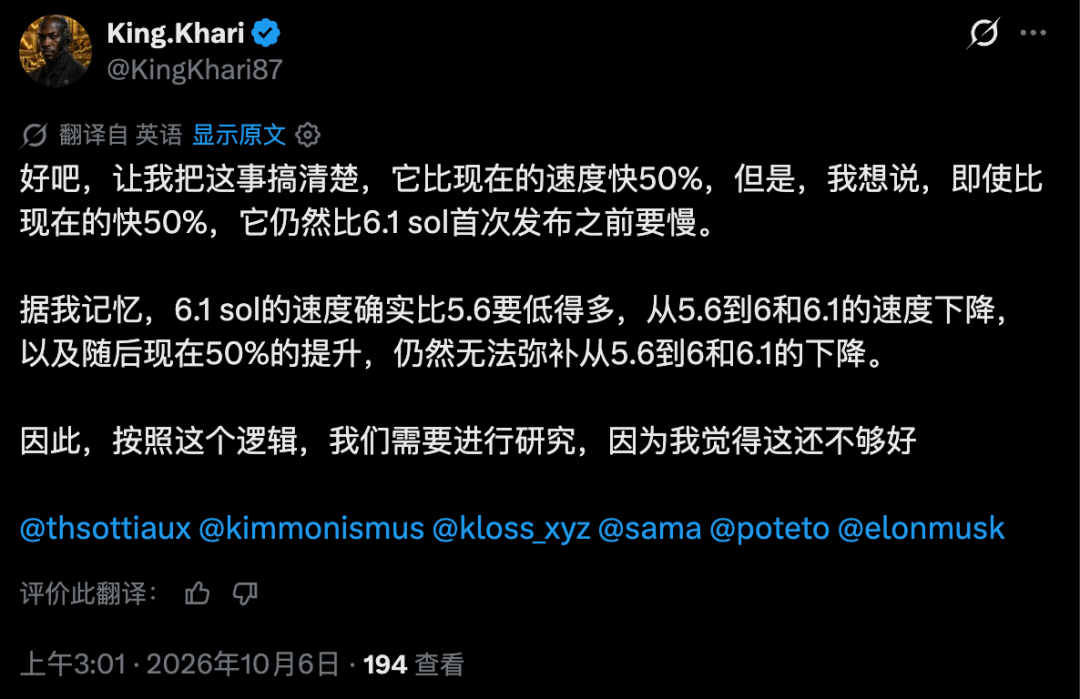
Этот аргумент сложно доказать на основе публичных данных, поскольку не существует единого официального исторического графика пропускной способности инференса для каждого пользователя до и после каждого события нагрузки.
Подтверждено то, что OpenAI признала необычно высокую нагрузку вокруг GPT-6.1 Sol и позднее выпустила оптимизацию инференса, предназначенную для улучшения стандартной скорости генерации текста.
Реакция пользователей всё же важна, поскольку объясняет, почему технически значимое улучшение производительности не вызвало автоматически положительный отклик.
Пользователи оценивают обновление относительно своего прошлого опыта, а не только относительно текущего бенчмарка компании.
Само по себе более быстрое стандартное генерирование ответов — это прямое улучшение удобства использования.
Но день 1 пришёлся на период нескольких пересекающихся изменений:
Поэтому реакция была связана не столько с одной оптимизацией инференса, сколько с тем, какие приоритеты, по мнению пользователей, выбирает OpenAI.
Для разработчиков главный вопрос практичен:
Становятся ли модели достаточно быстрыми и полезными, чтобы компенсировать более строгие лимиты, более дорогие уровни и более коммерциализированный пользовательский опыт?
Единого ответа нет.
Пользователь, который ценит Astra Ultrafast, Codex Cloud или более широкую экосистему инструментов OpenAI, может прийти к совершенно иному выводу, чем разработчик, оптимизирующий исключительно количество модельных токенов на каждый доллар подписки.
28-дневная программа создаёт необычно публичный цикл обратной связи.
Вместо объявления масштабной дорожной карты и просьбы пользователям ждать OpenAI вынуждает себя выпускать заметные улучшения в ежедневном ритме или компенсировать пользователям это сбросом.
Первый день был посвящён скорости инференса.
К 8 октября испытание уже вышло за пределы дня 1: последующие обновления включали бесплатный Auto Review, упрощение ограничений API rate limit, плагин для встреч, публичную бета-версию Decisions API, сбросы и GPT-6 с Intelligent UI.
Эта статья по-прежнему сосредоточена на срезе дня 1, поскольку именно он является темой исходного отчёта BAAI.
Более важная проверка заключается в том, каким будет совокупный результат всех 28 дней.
Если программа даст улучшения, которые пользователи действительно ощутят в повседневной разработке и интеллектуальной работе, оптимизация скорости будет выглядеть разумным первым шагом.
Если последующие обновления будут выглядеть косметическими, пока лимиты и ценообразование остаются главным предметом внимания, скептицизм, проявившийся в день 1, будет сложнее преодолеть.
В течение 28 дней Тибо Соттьо из OpenAI заявил, что команда будет ежедневно либо выпускать одно понятное улучшение, актуальное для большинства пользователей Codex и ChatGPT Work, либо предоставлять полный сброс. Программа началась в начале октября 2026 года.
OpenAI описывает оптимизацию дня 1 как приблизительное увеличение стандартной скорости генерации текста на 50%. Это не означает, что каждая полная задача Work или Codex завершится на 50% быстрее, поскольку время также занимают использование инструментов, просмотр веб-страниц, рассуждение и внешние сервисы.
Нет. OpenAI сообщает, что улучшение применяется к настройке стандартной скорости. Fast и Ultrafast — это отдельные уровни обслуживания и продуктовые опции.
OpenAI сообщает, что первоначальный тест визуальной рекламы начнётся позднее в октябре 2026 года в Соединённых Штатах во время генерации изображений для пользователей Free и Go. Реклама будет маркироваться и отделяться от сгенерированного изображения.
Нет. OpenAI планирует добавить водяные знаки textGrain в подходящий текст ChatGPT и Codex в Европейском союзе в ближайшие недели. Клиенты API по всему миру могут подключить функцию для отдельных моделей, но в API водяные знаки по умолчанию отключены.
Pro 500 — это уровень Pro от OpenAI стоимостью $500 в месяц. Он включает наибольший объём использования среди Pro-планов и доступ к Astra Ultrafast в ChatGPT Work и Codex.
Да. OpenAI документирует более низкий включённый лимит для вновь приобретаемых подписок Pro 200, при этом пользователи, имеющие право на сохранение прежних условий, могут сохранить предыдущий лимит до 29 октября 2026 года.
Это вывод SemiAnalysis для конкретных сравнений моделей и рабочих нагрузок с использованием её методологии эквивалентной API-ценности. Его не следует воспринимать как универсальный показатель качества модели или полезности для каждого пользователя.
OpenAI начала 28-дневный спринт обновлений Codex и ChatGPT Work с реального инфраструктурного улучшения: GPT-6 Astra и GPT-6.1 Sol теперь генерируют текст примерно на 50% быстрее при настройке стандартной скорости в подписочных продуктах и у поддерживаемых партнёров Sign in with ChatGPT.
Сдержанную реакцию легче понять в контексте всего, что происходило одновременно. OpenAI тестирует визуальную рекламу, развёртывает текстовые водяные знаки ЕС, перестраивает лимиты использования Pro и продаёт новый уровень за $500 с Astra Ultrafast, в то время как SemiAnalysis утверждает, что Anthropic в настоящее время предоставляет значительно большую эквивалентную API-ценность в нескольких распространённых сравнениях подписок.
Следовательно, спор первого дня на самом деле не о токенах в секунду. Он касается полного ценностного предложения, которое теперь оценивают пользователи: качества моделей, скорости, лимитов, цен, инструментов, конфиденциальности, рекламы и надёжности.
День 1 сделал модели быстрее; оставшиеся 27 дней определят, сможет ли OpenAI сделать общий опыт Codex и Work заметно лучше.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



