OpenAI провела значительную корректировку цен на серию GPT-5.6. С 30 июля 2026 года компания снизила цены на API GPT-5.6 Luna на 80%, а на G...
OpenAI внесла существенные изменения в цены на семейство GPT-5.6.
С 30 июля 2026 года компания снизила цену на API GPT-5.6 Luna на 80%, а на GPT-5.6 Terra — на 20%. Стандартная цена на флагманскую модель GPT-5.6 Sol осталась без изменений, однако OpenAI представила быстрый режим, который обеспечивает скорость обработки до 2,5 раз выше стандартной при сохранении того же уровня интеллекта модели.
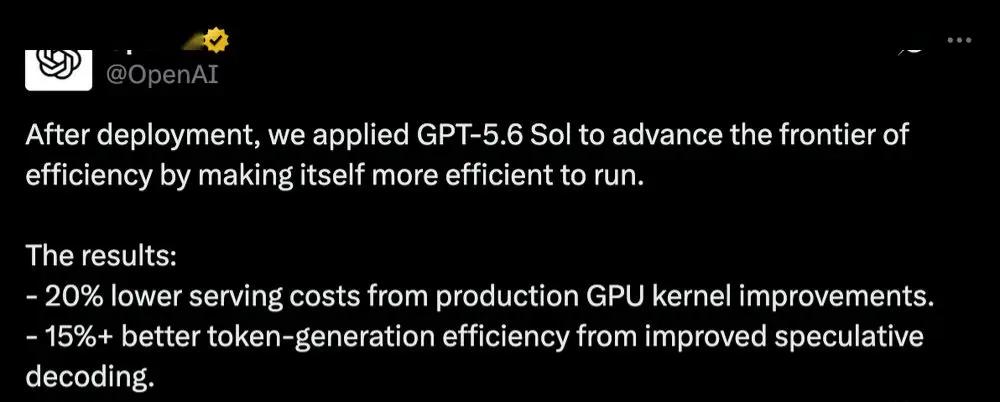
Это изменение опубликовано в тот момент, когда OpenAI обнародовала инженерный анализ, демонстрирующий, как GPT-5.6 Sol помогла оптимизировать системы, используемые для обслуживания самой GPT-5.6. По данным OpenAI, улучшения в производственных GPU-ядрах позволили снизить сквозную стоимость обслуживания на 20%, а усовершенствования в спекулятивном декодировании повысили эффективность генерации токенов более чем на 15%.
В результате OpenAI заняла более агрессивную позицию на так называемом фронте соотношения цены и производительности: согласование объёма используемого интеллекта с экономической ценностью конкретной задачи.
Для разработчиков самые важные изменения очевидны: Luna теперь значительно дешевле для высокопроизводительных агентных нагрузок, Terra стала доступнее для повседневного использования, а Sol можно приобретать на более высоком уровне обслуживания, когда задержка важнее цены.
Обновление цен от 30 июля охватывает всё семейство GPT-5.6, однако масштаб изменений для каждой модели различается.
Luna получила самое агрессивное снижение цены.
Её стандартная цена на API изменилась со следующих уровней:
| Тип токена | Старая цена | Новая цена | Изменение |
|---|---|---|---|
| Входные | 1,00 долл. / 1 млн токенов | 0,20 долл. / 1 млн токенов | -80% |
| Выходные | 6,00 долл. / 1 млн токенов | 1,20 долл. / 1 млн токенов | -80% |
OpenAI описывает Luna как самую быструю и доступную модель в семействе GPT-5.6, позиционируя её для чувствительных к цене высокопроизводительных нагрузок.
К таким задачам относятся:
Более низкая цена особенно меняет экономику агентных циклов, поскольку один пользовательский запрос может включать множество вызовов модели, а не одно простое завершение.
OpenAI отмечает, что Luna способна использовать инструменты и выполнять многошаговые рабочие процессы, что делает практичным делегирование большего объёма работы более дешёвой модели без необходимости сохранять агентное поведение исключительно за более дорогим передовым уровнем.
Стандартная цена на API для Terra теперь составляет:
| Тип токена | Старая цена | Новая цена | Изменение |
|---|---|---|---|
| Входные | 2,50 долл. / 1 млн токенов | 2,00 долл. / 1 млн токенов | -20% |
| Выходные | 15,00 долл. / 1 млн токенов | 12,00 долл. / 1 млн токенов | -20% |
Terra по-прежнему остаётся моделью среднего уровня в семействе GPT-5.6.
Она предназначена для нагрузок, требующих более сильных рассуждений, чем Luna, но не обязательно более высоких затрат Sol.
Типичные области применения включают:
OpenAI упоминает Notion как одного из клиентов, использующих Terra для персональных агентных нагрузок, таких как чувствительные к задержке вопросы и ответы в рабочем пространстве и задачи ограниченного объёма.
Стандартная цена на API для Sol осталась неизменной:
| Тип токена | Стандартная цена |
|---|---|
| Входные | 5,00 долл. / 1 млн токенов |
| Выходные | 30,00 долл. / 1 млн токенов |
Изменение для Sol — это не снижение цены.
Вместо этого OpenAI представила быстрый режим.
Быстрый режим заменяет прежнюю терминологию OpenAI «приоритетной обработки».
Для GPT-5.6 Sol OpenAI сообщает, что быстрый режим обрабатывает запросы до 2,5 раз быстрее стандартной обработки при неизменном уровне интеллекта модели.
Цена — это стоимость.
Быстрый режим стоит вдвое дороже стандартной обработки.
Для Sol это означает:
| Тип токена | Стандарт | Быстрый режим |
|---|---|---|
| Входные | 5,00 долл. / 1 млн | 10,00 долл. / 1 млн |
| Кэшированные входные | 0,50 долл. / 1 млн | 1,00 долл. / 1 млн |
| Выходные | 30,00 долл. / 1 млн | 60,00 долл. / 1 млн |
Существующие запросы API с использованием:
service_tier="priority"
сохраняют обратную совместимость и направляются в быстрый режим.
OpenAI также поддерживает:
service_tier="fast"
в качестве переименованного идентификатора услуги.
Быстрый режим особенно полезен, когда стоимость ожидания превышает стоимость более быстрых вычислений.
Примеры включают:
Рабочий процесс, требующий 20 или 30 вызовов модели, даже если каждый отдельный вызов имеет небольшую задержку, может ощущаться значительно медленнее, чем одиночный ответ в чате. Поэтому в агентных системах более быстрая обработка может иметь непропорционально важное значение.
Более низкие цены на Luna и Terra также отразились на способе расчёта использования в ChatGPT Work и Codex.
OpenAI сообщает:
Это не означает, что платные подписки сами по себе подешевели.
Это изменение означает, что при выборе Luna или Terra те же лимиты будут действовать дольше.

OpenAI опубликовала график зависимости цены от интеллекта на основе Artificial Analysis Intelligence Index v4.1, чтобы проиллюстрировать новое позиционирование Luna.
На графике GPT-5.6 Luna размещена выше 50 баллов по индексу интеллекта, а после корректировки цен одна из Luna
Расчётная стоимость задачи в конфигурации составляет примерно 0,05 доллара США.
Эти данные не следует путать с ценой любого отдельного вызова API.
Artificial Analysis рассчитывает стоимость за задачу индекса интеллекта на основе использования токенов модели и взвешенной методологии на базе бенчмарков. Фактическая стоимость производственных запросов зависит от:
размера входа
размера выхода
глубины рассуждений
кэширования подсказок
количества вызовов инструментов
числа раундов выполнения агента
тарификации длинного контекста
механизма повторов
До снижения цен 30 июля Artificial Analysis сообщала, что индекс интеллекта GPT-5.6 Luna в конфигурации с максимальным рассуждением составлял около 51.
Новые более низкие цены на токены ещё сильнее сместили Luna к низкозатратному концу кривой «интеллект-стоимость».
Более широкая идея, которую доносит OpenAI, заключается в том, что предприятиям не следует использовать самую дорогую модель на каждом этапе.
Рабочий процесс может сначала использовать Sol для устранения неоднозначности и составления плана, а затем поручать Luna чётко определённые задачи по реализации, тестированию или повторяющейся работе.
Когда модели более низкого уровня уже способны использовать инструменты и выполнять многошаговые рабочие процессы, такой подход к маршрутизации моделей становится более привлекательным.
За день до снижения цен OpenAI опубликовала подробную техническую статью о том, как GPT-5.6 стала более эффективной.
Самым необычным аспектом этой истории является то, что GPT-5.6 Sol сама участвовала в процессе оптимизации.
OpenAI сообщает, что её инженеры использовали Sol через Codex для анализа производственных систем, написания производительного кода, тестирования альтернатив и мониторинга экспериментов.
Компания описала три основных уровня оптимизации:
На уровне инференса OpenAI сообщает, что GPT-5.6 Sol самостоятельно переписала и оптимизировала производственные ядра.
GPU-ядра — это низкоуровневые программы, отвечающие за эффективное выполнение математических операций на аппаратном обеспечении ускорителей.
Даже если базовая архитектура модели не меняется, неэффективное перемещение данных, синхронизация, планирование или компоновка данных могут привести к недостаточному использованию дорогостоящих GPU-ресурсов.
OpenAI сообщает, что Sol помогла выявить следующие типы вычислений, подлежащих оптимизации:
Компания особо отметила участие в этой работе технологий GPU-программирования Triton и Gluon.
По данным OpenAI, улучшения ядер и связанные с ними оптимизации сервиса позволили снизить сквозную стоимость обслуживания GPT-5.6 на 20%.
Ещё одной важной оптимизацией стало спекулятивное декодирование.
Упрощённая версия спекулятивного декодирования выглядит так:
Таким образом, качество черновой модели имеет решающее значение.
OpenAI сообщает, что GPT-5.6 Sol спроектировала и провела сотни экспериментов с архитектурой спекулятивной модели, включая изменения:
Sol также контролировала процесс обучения и вмешивалась при возникновении аппаратных сбоев или нестабильности обучения.
OpenAI сообщает, что полученные улучшения позволили повысить эффективность генерации токенов более чем на 15%.
Стоимость модели зависит не только от кода, выполняемого внутри одного GPU.
Запросы необходимо маршрутизировать между следующими уровнями:
Если работа распределена неравномерно и часть оборудования простаивает, затраты могут оставаться высокими даже при мощных ускорителях.
OpenAI сообщает, что Sol помогла проанализировать производственный трафик, выявить источники дисбаланса нагрузки, протестировать альтернативные стратегии маршрутизации и настроить эвристики, используемые для распределения запросов.
Такого рода операционные оптимизации позволяют повысить общую пропускную способность без соответствующих дополнительных вложений в оборудование.
OpenAI также оптимизировала агентные фреймворки, используемые такими системами, как Codex и ChatGPT Work.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Агенту может потребоваться несколько вызовов модели и инструментов, прежде чем он вернёт конечный результат.
Например, Codex может:
Каждый цикл может переносить контекст, определения инструментов, предыдущие результаты и информацию об окружении.
Если этот контекст неоправданно растёт, увеличиваются и затраты, и задержка.
OpenAI сообщает, что её агентный фреймворк использует такие методы, как отложенное обнаружение, когда инструменты, навыки, плагины и MCP-интеграции раскрываются только при необходимости.
Вывод инструментов по умолчанию ограничен 10 000 токенов, если модель не запрашивает иное ограничение.
Это снижает вероятность того, что крупные результаты инструментов будут без необходимости заполнять окно контекста.
Агентные циклы обычно многократно повторно используют одни и те же инструкции и контекст.
Кэширование подсказок позволяет избежать повторных вычислений стабильных префиксов подсказок.
Но кэш работает только тогда, когда повторяющийся префикс остаётся полностью идентичным.
OpenAI сообщает, что её фреймворк сохраняет свойство только добавления для видимой модели истории:
Такая конструкция повышает частоту повторного использования кэша подсказок в Codex и ChatGPT Work.
Основной принцип прост:
Модель становится дешевле не только благодаря более низкой стоимости токенов, но и потому, что окружающая система с самого начала избегает генерации и обработки ненужных токенов.
OpenAI описывает это как петлю обратной связи.
Более сильные модели помогают инженерам улучшать:
Эти улучшения снижают затраты и задержку.
Более эффективная инфраструктура, в свою очередь, делает экономически выгодным запуск более сильных моделей в большем масштабе.
OpenAI считает, что это может сократить цикл от разработки модели до масштабного развёртывания, ускоряя темпы инноваций в области ИИ.
Необходимо находить следующие поколения оптимизационных выгод.
Снижение цен на Luna и Terra 30 июля — это наиболее заметный для клиентов результат на сегодняшний день.
В оригинальном отчёте на китайском языке также подчёркивалась бурная реакция сообщества разработчиков после объявления.
Некоторые пользователи обратили внимание на масштаб снижения цены на Luna.
Снижение на 80% значительно превышает постепенные корректировки цен, обычные для передовых API.
Другие считали, что Luna была недооценена ещё до снижения цены, особенно для агентных рабочих нагрузок — в таких сценариях более дешёвые модели могут выполнять рутинные задачи под руководством более сильного планировщика.
Эта корректировка цен также немедленно вызвала сравнения с другими экономичными моделями, включая Kimi K3.
Распространённый в сообществе мем описывал ситуацию так: Luna внезапно начала бороться за пользователей, которых привлекло низкое позиционирование цены Kimi K3.
Этот мем был забавным, но он не является техническим бенчмарком и поэтому не включён в изображения основного текста.
Ещё одной распространённой реакцией было упоминание @Anthropic с вопросом, будет ли соответственно скорректировано ценообразование Claude API.
Эта реакция отражает более широкие изменения в конкурентной среде на переднем крае больших моделей.
Год назад наиболее заметная конкуренция сосредотачивалась на:
Эти измерения по-прежнему важны.
Но разработчики, запускающие производственных агентов, всё больше внимания уделяют:
Самые дешёвые токены — не всегда самый дешёвый рабочий процесс.
Точно так же самая умная модель не обязательно является лучшей моделью для каждого шага рабочего процесса.
Предположим, задача состоит из пяти этапов:
Команда может использовать Sol на этапах 1 и 2.
Когда работа чётко определена, Luna может справиться с этапами 3–5.
Чем дешевле Luna, тем сильнее стимул переводить рутинную работу агентов с флагманской модели на более доступную.
Это не означает, что Luna приближается к Sol по всем возможностям.
Это означает, что ценность меньшей модели зависит от того, достаточно ли она умна для конкретной поставленной задачи.
Новая риторика OpenAI настойчиво подчёркивает результат за каждый доллар.
Это полезнее, чем просто смотреть на цену токенов.
Оценка в производственной среде должна отслеживать:
Модель, которая в пять раз дешевле за токен, всё равно может оказаться дорогой, если требует множества повторов.
Более дорогая модель, которая выполняет работу за меньшее количество шагов, в итоге может обойтись дешевле.
Новое ценообразование Luna делает расчёты более выгодными для меньших моделей, но разработчикам по-прежнему необходимы
оценки под конкретные рабочие нагрузки.
События 29 и 30 июля показывают, что OpenAI одновременно продвигает две связанные идеи.
Во-первых, GPT-5.6 всё чаще используется для улучшения инфраструктуры, на которой работает сам GPT-5.6.
Во-вторых, компания конвертирует часть этого повышения эффективности в более низкие цены для клиентов и более быстрые варианты обслуживания.
Это меняет конкурентный ландшафт.
Следующий этап рынка моделей — это не просто:
Какая модель самая умная?
Но также:
Сколько полезного интеллекта разработчик может купить за каждый доллар и каждую секунду ожидания?
Снижение цены Luna на 80% делает этот вопрос особенно актуальным.
Terra становится дешевле для повседневной профессиональной работы.
Sol остаётся моделью высокого класса, но режим Fast позволяет разработчикам платить больше за скорость, когда время критично.
По мере того как качество моделей сближается по всё большему числу задач, компании, которые заставляют то же оборудование выполнять больше полезной работы — и конвертируют этот рост эффективности в более выгодные цены — могут получить всё более важное конкурентное преимущество.
Начиная с 30 июля 2026 года OpenAI установил цену GPT-5.6 Luna в стандартном режиме обработки на уровне 0,20 доллара за миллион входных токенов и 1,20 доллара за миллион выходных токенов. Это на 80% ниже первоначальной цены в 1 доллар за миллион входных и 6 долларов за миллион выходных токенов.
GPT-5.6 Terra в настоящее время в стандартном режиме обработки стоит 2 доллара за миллион входных токенов и 12 долларов за миллион выходных токенов. OpenAI заявляет, что это на 20% ниже прежней цены в 2,50 доллара за миллион входных и 15 долларов за миллион выходных токенов.
Нет. Стандартная цена API для Sol остаётся на уровне 5 долларов за миллион входных токенов и 30 долларов за миллион выходных токенов. Основное изменение — введение режима Fast.
Режим Fast — это более быстрый уровень обработки API от OpenAI, который заменяет прежнее название Priority Processing (приоритетная обработка). Для GPT-5.6 Sol OpenAI заявляет, что при двойной стандартной цене токенов скорость обработки может возрасти до 2,5 раза по сравнению со стандартным режимом, без изменения уровня интеллекта модели.
Да. OpenAI сообщает, что запросы с уровнем обслуживания priority по-прежнему обратно совместимы и автоматически используют режим Fast. Разработчики также могут использовать значение уровня обслуживания fast.
OpenAI сообщает, что GPT-5.6 Sol, используемый через Codex в процессе инженерии под руководством человека, помог анализировать производственный трафик, переписывать GPU-ядра, проводить сотни экспериментов со спекулятивным декодированием и контролировать процесс обучения. OpenAI частично приписывает этой работе снижение сквозной стоимости обслуживания на 20% и повышение эффективности генерации токенов более чем на 15%.
Цены на подписку и квоты бюджета не изменятся. OpenAI заявляет, что благодаря более низким базовым ценам Luna и Terra теперь расходуют меньше кредитов в Codex и ChatGPT Work.
Нет. Luna стала значительно дешевле, но выбор модели по-прежнему зависит от сложности задачи и допустимой частоты ошибок. Распространённая стратегия — использовать более сильную модель для нечётких задач планирования и более дешёвую — для чётко определённых исполнительных задач.
ai/models/gpt-5-6-luna/): подробная информация о методологии модели Luna и её интеллектуальном индексе.
OpenAI снизила цены на API GPT-5.6 Luna на 80%, а на Terra — на 20%, оставив цену Sol Standard без изменений. Вместо этого для Sol добавлен режим Fast, который увеличивает скорость обработки API до 2,5 раз, но стоит вдвое дороже Standard.
Этот момент тесно связан с недавней инженерной работой OpenAI. Компания сообщает, что GPT-5.6 Sol помогла оптимизировать ядра GPU, спекулятивное декодирование, балансировку нагрузки и инфраструктуру для агентов, что снизило сквозные затраты на обслуживание на 20% и обеспечило рост эффективности генерации токенов более чем на 15% в части технологического стека.
Для разработчиков результат — более широкий диапазон соотношения цены и производительности: Sol для самых сложных задач, Terra для сбалансированных профессиональных задач, а Luna — для масштабных агентных операций по более низкой цене.
Обновление GPT-5.6 показывает, что конкуренция среди передовых моделей всё больше сосредоточена на стоимости каждого успешного результата, а не только на уровне интеллекта по сырым бенчмаркам.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



