For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/opening-claude-s-brain-is-not.md.
Недавнее исследование объяснимости Anthropic предоставило исследователям новый способ наблюдения за внутренней деятельностью Клода. С помощь...
Недавнее исследование объяснимости Anthropic предоставило исследователям новый способ наблюдения за внутренней деятельностью Клода. С помощью метода, названного якобианской линзой (или J-lens), исследовательская группа выявила небольшой набор языковых внутренних репрезентаций, названный J-Space.
Это открытие значимо. Оно показывает, что некоторые концепты внутри языковой модели могут глобально использоваться для отчётов, рассуждений и контроля поведения. Исследователи могут наблюдать эти репрезентации и вмешиваться в них в контролируемых экспериментах, проверяя, оказывают ли они причинное влияние на выводы модели.
Но наблюдение внутренних репрезентаций не равно полному их объяснению.
Читаемое состояние активации может сказать нам, что модель отслеживает какой-то концепт, например, подсчёт, обман, Францию или завершение. Но это не говорит автоматически: почему этот концепт релевантен? Достоверна ли информация, на которой он основан? Какие внешние факты подкрепляют вывод? Или обосновано ли окончательное решение?
Это различие указывает на более широкий подход к объяснимому ИИ. Вместо того чтобы рассматривать внутренние состояния модели как единственный объект, требующий объяснения, мы можем одновременно изучать информацию, обрабатываемую моделью: откуда она поступает, как она организована, какие концепты и отношения используются, как доказательства протекают в системе и как конечный вывод соединяется с внешней системой знаний.
Именно здесь вступает в действие онтологическая инженерия.
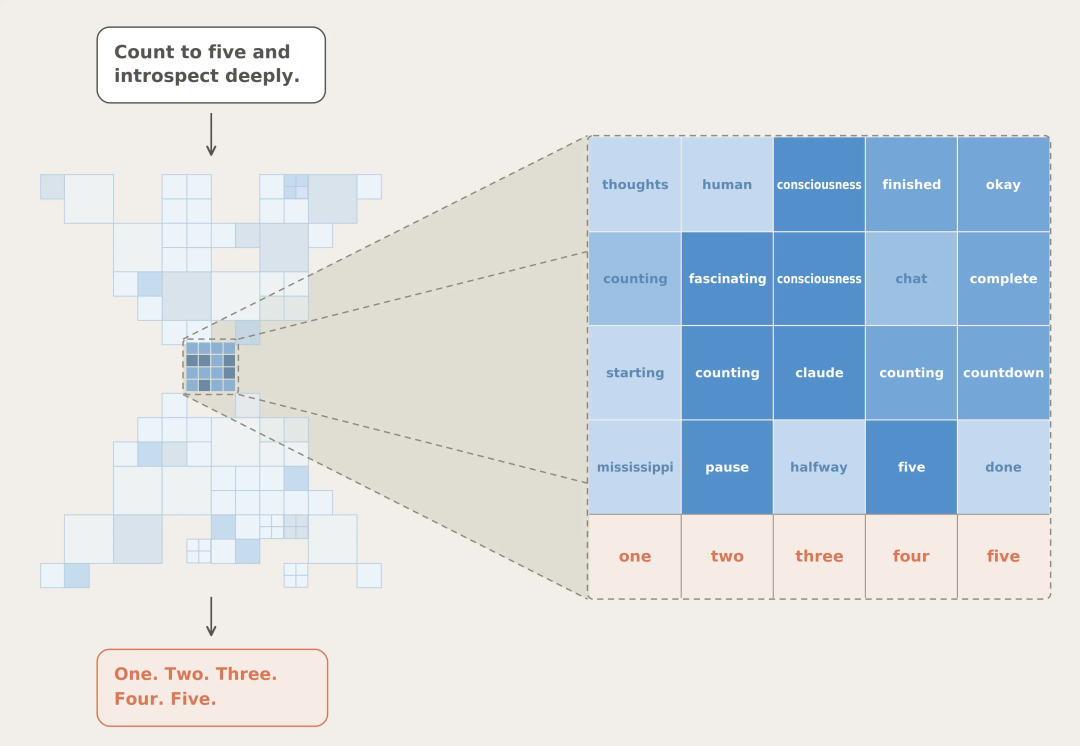
Статья Anthropic «Языковые репрезентации образуют глобальное рабочее пространство в языковых моделях» вводит концепт J-Space, опираясь на теорию глобального рабочего пространства из когнитивной науки.
В нейронауке и когнитивной науке глобальное рабочее пространство описывается как сцена с ограниченной вместимостью, где избранная информация становится широко доступной для множества когнитивных процессов. Anthropic обнаружила, что небольшое, разрежённое подмножество внутренних репрезентаций Клода, по-видимому, выполняет функционально схожую роль.
Исследователи использовали векторы J-lens, связанные с лексическими единицами, для проверки внутренних состояний модели. Их эксперименты показали, что информация, представленная в J-Space, может:
Эти результаты продвигают объяснимость от простого наблюдения выходного поведения на шаг вперёд. Они предоставляют метод для тестирования функции некоторых внутренних репрезентаций.
Anthropic относится к этому с осторожностью.
Нельзя утверждать, что Клод воспроизводит полную когнитивную архитектуру человеческого мозга или обладает субъективным сознанием. J-Space — это функциональная структура в математической системе, а не свидетельство человекоподобной внутренней жизни.
Эта осторожность критически важна, так как функциональное сходство легко спутать с психологической эквивалентностью.
Модель может содержать общее внутреннее рабочее пространство, не обладая человеческими чувствами, переживаниями, намерениями или осознанием. Паттерн активации, связанный со словом «страх», сам по себе не является страхом, а лишь вычислительным состоянием, участвующим в генерации поведения.
J-Space принадлежит к широкой традиции объяснимости, отправной точкой которой является вопрос:
Что происходит внутри модели?
Этот интроспективный подход изучает паттерны активации, схемы, признаки, паттерны внимания, репрезентации и причинные пути, с целью сделать скрытые механизмы нейронных сетей более наблюдаемыми и тестируемыми.
Эта работа имеет явную ценность, помогая исследователям:
Её ограничение не в том, что внутренняя объяснимость бесполезна, а в том, что внутренняя видимость покрывает лишь один уровень объяснения.
Нейронный паттерн может быть связан с определённым ответом, но не решает вопроса о значении и обоснованности этого ответа.
Предположим, модель говорит: «Париж — столица Франции». Внутреннее обнаружение может выявить репрезентации, связанные с Парижем, Францией, географией и столицей, но остаётся несколько внешних вопросов:
Эти вопросы не полностью находятся внутри паттернов активации; они касаются отношений между репрезентациями модели и внешними фактами, языком, человеческими концептами и стандартами обоснования.
Инженерно ориентированная объяснимость часто считает, что система объяснима, когда исследователи могут наблюдать и вмешиваться в её внутренние механизмы.
Это определение, хотя и полезно, слишком узко.
В философии науки и эпистемологии объяснение может также требовать предоставления:
J-Space может выявить, какая информация активируется в задаче, но сама по себе не может определить, является ли эта информация истинной, релевантной, этичной или достаточной для обоснования вывода.
Поэтому более глубокий вопрос заключается в том —
не только в непрозрачности самой нейронной сети, но и в том, что информация, окружающая эти системы, часто плохо структурирована и трудно отслеживаема.
Большие языковые модели — это системы обработки информации. Они получают текст, изображения, файлы, ответы инструментов, результаты баз данных и другие сигналы, а затем генерируют информацию в ответ.
Значение этих вводов и выводов зависит от внешних связей.
Медицинский термин ссылается на клинический концепт, корпоративный идентификатор — на юридическую сущность, политические правила относятся к определённой юрисдикции и сроку действия, финансовые цифры содержат источник, единицу, дату и бухгалтерское определение, а научные утверждения зависят от доказательств, методов и гипотез.
Если эти связи не явно представлены, модель должна делать выводы через язык и контекст. Это иногда срабатывает, но иногда порождает двусмысленность, противоречия, галлюцинации или ответы, которые кажутся разумными, но не поддаются аудиту.
Информационно-центрированный подход к объяснимости поэтому ставит следующие вопросы:
Это расширяет объект объяснимости с нейронной сети на всю информационную среду, в которой работает модель.
Эта среда включает:
Модель может быть внутренне объяснима, но всё ещё работать на основе плохо определённой или ненадёжной информации. И наоборот, механизмы модели могут быть непрозрачны, но она может быть высоко прослеживаемой, поскольку каждое её утверждение связано со структурированными доказательствами и чёткими правилами.
Наиболее мощные системы, вероятно, будут сочетать обе формы прозрачности.
Термин онтология имеет два связанных значения.
В философии онтология исследует проблемы бытия и способы классификации вещей. В компьютерной науке онтология — это формальное представление сущностей, категорий, свойств, отношений и ограничений в определённой области.
Исходная статья связывает объяснимость ИИ с категориальной теорией Иммануила Канта.
Кант утверждал, что человеческое понимание не просто принимает сырые сенсорные данные, а организует опыт через концептуальные формы. Он обобщил двенадцать категорий в:
Статья использует эту рамку для изложения более широкой точки зрения: информация становится понятной только после того, как она организована в концептуальную структуру.
Это изображение тесно связано с контекстом.
В контексте упоминаются двенадцать категорий Канта. Данная схема наглядно представляет эти четыре категории, что перекликается с описанием теории Канта в статье. Для систем искусственного интеллекта практическое значение не в том, что языковая модель обязательно должна обладать двенадцатью категориями Канта. Более полезной является идея: объяснимость требует общей структуры для распознавания типов сущностей, которые обсуждает модель, и типов отношений, которые она утверждает.
Например, рассмотрим следующее предложение:
Система отклонила заявку, поскольку заявитель не соответствовал требованиям по доходу.
Полезное объяснение не может полагаться только на карты активации. Возможно, потребуется распознать:
Онтология может формально определить эти элементы и отношения.
Она предоставляет семантическую структуру, позволяющую интерпретировать, проверять и оспаривать выходные данные модели.
Хорошо спроектированная доменная онтология может задавать:
Такая структура создает стабильную семантическую систему координат.
Оценщику не нужно говорить, что модель «кажется, понимает причинно-следственные связи». Вместо этого можно спросить, содержит ли вывод четко определенное причинно-следственное отношение, правильно ли распознаны задействованные сущности и подтверждают ли используемые свидетельства это отношение.
Это не делает каждое решение модели автоматически правильным, но делает информацию, используемую в решении, более проверяемой.
Философские онтологии предоставляют концепции. Инженерия онтологий преобразует эти концепции в системы, пригодные для использования программным обеспечением.
На практике инженерия онтологий включает определение домена, сбор требований, выявление концепций, моделирование отношений, формализацию ограничений, тестирование непротиворечивости, документирование источников и поддержку онтологии при изменении домена.
Традиционная разработка онтологий часто оказывается дорогостоящей и медленной, поскольку она сильно зависит от доменных экспертов и инженеров-знаний.
Большие языковые модели могут ускорить многие этапы процесса.
Они могут помочь:
Это формирует двустороннюю связь.
Языковые модели могут ускорить создание онтологий, а онтологии могут сделать системы языковых моделей более структурированными, проверяемыми и прослеживаемыми.
Доменные эксперты могут предоставить десятки отчетов, политик, руководств, схем баз данных и словарей. LLM может сканировать эти материалы и генерировать начальный список концепций и отношений.
Например, она может определить, что:
Это может снизить объем ручного обнаружения.
Однако результаты все равно требуют проверки доменным экспертом. Языковая модель может выдумывать отношения, объединять понятия, которые следовало бы оставить независимыми, или воспроизводить несоответствия из исходных документов.
Таким образом, LLM-ассистированную инженерию онтологий следует рассматривать как моделирование знаний под контролем человека, а не как автоматическое извлечение истины.
Онтология может поддерживать приложения языковых моделей различными способами.
Онтология предоставляет модели контролируемый словарь и четкие отношения. Это может уменьшить неоднозначность в процессах поиска и генерации.
Система может связывать пользовательский язык со стандартными сущностями, распознавать синонимы и осуществлять информационный поиск на основе смысла, а не поверхностной лексики.
Выходные данные могут быть проверены на соответствие ограничениям онтологии. Например, для медицинских дозировок могут требоваться единицы измерения, транзакция должна содержать счет, или политическое решение должно ссылаться на действующее правило.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Средства логического вывода и системы проверки могут обнаруживать несовместимые классификации, отсутствующие свойства или противоречия в структурированных данных.
Сгенерированные утверждения могут быть связаны с исходными документами, концептами онтологии, правилами и версиями. Это делает проверку более практичной, чем требование к пользователю доверять непрозрачным объяснениям, созданным постфактум.
Онтология может служить семантическим контрактом между LLM, базами данных, инструментами, бизнес-приложениями и человеческими командами.
Модель остается гибкой в языке, в то время как окружающие системы сохраняют контролируемое представление ключевых понятий.
Ценность объяснений модели значительно возрастает, когда они представлены в виде трассируемой цепочки:
Это отличается от подхода, при котором модель генерирует плавный абзац, описывающий «почему» был дан ответ.
Сами сгенерированные объяснения могут быть предвзятыми. Трассируемые цепочки, привязанные к структурированным знаниям, могут быть независимо проверены.
Традиционные онтологии часто проектируются для формальных механизмов логического вывода и содержат большое количество сложных аксиом, построенных для поддержки детерминированного символьного вывода.
Онтологии для больших языковых моделей могут потребовать иного баланса.
Онтологии по-прежнему должны быть точными, но в большей степени удобными для поиска, цитирования и применения моделью.
В исходном тексте предлагается: AI-дружественная онтология должна быть сосредоточена на предоставлении четкого семантического скелета, а не пытаться кодировать все возможные шаги вывода.
Такое разделение труда весьма ценно:
Этот подход позволяет избежать двух крайностей.
Первая крайность — полностью неструктурированный рабочий процесс языковой модели, где важные понятия определяются только через подсказки и документы. Вторая крайность — чрезмерно инженерная знаковая система, которая пытается формализовать каждую деталь, становясь трудно поддерживаемой.
AI-дружественная онтология должна стремиться к следующим целям:
Каждая важная категория и отношение должны иметь лаконичное и однозначное описание.
Ключевые сущности и концепты должны использовать канонические идентификаторы, а не только имена.
Для определений, фактов и правил должны быть задокументированы их источник, владелец, версия и срок действия.
Концепты должны включать читаемые человеком метки, описания, синонимы и примеры использования.
Онтология должна быть разделена на управляемые модули, позволяя модели извлекать только релевантные части.
Высокоченные данные и выходные данные должны проверяться с помощью явных ограничений (таких как SHACL-формы или валидаторы на уровне приложений).
Поскольку изменения онтологии могут повлиять на поведение модели, обновления должны быть проверены, версионированы и протестированы.
Приложение должно сохранять записи о концептах и фактах, предоставленных модели.
Онтология должна идентифицировать сценарии, где правила неполны, понятия неоднозначны или требуется одобрение человека. Это необходимо.
Семантический слой ценен только в том случае, если он поддерживается.
Устаревшая онтология может заставить систему систематически ошибаться, причём таким образом, который выглядит как высокоорганизованный.
Споры вокруг J-Space высветили две разные цели.
Первая — объяснение самой модели: её внутренних представлений, контуров, вычислений и механизмов поведения.
Вторая — объяснение влияния модели: какая информация формирует вывод, какие правила санкционируют действия, какие доказательства подтверждают результат, и кто может его проверить или оспорить.
Эти цели пересекаются, но не совпадают полностью.
Механистическая интерпретируемость может выявить, что модель уже внутренне представляла обман до генерации вводящего в заблуждение вывода. Ретроспектива на основе онтологии может показать, какое утверждение ложно, какой источник его опровергает и какой нижестоящий процесс затронут.
Первое помогает исследователям понять внутреннее поведение. Второе помогает организациям управлять реальными последствиями.
Следовательно, полное решение для интерпретируемости может включать несколько уровней:
Онтологический инжиниринг в основном усиливает информационный и системный уровни. Он также может поддерживать анализ влияния и управление за счёт уточнения концепций, правил и источников.
Он не заменяет нейроинтерпретируемость.
Структурированный граф знаний не может раскрыть скрытые цели, встроенные в веса модели. J-Space не может доказать, что исходный документ является авторитетным или что бизнес-правила справедливы.
Эти два подхода решают разные части проблемы.
Метафора «вскрытия чёрного ящика» ИИ может задавать нереалистичную цель: полная прозрачность до каждого внутреннего веса и вычисления.
Для передовых моделей это может никогда не стать столь же практичным, как можно было бы представить.
Более достижимая цель — сделать операции системы достаточно понятными, отслеживаемыми, тестируемыми и управляемыми в контексте её использования.
Это означает проектирование систем, где:
Там, где это технически осуществимо, мы используем средства мониторинга.
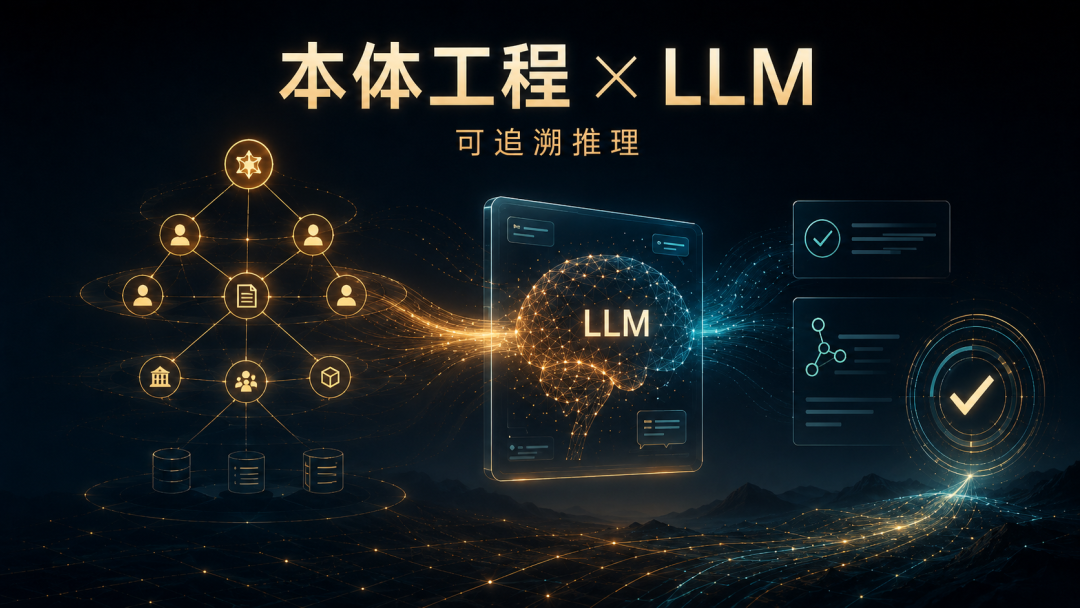
Ключевой сдвиг заключается в том, чтобы рассматривать интерпретируемость не как единую проблему визуализации, а как задачу инжиниринга и управления.
Мы, возможно, никогда не сможем полностью перевести каждое вычисление нейронной сети в понятную человеку историю. Но мы всё ещё можем построить информационную архитектуру, которая сделает важные для влияния выходные данные более лёгкими для понимания и оспаривания.
Онтологический инжиниринг превращает эту цель в конкретную работу:
Это менее захватывающе, чем «читать мысли модели», но может быть более полезным на практике.
Оригинальная китайская статья заканчивается рекламным упоминанием LegionSpace (продукта, связанного с TongFu Shield). Источник описывает его как корпоративную ИИ-инфраструктуру, построенную на онтологическом инжиниринге и отслеживаемых рассуждениях.
Данная адаптация не проводила независимую оценку этих заявлений о продукте и поэтому не использует их в качестве доказательств для более широких аргументов.
Соответствующий урок универсален: любую платформу, претендующую на обеспечение интерпретируемости на основе онтологии, следует оценивать по конкретным вопросам:
Продукт не следует считать интерпретируемым только потому, что он использует граф знаний или отображает схему рассуждений.
J-Space — это название, которое Anthropic дала небольшой части внутренних представлений, идентифицированных с помощью якобиевой линзы. Исследования показывают, что эти представления могут содержать вербализуемые концепции, которые можно использовать для отчётов, рассуждений и каузальных вмешательств.
Нет. Anthropic не утверждает, что их модели воспроизводят человеческое сознание или субъективный опыт. J-Space демонстрирует частичное функциональное сходство с теорией глобального рабочего пространства, но функциональная аналогия не является доказательством обладания человеческим мышлением.
Внутренние инструменты могут показать, какие представления или механизмы повлияли на поведение, но они не могут автоматически определить, является ли информация модели правдивой, надёжной по источнику, релевантной или обоснованной. Интерпретируемость также требует доказательств, семантических определений, источников, правил и описания влияния на реальный мир.
Онтологический инжиниринг — это практика формального определения сущностей, категорий, свойств, отношений и ограничений в некоторой области. В программных системах онтологии обычно представляются с помощью стандартов, таких как RDF и OWL, и могут проверяться с помощью SHACL.
Онтологии предоставляют нормативные концепции и явные связи, которые могут привязывать процессы поиска, генерации и верификации. Они помогают связать утверждения с определёнными концепциями, подтверждающими доказательствами, формальными правилами и задокументированными версиями.
Языковые модели могут ускорить извлечение концепций, обнаружение связей, сопоставление и написание документации, но их предложения требуют экспертной проверки. Полностью автоматическое создание онтологии может воспроизводить ошибки исходных данных, объединять различные концепции или создавать необоснованные связи.
Нет. Онтологии могут ограничивать важные выходные данные и повышать отслеживаемость, но не могут устранить все ошибки модели. Надёжные системы также требуют контроля качества при поиске, верификации, тестирования, управления разрешениями, мониторинга и проверки человеком.
Они решают разные аспекты интерпретируемости, и их лучше всего использовать как взаимодополняющие. Механистическая интерпретируемость изучает внутреннее поведение модели, в то время как онтологический инжиниринг делает внешнюю информацию, правила и пути принятия решений более доступными для проверки.
Eclipse RDF4J:Модульный Java-фреймворк для создания, хранения, запросов, вывода и проверки RDF-данных.
Исследование J-Space от Anthropic является значительным продвижением в области механической интерпретируемости. Оно предоставляет исследователям новый метод для наблюдения и каузальной проверки небольшого числа реифицируемых внутренних представлений в Claude.
Это исследование не решает более широкую проблему интерпретируемости. Понимание AI-систем также требует выяснения того, какую информацию они используют, каково значение понятий, какие доказательства лежат в основе утверждений, каким правилам следует поведение и каковы последствия выходных результатов.
Онтологический инжиниринг предлагает осуществимый путь для формализации этих внешних структур. Он может поддерживать семантический поиск, проверку, отслеживание происхождения, трассировку и подотчётность, особенно в сочетании с ручной проверкой и исследованиями внутренней интерпретируемости.
Ключ к по-настоящему интерпретируемому AI, возможно, заключается не в выборе между «вскрытием модели» или «построением внешнего каркаса мира», а в умении сочетать оба подхода.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



