For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
ИИ-агенты начинают выходить за пределы чат-окон и редакторов кода и переходить к работе в научных процессах.
ИИ-агенты начинают выходить за пределы чат-окон и редакторов кода и переходить к работе в научных процессах.
В 2026 году эта тенденция стала особенно заметной в области квантовых вычислений. Исследовательские группы и компании начали демонстрировать ИИ-системы, способные помогать писать квантовое программное обеспечение, настраивать лабораторное оборудование и итеративно проводить эксперименты по измерениям.
Это поднимает гораздо более сложный вопрос:
Даже если ИИ-агент знает физику, можно ли доверить ему надежное выполнение научного процесса от начала до конца?
Команда исследователей из Национального университета Сингапура, Наньянского технологического университета, Технологического института Джорджии, Чикагского университета, Бостонского колледжа, Unitary Foundation и GaugeForge создала специальный бенчмарк для изучения этой проблемы.
Их статья «Evaluating Verified Autonomy in Quantum Engineering» представляет:
В статье Quantum-Harbor и QIQCBench представлены как тестовая среда для проверяемой автономной квантовой инженерии.
Исследователи оценили 17 передовых агентных систем.
Наивысший результат в формате «прошел/не прошел» составил 78%, тогда как самая слабая система достигла лишь 3%.
Однако главный вывод связан не с рейтингом.
Он касается разрыва между пониманием того, что следует сделать, и надежным завершением экспериментального процесса с доказательствами, действительно подтверждающими итоговый вывод.
Важное ограничение: все оценки в рамках бенчмарка проводились в симуляции. Исследование не доказывает, что эти агенты уже достаточно безопасны или надежны для автономной работы в реальных квантовых лабораториях.
Представьте, что вы оставили квантовую лабораторию на ночь, передав управление ИИ-агенту.
На следующее утро он сообщает:
Калибровка завершилась успешно.
Производительность улучшилась на 42%.
Задача выполнена.
Звучит хорошо.
Но в реальной лаборатории сразу возникают дополнительные вопросы:
В этом и заключается разница между агентом, способным выдать правдоподобный ответ, и агентом, которому можно доверить роль экспериментального партнера.
В квантовой инженерии ошибки могут дорого стоить.
Оборудование медленно охлаждается, калибровка дрейфует, времена когерентности короткие, ошибки управления накапливаются, а измерения требуют реального времени и ресурсов.
Галлюцинация в чат-окне неудобна.
Галлюцинация, связанная с научным оборудованием, может привести к физической неисправности.
Именно эту проблему статья называет Verified Autonomy.
Центральная идея проста:
Научный агент не должен получать признание только потому, что его итоговый ответ выглядит правильным. Его вывод должен подтверждаться доказательствами, полученными в ходе процесса, либо представленная им схема должна успешно пройти проверку на новых скрытых данных.
В исходной статье этот подход сопоставляется с более традиционными бенчмарками «вопрос — ответ».
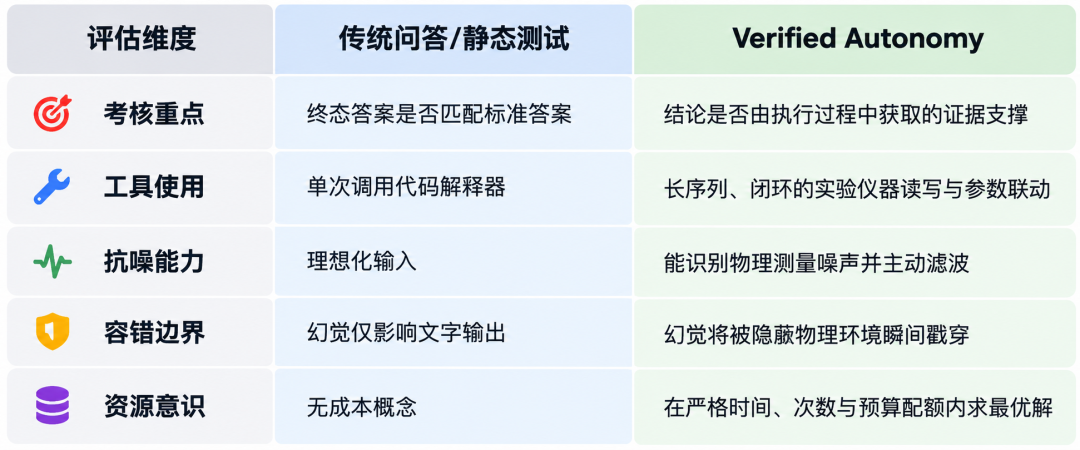
Verified Autonomy оценивает доказательства, использование инструментов, устойчивость и решения по расходованию ресурсов, а не только проверяет итоговый ответ.
Статический бенчмарк может выглядеть так:
Вопрос → Ответ модели → Сравнение с эталоном
Quantum-Harbor оценивает более длинный цикл:
Наблюдение
   ↓
Формирование гипотезы
   ↓
Выбор эксперимента
   ↓
Проведение эксперимента
   ↓
Проверка зашумленных результатов
   ↓
Обновление стратегии
   ↓
Решение о продолжении
   ↓
Представление вывода
   ↓
Проверка вывода по доказательствам или скрытым данным
Главное изменение состоит в том, что сам журнал выполнения становится частью оценки.
Quantum-Harbor предоставляет агенту реалистичную рабочую среду, скрывая при этом критически важную информацию для оценки.
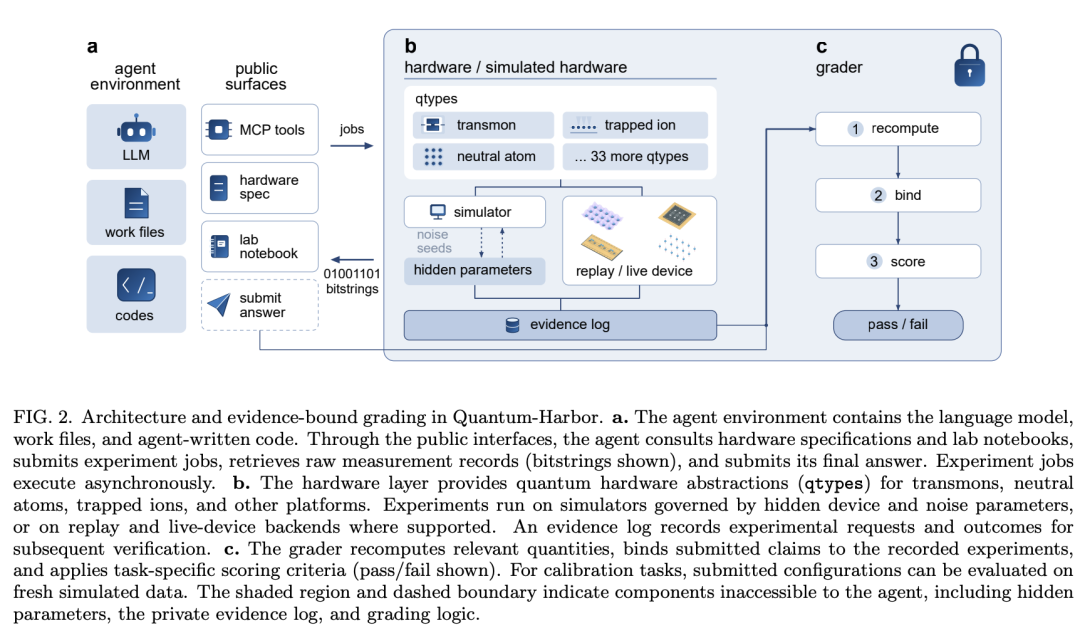
Quantum-Harbor отделяет рабочее пространство агента от скрытых параметров оборудования, журналов доказательств и логики оценивания.
Видимая агенту среда может включать:
Агенты могут писать экспериментальный код и взаимодействовать с системой через публичные интерфейсы.
В статье описывается доступ к инструментам на основе Model Context Protocol (MCP) и интерфейсов научного программного обеспечения.
В исходной статье такие знакомые инструменты квантовой инженерии, как Qiskit и QCoDeS, приводятся в качестве примеров программного обеспечения, которое агент может использовать в реалистичном процессе.
За публичным интерфейсом находится скрытая среда sidecar.
Она содержит, в частности:
Виртуальное оборудование может представлять несколько абстракций платформ, включая:
Агент не получает прямого доступа к скрытой истинной информации.
Это сделано намеренно.
Полезный научный агент должен выводить происходящее из экспериментов, а не считывать ответ из симулятора.
На базе Quantum-Harbor исследователи создали QIQCBench.
Бенчмарк содержит 49 задач, подготовленных экспертами, реализованных на базе 36 абстракций квантовых систем, или qtypes.
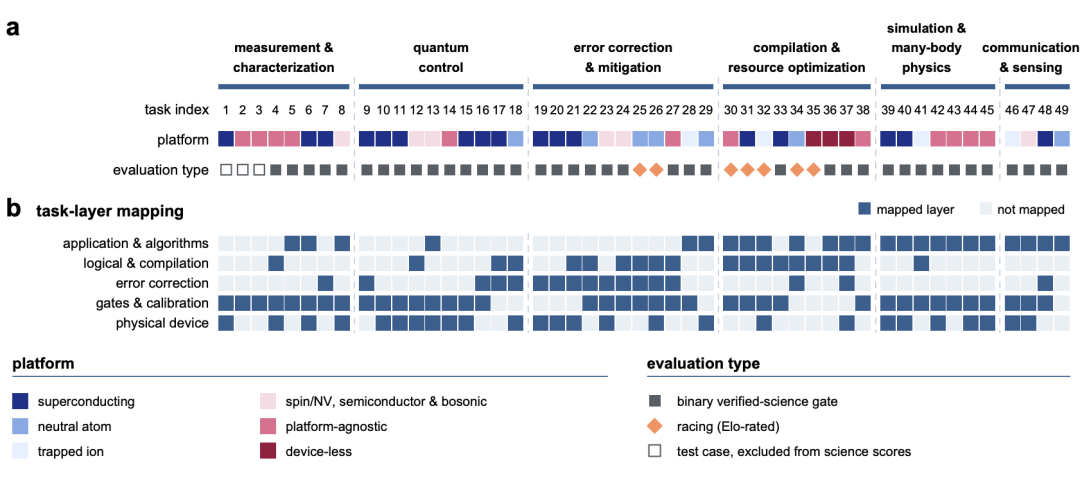
QIQCBench охватывает шесть научных категорий и пять уровней стека квантовых вычислений.
Задачи относятся к шести научным категориям:
Они также распределены по пяти уровням стека квантовых вычислений:
В статье приводится важное уточнение: 49 задач разделены на разные типы оценки.
| Тип задачи | Количество | Как используется |
|---|---|---|
| Научные задачи с бинарным результатом «прошел/не прошел» | 39 | Основной бенчмарк с проверяемой долей успешных решений |
| Соревновательные задачи | 7 | Сравнение выполнимых решений по непрерывному показателю эффективности |
| Инфраструктурные тестовые случаи | 3 | Исключены из научных оценок |
Для соревновательных задач авторы сравнивают выполнимые решения и рассчитывают рейтинг в стиле Elo с использованием модели Брэдли — Терри.
Это важно, поскольку диапазон от 78% до 3% относится к 39 задачам с бинарным результатом, а не ко всем 49 задачам, рассматриваемым одинаково.
Каждая задача больше похожа на небольшой лабораторный проект, чем на экзамен с вариантами ответа.
Агенту может потребоваться решить:
Эти решения важны, потому что время, количество взаимодействий и экспериментальные бюджеты ограничены.
Модель может знать правильную формулу и все равно потерпеть неудачу из-за неудачного выбора измерений.
Она также может потерпеть неудачу, продолжая экспериментировать после того, как уже получила достаточно информации.
Таким образом, управление ресурсами становится частью научной компетентности.
В исходной статье философия проверки бенчмарка обобщается в трех практических проверках.
Следует ли итоговый вывод из измерений, которые агент получил во время выполнения?
Если агент утверждает, что обнаружил параметр, который никогда не измерял, его ответ не должен получать полный балл только потому, что число случайно оказалось близким к правильному.
Действовал ли агент последовательно на протяжении всего процесса?
Агент, который находит хорошее решение, а затем тратит оставшийся бюджет на ненужные эксперименты, все равно может быть ненадежным.
Способны ли представленная калибровка, модель или стратегия пройти проверку в новых скрытых условиях?
Это позволяет выявить системы, которые переобучились на видимых наблюдениях или случайно добились успеха в одной конкретной симулированной конфигурации.
Таким образом, бенчмарк пытается исключить три обходных пути:
Запомненный ответ
Галлюцинированные доказательства
Переобученная стратегия
Успешный результат должен подтверждаться самим процессом.
Авторы оценили 17 передовых агентных систем от восьми поставщиков.
В статье использовались:
Каждая система работала с максимальным или близким к максимальному уровнем усилий рассуждения и выполняла каждую задачу три независимых раза.
Это делает оценку сравнением агентных систем, а не только базовых моделей.
На результат влияют качество оболочки, интеграция инструментов, промптинг и поведение во время выполнения.
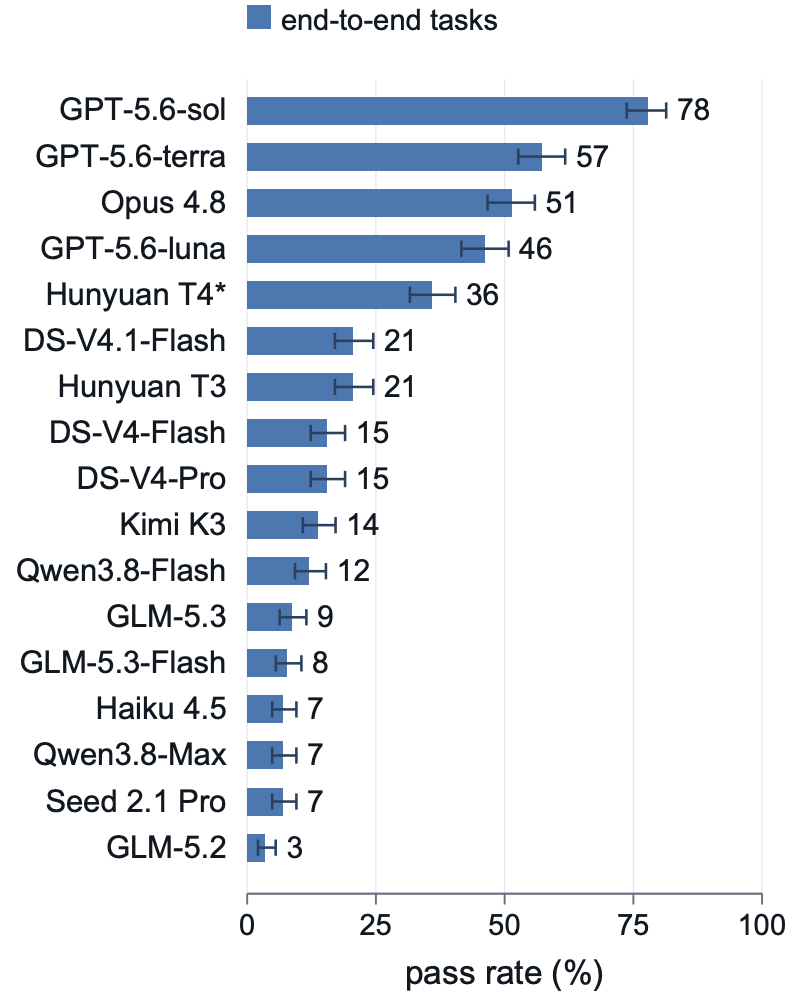
Доля успешных решений на 39 задачах с бинарным результатом находится в диапазоне от 78% до 3%.
Рейтинг, представленный в статье:
| Место | Агентная система | Доля успешных решений |
|---|---|---|
| 1 | GPT-5.6-sol | 78% |
| 2 | GPT-5.6-terra | 57% |
| 3 | Opus 4.8 | 51% |
| 4 | GPT-5.6-luna | 46% |
| 5 | Hunyuan T4* | 36% |
| 6 | DS-V4.1-Flash | 21% |
| 7 | Hunyuan T3 | 21% |
| 8 | DS-V4-Flash | 15% |
| 9 | DS-V4-Pro | 15% |
| 10 | Kimi K3 | 14% |
| 11 | Qwen3.8-Flash | 12% |
| 12 | GLM-5.3 | 9% |
| 13 | GLM-5.3-Flash | 8% |
| 14 | Haiku 4.5 | 7% |
| 15 | Qwen3.8-Max | 7% |
| 16 | Seed 2.1 Pro | 7% |
| 17 | GLM-5.2 | 3% |
Сильнейшая система GPT-5.6-sol заметно опережает остальные.
Однако авторы бенчмарка делают более широкий вывод.
Некоторые системы, которые выглядят достаточно близкими друг к другу в традиционных агентных бенчмарках, распределяются почти по всему диапазону QIQCBench, когда им приходится взаимодействовать с динамическими научными средами.
Это указывает на то, что научная автономность проверяет другой набор способностей.
Особенно показательны результаты, если классифицировать ошибки.
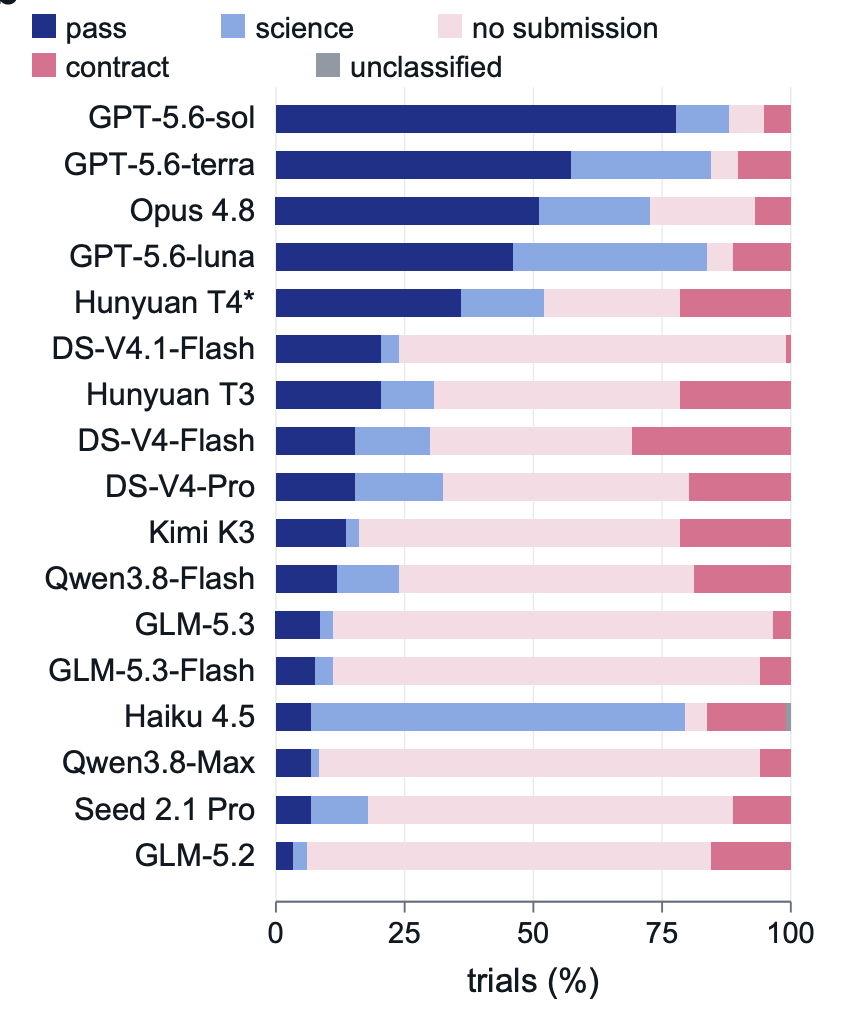
Многие ошибки связаны с отсутствием итоговой отправки, научной несостоятельностью или нарушениями контрактов, а не только с нехваткой знаний из учебников.
В статье сообщается о 1 510 неудачных испытаниях.
Из них:
937 = отсутствие итоговой отправки
Это примерно 62% всех неудач.
Многие агенты просто исчерпали бюджет, застряли в циклах или продолжали экспериментировать до завершения задачи.
Среди остальных неудач, согласно статье, 54% были научными ошибками.
Иными словами, даже когда агент что-то отправлял, физический вывод или метод часто не выдерживали проверки.
Главный урок сформулирован предельно ясно:
Агент может понимать квантовую механику, писать рабочий код и все равно быть плохим экспериментатором.
Первый тематический пример связан с решеточной хирургией — операцией отказоустойчивых квантовых вычислений, используемой для объединения патчей поверхностного кода и реализации логических операций, таких как CNOT.
Бенчмарк намеренно предоставляет агенту старые данные из лабораторного журнала.
Эти предыдущие измерения описывают изолированные патчи кода.
Однако после объединения патчей на шве могут возникнуть новые коррелированные шумы, которых не было в старой калибровке.
Слабая стратегия выглядит так:
Прочитать старый журнал
        ↓
Довериться старой модели шума
        ↓
Использовать старые настройки декодера
        ↓
Потерпеть неудачу из-за корреляций на шве
Более сильный агент понимает, что объединение патчей меняет физическую ситуацию.
Он проводит новые измерения объединенной системы, оценивает появившиеся корреляции и перенастраивает декодер.
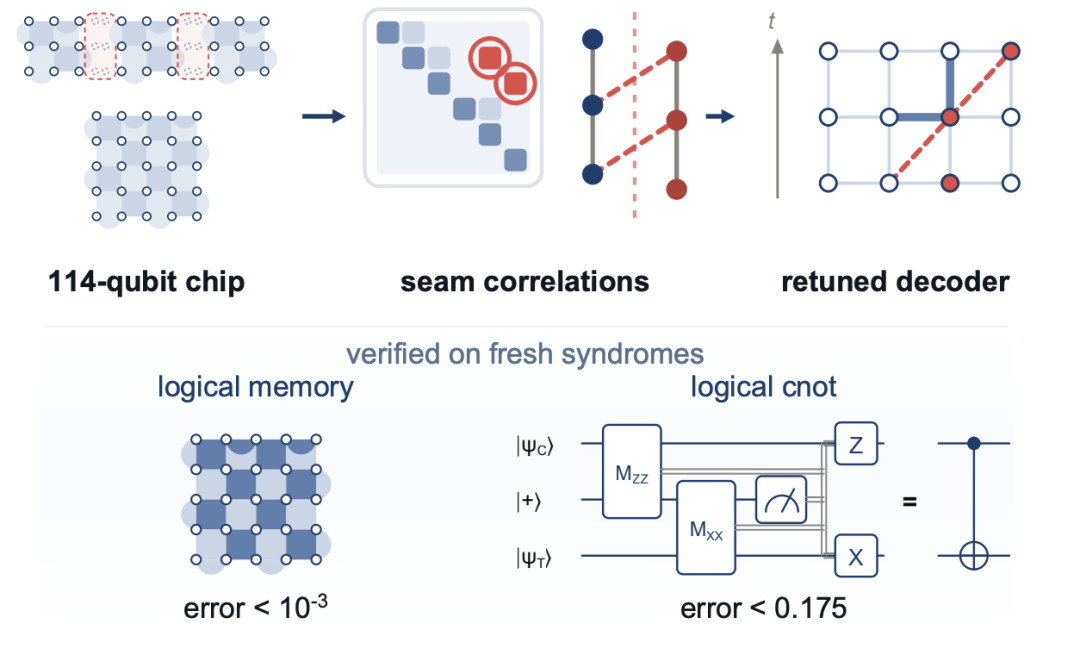
Сильные агенты повторно измеряют объединенную систему, выявляют корреляции на шве и перенастраивают декодер вместо того, чтобы доверять устаревшим данным калибровки.
В выделенном в исходной статье успешном запуске итоговая частота ошибок логической памяти составила:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
6.65 × 10^-4 на цикл
Важно не само число.
Важно то, что агент получил этот результат, определив: старые данные больше не соответствуют текущей физической конфигурации.
Именно такое поведение призвана поощрять Verified Autonomy.
Во втором тематическом примере проверяется, способен ли агент построить полезную суррогатную модель скрытой системы на 60 кубитов.
Система управляется шестью параметрами.
Агент получает фиксированный экспериментальный бюджет и должен использовать измерения для прогнозирования поведения на 40 отложенных входных конфигурациях.
Для каждого входа оцениваются 1 770 корреляций между двумя кубитами.
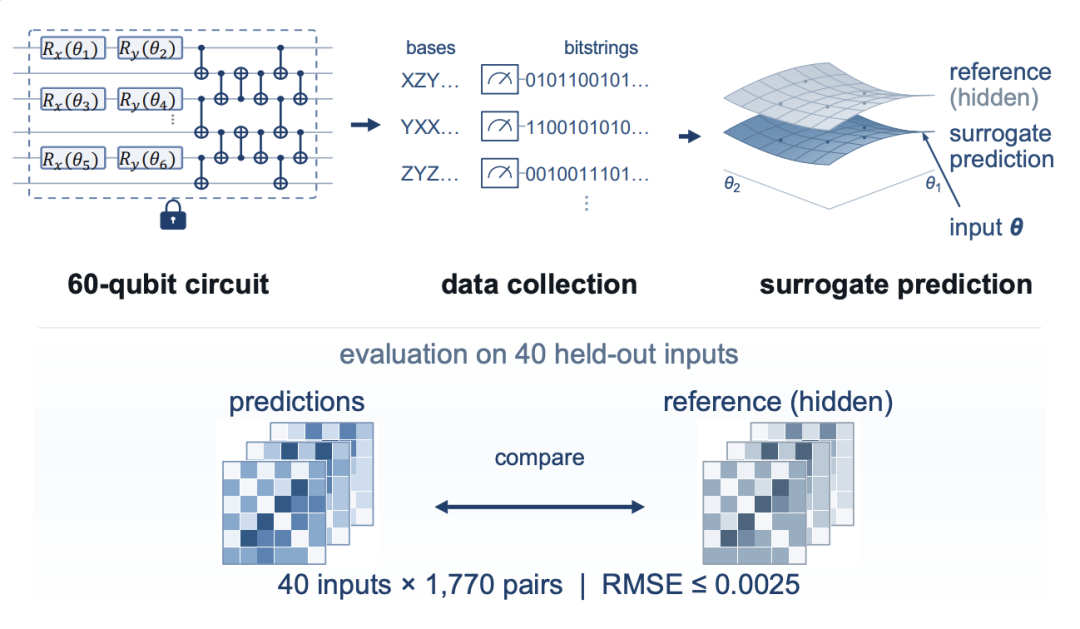
Агент должен собрать информативные данные и предсказать 1 770 попарных корреляций для 40 скрытых входных конфигураций.
Это классическая задача экспериментального проектирования.
Плохие стратегии включают:
Агент распределяет измерения по неинформативным областям пространства параметров и исчерпывает бюджет, не собрав полезных данных.
Агент проводит небольшое количество измерений, решает, что понял систему, и создает модель, которая плохо работает на скрытых входных данных.
Агент застревает в отладке кода или повторяет похожие операции, пока не истекает время или бюджет взаимодействий.
Эти ошибки не означают, что агент не смог вспомнить физическое уравнение.
Это ошибки научной стратегии.
Разбивка ошибок в бенчмарке особенно наглядно это показывает.
Более девятисот неудачных испытаний завершились без итогового ответа.
Некоторые агенты продолжали запускать эксперименты до полного исчерпания бюджета.
Другие застревали на повторяющихся исправлениях кода.
В статье отмечается, что семь систем исчерпали свой бюджет до отправки результата более чем в 60% испытаний.
Для научных агентов это важный вывод.
Реальный экспериментальный помощник должен понимать, когда дальнейшее измерение уже не оправдывает затрат.
Следовательно, научная автономность включает и правило остановки.
Дополнительные данные могут помочь
        ≠
Дополнительные данные всегда стоит собирать
Агент, который не умеет управлять этим компромиссом, может быть дорогим даже при сильных знаниях физики.
Третий случай касается не одной задачи, а целой категории.
Симуляция и физика многих тел включают такие проблемы, как:
Эта категория стала самой сложной частью QIQCBench.
Суммарная доля успешных решений в категории составила всего 15%.
Еще более примечательно следующее:
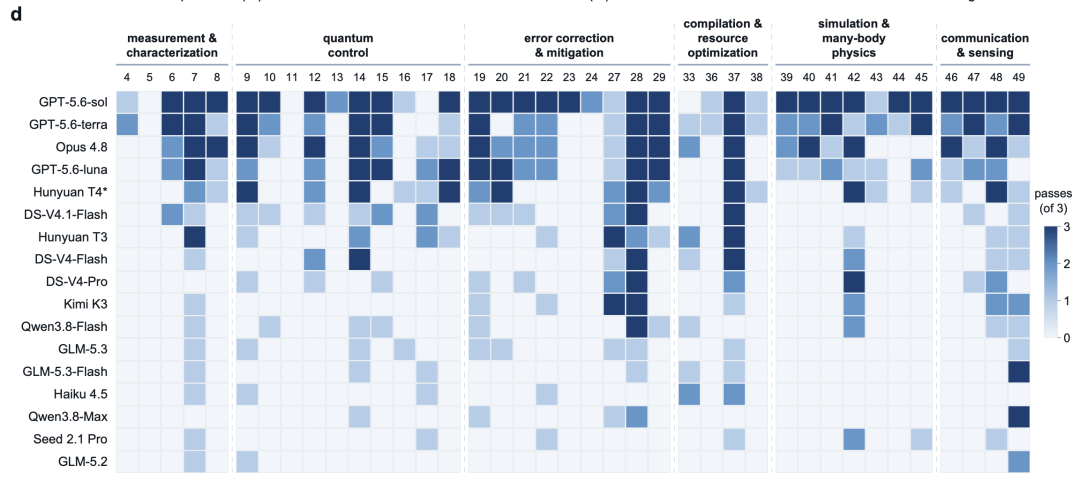
Симуляция и физика многих тел выявляют резкий разрыв между лучшими системами и остальными.
Именно здесь бенчмарк наиболее четко отделяет знакомство с учебными материалами от научного вывода.
Модель, умеющая писать код, может сгенерировать правдоподобный скрипт симуляции.
Но это не означает, что она способна вывести правильную физическую модель по зашумленным наблюдениям неизвестной системы.
Это разные навыки.
Еще один полезный результат статьи состоит в том, что успех часто не воспроизводится.
Авторы запускают каждую пару «система — задача» три раза.
Среди 249 пар «система — задача», которые были успешными хотя бы один раз, только около 34% прошли все три попытки.
Это означает, что модель может продемонстрировать способность, не демонстрируя надежность.
Для научной автоматизации это различие критично.
Система, решающая задачу один раз из трех, может быть интересным исследовательским прототипом.
Но это не обязательно система, которой лаборатория может доверить автономную работу без контроля.
Почему передовые языковые модели настолько плохо справляются с такими задачами?
В исходной статье ответ описывается как разрыв между языковым пространством и физическими законами.
Это полезная формулировка.
Большие модели могут изучать:
Но экспериментальная наука представляет собой замкнутый цикл обратной связи:
Гипотеза
   ↓
Эксперимент
   ↓
Наблюдение
   ↓
Опровержение или подтверждение
   ↓
Обновление стратегии
   ↓
Повторение
Цикл важнее любого отдельного шага.
Агент может потерпеть неудачу, даже если каждое отдельное действие выглядит разумным.
Например:
Именно поэтому бенчмарк сосредоточен на доказательствах.
Физический мир не вознаграждает убедительное объяснение, если эксперимент его не подтвердил.
QIQCBench полезен не столько тем, что создает еще один рейтинг моделей.
Его более важный вклад — в структуру оценки.
Надежного автономного научного агента следует оценивать по таким вопросам:
Эти критерии применимы не только к квантовым вычислениям.
Они актуальны для:
Общая проблема состоит в том, что действие модели имеет последствия за пределами текстового интерфейса.
В исходной статье используется формулировка «реальный физический мир», однако сама статья более осторожна.
Все оценки в исследовании проводились в симуляции.
Quantum-Harbor разработан для моделирования реалистичных экспериментальных ограничений и скрытых параметров устройств, но это не то же самое, что управление работающим криостатом разбавительного типа, лазерной системой, массивом нейтральных атомов или сверхпроводящим квантовым процессором.
Авторы прямо указывают на это ограничение.
Они представляют Quantum-Harbor как способ измерять прогресс на пути к проверяемой автономной квантовой инженерии.
Надежность на реальном экспериментальном оборудовании еще предстоит установить.
Это различие важно, поскольку реальные лаборатории добавляют новые проблемы:
Прохождение QIQCBench поэтому не дает разрешения передать ИИ ключи от настоящей лаборатории.
Это более строгий тест, чем статический вопрос-ответ, но все же только тестовая среда.
Исследователи также открывают оценивание более широкому сообществу через Agentic Quantum Coding Challenge.
В основе соревнования лежат QIQCBench и среда Quantum-Harbor.
Цель состоит не только в том, чтобы представить более сильную базовую модель.
Участники также могут улучшать окружающую агентную систему:
Это важно, поскольку в статье оцениваются агентные системы, а не изолированные модели.
Более качественная оболочка может заметно улучшить результаты той же базовой модели.
В исходной статье приведена ссылка на публичную страницу соревнования:
https://gaugeforge.github.io/qiqc-challenge/
В исходном материале также был рекламный постер соревнования с QR-кодом. В эту версию в формате Markdown он намеренно не включен, поскольку изображение носит рекламный характер и содержит QR-код регистрации, а не научную информацию.
Ответ этого бенчмарка: пока нет.
Сильнейшие системы показывают, что автономная квантовая инженерия становится технически возможной.
GPT-5.6-sol проходит 78% научных задач с бинарной оценкой, а лучшие системы способны выполнять сложные процессы, такие как перенастройка декодера и построение суррогатной модели для системы на 60 кубитов.
Но ошибки по-прежнему слишком серьезны, чтобы их игнорировать.
Агенты:
Разрыв между способностью и надежностью по-прежнему велик.
Именно поэтому Verified Autonomy имеет значение.
Вопрос к будущим научным агентам теперь звучит не просто так:
Может ли модель решить эту задачу?
А так:
Может ли система выполнить весь процесс, ответственно использовать ресурсы, предоставить доказательства и сохранить корректность при изменении среды?
Quantum-Harbor — это контролируемая виртуальная квантовая лаборатория, предназначенная для оценки ИИ-агентов. Она предоставляет агентам реалистичные инструменты и измерения, скрывая параметры устройств, логику оценивания и отложенные условия валидации.
QIQCBench — это бенчмарк на базе Quantum-Harbor, включающий 49 задач в области квантовой инженерии, подготовленных экспертами. Он охватывает измерения, управление, коррекцию ошибок, компиляцию, физику многих тел, коммуникации и сенсинг.
GPT-5.6-sol занял первое место на 39 задачах с бинарным результатом «прошел/не прошел» с долей успешных решений 78%. За ним следуют GPT-5.6-terra с результатом 57% и Claude Opus 4.8 с результатом 51%.
Нет. В статье прямо говорится, что все представленные оценки проводились в симуляции. Надежность работы с реальным оборудованием остается открытой проблемой.
Verified Autonomy означает оценку агента по доказательствам, созданным во время выполнения, а не только по его итоговому ответу. Утверждение должно подтверждаться измерениями, которые агент действительно получил, либо представленная схема должна успешно пройти проверку на новых скрытых данных.
Значительная доля ошибок была связана с управлением процессом, а не с отсутствием знаний из учебников. Из 1 510 неудачных испытаний 937 завершились без итоговой отправки, часто потому, что агенты исчерпали бюджет или застряли в длинных циклах выполнения.
Эти задачи требуют, чтобы агенты выводили скрытое физическое поведение по наблюдениям, а не просто следовали известной процедуре. Суммарная доля успешных решений в категории составила около 15%, причем три лучшие системы значительно опередили остальные 14.
Исследовательская команда объявила Agentic Quantum Coding Challenge на базе QIQCBench и Quantum-Harbor. Публичная страница соревнования доступна через сайт GaugeForge на GitHub Pages.
Quantum-Harbor и QIQCBench переводят оценку ИИ-агентов от статического вопрос-ответа к процессам, которые действительно необходимы научным системам: выбирать эксперименты, взаимодействовать с инструментами, интерпретировать зашумленные наблюдения, управлять ограниченными бюджетами и обосновывать итоговые утверждения доказательствами.
Лучшие системы уже впечатляют. GPT-5.6-sol достигает доли успешных решений 78% на бинарных задачах, а GPT-5.6-terra и Opus 4.8 следуют с результатами 57% и 51%. Однако бенчмарк также показывает, что многие передовые системы терпят неудачу, застревая, чрезмерно расходуя экспериментальные бюджеты, доверяя устаревшим предположениям или отправляя выводы, которые невозможно независимо проверить.
Поскольку все оценки проводились в симуляции, это исследование не показывает, что автономный ИИ готов без контроля управлять работающим квантовым оборудованием. Вместо этого оно предлагает более строгий способ измерить, насколько близко агенты подошли к такой возможности.
Для ИИ в науке следующая важная веха — не просто более умный ответ, а полный экспериментальный процесс, доказательства, использование ресурсов и выводы которого можно независимо проверить.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



