For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
Системы ИИ берут на себя всё большую часть работы по созданию ИИ: пишут программное обеспечение, отлаживают инфраструктуру, проводят экспери...
Системы ИИ берут на себя всё большую часть работы по созданию ИИ: пишут программное обеспечение, отлаживают инфраструктуру, проводят эксперименты и предлагают следующие шаги. Поэтому рекурсивное самоулучшение, обычно сокращаемое до RSI, становится всё более практическим исследовательским вопросом.
Ключевое различие состоит в том, ускоряет ли ИИ процесс, которым руководят люди, или способен самостоятельно спроектировать и разработать более сильного преемника. В представленном отчёте BAAI описывается отрасль, движущаяся в сторону второго варианта. Публичные исследования дают конкретные свидетельства первого, наряду со значительной неопределённостью относительно того, насколько далеко может зайти этот прогресс.
В исследовательском обсуждении Anthropic полное RSI означает, что система становится способной автономно проектировать и разрабатывать своего преемника. Агент для программирования, который улучшает скрипт обучения, может способствовать этому процессу, не замыкая весь цикл полностью.
В этом участвуют несколько различных способностей:
Успех на одном уровне не доказывает успех на каждом последующем уровне. Anthropic прямо заявляет, что в его описании полное RSI ещё не достигнуто и не является неизбежным.
Anthropic сообщает, что по состоянию на май 2026 года Claude написал более 80% кода, включённого в его кодовую базу. Это показатель авторства для принятого кода, а не утверждение, что ИИ принял более 80% всех инженерных решений.
Компания также сообщает, что типичный объём кода на одного инженера во втором квартале 2026 года был примерно в восемь раз выше уровня 2024 года, если измерять его числом строк кода, принятых в день. Существенна и собственная оговорка компании: строки кода несовершенно измеряют количество работы и не должны интерпретироваться как восьмикратный рост полезной продуктивности.
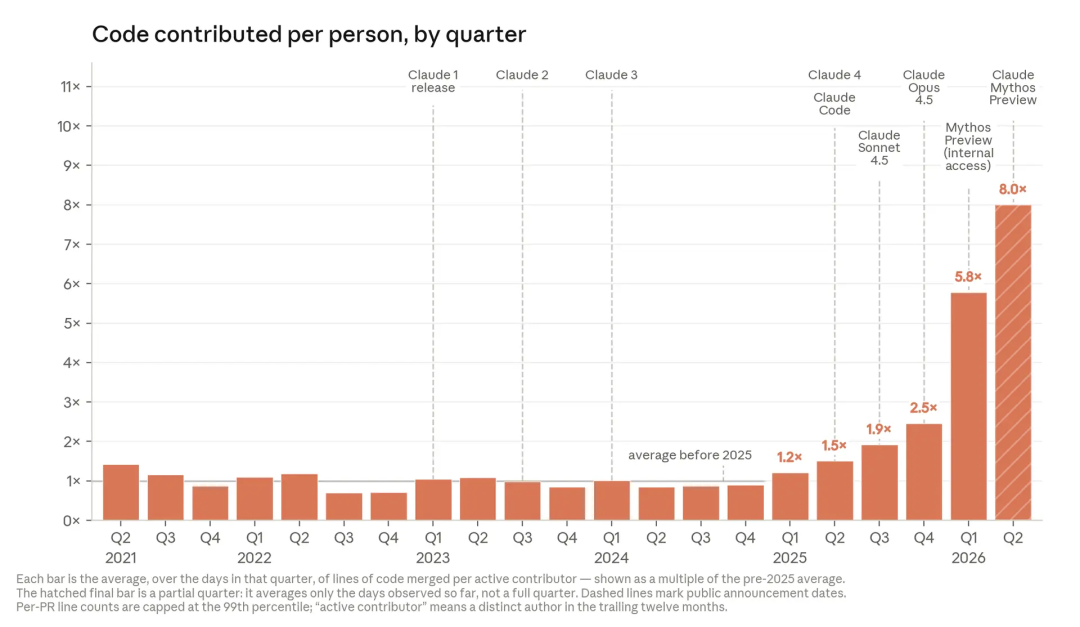
График Anthropic, воспроизведённый в статье Xinzhiyuan на BAAI Hub.
Практическое изменение заключается в том, что инженер может направлять и проверять больший объём работы, не набирая вручную каждую реализацию. При этом цели, качество кода, общая инфраструктура и возможности проверки остаются ограничениями. Это не доказывает, что человеческая проверка стала ненужной.
Написание реализации — лишь часть исследовательской работы. Агенту также нужно запускать эксперименты, изучать результаты и определять, действительно ли изменение помогло.
Anthropic описывает повторяющийся тест оптимизации, в котором модель получает код обучения и пытается ускорить его, сохраняя проверки корректности. Результаты заметно улучшались от поколения модели к поколению. Компания предупреждает, что абсолютное ускорение зависит от того, какой запас для оптимизации есть в исходном коде; это не измерение эквивалентного ускорения обучения передовых моделей.
Ещё один пример даёт проект автоматизированного исследования перехода от слабого к сильному. Агенты могли предлагать и выполнять эксперименты в рамках выбранной людьми задачи и системы оценки. Это свидетельство автоматизации исследований в заданных границах, а не демонстрация того, что система самостоятельно выбрала наиболее ценную исследовательскую повестку.
SWE-bench оценивает изменения программного обеспечения на задачах из репозиториев и тестах. Горизонты времени выполнения задач METR изучают длительность задач, которые модели могут выполнить при заданных уровнях надёжности.
Эти измерения отвечают на разные вопросы. Система может становиться лучше в исправлении проблем репозитория или выполнении более длительных задач, не умея самостоятельно планировать успешную программу разработки модели.
Результаты по временным горизонтам также являются вероятностными. Продолжительность задачи в бенчмарке не означает, что агент сможет надёжно работать столько же астрономического времени над любым проектом. Важны человеческие базовые показатели, пороги успеха, доступ к инструментам и распределение задач.
В исходной статье приводятся обсуждения в социальных сетях о внутренних агентах, более коротких циклах выпуска, невыпущенных моделях и крупных научных результатах. Такие сообщения могут указывать на темы, достойные изучения, но сами по себе не демонстрируют автономный цикл самоулучшения.
Более короткие интервалы между релизами могут иметь несколько объяснений. Решение моделью сложных математических задач демонстрирует способность в этих задачах; само по себе это не показывает, что модель улучшила собственный процесс обучения. Аналогично, анонимное заявление о внутренней модели лаборатории не заменяет технический отчёт с воспроизводимыми данными.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Обоснованный вывод более узок: публичные раскрытия показывают, что ИИ выполняет растущую долю инженерной работы и некоторых экспериментальных исследований. Остаётся открытым вопрос, приведёт ли этот прогресс к полному RSI.
Anthropic обсуждает как потенциальные преимущества, так и риски всё более автоматизированной разработки. Более способные исследовательские агенты могут ускорить научную работу, одновременно усложняя верификацию, мониторинг и выравнивание.
Тот же процесс способен создавать и обычные операционные узкие места. Если агенты генерируют код быстрее, чем люди могут его проверять, более быстрая генерация не преобразуется напрямую в более быстрое и надёжное развёртывание. Доступность вычислительных ресурсов, качество экспериментов и решения о том, что именно создавать, остаются значимыми даже тогда, когда реализация становится дешевле.
Поэтому оценка RSI должна отслеживать доказательства на каждом этапе: что сделал агент, кто выбрал его цель, какие ресурсы он использовал и как был проверен результат.
RSI означает рекурсивное самоулучшение. В этом контексте оно относится к системе ИИ, которая становится способной автономно проектировать и разрабатывать более сильного преемника, а не просто помогать человеку улучшать программное обеспечение.
Генерация кода показывает, что часть процесса разработки можно автоматизировать. Полное RSI потребовало бы гораздо более широкого сочетания выбора исследовательского направления, реализации, обучения и оценки, поэтому высокая доля кода, написанного ИИ, не является достаточным доказательством.
Он относится к коду, авторство которого приписывается Claude и который был включён в кодовую базу Anthropic по состоянию на май 2026 года. Его не следует интерпретировать как долю всей работы компании, выполненной автономно, или как долю стратегических решений, принятых ИИ.
Они могут указывать на изменение объёма выпуска, но не измеряют напрямую полезность, сопровождаемость или бизнес-ценность. Anthropic сама предупреждает, что её восьмикратный рост объёма кода, вероятно, завышает реальный прирост продуктивности.
Они описывают производительность на конкретном наборе задач при заявленных уровнях успеха, используя длительность выполнения задач людьми как ориентир. Они не гарантируют, что агент сможет завершить любое реальное задание сопоставимой длительности.
Да; агент может проектировать и проводить эксперименты в рамках задачи и системы оценки, заданных людьми. Это может быть ценной автоматизацией исследований, при которой решения более высокого уровня остаются за людьми.
В основном обсуждении Anthropic прямо сказано, что это не неизбежно. Исследовательское суждение, вычислительные ресурсы, инфраструктура, оценка и другие узкие места могут ограничить или изменить траекторию, а прогнозы следует отделять от продемонстрированных результатов.
Публичные данные подтверждают существенный рост программирования с поддержкой ИИ и автоматизации исследований в заданных границах. Эти достижения делают перспективу рекурсивного самоулучшения достойной изучения, но не доказывают, что полностью автономный цикл разработки преемника уже существует.
Ключевой вопрос заключается в том, какие части разработки ИИ система может выполнять и проверять независимо, а не в том, насколько впечатляющими выглядят её график релизов или заголовочный результат бенчмарка.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



