Tencent Hunyuan выпустила предварительную версию Hy ASR 3.0 — новой модели распознавания речи в реальном времени, основанной на языковых воз...
Компания Тенсент выпустила Hy ASR 3.0 Preview — новую модель распознавания речи в реальном времени, построенную на основе языковых возможностей Hy3.
Данная модель призвана вывести автоматическое распознавание речи за рамки изолированного акустического декодирования.
Традиционные системы ASR в основном отвечают на один вопрос:
Какая последовательность слов лучше всего соответствует этому аудио?
Hy ASR 3.0 добавляет второй вопрос:
Какая транскрипция наиболее осмысленна в данном контексте?
Это различие становится критически важным, когда аудио содержит:
В Тенсенте заявляют, что модель сочетает высокоточную акустическую систему с контекстным моделированием и смысловым выводом Hy3. Её цель — не творчески пересказывать сказанное пользователем, а выбирать более правдоподобный вариант транскрипции, используя языковой контекст, когда само аудио неоднозначно.
В Тенсенте сообщают, что на агрегированных публичных тестовых наборах уровень ошибок в словах (WER) для путунхуа составляет 3,34%, для английского — 2,62%, для кантонского — 3,12%.
Hy ASR 3.0 Preview уже доступен как движок Tencent Cloud Realtime WebSocket с документационной поддержкой и интегрирован в ассистента Tencent Yuanbao. Приложения WorkBuddy и другие продукты Тенсента постепенно подключаются.
Публичная предварительная версия уже доступна, однако она ещё не представляет собой финальную версию продукта, описанную в более широких анонсах. Текущие ограничения API могут быть существенны для команд, планирующих производственную интеграцию.
Тенсент оценил Hy ASR 3.0 Preview на нескольких публичных наборах речевых данных и сравнил его с другими системами ASR.
Компания сообщает следующие агрегированные показатели WER:
| Язык или речевой вариант | WER Hy ASR 3.0 Preview |
|---|---|
| Путунхуа | 3,34% |
| Английский | 2,62% |
| Кантонский | 3,12% |
Чем ниже WER, тем лучше.
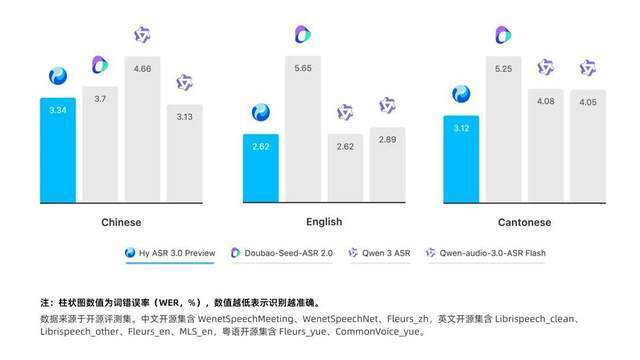
Примечания к диаграмме указывают, что в агрегированной оценке использовались следующие наборы данных:
Агрегированные данные полезны для широких сравнений, но могут скрывать важные различия.
Модель может показывать разные результаты в разных сценариях:
Поэтому производственным командам следует тестировать модель на собственном аудио.
Не стоит выбирать систему ASR, полагаясь только на один показатель WER из заголовка.
Уровень ошибок в словах обычно определяется так:
WER = (замены + удаления + вставки) / количество слов в эталонной транскрипции
Три типа ошибок:
Более низкий WER обычно означает более точную транскрипцию.
Однако WER не охватывает все типы сбоев в реальных сценариях.
Рассмотрим две ошибки в одном слове:
«Ship the order tomorrow»
→ «Ship the order today»
И:
«The color is navy blue»
→ «The colour is navy blue»
Обе могут дать одинаковое количество ошибок, но первая может изменить деловое действие, тогда как вторая может вообще не иметь никакого влияния на бизнес.
Для таких областей, как обслуживание клиентов, здравоохранение, финансы, производство и голосовые интерфейсы управления, командам следует оценивать и смысловое влияние, и WER.
Тенсент также опубликовал результаты внутренних тестовых наборов, охватывающих четыре практические категории:
Заявленные результаты:
| Внутренняя категория оценки | WER Hy ASR 3.0 Preview |
|---|---|
| Общее распознавание | 4,95% |
| Распознавание диалектов | 9,31% |
| Контекстная оценка | 4,76% |
| Сложные акустические условия | 6,36% |
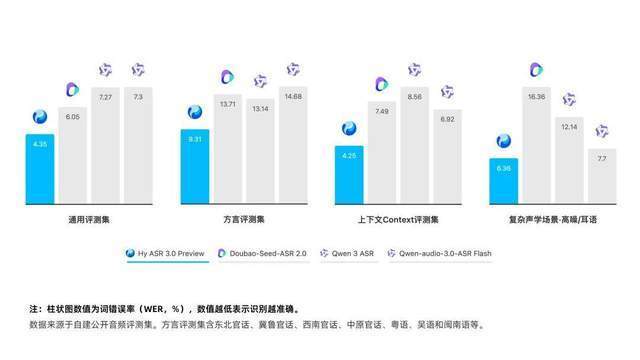
Тенсент заявляет, что Hy ASR 3.0 Preview достиг наименьшего WER среди сравниваемых систем во всех четырёх внутренних категориях.
Эти результаты полезны как заявленные компанией свидетельства качества продукта, однако внутренние тестовые наборы не являются нейтральным публичным бенчмарком.
Перед внедрением организациям следует задать вопросы:
Тенсент сводит практические улучшения к четырём областям.
Модель призвана улучшить распознавание в следующих сценариях:
Тенсент также заявляет, что модель снижает накопление ошибок в более длинных высказываниях.
Это утверждение описывает базовые возможности модели. Однако текущая предварительная версия Tencent Cloud по-прежнему ограничивает один публичный API-запрос 60 секундами, поэтому приложениям, обрабатывающим совещания или записи, сейчас приходится разбивать аудио на сегменты.
И самостоятельно управлять контекстом между фрагментами.
Неудачная сегментация может заново создать те проблемы, которые модель призвана решать.
Например, разрезание аудио по произвольным 60-секундным границам может разорвать:
Поэтому логика сегментации должна по возможности сохранять границы предложений и границы речевой активности.
Речь содержит множество неоднозначных звуков.
В путунхуа много омофонов. В английском есть слова и имена, которые звучат похоже. Диалектное произношение может сделать несколько вариантов транскрипции акустически правдоподобными.
Традиционные декодеры могут выбирать слово с локальной максимальной вероятностью.
Системы с учётом контекста могут оценивать всё высказывание целиком.
Например, пользователь может произнести фразу, которую можно транскрибировать как два разных омофона. Слова по теме финансов, игр, медицины или путешествий в ближайшем контексте могут подсказать, какое значение более вероятно.
Ожидаемый процесс обработки можно упростить так:
Аудиофункции
→ Слова-кандидаты
→ Контекст предложения
→ Проверка семантической согласованности
→ Итоговый текст транскрипции
Это не означает, что модель способна по-настоящему понимать речь так же, как человек.
Скорее это означает, что языковые компоненты используют более широкое контекстное окно и семантические вероятности для улучшения решений по транскрипции.
Контекстно-зависимые системы ASR также несут новый риск: семантическая сверхкоррекция.
Модель иногда может заменить редкую, но правильно произнесённую фразу на более распространённую, которая кажется более естественной.
Поэтому оценка в производственной среде должна включать:
Цель — использовать контекст, не выдумывая речевое содержание, которого не было в звуке.
В маркетинговых материалах подчёркивается улучшение с помощью hotword (ключевых слов), применимое к:
Когда общая модель недостаточно часто встречает редкое слово, hotword-списки могут быть особенно полезны.
Примеры:
Фирменные названия лекарств
Модели заводского оборудования
Коды клиентских счетов
Новые запущенные бренды
Технические аббревиатуры
В продукте Tencent Cloud Universal ASR уже есть API для списков hotword и параметр hotword_id.
Однако в текущей документации предварительной версии Hy ASR 3.0 прямо указано, что улучшение с помощью hotword пока не доступно для этого предварительного движка.
Поэтому следует различать публичные заявления о продукте и фактически доступный статус API:
| Возможность | Описание в релизных заметках модели | Текущий статус предварительного API |
|---|---|---|
| Улучшение с помощью hotword | Описано как поддерживаемая возможность | Указано как «скоро появится» |
| Контекстный ввод | Описан как ключевая возможность | Указано как «скоро появится» |
| Внутреннее контекстное языковое моделирование | Ключевая особенность модели | Доступно через поведение модели |
Предприятиям не следует строить планы запуска, зависящие от внешнего контекстного ввода или hotword-списков, пока Tencent Cloud не подтвердит поддержку в официальной документации API.
Tencent сообщает, что модель оптимизирована для следующих случаев:
Устойчивость к шуму важна, потому что реальная речь редко похожа на чистые лабораторные записи.
Микрофон службы поддержки может улавливать звуки клавиатуры и голоса коллег рядом.
Мобильный ассистент может слышать дорожный шум, ветер, музыку или чужие разговоры.
Приложения для конференций могут получать сжатый аудиопоток с микрофона ноутбука, находящегося далеко.
Модель может повысить устойчивость, но не может восстановить информацию, которая никогда не была захвачена.
Командам по-прежнему следует использовать:
Качество ASR — это свойство всей системы, а не только модели.
Tencent сообщает, что Hunyuan Hy ASR 3.0 Preview объединяет три основных компонента:
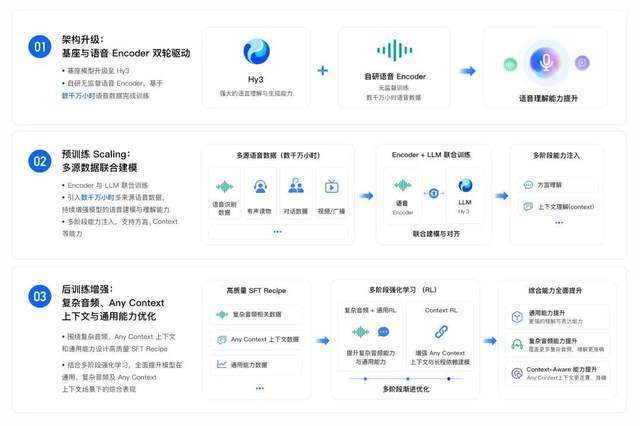
Hy3 предоставляет компонент языкового понимания.
Его функции включают:
Tencent описывает эту архитектуру как дизайн смеси экспертов (MoE), балансирующий производительность и эффективность.
В публичной документации по ASR не раскрываются полное число параметров, число активных параметров, профиль задержки или полная архитектура логического вывода Hy ASR 3.0 Preview.
Речевой энкодер преобразует сырой звук в акустическое представление, которое может обрабатывать языковая модель.
Tencent сообщает, что энкодер обучался на десятках миллионов часов немаркированной речи.
Обучение без учителя или самообучение на аудио ценно, потому что ручная транскрипция такого объёма речевых данных стоила бы непомерно дорого.
Энкодер может извлекать из сырого аудио повторяющиеся структуры, такие как:
Качество этого представления влияет на все последующие этапы.
Если на этапе энкодера два звука оказываются перепутаны, языковая модель должна сильнее полагаться на контекст, чтобы восстановить правильные слова.
Tencent сообщает, что речевой энкодер и языковая модель обучались совместно на крупномасштабных многоисточниковых речевых наборах данных, охватывающих:
Совместное обучение направлено на сокращение разрыва между акустическим распознаванием и языковым пониманием.
Вместо того чтобы рассматривать распознавание речи как:
Аудиомодель завершает работу
→ Языковая модель затем чистит транскрипт
Hy ASR 3.0 представлен как более интегрированный процесс:
Речевое представление и языковое моделирование
→ Обучение работает совместно
→ На выходе контекстуализированная транскрипция
Точные внутренние границы между энкодером, декодером, языковой моделью и этапами обучения с подкреплением полностью не раскрыты.
Tencent описывает схему обучения с учителем (SFT), охватывающую:
Компания также сообщает об использовании многоэтапного обучения с подкреплением для:
В настоящее время нет публичных технических статей с полным описанием дизайна вознаграждений, распределения данных, вычислительных мощностей для обучения или результатов абляционных экспериментов.
Поэтому заявления об архитектуре следует рассматривать как техническое описание на уровне продукта, а не как воспроизводимую исследовательскую спецификацию.
Документация Tencent Cloud описывает текущий движок Hy-ASR-3.0-preview как поддерживающий:
Список диалектов из документации выглядит так:
| № | Диалект или региональный вариант |
|---|---|
| 1 | Кантонский |
| 2 | Дунбэйский |
| 3 | Хэнаньский |
| 4 | Шэньсийский |
| 5 | Чэндуский |
| 6 | Чунцинский |
| 7 | Уханьский |
| 8 | Гуйянский |
| 9 | Циндаоский |
| 10 | Цзинаньский |
| 11 | Чаншаский |
| 12 | Хэфэйский |
| 13 | Хэбэйский |
| 14 | Куньминский |
| 15 | Ланьчжоуский |
| 16 | Иньчуаньский |
| 17 | Наньчанский |
| 18 | Пекинский |
| 19 | Сычуаньский |
| 20 | Тяньцзиньский |
Ярлыки диалектов в коммерческой документации по ASR — это широкие продуктовые категории.
Каждая категория реальной речи различается в зависимости от города, возраста, социального окружения, переключения кодов, лексики и конкретного говорящего.
Заявление о поддержке того или иного диалекта не следует понимать как одинаково высокую точность для каждого носителя языка в данном регионе.
Tencent Cloud 4 августа 2026 года добавила движок предварительной версии Hy ASR 3.0 в продукт реального времени на базе WebSocket.
Данный публичный сервис в настоящее время описывается как версия внутреннего тестирования или предварительная версия.
| Позиция | Текущий задокументированный статус |
|---|---|
| Тип продукта | Распознавание речи в реальном времени |
| Способ подключения | Tencent Cloud WebSocket API |
| Название движка | Hy-ASR-3.0-preview |
| Длительность аудио | Не более 60 секунд на одно обращение |
| Формат аудио | 16 кГц, моно, PCM |
| Включённый параллелизм | 20 параллельных соединений |
| Путунхуа | Поддерживается |
| Английский язык | Поддерживается |
| 20 диалектов | Поддерживается |
| Разделение говорящих | Не поддерживается в предварительной версии |
| Поддержка параметров VAD | Указано как неподдерживаемое в предварительной версии |
| Замена слов | Не поддерживается в предварительной версии |
Параметр порога шума | Не поддерживается в предварительной версии |
| Внешний контекстный ввод | Скоро появится |
| Улучшение ключевых слов | Скоро появится |
Общая справочная документация WebSocket API содержит параметры, используемые другими движками, включая VAD и идентификаторы ключевых слов.
Hy ASR 3.0 руководствуется специализированным описанием предварительной версии движка.
Наличие параметра в общей схеме API не гарантирует, что предварительная версия движка в настоящее время реализует данный параметр.
Официальная настройка состоит из трёх основных этапов.
Откройте сервис распознавания речи Tencent Cloud и завершите процесс активации аккаунта.
Официальная документация по быстрому старту доступна по адресу:
https://cloud.tencent.com/document/product/1093/54362
Перед включением постоплатного тарифа ознакомьтесь с условиями оплаты.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Tencent Cloud отмечает, что для новых аккаунтов постоплатный тариф по умолчанию отключён и требует ручного включения.
Создайте или получите:
AppIDSecretIDSecretKeyЭти учётные данные используются для подписи запросов на подключение к WebSocket.
Храните их в менеджере секретов или в защищённых переменных окружения.
Не размещайте долгосрочные действительные учётные данные в:
Для браузерных или мобильных продуктов создавайте подписанную информацию для подключения на доверенном бэкенде.
Формат конечной точки, задокументированный в Tencent Cloud:
wss://asr.cloud.tencent.com/asr/v2/?{request_parameters}
Замените `` на ваш AppID Tencent Cloud.
Запрос содержит параметры подписи, например:
secretidtimestampexpirednoncevoice_idengine_model_typeДля предварительной версии Hy ASR 3.0 укажите:
engine_model_type=Hy-ASR-3.0-preview
Каждое WebSocket-соединение требует уникального voice_id.
Если соединение завершено или прервано, старый voice_id становится недействительным, и необходимо сгенерировать новый.
Текущая предварительная версия требует:
Частота дискретизации: 16 кГц
Каналы: моно
Формат: PCM
Максимальная длительность входа: 60 секунд
Тестируйте полный аудиотракт, а не только исходный файл.
Микрофонные SDK, браузерные медиа-API, телефонные системы и платформы конференц-связи могут выполнять ресемплинг или сжатие аудио до его поступления на сервер.
Сервис поддерживает транскрипцию в реальном времени, возвращая текст по мере передачи аудио.
Приложение должно обрабатывать:
Не предполагайте, что каждый частичный результат распознавания является финальным.
Интерфейс ASR в реальном времени может исправлять ранее распознанные слова по мере получения дополнительного контекста.
Пользовательский интерфейс должен различать промежуточный и подтверждённый текст.
Сформируйте репрезентативный оценочный набор, включающий:
шум;
Оценивайте как качество распознавания, так и поведение системы.
Tencent Cloud относит Hy ASR 3.0 предварительной версии к категории движок распознавания речи в реальном времени Large Model 2.0.
Текущая страница тарифов указывает:
| Тарифный вариант | Текущая цена |
|---|---|
| Пакет предоплаты 60 часов | Итого 60 юаней, т.е. 1,00 юань/час |
| Пакет предоплаты 1 000 часов | Итого 950 юаней, т.е. 0,95 юаня/час |
| Пакет предоплаты 10 000 часов | Итого 9 000 юаней, т.е. 0,90 юаня/час |
| Пакет предоплаты 100 000 часов | Итого 88 000 юаней, т.е. 0,88 юаня/час |
| Пакет предоплаты 300 000 часов | Итого 255 000 юаней, т.е. 0,85 юаня/час |
| Постоплата | 1,00 юань/час, ежедневное списание |
Текущая таблица тарифов Tencent показывает, что распознавание Large Model 2.0 не предоставляет бесплатного объёма аудио.
Включённые 20 параллельных соединений — это квота параллелизма, а не бесплатное время распознавания.
Цены могут меняться. Перед подготовкой коммерческих предложений или оценкой долгосрочного бюджета проверяйте актуальную страницу тарифов.
По текущей постоплатной ставке 1,00 юань/час:
100 часов успешного распознавания
× 1,00 юань/час
= 100 юаней
Производственный бюджет также должен включать:
Стоимость ASR — лишь часть полноценной системы транскрипции.
Tencent сообщает, что Yuanbao участвовал в разработке модели и стал первым продуктом Tencent, интегрировавшим её.
Пользователи могут опробовать функцию через голосовой ввод в Yuanbao; модель предназначена для улучшения:
Tencent заявляет, что другие продукты, такие как WorkBuddy, постепенно подключаются.
Интеграция в потребительских продуктах может отличаться от публичного API предварительной версии Tencent Cloud.
Например, Yuanbao может использовать внутренние сервисы, продуктовый контекст или конфигурации развёртывания, недоступные внешним разработчикам.
Не следует предполагать, что опыт в Yuanbao полностью соответствует параметрам публичного API.
Предварительная версия Hy ASR 3.0 ориентирована на короткие низкозадержные голосовые взаимодействия.
Потенциальные сценарии включают:
Предварительная версия в настоящее время не поддерживает разделение говорящих, что может ограничивать транскрипцию многосторонних звонков без дополнительных компонентов для разделения каналов или говорящих.
Движок может поддерживать короткие субтитры в реальном времени для:
Приложения должны тестировать стабильность частичных результатов и поведение пунктуации.
Контекстно-зависимое распознавание может улучшить поиск, включающий:
Пока в предварительной версии не открыта возможность загрузки горячих слов, редкие
термины и специфическая лексика могут требовать постобработки или отдельного слоя исправления ошибок.
Движок может преобразовывать устные команды в текст для:
Управление интеллектуальными устройствами.
Командная система ни в коем случае не должна выполнять операции с высоким уровнем воздействия только потому, что результат транскрипции выглядит высокоуверенным.
Для разрушительных или финансовых операций необходимо подтвердить распознанное намерение и запросить явное одобрение пользователя.
Короткие аудиофрагменты могут быть транскрибированы перед передачей в следующие процессы:
Качество последующей обработки ИИ на каждом этапе зависит от результата транскрипции.
Если политика позволяет, храните исходный аудиофайл или данные об уверенности, чтобы неоднозначные результаты можно было проверить.
Продукт по-прежнему помечен как предварительная версия или внутренняя бета-версия.
Интерфейс, цены, ограничения и поддерживаемые функции могут изменяться.
Текущий публичный API не может напрямую заменить пакетную транскрипцию длинных записей.
Длинные аудиофайлы требуют сегментации и, возможно, наличия контекстного слоя на уровне приложения.
Предварительная версия в настоящее время требует PCM с частотой 16 кГц в моно-режиме.
Многие производственные среды используют MP3, AAC, Opus или телефонные кодеки, что требует конвертации.
В документации, специфичной для текущего движка, указано, что разделение говорящих не поддерживается.
Транскрипция нескольких говорящих может потребовать отдельных аудиоканалов или другого сервиса разделения говорящих.
Согласно официальной документации, заявленные возможности еще не доступны в публичном предварительном API.
Диаграммы сравнения взяты у Tencent.
Независимая оценка при сопоставимых условиях повысит достоверность сравнения.
Tencent предоставила высокоуровневое описание архитектуры и процесса обучения Hy ASR 3.0 Preview, но полные воспроизводимые детали не опубликованы.
Языковой декодер может отдавать предпочтение распространенным предложениям, игнорируя редкие, но фактически правильно произнесенные фразы.
Тестирование должно включать редкие и неожиданные фразы.
Включите как минимум несколько сотен репрезентативных высказываний, а не небольшой набор чистых демонстрационных образцов.
Создайте проверенные вручную эталонные транскрипции с четкой стратегией нормализации.
Определите, как обрабатывать:
Используйте:
Не объединяйте всех носителей диалектов в одно среднее значение.
Представляйте результаты отдельно по регионам и условиям записи.
Создайте парные образцы с акустически схожим содержимым, где контекст предложения меняет правильный результат транскрипции.
Оцените названия продуктов и
Сначала работайте с терминами, затем повторите тестирование после открытия поддержки хот-вордов в Tencent.
Используйте реальные записи окружающей среды, а не только цифровое наложение шума.
Убедитесь, что реализация 60-секундной сегментации не обрывает важные высказывания и не создает дублирующегося текста.
Включите следующие этапы:
Захват
+ Загрузка
+ Распознавание
+ Финализация результата
+ Последующая обработка
Голосовые записи могут содержать личную или чувствительную информацию.
Перед развертыванием необходимо четко определить политику хранения данных, контроля доступа, шифрования, согласия пользователей и удаления.
| Область | Традиционный конвейер | Направление Hy ASR 3.0 |
|---|---|---|
| Основное внимание | Точность от акустики к тексту | Акустическое распознавание плюс контекстное языковое моделирование |
| Легко спутываемые омофоны | Обычно опирается на локальные вероятности | Использует более широкий контекст предложения |
| Диалекты | Отдельные модели или ограниченное покрытие | Единый документированный гибридный движок с поддержкой 20 диалектов |
| Специализированная лексика | Внешние хот-ворды или пользовательские модели | Заявлена поддержка хот-вордов; ожидается в предварительной версии |
| Сложная речь | Акустическая модель плюс постобработка | Совместное обучение речи и языку плюс пост-обучение |
| Выходные данные | Транскрибированный текст | Транскрибированный текст с более связным контекстом |
| Основной риск | Акустические замены и пропуски | Акустические ошибки плюс возможная семантическая чрезмерная коррекция |
Новый подход не устраняет необходимость в традиционной ASR-инженерии.
Он добавляет более мощный языковой слой поверх той же сквозной системы.
Hy ASR 3.0 Preview — это модель распознавания речи в реальном времени, выпущенная Tencent Hunyuan на основе языковой базы Hy3 и собственного речевого кодировщика. Ее цель — объединить акустическое распознавание с контекстным пониманием языка.
Документация Tencent Cloud указывает на поддержку стандартного путунхуа, английского и 20 китайских диалектов или региональных вариантов, включая кантонский, дунбэйский, хэнаньский, шэньсийский, чэндуский, чунцинский, уханьский и другие. Точность может варьироваться в зависимости от говорящего и региона.
Tencent опубликовал агрегированные результаты WER для публичных бенчмарков: путунхуа — 3,34%, английский — 2,62%, кантонский — 3,12%. Это результаты, сообщенные компанией на основе нескольких наборов данных, а не независимо воспроизведенные результаты единого теста.
Текущая публичная предварительная версия принимает до 60 секунд аудио за один вход. Более длинные записи требуют сегментации, а приложение должно сохранять действующий контекст между сегментами.
Согласно документации предварительной версии Tencent Cloud от 4 августа 2026 года, в настоящее время нет. Эти возможности описаны в релизных материалах, но официальные страницы API показывают, что контекстный ввод и расширение хот-вордов будут открыты позже.
Текущая документация Hy ASR 3.0 Preview указывает поддержку ввода PCM с частотой 16 кГц в моно-режиме. Приложения, использующие MP3, AAC, Opus или другие форматы, должны конвертировать аудио перед вызовом.
Отправляйте его в этот движок.
Разработчики используют WebSocket API Tencent Cloud для распознавания речи в реальном времени и устанавливают engine_model_type в значение Hy-ASR-3.0-preview. Соединение должно быть подписано учетными данными Tencent Cloud.
Текущая страница выставления счетов Tencent Cloud не указывает бесплатную квоту аудио для распознавания большой модели 2.0. На странице указано, что предоплаченные пакеты начинаются с 60 часов по цене 1 юань за час, постоплата — 1 юань за час, при этом включено 20 параллельных соединений.
com/document/product/1093/135476): текущий официальный статус, поддерживаемые диалекты, ограничения и базовые настройки.
Предварительная версия Hy ASR 3.0 от Tencent Hunyuan сочетает речевой кодировщик с языковыми возможностями Hy3 для улучшения транскрипции в условиях мандарина, английского, диалектов, смешанных языков, шумной среды и контекстно-зависимых сценариев.
Tencent сообщает о WER 3,34% для мандарина, 2,62% для английского и 3,12% для кантонского диалекта на агрегированных публичных наборах данных, а также о ведущих результатах в собственных внутренних тестах. Эти цифры обнадёживают, но требуют проверки на аудио материалах каждой организации.
Текущая предварительная версия Tencent Cloud уже по функциональности, чем полная концепция релиза.
Она поддерживает потоковое распознавание через WebSocket, моно PCM с частотой 16 кГц и аудиовход длительностью до 60 секунд. Внешняя контекстная инъекция, улучшение горячими словами, разделение говорящих и ряд других функций на данном движке пока недоступны.
Ключевое изменение заключается не в том, что распознавание речи перестало слушать звук, а в том, что языковая модель теперь помогает определить, что звук, скорее всего, означает.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



