curl -sL https://www.example.com/ | grep -o "[^"
curl -sL https://www.example.com/ | head -c 1200
如果回傳裡只有 `
` 和一堆 script 標籤、沒有可讀的公司名、產品名和段落文字,那搜尋爬蟲第一次拿到的就是這份空殼。Google 的 JavaScript SEO 文件說明了抓取與渲染的關係:腳本內容並非完全不可見,但渲染需要額外的抓取佇列與資源,內容和連結越依賴腳本,被正確讀取的不確定性越大(見 [Google JavaScript SEO 基礎](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics))。
**改法**:讓關鍵內容進初始 HTML——伺服器端渲染、靜態生成,或至少把標題、正文、內鏈輸出成真實標籤。判斷標準很簡單:關掉瀏覽器 JavaScript,頁面還要能讀。
## 檢查二:Title 和 Meta Description 寫對了嗎

AI 生成頁面最容易漏掉的是中繼資料,因為它們在視覺上完全不可見。三個高頻錯誤:
- **全站同一個 Title**:模板變數沒替換,所有頁面都是「首頁 | 某某科技」;
- **Description 為空**:Google 只能自行摘取正文,摘要常常讀起來毫無資訊量;
- **Title 過長**:中文標題超過約 30 個字在行動端會被截斷,賣點被切掉。
```html
企業官網搭建:從需求到上線的完整流程 | 品牌名
自查方式:抽 5 個核心頁面(首頁、產品頁、定價頁、案例頁、部落格頁),確認 Title 各不相同、都含該頁主題詞;Description 是完整的一句話,而不是關鍵詞堆疊。
檢查三:sitemap.xml 與 robots.txt 是否真的可用
這兩個檔案是爬蟲進入網站的入口,也是 AI 建站最容易被忽略的兩個檔案——因為它們在介面上不存在。
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
重點核對三件事:sitemap 裡的網域必須是正式網域而不是預覽網域;被 Disallow 的路徑不能同時出現在 sitemap 裡;Sitemap: 一行必須是絕對位址。
同時要清楚 robots.txt 的邊界。Google 在其索引指南中提醒,robots.txt 控制的是抓取,並不是可靠的防收錄手段:被 robots.txt 攔截的 URL 仍可能因為外部連結而出現在搜尋結果裡;需要頁面明確不進索引時,應使用 noindex(robots meta 標籤或 X-Robots-Tag 回應標頭)。Google 也在 2026 年 10 月的文件更新中新增了「只索引面向搜尋的內容」一節,建議把僅用於分享、協作或工具輸出的生成頁預設設為不索引,並透過 Search Console 的頁面索引報告與搜尋成效報告監控索引異常(詳見 Google 索引指南更新解讀)。
檢查四:canonical 指向的是不是本頁
rel=canonical 告訴搜尋引擎「這一組相似 URL 裡,哪個是主版本」。AI 生成時常出現三類錯誤:
- 所有頁面都指向首頁,等於告訴 Google 每個頁面都是首頁的副本;
- 指向預覽或測試網域,正式頁面反而被當作副本;
- 帶參數的位址與乾淨位址互相指認,導致訊號來回打架。
-
正確做法是:canonical 使用絕對位址、https、與你希望被收錄的最終 URL 完全一致(含或不含結尾斜線要全站統一);多語言網站每個語言版本指向自己,並用 hreflang 建立對應關係,而不是互相 canonical 到英文版。
檢查五:結構化資料有沒有寫進錯誤資訊

AI 很擅長「補全」結構化資料,也很擅長順手編造:不存在的評分、沒有的價格區間、虛構的成立年份。這些都違反了結構化資料的基本要求——資料必須與頁面可見內容一致。
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "品牌名",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
原則是寧少不濫:只寫頁面上能看到的欄位;不確定的成立時間、評分、庫存狀態一律刪掉;發布前用結構化資料測試工具跑一遍,確認沒有解析錯誤。
檢查六:表單、彈窗和互動會不會擋住爬蟲
表單本身不影響索引,問題出在它們經常「頂替」了正文:整頁只有一張留資表單、內容鎖在登入後、首屏彈一個全螢幕彈窗要求先同意 Cookie。對爬蟲而言,這些頁面缺乏可用於匹配搜尋意圖的文字。
另外,AI 建站常生成大量「用完即棄」的頁面——表單提交成功頁、報價結果頁、分享連結。這類頁面若被索引,會稀釋網站品質。按 Google 的建議,把它們預設設為 noindex 更穩妥(索引指南解讀);真正面向搜尋的落地頁則應保留完整可見的 HTML 正文,而不是靠點擊才展開。
幾分鐘搭建展示站並增長獲客
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
檢查七:下一次用 AI 改頁面,會把 SEO 設定改回去嗎
這是 AI 建站最容易被低估的風險:頁面是持續生成的,今天手工補好的 Title、canonical、robots 規則,明天一次「幫我改下配色、順便優化文案」的重生成就可能被覆蓋。
可行的做法是流程約束,而不是靠記憶:
- 把 SEO 相關設定集中在模板或全域設定裡,減少逐頁手寫;
- 每次重新生成後,把檢查清單跑一遍,至少覆蓋首頁、產品頁、定價頁;
- 關注 URL 數量的異常成長:模板改動或新功能上線常會批次產生新 URL,Google 建議同時監控平台側的內容建立量與索引量變化(同上);
- 上線前固定一次「設定項 Diff」:Title、canonical、robots、sitemap 四項對比上一次發布版本。
檢查八:為什麼這件事值得投入
技術 SEO 不是小圈子話題。據 Mordor Intelligence 的統計,技術 SEO 服務市場 2025 年規模為 15.73 億美元,預計從 2026 年的 16.89 億美元成長到 2031 年的 28.37 億美元,2026—2031 年複合年成長率約 10.93%;其中技術 SEO 類別在 2025 年占比 32.41%,原因正是渲染、網站結構、重新導向、結構化資料與頁面效能直接決定了內容能否被大規模發現和取回,報告同時指出 Google 仍將 Core Web Vitals 納入搜尋評估(數據見 Technical SEO Services 市場報告)。換句話說,頁面上線只是開始,能否被抓到、被理解、被引用,才是搜尋與 AI 搜尋時代的入場券。
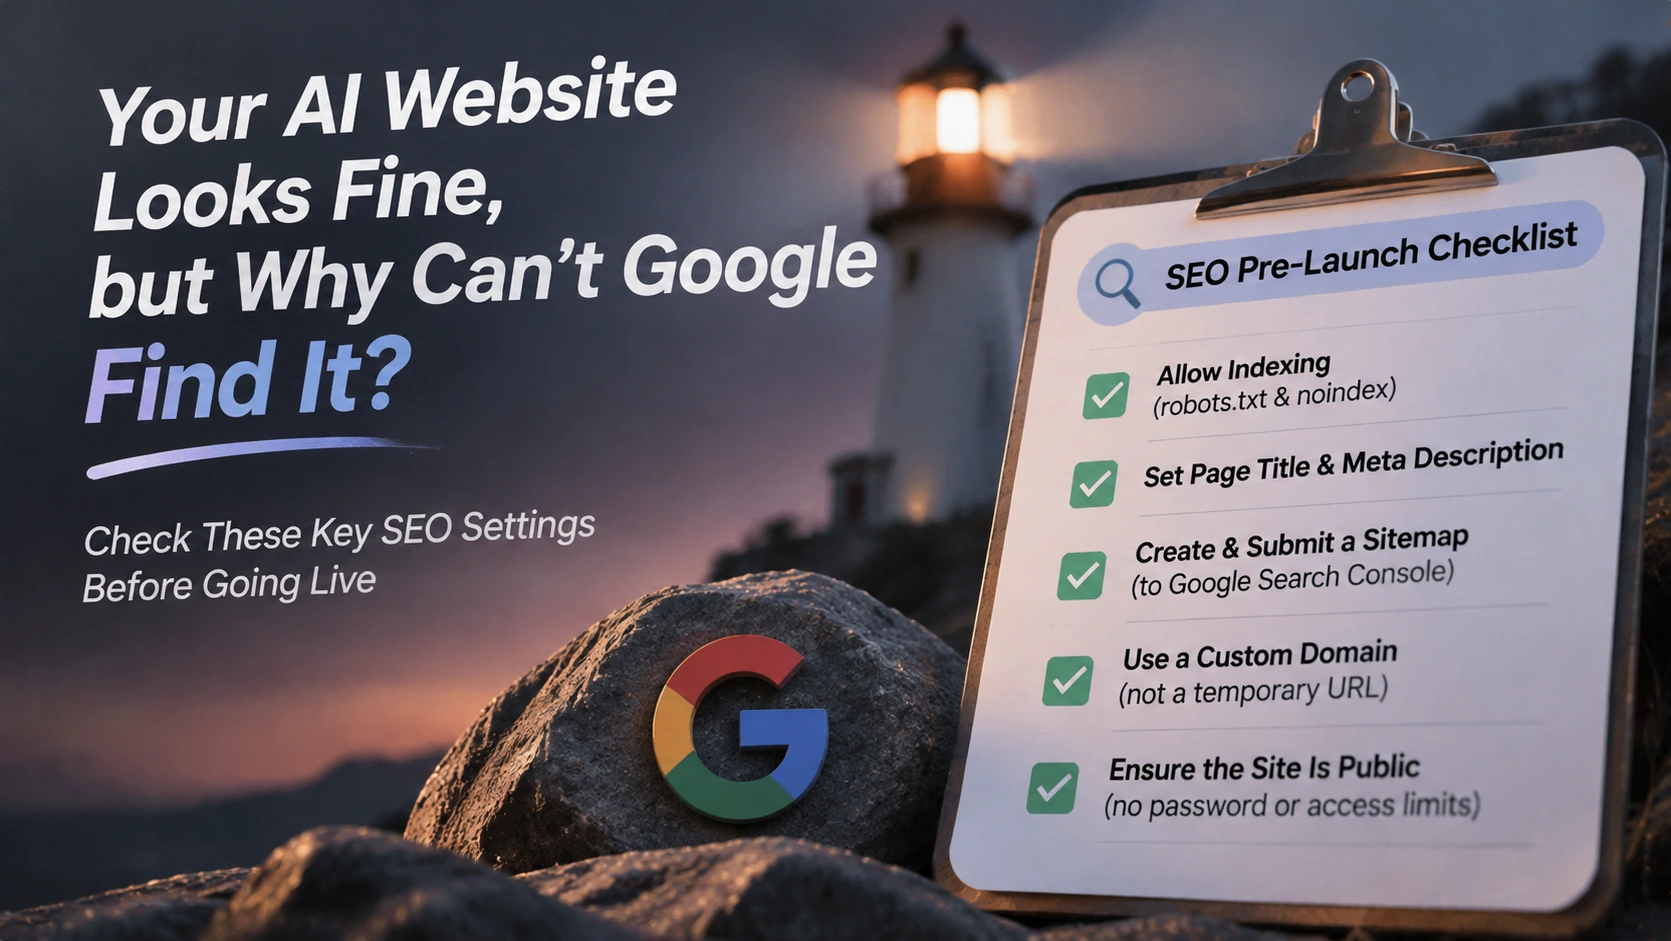
AI 建站上線前的 10 項 SEO 檢查清單
| # | 檢查項 | 通過標準 |
|---|---|---|
| 1 | 初始 HTML | 關閉 JS 後仍能看到標題與正文 |
| 2 | HTTP 狀態 | 核心頁面回傳 200,舊位址 301 到新位址 |
| 3 | Title | 每頁唯一、含主題詞、長度可控 |
| 4 | Meta Description | 每頁獨立、是完整句子 |
| 5 | robots.txt | 只攔後台與預覽路徑,Sitemap 用絕對位址 |
| 6 | sitemap.xml | 只含正式網域與可索引頁面 |
| 7 | canonical | 指向自身正式 URL,全站斜線規則統一 |
| 8 | noindex | 預覽站、結果頁、分享頁預設不索引 |
| 9 | 結構化資料 | 只寫頁面可見欄位,無解析錯誤 |
| 10 | 互動與表單 | 正文不被彈窗、登入牆、表單獨占 |
這張表的價值不在「高級技巧」,而在可重複:每次發布前跑一遍,十分鐘能擋掉大多數「做好了但搜不到」的情況。
企業現在應該做什麼
如果你正用 AI 工具建站,可以把順序調成:先生成結構與內容,再補中繼資料與索引規則,最後統一做一次發布前核驗。像 We0 這類 AI 建站平台已經把頁面生成、CMS 後台、網域部署與 SEO/GEO 設定位在同一條鏈路裡(可參考 We0 官網),生成速度快並不改變一個前提:搜尋引擎只認實際輸出到 HTML 裡的東西,所以上線後的實測仍然不可省略。
具體動作建議三步:先用 curl 看初始 HTML,再用搜尋控制台確認抓取與索引狀態,最後把上面 10 項做成發布前的固定環節,並寫進團隊的上線流程文件。
FAQ
Q:AI 生成的網站天生不符合 SEO 要求嗎?
不是。AI 生成只是產出的方式,問題在於生成過程預設關注「頁面看起來對不對」,而不檢查「搜尋引擎讀到了什麼」。只要初始 HTML 含正文、中繼資料與索引規則正確,AI 建站和手動建站在搜尋表現上沒有本質差別。
Q:頁面在 Google 裡搜不到,是不是被降權了?
多數情況還沒到「降權」這一步,而是尚未被抓取或索引。先查索引狀態,再查是否被 robots.txt 或 noindex 攔住,最後才輪到內容品質與競爭度。
Q:只做 sitemap 提交,能不能保證被收錄?
不能。sitemap 是發現線索,不是收錄承諾;它能讓爬蟲更快知道你有哪些頁面,但頁面能否索引取決於抓取存取、內容品質與索引規則。
Q:JavaScript 渲染的頁面,Google 一定讀不到嗎?
不一定,但不確定性更高。渲染需要額外資源,且頁面越依賴腳本,首屏文字和連結被正確讀取的機率越低。把核心內容放進初始 HTML 是成本最低的保險。
Q:多久能看到效果?
索引與排名沒有統一時程表,取決於抓取頻率、網站規模與競爭情況。可以確定的是:設定錯誤會一直生效,直到你發現並修正它。
相關工具
- Google Search Console:查看頁面索引報告與搜尋成效
- Google JavaScript SEO 文件:確認渲染與抓取的實際規則
curl/ 瀏覽器開發者工具:驗證初始 HTML 與關閉 JS 後的可讀性- 結構化資料測試工具:校驗 JSON-LD 是否可解析
相關連結
摘要
AI 建站讓上線變快,但沒有改變搜尋引擎的工作方式:它讀 HTML、讀回應標頭、讀連結結構,而不是讀你螢幕上的效果圖。上線前把初始 HTML、Title 與 Description、robots.txt 與 sitemap、canonical、noindex、結構化資料、表單與互動這七處核一遍,再把它們固化成流程,就能把「網站做好了卻沒流量」從常態變成可排查的問題。