關鍵字搜尋量回答的是「有多少人用這組詞搜尋」,它沒有回答「這個人在做決定之前還會問什麼」。AI 搜尋把後者變成決定性變數:當用戶在 ChatGPT、Perplexity、Gemini 或 Google AI Mode 裡提出一個帶約束條件的問題時,引擎會自己生成多條子查詢去檢索,再把檢索到的段落拼成一個帶引用的答案。決定你能否被引用的,不再只是有沒有排上某個詞,而是頁面裡有沒有能單獨被抽出來、正好回答某條子查詢的段落。
所以更準確的說法是:搜尋量仍是有用的需求規模信號,但它是起點指標,不是終點指標。關鍵字研究要新增三件事——這條需求背後的完整問題鏈、每個問題對應的檢索形態、以及頁面是否具備可被抽取的答案塊。
為什麼只看搜尋量會漏掉真實的購買意圖
傳統流程是「主關鍵字 → 相關詞 → 內容」,它假設每次搜尋都是獨立、詞形固定的需求。用戶行為已經改變:一條真實提問常常同時包含預算、場景、相容性和使用方式,例如「一萬五以內、能剪影片、續航好、方便出差的筆電」。這些條件在 AI 搜尋裡會被拆成不同分支分別檢索。
以 B2B 採購為例,「best CRM software」背後通常是一串連續追問:小型企業適合哪一個?支援郵件自動化嗎?能和 Shopify 打通嗎?月費最低的是哪個?這四問的檢索價值可能高於原始詞本身,但月搜尋量往往接近零——很少有人把完整問句打進搜尋框,可他們會這樣問 AI。
由此出現兩個漏洞。第一,低搜尋量不等於低商業價值。第二,搜尋量對答案形態沒有任何提示:它不會告訴你比較類需求需要一張表、流程類需求需要編號步驟、定義類需求需要一段能獨立成立的三五十字解釋。而恰恰是這些形態,決定內容能否被檢索到。
什麼是 Query Fan-Out(查詢扇出)
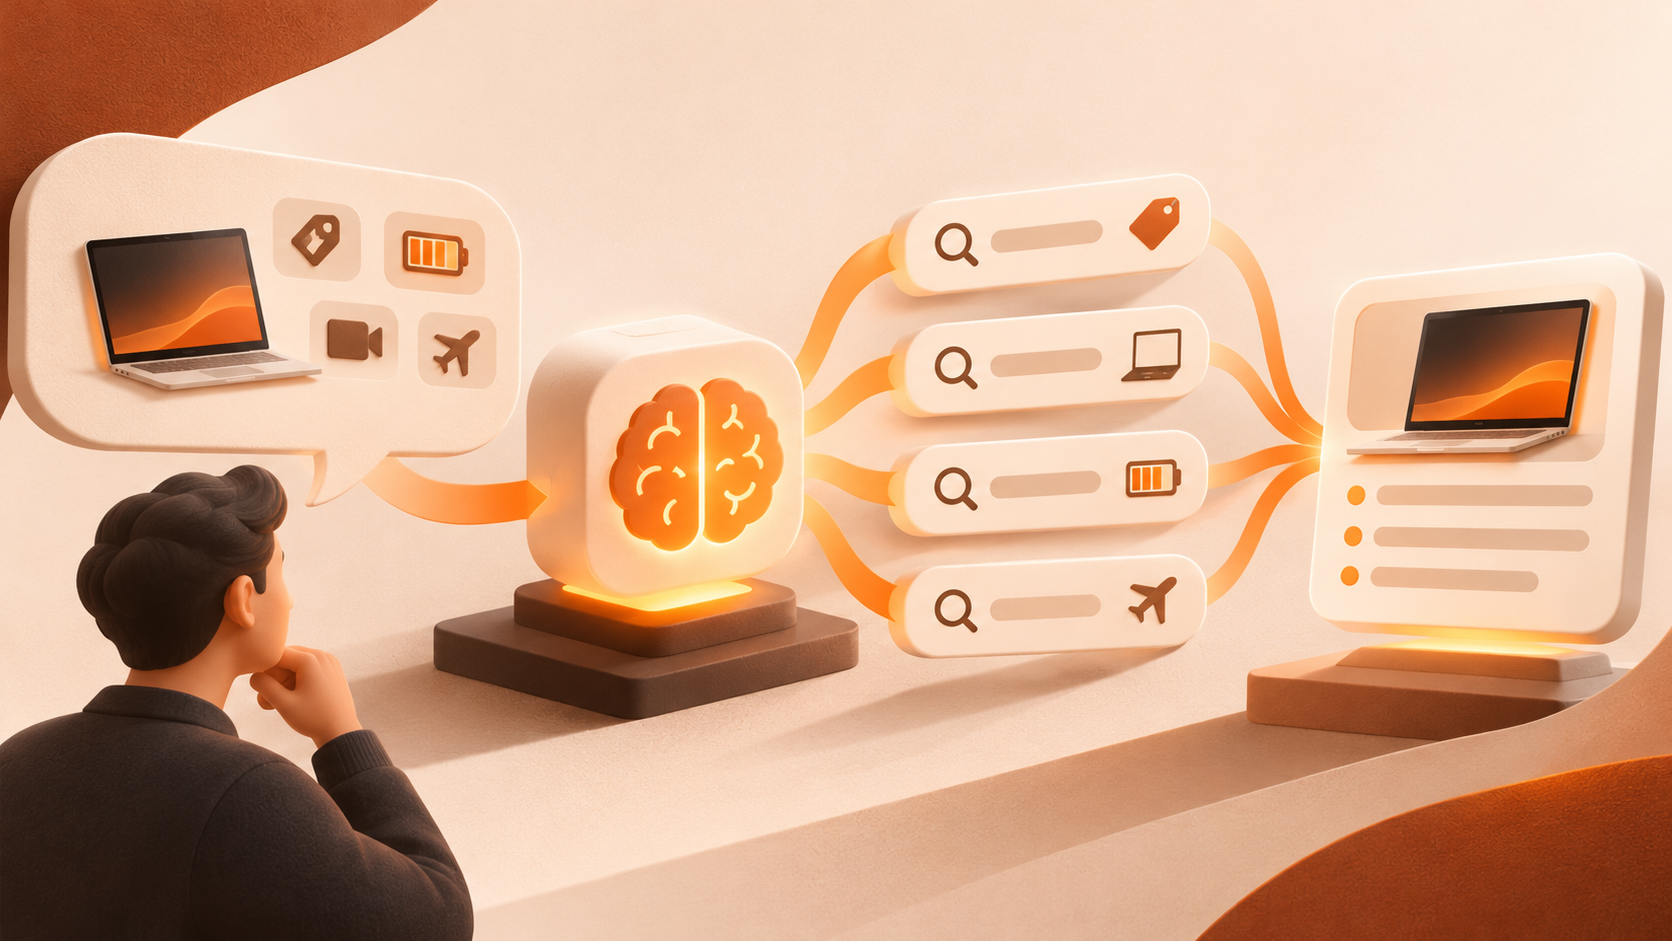
Query Fan-Out 指 AI 搜尋引擎把一條提問拆成若干條由模型自己生成的子查詢,並行檢索、為返回段落打分,再合成一個帶引用的答案。Google 在 AI 功能文件中說明,AI Mode 與 AI Overviews 這類體驗可能使用該技術,從而呈現比常規結果頁「更廣、更多樣的一組有用連結」(Google Search Central)。
工程上通常分五步:識別意圖與複雜度、生成子查詢、過濾高度重複的子查詢、並行檢索、合成答案並附引用。第三步最容易被忽略:系統偏好覆蓋度而不是重複,兩個內容近似的頁面一般不會同時進入檢索。
規模上,公開觀測大致是:AI Mode 單次提問約產生 8–12 條並行子查詢(實測常見 3–8 條);ChatGPT 平均每次聯網搜尋 4.7 條子查詢;「上百次搜尋」只適用於 Deep Search 這類多輪管線,上限約 20 輪。更關鍵的是子查詢的形態——反向分析顯示其平均長達 70–80 個詞,複雜度約為傳統三四個詞關鍵字的 17–26 倍(MaximusLabs)。引擎不是拿你的關鍵字去搜,而是拿一段帶上下文和使用場景的完整描述去搜。
扇出也不是無條件發生。相關專利把是否生成子查詢與輸入長度、查詢頻次、結果品質、token 數量、伺服器負載綁定。短導航型或簡單事實型提問,常只執行一次接近原始提問的檢索;長比較型、評估型提問才會展開最大的分支樹。預算因此應優先壓在複雜的商業問題上。
搜尋意圖從「一個詞」變成「一條問題鏈」
導航、資訊、商業調查、交易這四類意圖依然成立,但在 AI 搜尋裡,一條主意圖會延伸出多層子意圖。以 "How do I choose the best SEO tool for my business?" 為例,主意圖是選工具,子意圖卻包括:我需要哪類工具?預算多少?哪些功能是關鍵?要不要技術 SEO 能力?新手和代理機構分別適合什麼?
這裡要區分兩個常被混用的概念:關鍵字聚類把相似的詞按意圖、語義和 SERP 重疊度歸組,解決內容怎麼組織;Query Fan-Out 描述一個問題如何裂變成多條檢索路徑,包括用戶從未明說的主題,解決檢索怎麼發生(SEO for Today)。前者是編輯方法,後者是工程機制,不能互相替代。
表:八類子查詢及其需要的內容形態
對扇出分支歸類後,一次提問通常會產生八類子查詢,每類需要的段落形態不同。這張表可以直接當內容自查清單:
| 子查詢類型 | 示例 | 需要的內容形態 |
|---|---|---|
| 精確匹配 | best CRM software | 直接給出選項的答案塊 |
| 語義變體 | top CRM platforms | 換用買方另一種說法重述同一答案 |
| 導航型 | 某廠商定價頁 | 可抓取、結構清晰的產品或定價頁 |
| 比較型 | A vs B for small business | 帶明確屬性的表格行 |
| 定義型 | what is pipeline attribution | 可獨立成立的三五十字短定義 |
| 流程型 | how to migrate CRM data | 編號步驟,一步一個動作 |
| 榜單型 | CRM tools for agencies | 帶篩選條件的可掃讀列表 |
| 場景型 | CRM for a 3-person team | 點名團隊規模與使用場景的限定句 |
純散文頁面通常只覆蓋其中兩三類:沒有表格,比較分支就無內容可抽;沒有編號步驟,流程分支就落空;從沒寫過團隊規模,場景分支就匹配不上。格式在這裡不是排版偏好,而是可檢索性本身。
從一個關鍵字擴展到完整問題鏈:五步操作法
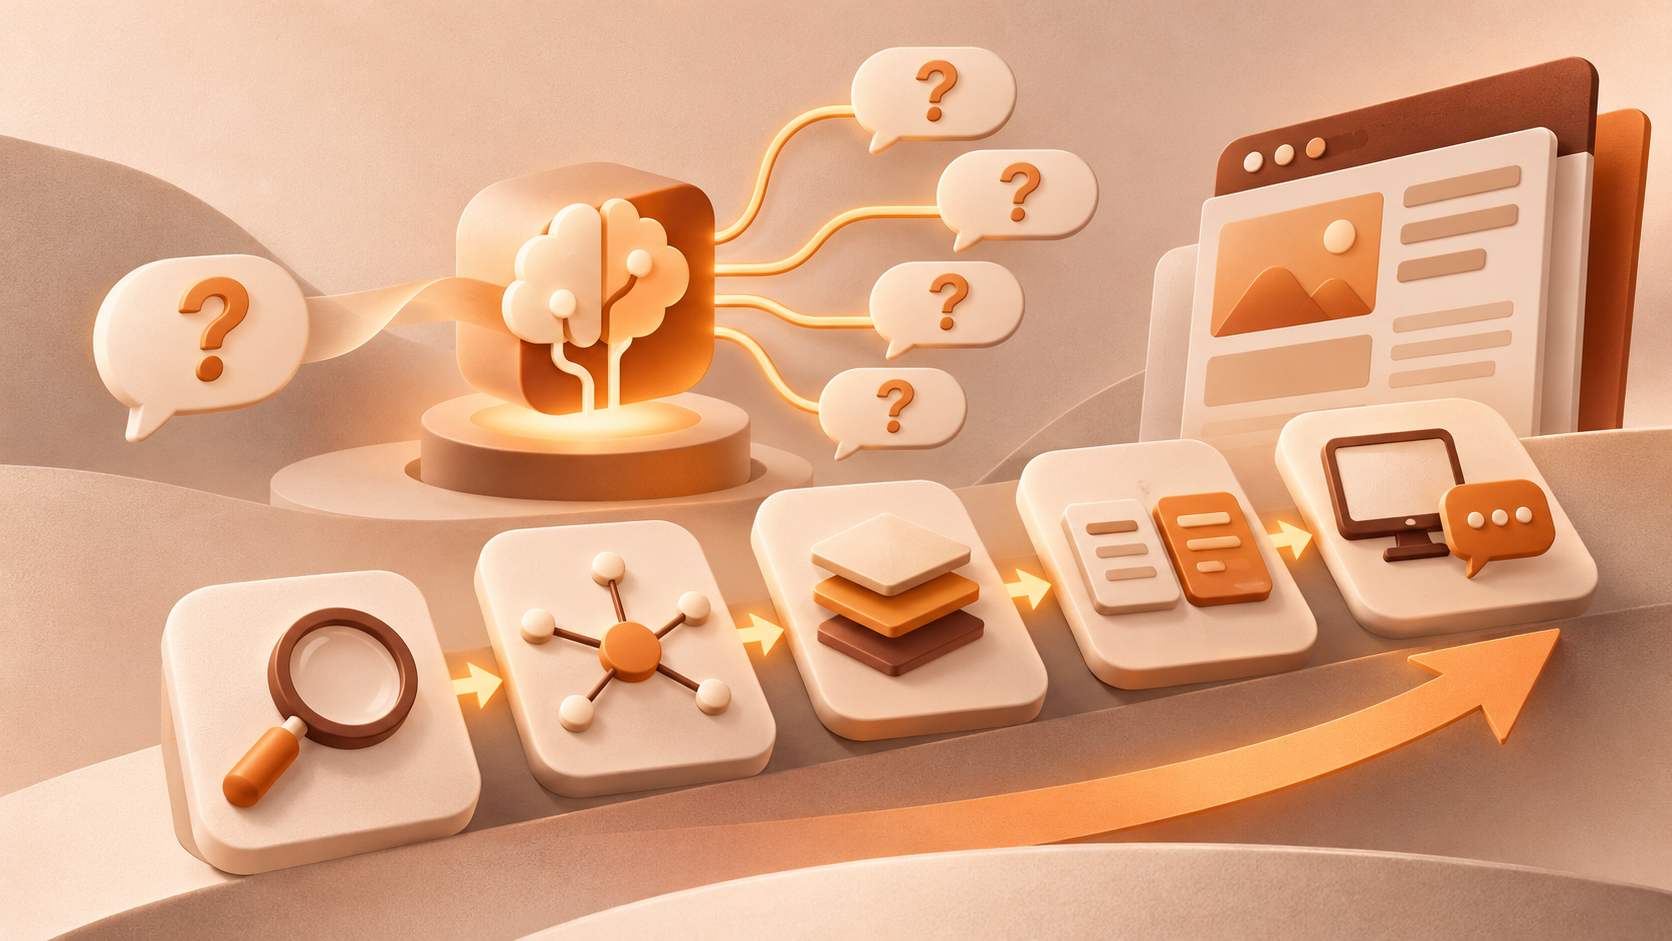
第一步,列種子提示詞而不是關鍵字。收集 10–20 條理想客戶在預約演示前真的會打出來的問題,越口語越好。
第二步,把每條種子放進 Perplexity 跑一遍。它的介面會顯示實際執行的檢索,是目前少數可以觀察扇出行為的地方。
第三步,逐條記錄它帶出的 5–8 個相關問題,保持原話,不要改寫成關鍵字。
第四步,用 AlsoAsked 這類問答工具交叉核對同一組種子,補上被漏掉的分支。
第五步,把存活的子問題映射成已有頁面上的 H2 與 H3。原則是「一個問題簇一個頁面」,而不是「一個子查詢一個頁面」:為每條子查詢單獨建薄頁面會稀釋權威度,也會觸及 Google 對規模化內容濫用的政策邊界(MaximusLabs)。
需要明確,真實分支樹是會話化、帶個人化的,外部無法完整複刻。問題鏈是重建出來的近似值,適合做覆蓋度規劃,不適合當作精確數據對外匯報。
幾分鐘搭建展示站並增長獲客
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
內容集群:把問題鏈變成三層結構
落地時可以分三層:支柱頁回答「這個決策該怎麼做的完整框架」;子頁承接有獨立搜尋需求的子問題,例如某類方案對比、某個行業的價格結構;FAQ 塊承接枝節問題,例如相容性、退款、最低配置。
判斷一個子問題要不要單獨成頁,用三個檢查:它在真實對話裡會被單獨提問嗎?它的回答任務是否支柱頁無法承擔而又不跑題?你能用一句話說清它和同級頁面不重疊的地方嗎?三問都通過,才建新頁。
同時要意識到底部漏斗的優先級差異。購買型提問的扇出通常集中在價格、方案、免費額度、退款政策和競品對比上,比較頁與定價頁因此比定義頁更容易進入購買路徑;定義型問題往往被引擎自己回答掉,贏得它更多只是獲得一次提及。
FAQ 與產品頁應該如何分工
兩者承擔不同檢索任務,混在一起會讓兩邊都變差。產品頁的目標是把「是否適合我」說清楚:誰適用、包含什麼能力、邊界在哪、價格結構如何、怎麼開始。它應該顯式寫出團隊規模、使用場景、整合項和限制條件,因為這些正是場景型子查詢用來匹配的限定資訊。
FAQ 的目標是消除決策摩擦,回答那些不進主幹、但用戶一定會問的枝節問題。每條答案要能脫離上下文獨立成立:把代詞換成實體名,先給結論再補條件,長度控制在幾十字。
頁面內部的結構順序也是檢索決策。在引用模式觀測中,約 44% 的引用份額集中在前 30% 的正文,之後逐步遞減(MaximusLabs)。所以最商業化的答案應出現在頁面前三分之一,而不是留到最後。
搜尋引擎與對話式搜尋能同時覆蓋嗎
多數情況下可以,重疊比想像中大。幾個主要入口的偏好並不衝突:AI Mode 看重子主題覆蓋與段落清晰度;ChatGPT 看重自包含的問答塊與專業信號;Perplexity 看重時效與來源透明;Claude 的研究模式看重深度與方法。它們的交集是答案前置、來源可見、語言平實、正文有真實深度。
一個方向性變化值得注意:在公開觀測中,AI Overview 引用對前 10 名自然結果的依賴從約 76% 降到約 38%,另有相當比例引用來自排名 100 名之外的位置(MaximusLabs)。它的含義不是「排名無用」,而是「排名不再是引用的唯一門檻」——段落能否被抽取、能否直接回答問題,權重明顯上升。
基礎功依然要做:技術可抓取性、內容結構、內部連結與結構化資料,仍是進入 AI 搜尋體驗的前提(Google Search Central)。
企業現在應該做什麼:六項檢查清單
| 優先級 | 動作 | 完成標準 |
|---|---|---|
| 1 | 用 10–20 條真實客戶提問替換關鍵字清單 | 每條都是完整口語問句 |
| 2 | 在 Perplexity 裡跑一遍並記錄後續問題 | 每條種子至少記錄 5 個分支 |
| 3 | 給核心商業頁做八類子查詢覆蓋自查 | 八類中至少覆蓋六類 |
| 4 | 在每個 H2 下補一個獨立答案塊 | 代詞換成實體名,先結論後條件 |
| 5 | 把最商業化的區塊前移到前三分之一 | 首屏之後一屏內出現 |
| 6 | 為每個問題簇指定唯一歸屬頁 | 沒有兩個頁面回答同一問題 |
同時保留一部分搜尋量判斷:它仍是估算需求規模、排定優先級、判斷季節性的低成本信號。真正要放棄的是「搜尋量高就寫、低就不寫」這條單線規則。
we0 如何承接這條鏈路
問題鏈要變成內容資產,最終得落在網站上:面結構、FAQ 塊、比較表、結構化資料、多語言版本和後續更新節奏。we0.ai 提供的路徑是把建站與內容增長放在同一個工作台:用自然語言描述需求,由多 Agent 協作生成可運行頁面,在視覺化畫布上調整後部署到自有域名,再用 CMS 後台持續維護內容,並在站點側處理 SEO 與 GEO 相關設置(we0.ai)。
對需要快速驗證問題簇的團隊來說,這種一體化的價值不在於「生成得多快」,而在於從一句需求到頁面發布、再到按問題鏈檢查覆蓋度,中間不必在三四個工具之間來回搬運內容與文案。
FAQ
Q:關鍵字搜尋量還需要看嗎?
需要,但用於判斷需求規模與優先級,而不是選題的唯一依據。搜尋量無法反映子查詢分支、答案形態和意圖層級,這三項要靠問題鏈研究補齊。
Q:Query Fan-Out 和關鍵字聚類是一回事嗎?
不是。關鍵字聚類按意圖和語義把相似的詞歸組,用於組織內容;查詢扇出是引擎把一次提問拆成多條子查詢並行檢索的機制,用來解釋檢索行為。
Q:怎麼判斷自己的頁面能不能被引用?
從可抽取性入手:每個小節是否有可獨立成立的答案塊、是否點名了實體與適用場景、是否有表格或步驟、來源是否可見。這些都能人工核對,不必依賴第三方分數。
Q:小團隊沒有預算做完整研究怎麼辦?
先做最小閉環:選 10 條真實客戶提問,跑一遍對話式檢索並記錄分支,把核心商業頁補齊表格、步驟和答案塊,按季度複跑並標註日期,用來區分結果變化來自內容調整還是引擎更新。
Related Tools
- Google Search Central 的 AI 功能文件:確認官方口徑與基礎要求。
- Perplexity:介面可見檢索過程,適合觀察扇出行為。
- AlsoAsked:按關鍵字取問題簇,補全被漏掉的分支。
- we0.ai:從建站到內容運營與 SEO/GEO 設置的一體化工作台。
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站與獲客工作台
Summary
搜尋量沒有失效,它只是從「選題依據」退回到「需求規模參考」的位置。關鍵字研究的新增工作,是把一個詞擴展成一條完整問題鏈,為每個問題準備可被抽取的答案形態,再用問題簇而不是單詞來分配頁面。這樣做既服務傳統搜尋結果,也服務會自己改寫查詢的對話式搜尋。判斷標準也隨之改變:不是這個詞有多少搜尋量,而是當用戶連續追問到第四、第五個問題時,你的站點還能不能成為被引用的那一個答案。