一份實用的 Gemini 3.5 Flash 開發者指南,涵蓋三個代價高昂的 API 遷移陷阱、GitHub Copilot 的 14 倍計量、思考保留造成的 token 膨脹、真實的 MCP 風格工具迴圈,以及快速遷移檢查清單。此版本亦將開發者工作流程選擇,與 We0 AI 展...
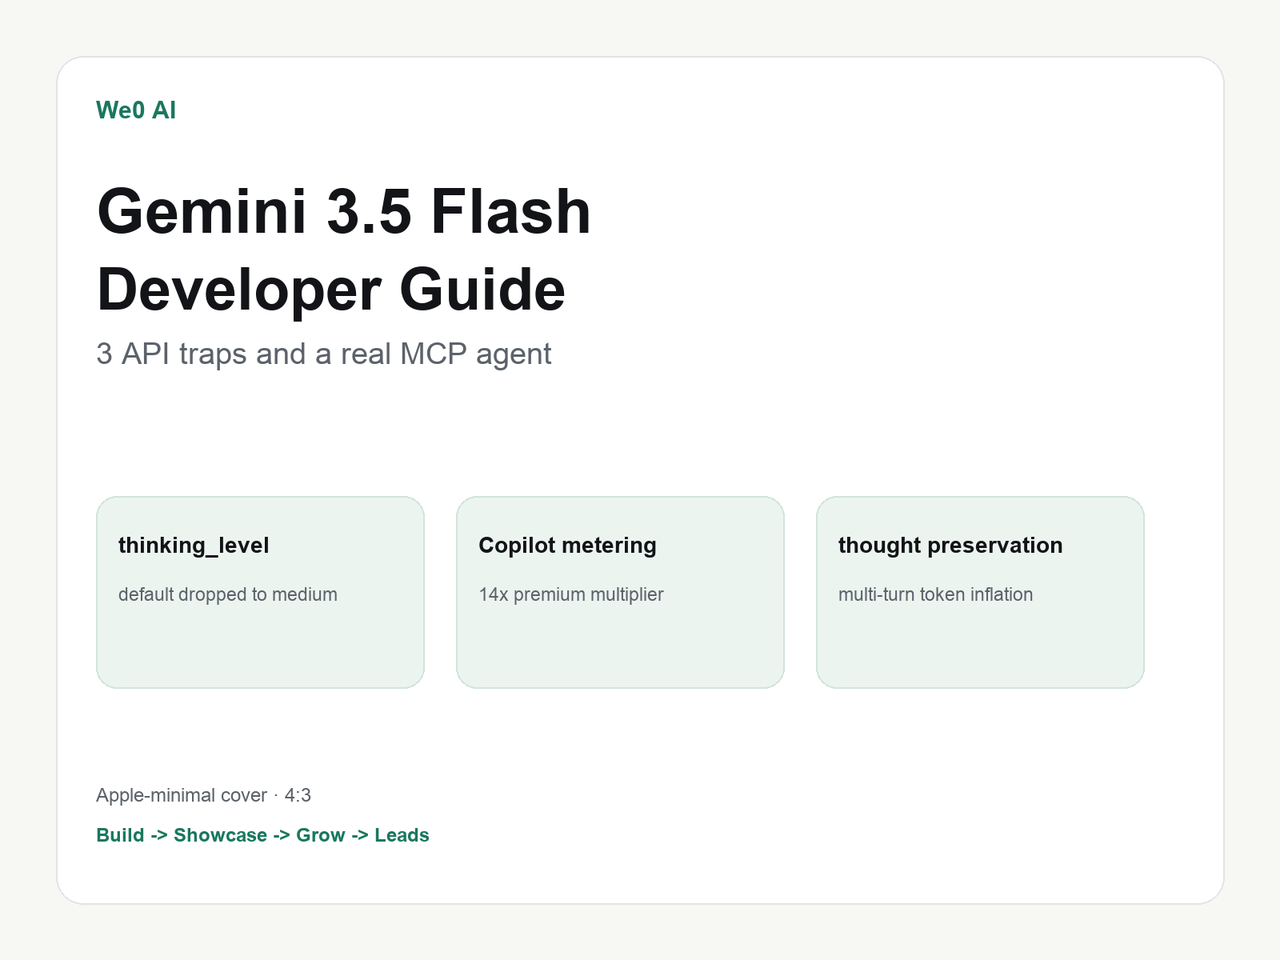
Gemini 3.5 Flash 最昂貴的錯誤,是無聲預設值,而不是語法錯誤。
對很多編碼代理而言,low比大家預期中更適合作為預設值。
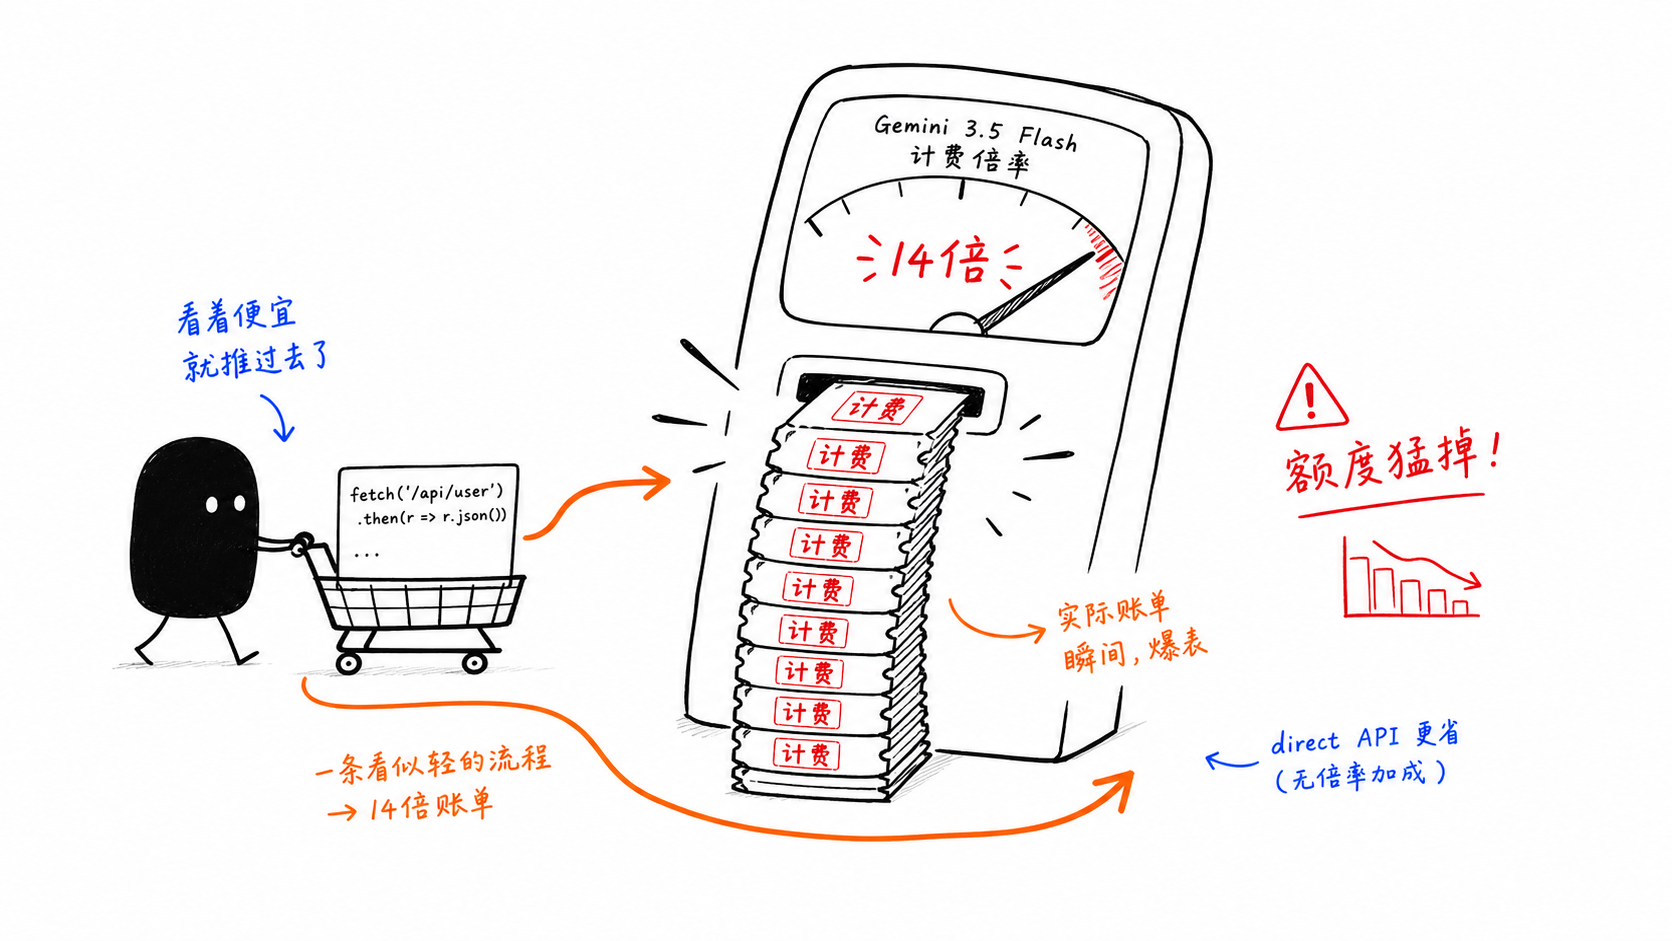
透過 GitHub Copilot 執行的重度代理迴圈,可能因為 14 倍計費而變得貴得多。
在 We0 AI,模型選擇只係工作流程嘅一部分,其餘在於產品如何被說明、呈現及發現。
gemini-3.5-flash 看起來很容易呼叫。
正因如此,也很容易低估它。即使只是把預覽版時期的程式碼作小幅遷移,仍可能產生較差的輸出、不同的成本結構,以及更昂貴的多輪迴圈,而且完全不會拋出任何明顯錯誤。
本指南聚焦於最重要的三個陷阱、可避免它們的程式碼寫法,以及一個你可以快速調整使用的實用 MCP 風格代理迴圈。
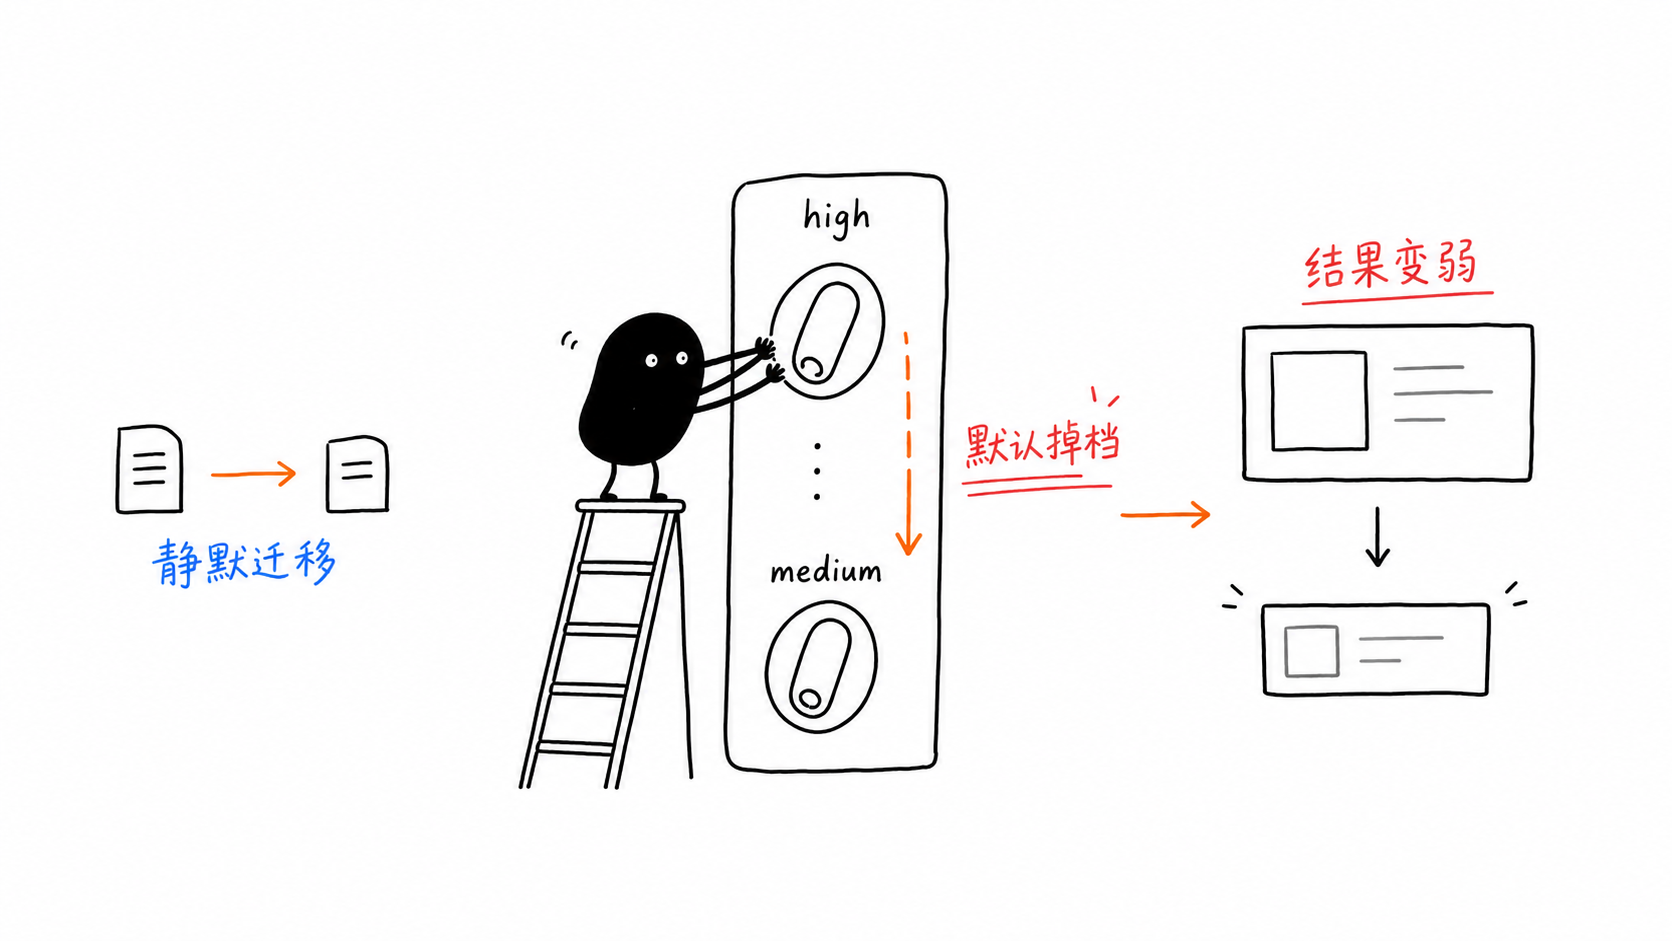
thinking_level 的預設值由 high 降至 medium這很危險,因為完全不會當機。
你把舊程式碼移植過來,請求仍然會回傳,但模型已不再以你原先假設的推理層級運作。
值
作用
何時使用
minimal
最低限度推理
自動完成、分類、單次完成
編碼代理、MCP 工具迴圈、多步驟工作流程
medium
消費者聊天、一般問答
high
最大推理強度
高難度推理、除錯新問題、數學、規劃
response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents=prompt,
)

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
)
第二段程式碼可以執行,但預設值已經不再相同。
from google import genai
import os

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
    config={
        "thinking_config": {
            "thinking_level": "high"  # or "low" for coding agents
        }
    },
)對很多編碼代理工作流程而言,應先由 low 開始,而不是 high。
實際原因很簡單:
更快
更便宜
對工具密集型編碼迴圈而言,往往已經足夠好,或表現相若
問題不在模型的標價,而是在 GitHub Copilot 內部的高級請求乘數。一旦以代理方式使用 Flash,成本結構就會迅速改變。
輕量互動式使用會留在 Copilot 內
重度迴圈及批次式工作流程則透過直接 API 進行
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
架構本身就成為成本控制手段。
Gemini 3.5 Flash 會在多輪對話之間延續內部推理。
這有助提升連貫性,但亦意味這些思考內容可能會持續出現在之後的 token 計算之中。
對長時間代理迴圈而言,這可能會大幅推高 token 用量。
在清晰的階段邊界重設聊天
先總結,再只延續真正重要的內容
對穩定指令及工具定義使用提示快取
持續觀察 thoughts tokens 與 prompt tokens 的比例變化
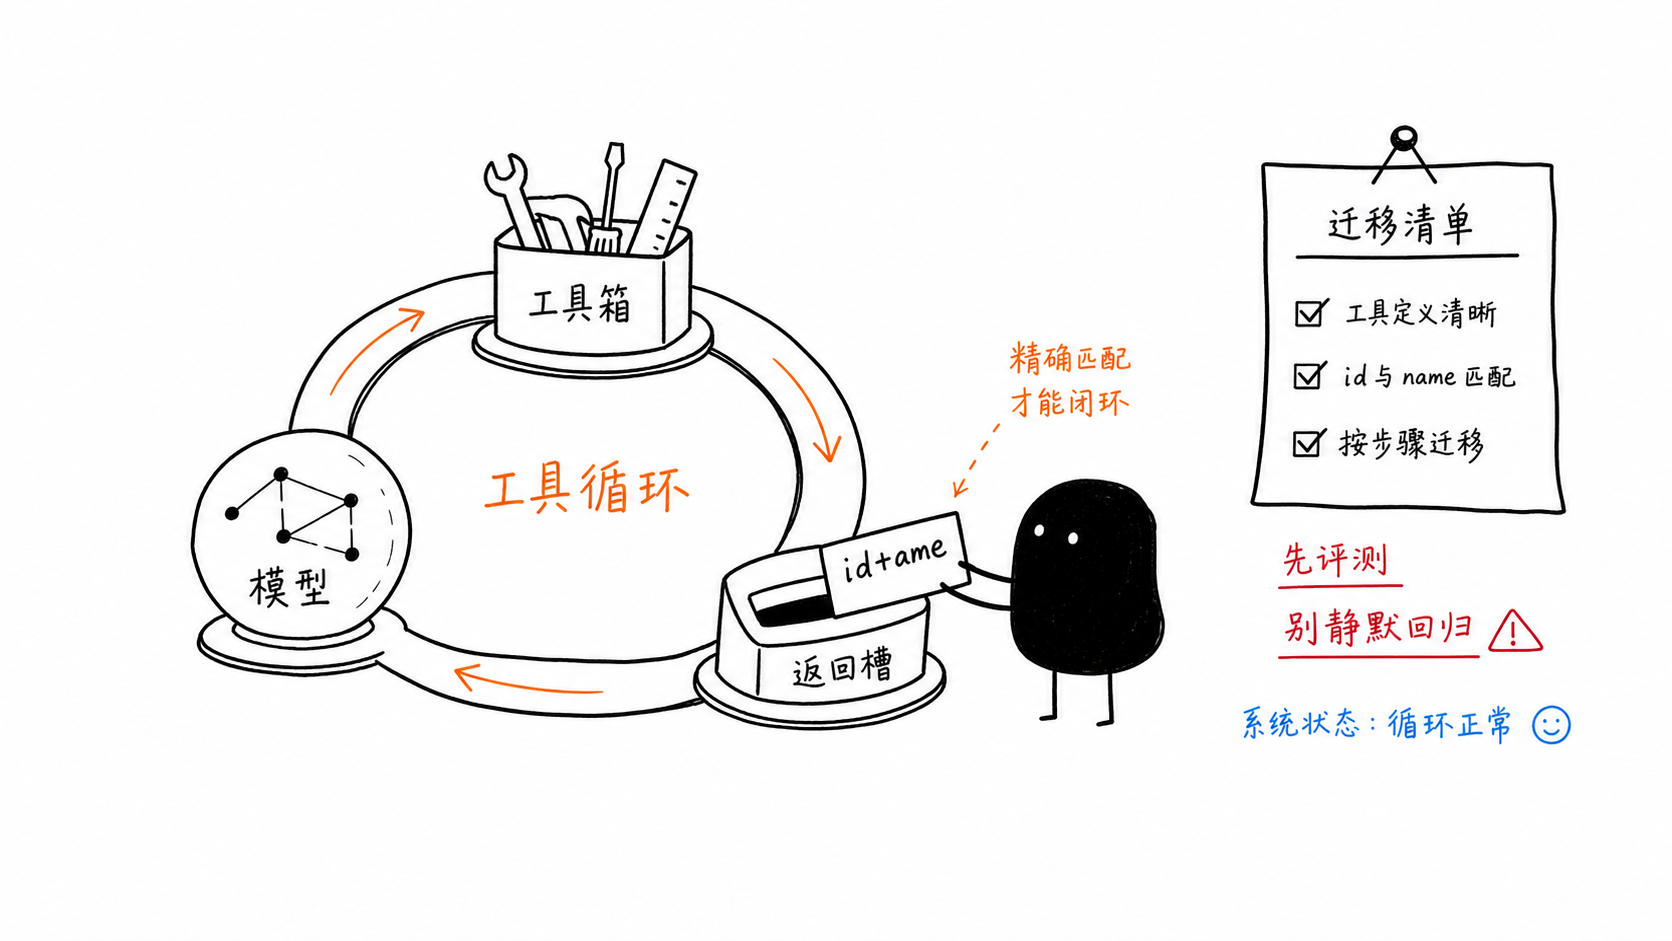
原文文章包含一個非常實用的端對端模式:一個讀取檔案工具、一個抓取 URL 工具、一個標準函式宣告格式,以及一個把工具回應送回模型的迴圈。
import os
import httpx
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

read_file = types.FunctionDeclaration(
    name="read_file",
    description="讀取本機檔案,並以文字形式傳回其內容。",
    parameters={
        "type": "object",
        "properties": {
            "path": {
                "type": "string",
                "description": "檔案的絕對路徑"
            }
        },
        "required": ["path"],
    },
)

fetch_url = types.FunctionDeclaration(
    name="fetch_url",
    description="擷取 URL,並以文字形式傳回回應主體。",
    parameters={
        "type": "object",
        "properties": {
            "url": {
                "type": "string",
                "description": "完整限定的 URL"
            }
        },
        "required": ["url"],
    },
)tools = types.Tool(function_declarations=[read_file, fetch_url])
def execute_tool(call):
if call.name == "read_file":
return Path(call.args["path"]).read_text(encoding="utf-8")
if call.name == "fetch_url":
return httpx.get(call.args["url"], timeout=15).text[:50000]
raise ValueError(f"未知工具:{call.name}")
def run_agent(task: str, max_turns: int = 8):
history = [types.Content(role="user", parts=[types.Part(text=task)])]
for _ in range(max_turns):
response = client.models.generate_content(
model="gemini-3.5-flash",
contents=history,
config=types.GenerateContentConfig(
tools=[tools],
thinking_config=types.ThinkingConfig(thinking_level="low"),
),
)
if not response.function_calls:
return response.text
history.append(response.candidates[0].content)
tool_results = []
for call in response.function_calls:
result = execute_tool(call)
tool_results.append(
types.Part(
function_response=types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": result},
)
)
)
history.append(types.Content(role="tool", parts=tool_results))這條細小但關鍵的遷移規則是:你的函式回應必須同時對應原始呼叫中的 id 和 name。
手動建立工具迴圈對原型開發來說沒問題。但到了正式生產環境,你很快就會發現自己在重建編排、快取、路由、重試,以及可觀測性。
這就是為甚麼更重要的問題不只是「我能否接上這個模型」,而是「有多少 agent 基礎設施將要由我自己承擔?」
如果你正從 gemini-3-flash-preview 遷移到 gemini-3.5-flash,請明確檢查以下項目:
小心替換模型 ID
有意識地設定 thinking_level
移除過時的採樣覆寫設定,除非評估結果證明有需要
id 和 name檢查 response.usage_metadata.thoughts_token_count
對於你仍然依賴但尚未支援的 API,保留 preview 版本
執行遷移前/後評估
比較 Copilot 計費與直接 API 成本
如果你的目標不只是測試提示詞,而是把檔案、程式碼儲存庫、API、文件和 agent 工作流程串連起來,你通常需要的不只是原始模型端點。
在 We0 AI,這個原則更進一步:agent 工作流程只完成了一半工作。其餘部分是透過文件、常見問題、產品頁面、展示內容,以及 SEO/GEO 版面,令產品變得易於理解、可搜尋、可推薦,並可帶來轉換。
呼叫本身很簡短。真正重要的是明確設定 thinking_level,以免遷移時在不知不覺中降低輸出品質。
thinking_level 有哪些值?minimal 適用於非常輕量的任務
low 適用於編碼和 agent 工作流程
medium 作為面向消費者風格的預設值
high 適用於更困難的推理和更深入的規劃
因為計費乘數改變了成本結構。對於大量使用 agent 的情況,這對成本的影響可能比基礎模型價格更大。
這是指模型在多輪對話之間保留內部推理。這有助於提升多輪一致性,但亦會增加 token 成本隨時間上升的機會。
是的,尤其當工具綱要、回應匹配、thinking_level 及 token 預算都經過審慎處理時。
從一句話開始,幾分鐘內拿到完整網站。