For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
Anthropic 已發布 **Claude Haiku 5.5**,這是其迄今速度最快、成本最低的小型模型。

Anthropic 已發布 Claude Haiku 5.5,這是其迄今速度最快、成本最低的小型模型。
該模型於 2026 年 10 月 7 日正式發布,適用於速度、處理量與成本比每次請求都使用最強模型更重要的工作。
Anthropic 將 Haiku 5.5 定位於以下任務:
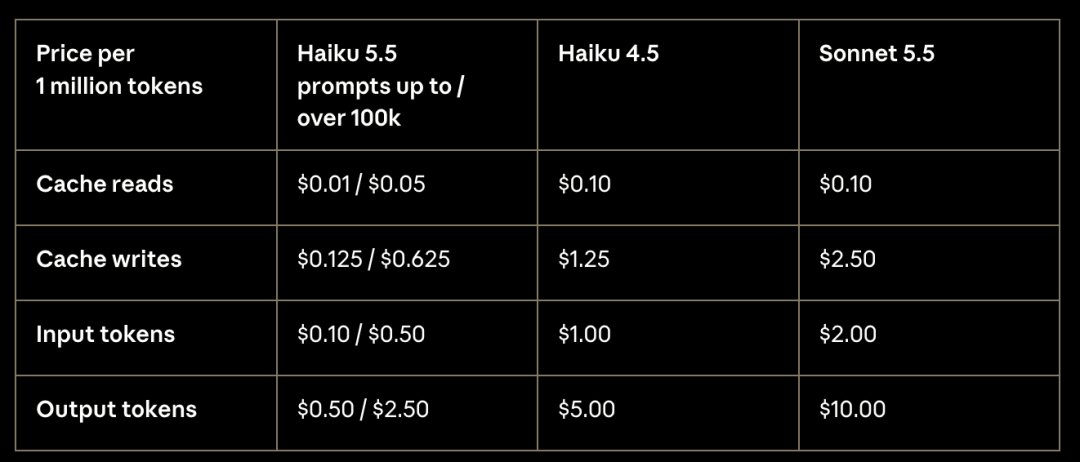
最引人注目的數字是其短提示詞價格:
輸入:
每 100 萬 tokens 0.10 美元

輸出:
每 100 萬 tokens 0.50 美元
適用於不超過 100,000 tokens 的提示詞。
這是 Haiku 4.5 所列輸入與輸出價格的十分之一,也是 Sonnet 5.5 標準輸入與輸出價格的二十分之一。
價格下降並不代表每種實際工作負載都會便宜 90%。
Anthropic 自己的估算更為保守:在計入長上下文定價與新版 tokenizer 後,Anthropic 表示,Haiku 5.5 的平均執行成本比 Haiku 4.5 低約 75%。
更令人意外的是,該模型不只是更便宜。
在 Anthropic 公布的多項評估中,Haiku 5.5 大幅超越 Haiku 4.5,甚至在 Anthropic 公布 GPT-6 Luna 結果的每一項基準測試中,都擊敗了價格相近的 GPT-6 Luna。
但這並不代表 Haiku 5.5 能在困難的程式設計與開放式 Agent 工作中取代 Sonnet 5.5 或 Opus 5.5。
Anthropic 明確建議在這些任務中使用更大型的模型。
更好的理解方式是:Haiku 5.5 是一名高處理量工作者,如今其能力終於足以承擔比早期 Haiku 模型更嚴肅的 Agent 任務。
其定價結構分為兩個層級。
對於不超過 100,000 個輸入 tokens 的提示詞:
| Token 類型 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| 快取讀取 | 每 100 萬 0.01 美元 | 每 100 萬 0.10 美元 | 每 100 萬 0.10 美元 |
| 快取寫入 | 每 100 萬 0.125 美元 | 每 100 萬 1.25 美元 | 每 100 萬 2.50 美元 |
| 輸入 | 每 100 萬 0.10 美元 | 每 100 萬 1.00 美元 | 每 100 萬 2.00 美元 |
| 輸出 | 每 100 萬 0.50 美元 | 每 100 萬 5.00 美元 | 每 100 萬 10.00 美元 |
對於超過 100,000 個輸入 tokens 的提示詞,Haiku 5.5 的價格變為:
快取讀取:
每 100 萬 0.05 美元

快取寫入:
每 100 萬 0.625 美元

輸入:
每 100 萬 0.50 美元

輸出:
每 100 萬 2.50 美元
批次處理可讓輸入與輸出 tokens 享有 50% 折扣。
Anthropic 也表示,先前 Haiku 模型約 90% 的請求都低於 100K 提示詞門檻,這也是較低價格層級對典型高處理量部署如此重要的原因。
短提示詞價格比 Haiku 4.5 低 90%。
但 Anthropic 估算,實際平均降幅約為 75%。
主要有兩個原因。
當提示詞超過 100,000 個輸入 tokens 後,Haiku 5.5 的價格會提高 5 倍。
此時該模型仍比 Haiku 4.5 便宜,但降幅從 90% 變為 50%。
Haiku 5.5 使用 Claude 4.7 及後續模型採用的新 tokenizer。
Anthropic 的遷移指南表示,相同的輸入文字在 Haiku 5.5 上產生的 tokens 約為:
多 30% 的 tokens
實際增加幅度取決於內容。
這會影響:
max_tokens因此,開發者不應取得 Haiku 4.5 的 token 數量後,直接套用 Haiku 5.5 的新 token 價格。
必須使用新模型重新計算文字所對應的 tokens。
對於標準短上下文請求,兩個模型的 token 價格可以直接比較。
OpenAI 目前列出的 GPT-6 Luna 價格為:
輸入:
每 100 萬 0.10 美元

快取輸入:
每 100 萬 0.01 美元

快取寫入:
每 100 萬 0.125 美元

輸出:
每 100 萬 0.50 美元
這些價格與 Haiku 5.5 的短提示詞價格一致。
但兩者的長上下文定價門檻差異很大。
當提示詞超過以下長度時,較高價格層級開始生效:
100,000 個輸入 tokens
之後價格為:
輸入:
每 100 萬 0.50 美元

快取讀取:
每 100 萬 0.05 美元

輸出:
每 100 萬 2.50 美元
OpenAI 的長上下文定價在超過以下長度後開始生效:
272,000 個輸入 tokens
之後價格變為:
輸入:
每 100 萬 0.20 美元

快取輸入:
每 100 萬 0.02 美元

輸出:
每 100 萬 0.75 美元
因此,原文將短上下文與長上下文區分開來是正確的。
對於低於 100K 的提示詞,兩者的標準價格非常接近。
對於非常長的提示詞,Luna 目前具有明顯更低的長上下文價格,而且要到更大的提示詞才會觸發該價格層級。
這可能會實質影響長文件或大型 Agent 歷史記錄的模型路由決策。
Anthropic 利用 Haiku 5.5 發布的機會,降低了另一項重要成本。
Claude Sonnet 5.5 的快取讀取價格從:
每 100 萬 tokens 0.20 美元
降至:
每 100 萬 tokens 0.10 美元
Anthropic 估計,這會讓 Sonnet 5.5 在大多數 Agent 工作負載中的成本降低約 20%,因為在長時間執行的 Agent 中,快取讀取可能占 tokens 的很大比例。
這讓模型家族的層級區分更加清晰:
Haiku 5.5
→ 最便宜、最快,適合最高處理量的工作

Sonnet 5.5
→ 更強,適合定義清楚的工作與程式設計

Opus 5.5
→ 適合最困難的開放式工作與複雜 Agent
基準測試表最清楚地展現了這一代的改進。
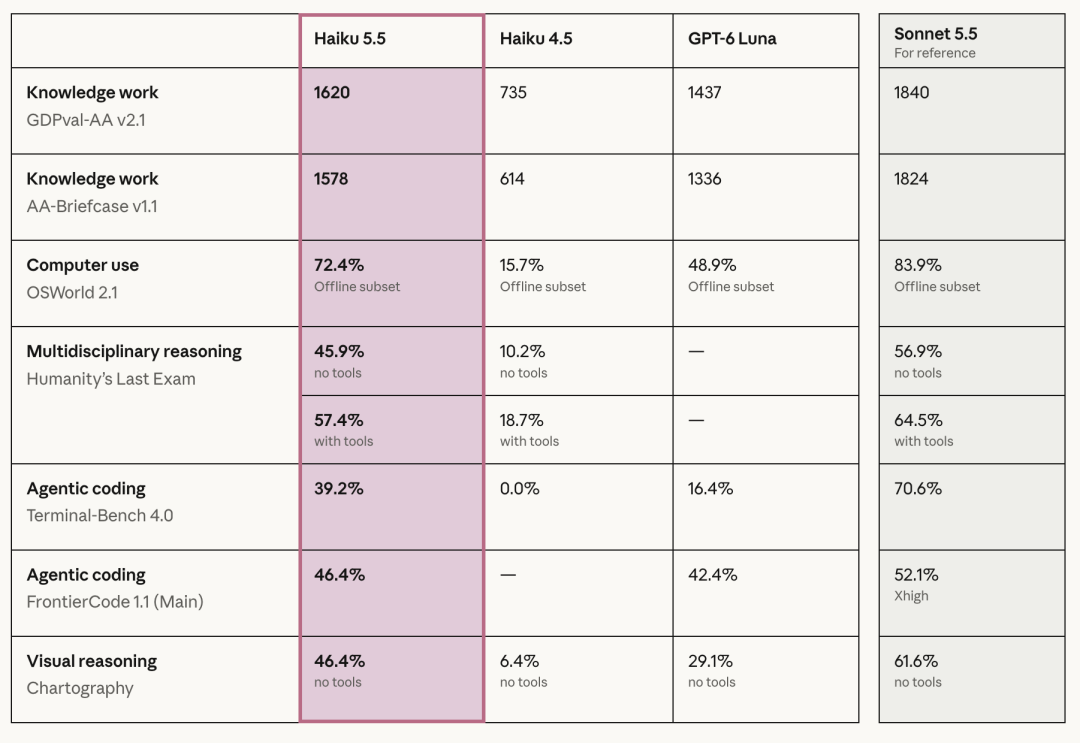
Anthropic 公布的結果如下:
| 基準測試 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 離線 | 72.4% | 15.7% | 48.9% | 83.9% |
| HLE,無工具 | 45.9% | 10.2% | — | 56.9% |
| HLE,使用工具 | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 Main | 46.4% | — | 42.4% | 52.1% Xhigh |
| Chartography | 46.4% | 6.4% | 29.1% | 61.6% |
在 Anthropic 公布的表格中,只要有列出 Luna 分數的項目,Haiku 5.5 都擊敗了 GPT-6 Luna。
考慮到兩個模型的短上下文輸入與輸出價格相同,這是一項值得注意的結果。
不過,這些是 Anthropic 公布的基準測試比較。
不應將其轉化為 Haiku 5.5 在所有工作負載中都優於 Luna 的普遍性結論。
實際生產結果取決於:
世代之間最強的改進出現在 OSWorld 2.1,這是一項對電腦操作 Agent 進行評估的基準測試。
Haiku 4.5 的得分為:
15.7%
Haiku 5.5 達到:
72.4%
Sonnet 5.5 仍然更高,達到:
83.9%
而 GPT-6 Luna 列出的成績為:
48.9%
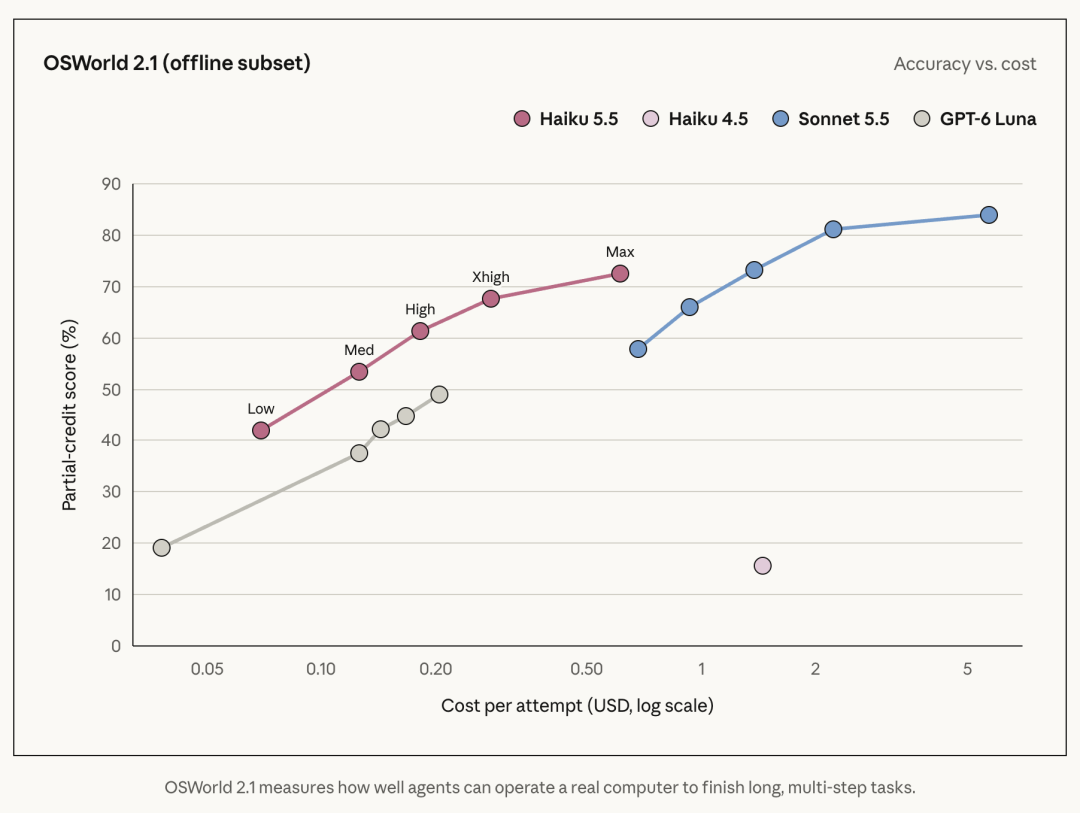
其成本效能曲線尤其值得注意。
Anthropic 的圖表顯示,在該評估中,中等努力程度的 Haiku 配置已能以較低的每次嘗試測量成本,超越圖中 Luna 的最佳結果。
這並不代表兩個模型在能力或價格上完全相同。
但它確實說明了 Anthropic 為何將 Haiku 5.5 定位於瀏覽器操作與其他對延遲敏感的 Agent 任務。
在 GDPval-AA v2.1 中,Haiku 5.5 達到:
1620 Elo
相比之下:
Haiku 4.5:
735

GPT-6 Luna:
1437

Sonnet 5.5:
1840
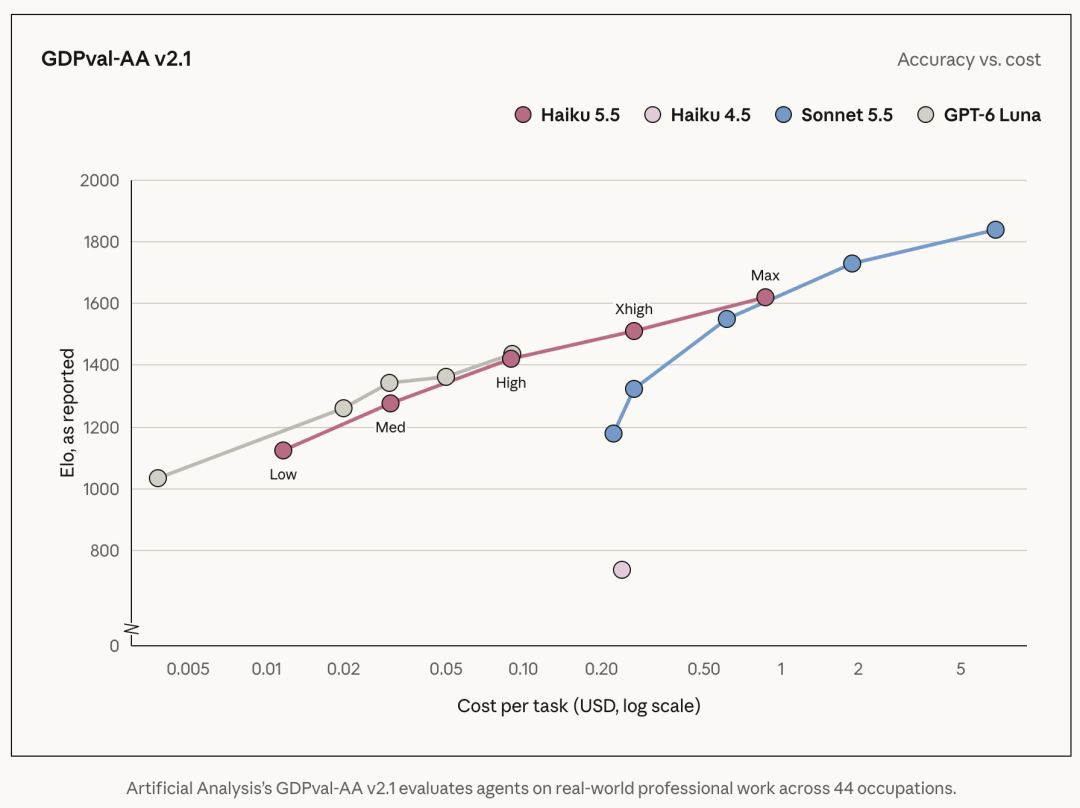
在預設的中等努力程度下,得分低於 Haiku 的 Max 結果,但成本也大幅下降。
這種彈性是 Haiku 家族此前所沒有的。
Claude Haiku 5.5 是首個支援可調整 努力程度設定的 Haiku 類模型。
可用層級包括:
low
medium
high
xhigh
max
Claude API 的預設值為:
medium
這讓開發者可以在推理深度、成本與延遲之間進行權衡。
對於路由或分類任務,low 可能已經足夠。
對於較困難的資訊擷取或 Agent 任務,較高的努力程度可以使用更多計算資源。
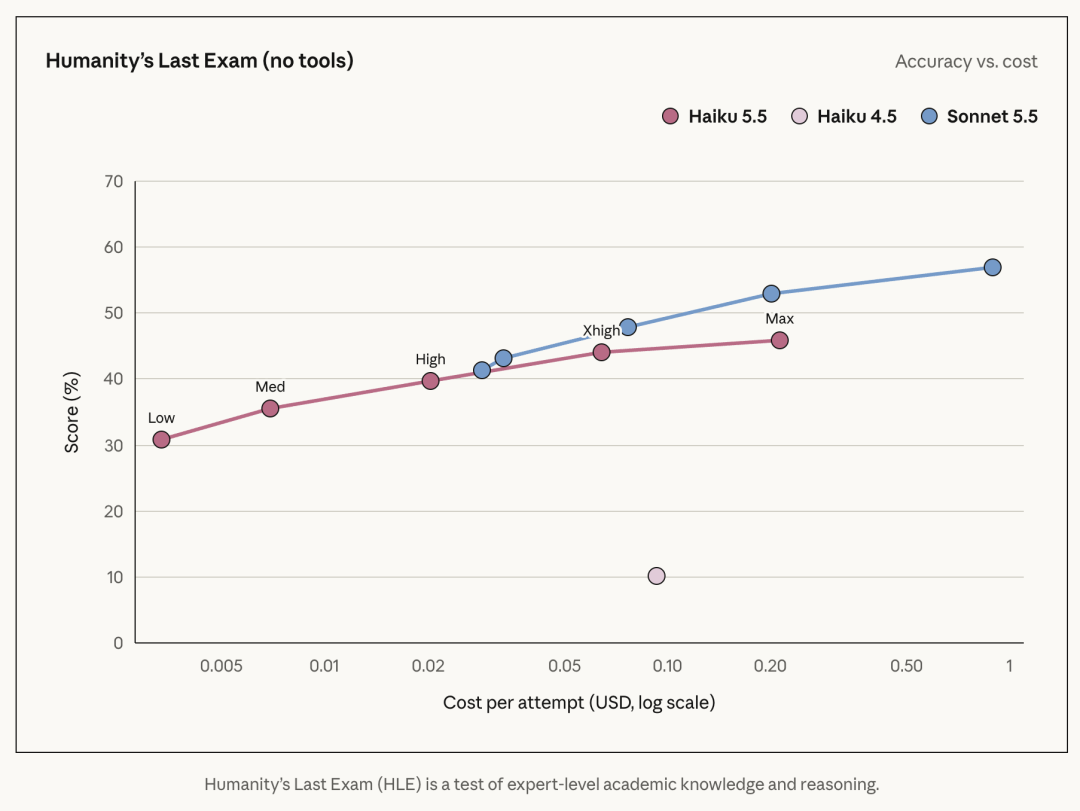
這也解釋了為什麼單一基準測試數字不一定能說明全部情況。
Haiku 5.5 的得分取決於為任務選擇的努力程度。
原文對這一點相當謹慎,而官方資料也支持這個判斷。
在 Terminal-Bench 4.0 中:
Haiku 5.5:
39.2%

GPT-6 Luna:
16.4%

Sonnet 5.5:
70.6%
在 FrontierCode 1.1 Main 中:
Haiku 5.5:
46.4%

GPT-6 Luna:
42.4%

Sonnet 5.5:
52.1%,Xhigh
Haiku 的進步幅度很大,尤其相較於 Terminal-Bench 中 Haiku 4.5 所呈現的 0.0% 結果。
但 Anthropic 明確表示,Sonnet 5.5 與 Opus 5.5 仍然是複雜 Agent 程式設計的更佳選擇。
這讓 Haiku 的角色更加清晰:
Haiku:
執行範圍狹窄的子任務

Sonnet:
複雜且定義清楚的程式設計

Opus:
最困難的規劃與開放式 Agent 工作
Anthropic 建議將 Haiku 5.5 用於以下工作:
Anthropic 稱其為標準速度下最快的 Claude 模型。
只有在 Opus 使用單獨定價的 Fast Mode 時,Haiku 的運行速度才會慢於 Opus。
這使 Haiku 5.5 適合任何延遲能直接轉化為產品價值的場景。
Anthropic 在發布時公布了多項客戶評估。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
這些是客戶回報的測試,不是普遍適用的效能保證。
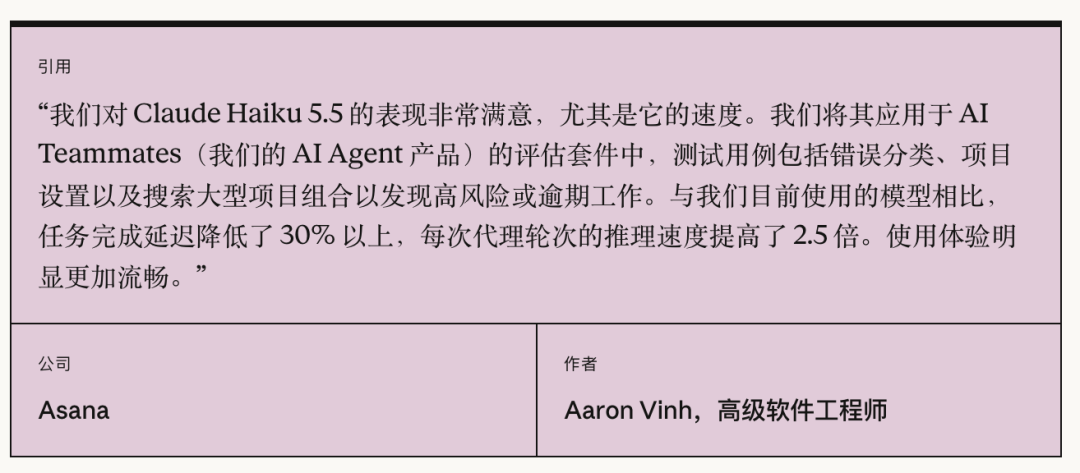
Asana 在其 AI Teammates 測試套件中評估了 Haiku 5.5。
其任務包括:
Asana 表示,與其當時使用的模型相比,任務完成延遲降低超過 30%,每次 Agent 轉向的推理速度最高提升 2.5 倍。
Box 表示,在早期測試中,Haiku 5.5 的得分比 Haiku 4.5 高 11 分,延遲約為其一半。
該公司強調的分析工作負載包括:
AlphaSense 測試了 400 個文件問答查詢。
其回報的評估得分為:
Haiku 5.5:
0.84

Haiku 4.5:
0.76
其重要性在於規模。
AlphaSense 表示,這類「在文件中提問」工作負載在生產環境中每週處理約 800 萬次呼叫,因此成本與延遲的小幅變化在營運上都十分重要。
其中一個最清晰的使用場景,不是取代更大型的模型,而是在大型模型之下工作。
大型模型可以:
理解整體任務
→ 將任務拆分為子問題
→ 分派狹窄範圍的工作
接著由 Haiku 5.5 平行執行這些工作。
這種模式讓系統只在真正重要的地方使用昂貴模型的能力。
Cognition 表示,Haiku 5.5 現已作為副手模型整合到 Devin Fusion 中。
Cognition 表示,在 Opus 5.5 擔任主模型、Haiku 5.5 擔任副手時,FrontierCode 得分達到 66.2,同時降低成本與延遲。
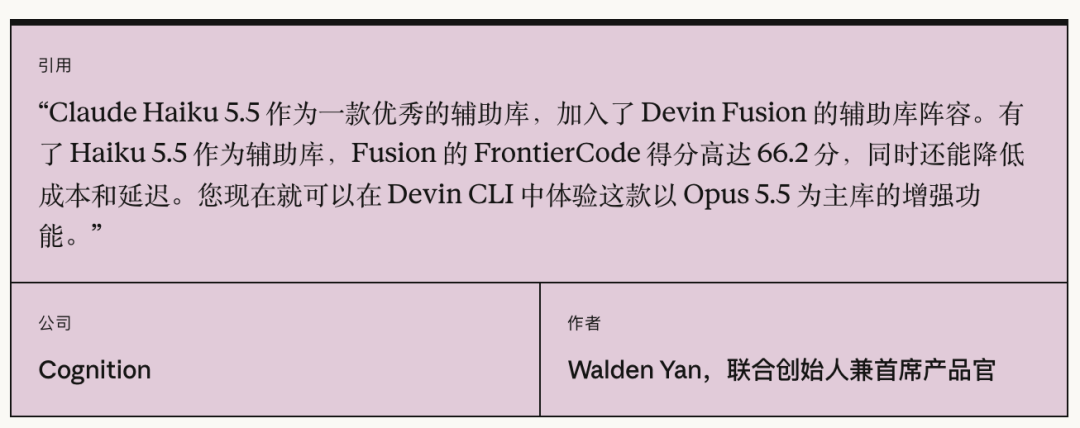
這是階層式模型路由的一個良好例子:
Opus 5.5
→ 規劃
→ 困難決策
→ 整合

Haiku 5.5
→ 平行子任務
→ 檢索
→ 範圍明確的實作
→ 重複性工作
其結果不只是「使用更便宜的模型」。
而是「只在工作需要時使用昂貴模型」。
金融 AI 公司 Rogo 描述了類似模式。
大型模型可以建立簡報,而 Haiku 5.5 子 Agent 搜尋 10-K 申報文件,擷取某一張投影片所需的分部收入數字。
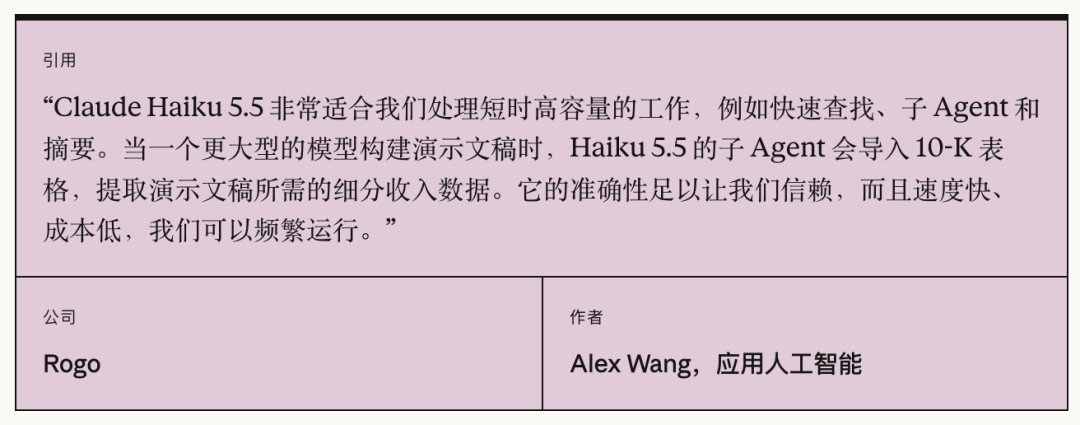
這正是 Haiku 所設計的狹窄、可重複工作:
具體問題
+
已知來源
+
高處理量
+
低延遲要求
原文包含 Anthropic 開發者展示的一項落蛋設計任務。
據報導,單獨工作的 Opus 5.5:
耗時 3 分 37 秒
測試 25 種設計
成本 0.47 美元
當 Opus 使用 10 個 Haiku 5.5 子 Agent 時,原文報告:
58 秒
測試 86 種設計
總成本 0.14 美元
原始 BAAI 圖片在準備期間無法穩定載入,因此本文未重現該圖片。
這個例子應被視為 Anthropic 對特定 Agent 架構的展示,而不是普遍適用的 4 倍速度或成本保證。
其目的在於說明平行化的作用。
當任務能夠清楚拆解時,許多快速的小型 Agent 可以同時探索更多可能性,而不是由一個昂貴模型按順序工作。
Anthropic 目前的模型文件列出以下資訊:
| 規格 | Claude Haiku 5.5 |
|---|---|
| 模型 ID | claude-haiku-5-5 |
| 上下文視窗 | 1,000,000 tokens |
| 最大輸出 | 128,000 tokens |
| 批次 API 最大輸出,Beta | 300,000 tokens |
| 輸入 | 文字、圖片 |
| 輸出 | 文字 |
| 思考 | 自適應 |
| 預設努力程度 | medium |
| 可靠知識截止日期 | 2026 年 6 月 |
| 發布日期 | 2026 年 10 月 7 日 |
1M-token 上下文視窗是預設配置。
僅使用完整上下文視窗不需要特殊的 Beta 標頭。
這是原文中最重要的實務部分之一。
Anthropic 的官方遷移指南確認了數項破壞性或行為變更。
對於 Claude API:
claude-haiku-4-5
→
claude-haiku-5-5
Haiku 5.5 的 ID 是固定的,不使用日期後綴。
使用新版 tokenizer 後,相同文字約增加 30% 的 tokens。
開發者應重新計算:
max_tokensHaiku 4.5 可以使用:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5 則改用自適應思考。
如果請求仍傳送舊版手動 budget_tokens 配置,會返回 400 錯誤。
開發者應使用自適應思考,並透過 effort 參數控制深度。
Anthropic 建議在 Haiku 5.5 請求中省略:
temperature
top_p
top_k
非預設值可能會返回 400 錯誤。
應改用提示詞與努力程度來控制行為。
Haiku 5.5 不支援舊版模式,即最後一則訊息是模型接續完成的 Assistant 回合。
對於結構化格式,Anthropic 建議改用結構化輸出或工具結構描述。
對於 Claude API 與 Google Cloud 電腦操作整合,遷移指南表示應改用:
computer_toolset_20260801
目前的工具組將以下操作作為單一電腦工具組的成員工具:
Anthropic 建議為電腦操作環境採取嚴格隔離與存取控制。
應用程式應將以下狀態作為明確狀態處理:
refusal
model_context_window_exceeded
安全拒答與一般可重試的基礎設施故障並不相同。
Anthropic 的 Haiku 5.5 遷移指南表示,新模型不支援 Priority Tier。
仍持有 Haiku 4.5 Priority Tier 承諾的團隊應另行規劃容量。
Anthropic 提供了內建的 Claude API 遷移技能。
在 Claude Code 中,原文的指令有效:
/claude-api migrate this project to claude-haiku-5-5
官方遷移指南表示,該技能可以:
在編輯檔案前,它會要求使用者確認遷移範圍。
對於 API 呼叫分散在多個檔案中的大型程式碼庫,這項功能相當實用。
Anthropic 表示,其 Python 與 TypeScript SDK 現已包含以下功能的 Beta 類別:
目前的電腦操作介面使用:
computer_toolset_20260801
在支援的平台上,該工具組提供 17 個成員操作,例如:
screenshot
left_click
type
scroll
zoom
對於僅限網頁的工作流程,Anthropic 建議在適當情況下使用瀏覽器操作工具,而不是暴露完整的桌面環境。
這一點很重要,因為 Haiku 的速度與低價格組合,使其特別適合重複性的瀏覽器與桌面 Agent 互動。
Anthropic 表示,Haiku 5.5 可透過以下管道使用:
原文也指出,Cursor 與 OpenRouter 等第三方平台同樣提供該模型。
這些是外部整合服務,可能有各自的定價、速率限制與模型路由行為。
對於直接使用 Anthropic 進行開發,官方模型 ID 為:
claude-haiku-5-5
Claude Haiku 5.5 是 Anthropic Claude 5.5 家族中速度最快、成本最低的小型模型。它專為高處理量、對延遲敏感的工作而設計,例如摘要、分類、路由、資訊擷取、瀏覽器操作與子 Agent 任務。
對於不超過 100K tokens 的提示詞,輸入價格為每百萬 tokens 0.10 美元,輸出價格為每百萬 tokens 0.50 美元。超過 100K 的提示詞使用更高價格,即每百萬 tokens 輸入 0.50 美元、輸出 2.50 美元。
短提示詞的 token 價格低 90%。Anthropic 估計,實際工作負載的平均成本更接近降低 75%,因為超過 100K 的請求只有 50% 的價格降幅,而且新版 tokenizer 會讓相同文字產生約 30% 更多 tokens。
在短上下文中,兩者的標準輸入、快取輸入與輸出價格相同。在長上下文中,GPT-6 Luna 目前更具價格優勢,因為其較高價格層級要到超過 272K tokens 才會開始,而其長上下文價格也較低。
有。Anthropic 列出的上下文視窗為 1,000,000 tokens,普通請求最多可輸出 128K tokens。Beta Message Batches 選項可以支援最多 300K 輸出 tokens。
它比 Haiku 4.5 強大得多,並在 Anthropic 公布的 Terminal-Bench 與 FrontierCode 結果中擊敗 GPT-6 Luna。但 Anthropic 仍建議對複雜的 Agent 程式設計使用 Sonnet 5.5 或 Opus 5.5。
主要變化包括新的模型 ID、相同文字約增加 30% 的 token 數量、以自適應思考取代 budget_tokens、移除舊版採樣設定、不再支援 Assistant 預填內容、更新電腦操作工具,以及新的停止原因。
Claude API 的模型 ID 是:
claude-haiku-5-5
Anthropic 也為 Amazon Bedrock、Google Cloud、Microsoft Foundry 與 AWS 上的 Claude Platform 記錄了平台特定識別碼。
/claude-api migrate 工作流程。computer_toolset_20260801 與桌面 Agent 整合的官方指南。computer_toolset_20260801 介面與安全指南文件。Claude Haiku 5.5 是一次幅度遠超其 Claude 價格階梯底部定位的重大升級。Anthropic 將短提示詞價格降至每百萬輸入 tokens 0.10 美元、每百萬輸出 tokens 0.50 美元,同時將模型升級至 1M 上下文視窗、自適應思考,以及大幅增強的電腦操作、程式設計、知識工作與推理效能。
該模型的角色仍然清晰。Sonnet 5.5 與 Opus 5.5 仍然是困難 Agent 程式設計與開放式工作的更佳選擇,而 Haiku 5.5 則針對快速、狹窄、可重複的工作進行最佳化,這些工作可以大規模執行,也可以交由更大型的主模型分派。
從 Haiku 4.5 遷移的開發者不應只更換模型 ID。新版 tokenizer、自適應思考、採樣限制、預填內容變更、電腦操作工具組與長上下文定價門檻,都會影響既有整合。
Haiku 5.5 最具吸引力的地方,不是作為所有大型模型的廉價替代品,而是作為快速執行層,讓高處理量與多 Agent 系統的成本大幅降低。
從一句話開始,幾分鐘內拿到完整網站。



