For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize 宣布,Gemini 4 Argon 在 ARC-AGI-3 上取得**經驗證的 97.5% 成績**。據主辦方表示,Google DeepMind 因此成為第二家在該基準測試中超過 95% 的前沿 AI 實驗室。
ARC Prize 宣布,Gemini 4 Argon 在 ARC-AGI-3 上取得經驗證的 97.5% 成績。據主辦方表示,Google DeepMind 因此成為第二家在該基準測試中超過 95% 的前沿 AI 實驗室。
這項結果也伴隨一項同樣重要的比較:同一模型系列使用標準測試框架(Standard harness)時,得分為 49.8%;使用供應商適配器(Provider Adapter)時則為 97.5%。據報告,兩者的評估成本分別約為 5,800 美元和 4,800 美元。
這些是特定配置系統的測試結果。在根據這個醒目的數字下結論之前,必須先了解基準測試、推理程度、測試框架以及未完成的測試執行情況。
ARC Prize 的公告列出以下數據:
| 基準測試與設定 | 報告成績 | 報告評估成本 |
|---|---|---|
| ARC-AGI-1,最佳報告設定 | 98.5% | 每項任務約 0.16 美元 |
| ARC-AGI-2,最佳報告設定 | 91.3% | 每項任務約 0.32 美元 |
| ARC-AGI-3,供應商適配器、低推理程度 | 97.5% | 整次評估約 4,800 美元 |
| ARC-AGI-3,標準框架、低推理程度 | 49.8% | 整次評估約 5,800 美元 |
各項成本的計算單位不同。 ARC-AGI-1 和 ARC-AGI-2 的金額是每項任務的成本;ARC-AGI-3 的金額則指整次評估執行的成本。若不說明這項差異,就不應把它們放在同一個成本尺度上比較。
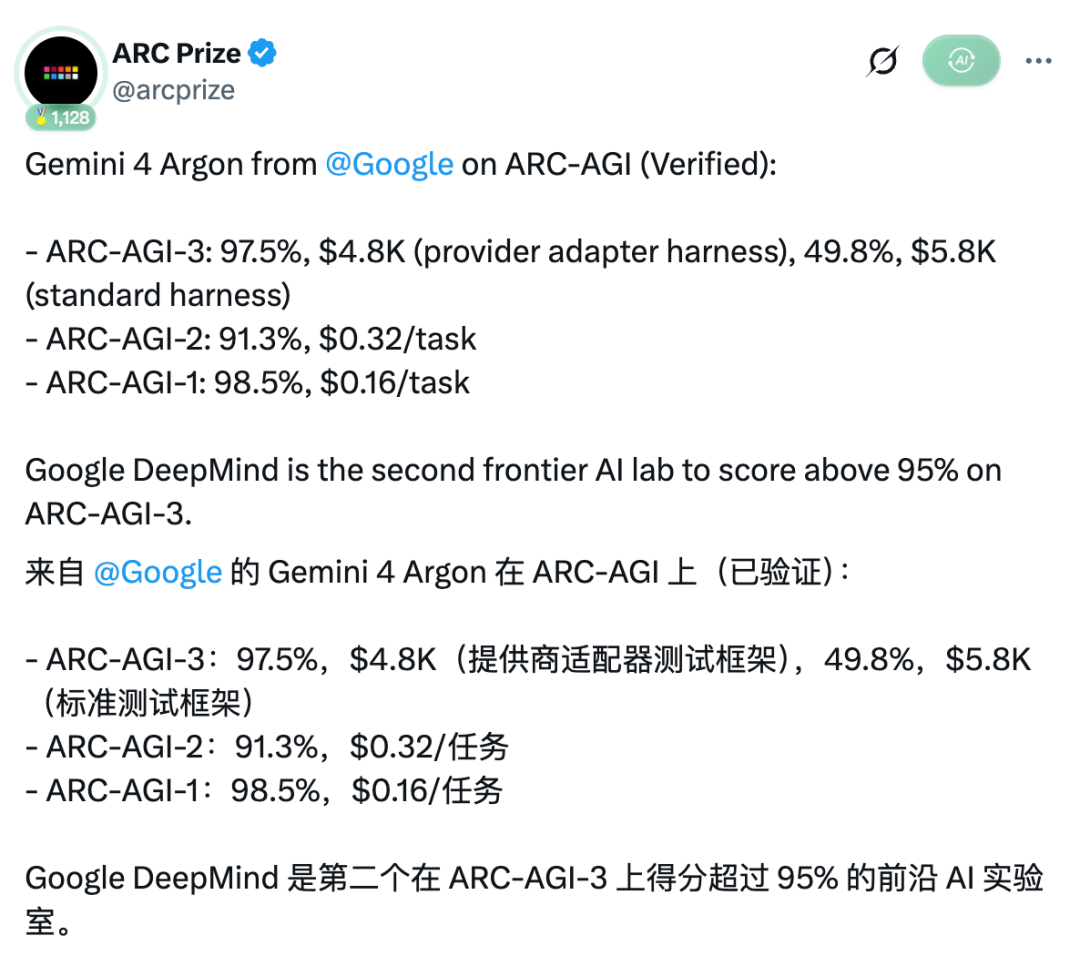
此圖重現來源報告中 ARC Prize 公布經驗證成績的公告。
即時排行榜列出的 ARC-AGI-1 和 ARC-AGI-2 最佳設定成本更為精確,分別是每項任務 0.162 美元和 0.325 美元。排行榜列出的 ARC-AGI-2 成績為 91.3%,與公告一致,但同一結果頁面的說明段落則寫作 91.2%。本文保留公告及排行榜所列的數值,同時註明這項差異。
ARC-AGI-3 與前兩代基準測試不同。它不再要求模型根據靜態範例推斷輸出網格,而是讓代理在陌生的互動環境中探索、了解行動方式,並在沒有自然語言指示解釋遊戲規則的情況下學會達成目標。
ARC Prize 表示,這項測試衡量的是技能習得效率、適應能力,以及隨時間進行規劃的能力。因此,基準測試的分數並不單純等於「贏得遊戲的百分比」。基準測試的說明指出,達到 100% 分數代表以不遜於人類參考基準的效率完成遊戲。
來源追蹤了 ARC-AGI-3 在 3 月推出前後,前沿模型的成績仍低於 1%,到同年稍後則接近滿分的變化。報告特別提到 OpenAI 先前的 GPT-6 Astra 成績,接著是 Gemini 跨越 95% 的表現。
這代表模型在這項評估中的表現有了大幅進展,但不代表主辦方測試了所有可能的推理形式,也不代表已證明任一系統都能像人一樣學會任何新任務。
報告也指出,模型在 25 款公開遊戲中展現出很高的行動效率:比人類基準少使用 62% 的行動次數、在三款遊戲中達到或超越速通紀錄,並在六款遊戲中與速通紀錄的差距不超過 10%。這些特定比較是來源對公開測試集的觀察,不應推廣到全部 55 項評估任務或任意遊戲。
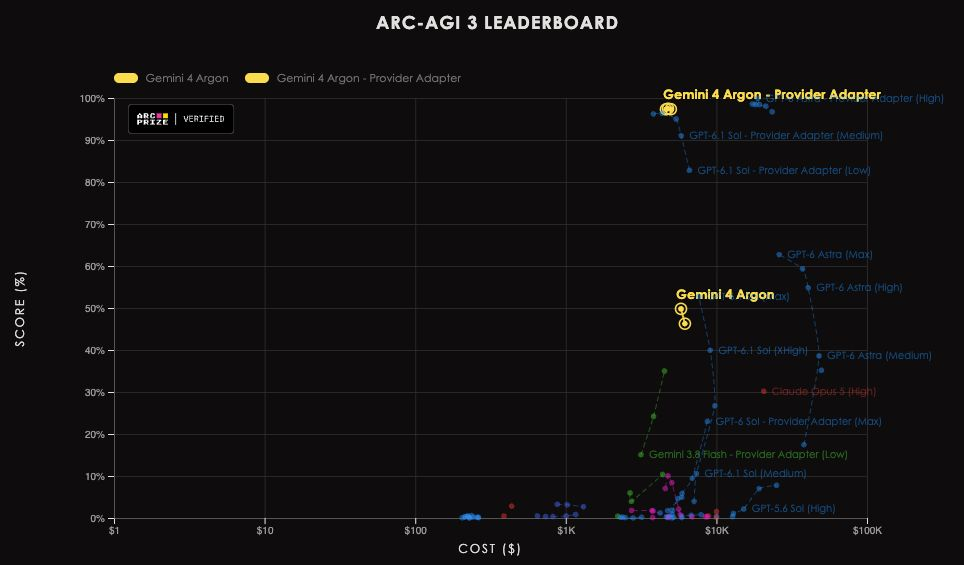
此圖保留自報告中的排行榜截圖;即時結果頁提供目前的配置細節。
代理測試框架會控制模型周遭的互動方式,例如如何提供觀察結果、如何傳送動作、保留哪些上下文,以及對話變長時如何處理。
ARC Prize 對兩種測試條件分別作出以下定義:
Gemini 4 Argon 的即時結果如下:
| 推理程度 | 標準測試框架 | 供應商適配器測試框架 |
|---|---|---|
| 低 | 49.8% | 97.5% |
| 中 | 46.3% | 97.3% |
| 高 | 沒有完整的已報告比較數據點 | 97.3% |
低推理程度下的分數差距為 47.7 個百分點。這顯示所配置的互動系統會大幅影響測得的結果,但無法據此單獨確認某一項因素的因果作用。除了測試框架標籤之外,也必須考慮上下文處理、執行條件、API 可靠性和其他設定。
ARC Prize 特別指出,API 問題導致標準測試框架的評估無法完整完成。低、中、高推理程度的測試分別完成了 55 項任務中的 42、46 和 19 項。報告中的整體分數包含全部 55 項任務,並保留未完成測試執行所取得的部分分數;這些完成數量不代表模型必然完整解決了 42 或 46 款遊戲。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
未完成的高推理程度標準框架數據點未納入圖表。因此,在這次評估中,提高推理程度並未產生一組完整且可直接比較的標準框架結果。
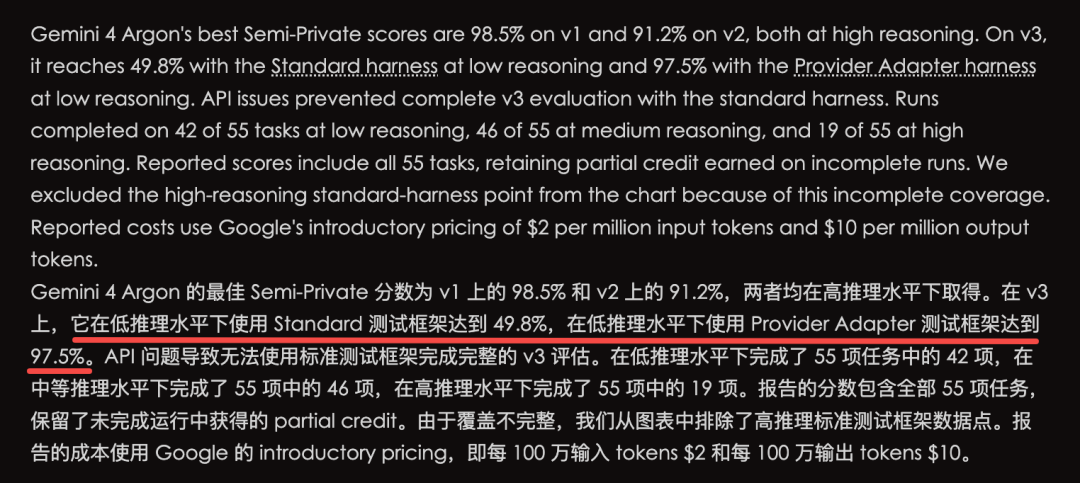
此圖重現來源報告中的配置與測試涵蓋範圍註記;如需了解最新情況,請參閱即時結果頁。
據 ARC Prize 說明,成本估算採用 Google 的 API 入門價格:每百萬輸入 token 2 美元、每百萬輸出 token 10 美元。這不是解決新的真實世界任務時固定不變的價格,也可能隨價格或配置而改變。
來源報告提出的主要實用啟示是合理的:只有模型名稱和單一百分比,無法完整呈現受評估的系統。即使使用相同模型名稱,只要上下文管理介面不同,兩個分數回答的也可能是不同問題。
ARC Prize 的政策明確指出,分別報告兩種測試框架的結果,是因為它們各自對應不同的評估問題。這些經驗證結果由主辦方依據公開方法執行;相較於未經佐證的供應商簡報,它們是更有力的證據,但適用範圍仍受限於測試的任務分布和條件。
比較這些結果時,建議依序確認基準測試版本、確切的模型配置、推理程度、測試框架、任務涵蓋範圍、評分規則和成本單位。如此更容易分辨是真正的能力提升,還是把不同實驗的結果放在一起比較。
接近滿分的表現也引出一個研究問題:測試還剩下多少可供模型進步的空間?但這不會讓剩餘限制消失,也不代表「AGI 基準測試」這個說法就能證明通用人工智慧已經實現。
ARC Prize 報告指出,Gemini 4 Argon 在低推理程度下使用供應商適配器測試框架,取得 97.5%。在不同測試條件下,低推理程度的標準框架結果為 49.8%,而且部分測試執行未能完成。
不是。ARC-AGI-3 使用以效率為基礎的評分系統,並可提供部分分數。不能直接把分數換算成完整完成的遊戲數量。
標準測試框架是精簡且不依賴特定供應商的介面,會保留模型自行選擇的筆記。供應商適配器則可使用供應商專屬的上下文管理功能,包括保留推理狀態和精簡對話內容。
公告指出,低推理程度的供應商適配器測試成本約為 4,800 美元,標準測試框架則約為 5,800 美元。ARC Prize 表示,這些估算採用 token 入門價格;它們是整次評估的總成本,不是每項任務的價格。
ARC Prize 將結果標示為已驗證,並公布測試政策及按模型分類的結果頁面。本文已查閱這些資料,但並未重新執行評估,也未獨立重現這些分數。
沒有任何單一基準測試能證明這一點。這項結果顯示 Gemini 4 Argon 在所述系統配置下,於 ARC-AGI-3 表現出色;至於在該設定之外的可靠性和泛化能力,仍需要更多證據。
Gemini 4 Argon 經驗證的 ARC-AGI 成績顯示,它在靜態與互動式測試中都有出色表現。ARC-AGI-3 的 97.5% headline 成績,來自特定的低推理程度供應商適配器配置;據報告,整次評估成本約為 4,800 美元。
標準框架的結果、未完成的測試執行,以及上下文管理上的差異,都是解讀這項比較時不可忽略的要點。應一併檢視模型、測試框架與評估條件;單看百分比並不能證明通用人工智慧已經實現。
從一句話開始,幾分鐘內拿到完整網站。



