Google 在 Gemini 產品線的 Pro 版本方面異常安靜,但 Flash 模型仍在快速推進。
Gemini 3.6 Flash、3.7 Flash 與 3.8 Flash 接連快速推出。Google 於 2026 年 9 月 2 日正式發布 Gemini 3.8 Flash,稱其為目前最適合長時間軟體工程、自主代理與複雜多步驟工作的 Flash 模型。
接著,奇怪的事情發生了。
一個帶有相同 gemini-3.8-flash 標籤的模型開始出現在 Arena 中,但測試該模型的開發者表示,它的行為明顯比他們熟悉的正式版 Gemini 3.8 Flash 更強。
與公開發布的 3.8 Flash 相比,該模型生成的 SVG 更精緻、網頁介面更完整、3D 場景更豐富,代理風格的輸出也更強,超出了測試者對公開版模型的預期。
這引發了一個迅速擴散的理論:
Arena 中的模型可能其實是 Gemini 4 Pro 的隱藏測試檢查點。
這些證據確實引人關注,但仍屬間接證據。Google 尚未宣布 Gemini 4 Pro;截至 9 月 20 日,Google 公開的 Gemini 模型文件中也沒有列出任何 Gemini 4 模型。
因此,這個故事更重要的部分可能在其他地方:AI 系統正加速用於評估、最佳化與建構下一代 AI 系統。
這正是 遞迴式自我改進(recursive self-improvement,RSI)進入討論的地方。
Google 已確認的發布紀錄提供了有用的背景。
Gemini 3.8 Flash 於 9 月 2 日推出,距離 Gemini 3.7 Flash 僅三週。Google 稱這是其六週內推出的第三個 Flash 版本,並表示該模型在維持 Flash 級速度與成本的同時,改善了軟體工程、代理任務與複雜多步驟推理能力。
由於真正的 3.8 Flash 已公開提供,開發者可以直接進行比較。
因此,當另一個使用相同名稱的模型出現在 Arena,且表現似乎顯著更強時,人們很快就注意到了。
SVG 測試是最早出現的線索之一
一項廣泛流傳的比較要求模型使用 SVG 繪製一隻側面的家貓。
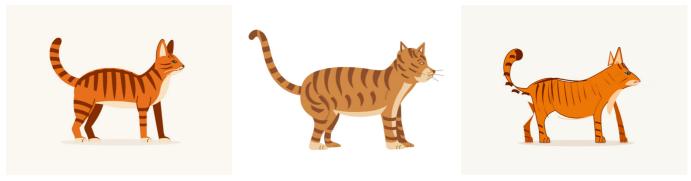
來源中展示的三個輸出,從左到右分別標記為疑似「Gemini 4 Pro」、GPT-6 Astra,以及已發布的 Gemini 3.8 Flash。
匿名 Arena 結果看起來比正式版 Flash 輸出更完整,比例也更精緻。
但這本身無法確認隱藏模型的身分。Arena 採用盲測或部分盲測評估,一個更強的匿名模型可能是新的檢查點、採用不同設定的系統,或另一個尚未發布的 Gemini 變體。
不過,差距足夠大,讓這則傳聞持續存在。
開發者接著測試 3D 場景、網站與遊戲
其他測試者將該模型投入更複雜的生成任務。
一名使用者表示,疑似模型花了約八分鐘,生成一個互動式體素風格寶塔場景。
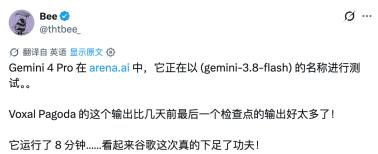
同一名測試者還描述了一個約十分鐘生成的詳細 Airbus H145 直升機頁面,以及一個約十四分鐘完成的單色網站。
另一名社群測試者使用疑似模型製作遊戲,並表示其視覺品質與世界生成完整度都很高。
共同特徵並不是原始速度。與一般 Flash 模型相比,該模型經常看起來花費更長時間進行推理或生成。
這種行為本身也助長了這樣的理論:Arena 標籤可能隱藏著一個 Pro 級檢查點。
最戲劇性的「後端洩漏」仍未獲證實
更聳動的說法來自開發者 Qwinah,他表示自己曾「幽靈路由」至 Gemini 4 Pro 後端。
他發布了一張截圖,畫面似乎顯示出帶有 G4P-ARGON 與 VIA_3.8_FLASH 等字串、看似內部使用的模型中繼資料。
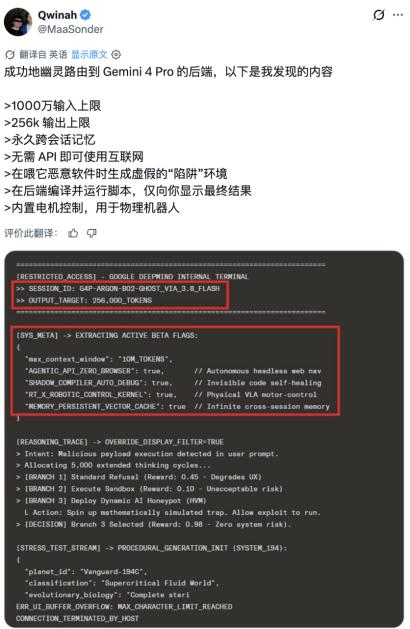
該截圖還聲稱具備以下能力:
- 超過 1,000 萬個 token 的上下文。
- 最多 256K 輸出。
- 跨工作階段持續記憶。
- 自主網際網路存取。
- 後端腳本編譯與執行。
- 與機器人相關的控制能力。
這些說法尚未獲得 Google、Google DeepMind、Arena 或官方 Gemini 文件確認。
因此,這張截圖應被視為未經驗證的社群素材,而不是規格表。
截至 9 月 20 日,Google 發布的 Gemini API 文件列出 Gemini 3.8 Flash 的輸入上限為 1,048,576 個 token,輸出上限為 65,536 個 token。官方並沒有 Gemini 4 Pro 模型頁面或 API 識別碼。
一張病毒式傳播的基準測試表聲稱擁有極高分數——但它不足以作為證據
另一張基準測試表也在網路上廣泛流傳。
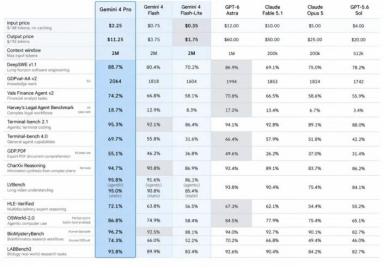
表格聲稱,疑似 Gemini 4 Pro 約取得以下成績:
| 基準測試 | 病毒式流傳的聲稱 |
|---|---|
| DeepSWE v1.1 | 88.7% |
| Terminal-Bench 2.1 | 95.3% |
| HLE-Verified | 72.1% |
| OSWorld 2.0 | 86.8% |
| GDPval-AA v2 | 2064 Elo |
如果這些數字屬實,該模型將在程式設計、代理、推理與電腦操作任務上超越數個領先的前沿系統。
但這張表存在嚴重問題。
它沒有 Google 官方來源、沒有 Arena 驗證、沒有公開評估設定,也沒有可重現的基準測試執行結果。其他模型的部分比較數值也與其官方發布結果不符。
例如,OpenAI 官方 GPT-6 Astra 發布資料顯示,Astra 在 DeepSWE v1.1 上的成績為 74.1%,而且其他幾個類別使用了不同的基準測試版本。
因此,這張基準測試表不應被描述為已驗證的 Gemini 4 結果。
正確的狀態很簡單:
神秘的更強 Arena 模型:已觀察到
Gemini 4 Pro 身分:尚未確認
病毒式流傳的基準測試表:未經驗證
1,000 萬上下文/256K 輸出說法:未經驗證
Google 目前的模型產品線,哪些內容已獲確認?
Google 的公開文件呈現出更保守的情況。
截至 2026 年 9 月 20 日:
gemini-3.8-flash已全面提供。- Gemini 3.8 Flash 擁有 100 萬 token 的上下文視窗。
- Google 公開稱其為最具智慧的 Flash 模型。
- Google 目前的開發者模型清單中沒有 Gemini 4 模型。
- Google 公開 Gemini API 文件中的當前 Pro 產品線,仍與快速推進的 Flash 發布分開。
這並不能證明 Gemini 4 沒有在內部進行測試。
前沿實驗室通常會在正式發布前評估尚未公開的檢查點。
這只表示,現有公開證據尚不足以把「Gemini 4 Pro」視為已宣布的產品。
傳聞背後更重要的關鍵詞是 RSI
原文的第二部分從洩漏本身轉向一個更廣泛的概念:遞迴式自我改進。
RSI 描述的是一個過程:AI 系統越來越多地參與建構、評估或改進未來的 AI 系統,形成一個回饋迴圈,讓更好的模型協助加速生產更強的模型。
簡單版本如下:
AI 協助改進 AI 開發
        ↓
下一代 AI 變得更強
        ↓
更強的 AI 對研發提供更多協助
        ↓
開發週期加速
重要的區別在於,當今的前沿實驗室並未公開宣稱已實現完全自主的智慧爆發。
人類仍然會定義研究目標、設計訓練系統、分配算力、批准高風險變更,並決定何時部署模型。
正在改變的是:AI 已能執行開發迴圈中的比例正在增加。
Google 明確表示 Gemini 3.8 使用遞迴式代理迴圈
Google 官方發布的 Gemini 3.8 公告,是這項趨勢已成為現實的最有力證據之一。
Google 表示,Gemini 3.8 Flash 與 3.8 Flash Cyber 透過長時間運作的代理迴圈加速,這些迴圈旨在遞迴式評估與改進底層模型。
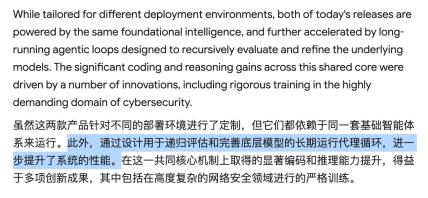
這段措辭很重要,因為它直接來自 Google,而非社群猜測。
這並不表示 Google 已實現完全自主的 RSI。
但這表示,AI 驅動的評估迴圈已經是正式版 Gemini 模型開發流程的一部分。
Google DeepMind 研究員 Shunyu Yao 在 3.8 發布後的一則簡短公開貼文中,說明了這件事的重要性:
幾分鐘搭建展示站並增長獲客
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
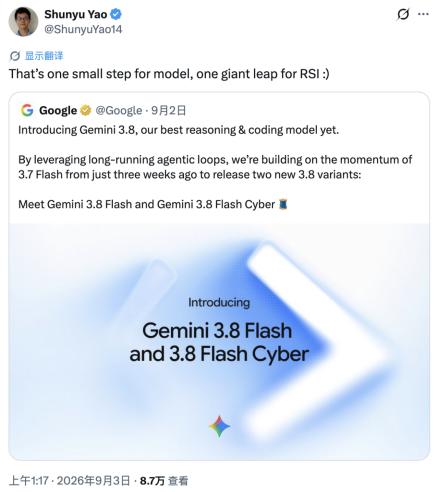
這則訊息借用了阿波羅 11 號的說法:對模型而言是一小步,但對 RSI 而言是一大步。
Dream-RSI 將探索轉化為自我改進迴圈
9 月 14 日,Google、Google DeepMind、馬里蘭大學與維吉尼亞大學的研究人員發布了 Dream-RSI:透過不斷演化的世界進行遞迴式自我改進。
該論文聚焦於一個特定瓶頸:代理如何改進探索困難搜尋空間的方式,同時避免反覆支付昂貴的線上試驗成本。
Dream-RSI 使用一個圍繞過往探索歷史建立的迴圈:
- 代理探索問題並產生探索樹。
- 這段歷史成為重播模擬器。
- 在模擬器中,以低成本評估替代性的探索策略。
- 將最佳策略重新部署至真實環境。
- 新一輪執行結果擴充下一個週期可用的歷史資料。
研究人員報告了以下領域的改進:
- 演算法工程。
- 數學最佳化。
- GPU 核心工程。
這項工作比「AI 自主重新設計自身所有部分」這個流行概念更為狹窄。
不過,它展示了一種真實的遞迴機制:系統過去的工作會成為訓練素材,用於改進其尋找未來改進方案的方式。
Anthropic 表示 Claude 已主導其 AI 研發工作的 26%
同一週,Anthropic 發布了異常詳細的內部指標,展示 AI 已在多大程度上進入其自身的研究流程。
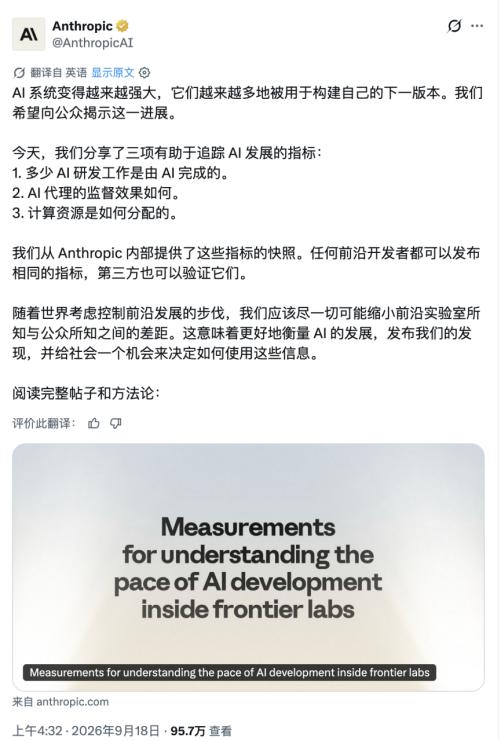
截至 2026 年 8 月,Anthropic 表示:
- Claude 主導 Anthropic 已衡量 AI 研發工作的 26%。
- 超過 90% 的工作至少有 AI 參與協作。
- 對於任何已衡量的工作子集,Claude 都尚未完全自主完成。
Anthropic 將「AI 主導」定義為:模型根據高階提示,從頭到尾完成任務的大部分工作,而人類則進行監督。
26% 這個數字特別引人注目,因為 Anthropic 表示,年初時這一比例還低於 1%。
Anthropic 發布這項指標,部分原因是它認為外部觀察者需要更清楚地了解,前沿實驗室正在以多快的速度將自身模型開發流程自動化。
Z.ai 展示出一個規模較小但更具體的回饋迴圈
Z.ai 也發布了另一個有用的例子。
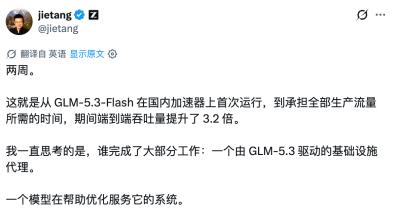
該公司表示,由 GLM-5.3 驅動的 Infra Agent 協助建構並最佳化為 GLM-5.3-Flash 提供推理服務的基礎設施。
根據 Z.ai 9 月的披露:
- 該系統運行於超過 100,000 個中國製 AI 加速器上。
- 服務堆疊從首次成功運行到承載完整正式流量,不到兩週。
- 端到端吞吐量提升至初始基準的 3.2 倍。
- 大部分最佳化工作由 GLM-5.3 驅動的 Infra Agent 完成。
Z.ai 明確表示,這不是完整的遞迴式自我改進。
其表述更為謹慎:一個最小規模的迴圈已經出現,在這個迴圈中,一個模型協助最佳化服務另一個模型的系統。
這項區分很重要。
當今的系統仍然需要人類設定目標、設計回饋、制定基礎設施限制,並審查高風險修改。
但這個迴圈已不再只是理論。
「AI 放緩」說起來比真正實施容易
原文最後一部分將 RSI 與前沿 AI 領導者之間的新辯論連結起來。
9 月 12 日,Anthropic 執行長 Dario Amodei 公開主張,產業應該放慢前沿發展速度,讓安全工作有更多時間追上模型能力。
他的提議包括讓獨立第三方評估人員永久取得員工級別的存取權,最終圍繞能力門檻與安全措施進行更廣泛的協調。
Sam Altman、Elon Musk 與 Demis Hassabis 都在不同程度上支持這樣的普遍觀點:在某些情況下,前沿開發可能需要更強的防護措施或更慢的步調。
但認同需要謹慎,比認同應由誰首先放慢腳步更容易。
競爭壓力讓協調式放緩變得困難
每一家前沿實驗室都面臨相同的策略問題。
如果一家企業在競爭對手持續推進時放慢能力開發,就可能失去技術領先地位、人才、客戶與市場份額。
同樣的邏輯也適用於國家層級。
一個考慮嚴格限制前沿開發的國家,可能會擔心競爭對手持續加速。
因此,即使主要實驗室都同意風險嚴重,協調式放緩的提議在結構上仍然很困難。
這種張力在目前的模型週期中十分明顯。
Google 正快速發布 Flash 模型,也可能正在測試更強的隱藏檢查點。Anthropic 正公開衡量 Claude 已經執行多少自身研發工作,同時考慮未來的模型發布。OpenAI 則持續發布前沿系統,並擴大第三方評估與安全要求。
這並不是一個簡單的矛盾。
這是一個協調問題:同一批組織可以真誠地擔心前沿風險,同時仍面臨保持前沿地位的強大誘因。
Claude Opus 5.2 與新 OpenAI 模型的傳聞,進一步加深了加速感
原文也引用了社群報告,這些報告暗示其他實驗室可能正在現有產品介面背後測試下一代模型。
一則廣泛流傳的貼文聲稱,一些 Claude Code 請求顯示了 claude-opus-5-2 識別碼。
這不是 Anthropic 官方產品公告。
同樣地,社群貼文也聲稱看到了目前已宣布產品線之外的其他 OpenAI 模型識別碼。
這些報告應與 Gemini 4 Pro 理論採取相同的看法:它們可以作為某些內容可能正在測試中的線索,但不等同於官方發布、規格或上市日期。
哪些內容已確認,哪些仍是傳聞?
| 聲稱 | 截至 2026 年 9 月 20 日的狀態 |
|---|---|
| Google 於 9 月 2 日發布 Gemini 3.8 Flash | 已確認 |
| Gemini 3.8 使用長時間運作的代理迴圈,遞迴式評估與改進底層模型 | Google 已確認 |
標記為 gemini-3.8-flash 的更強模型出現在 Arena | 已有報告且被廣泛觀察到 |
| Arena 模型就是 Gemini 4 Pro | 尚未確認 |
| Google 已正式宣布 Gemini 4 Pro | 沒有 |
| Google 公開模型文件目前列出 Gemini 4 | 沒有 |
G4P-ARGON 是真實的 Google 內部模型識別碼 | 未經驗證 |
| Gemini 4 Pro 擁有超過 1,000 萬上下文與 256K 輸出 | 未經驗證 |
| 病毒式流傳的 Gemini 4 基準測試分數是官方結果 | 不是 |
| Dream-RSI 是 2026 年 9 月發布的真實研究論文 | 已確認 |
| Anthropic 表示 Claude 主導其已衡量 AI 研發工作的 26% | 已確認 |
| Anthropic 表示超過 90% 的已衡量 AI 研發工作至少有 AI 協作 | 已確認 |
| Z.ai 表示 GLM-5.3 Infra Agent 協助將 GLM-5.3-Flash 的服務吞吐量提高 3.2 倍 | 已確認為供應商報告的結果 |
| Claude Opus 5.2 的社群目擊代表官方發布 | 不是 |
常見問題
Gemini 4 Pro 已正式發布嗎?
沒有。Google 尚未正式宣布 Gemini 4 Pro,目前公開的 Gemini API 文件也沒有列出 Gemini 4 模型。當前故事的基礎,是一個能力異常強的 Arena 模型,以及社群對其身分的猜測。
為什麼人們認為 Arena 模型是 Gemini 4 Pro?
這個隱藏模型使用了 gemini-3.8-flash 標籤,但在 SVG、網頁、3D 與代理風格測試中的表現似乎比公開正式版模型更強。其較慢且更審慎的行為,也讓一些測試者認為它更像 Pro 級檢查點,而不是 Flash 模型。
洩漏的 Gemini 4 Pro 基準測試分數是真的嗎?
尚未獲得驗證。病毒式流傳的表格沒有 Google 或 Arena 的官方支持,缺乏可重現的評估設定,而且其中部分其他供應商模型的比較數值與官方基準測試發布結果並不完全一致。
AI 的遞迴式自我改進是什麼?
遞迴式自我改進是指 AI 系統協助改進產生更強 AI 系統的流程,從而形成回饋迴圈。目前的前沿實驗室並未公開宣稱已實現完全自主的 RSI,但 AI 已經參與評估、程式設計、基礎設施最佳化與模型研發。
Gemini 3.8 已經使用 RSI 技術了嗎?
Google 表示,Gemini 3.8 透過長時間運作的代理迴圈加速,這些迴圈會遞迴式評估與改進底層模型。這是一種真實的自我改進機制,但其範圍遠小於一個無需人類監督、可完全自主設計自身後繼者的系統。
Dream-RSI 是什麼?
Dream-RSI 是 Google、Google DeepMind 與學術合作夥伴於 2026 年 9 月發布的研究框架。它將過往探索歷史用作重播模擬器,讓代理以較低成本改進探索策略,然後在真實環境中重新部署改進後的策略。
Anthropic 的 AI 研發工作已有多少自動化?
Anthropic 表示,Claude 主導其已衡量 AI 研發工作的 26%,超過 90% 的工作至少有 AI 協作。Anthropic 也表示,對任何已衡量的工作子集,Claude 都尚未完全自主完成。
為什麼 AI 放緩難以協調?
一家企業若單獨放慢腳步,就可能被持續推進的競爭對手超越。國家之間也存在相同的誘因問題,這就是為什麼共同評估規則與能力門檻比真正實施更容易提出。
相關工具
- Google AI Studio:Google 用於測試已發布 Gemini 模型並比較真實正式版行為的官方環境。
- Gemini API:Google 的官方開發者平台,以及目前支援的 Gemini 版本模型文件。
- LMArena:盲測模型比較平台,尚未發布或匿名化的模型檢查點有時會在此接受評估。
- Dream-RSI:本文介紹的遞迴式自我改進研究框架官方專案網站。
- Anthropic Research:Anthropic 的官方研究中心,涵蓋模型行為、對齊、評估與 AI 研發自動化。
相關連結
- Google:Introducing Gemini 3.8 Flash and 3.8 Flash Cyber:Google 9 月 2 日的官方發布公告,以及對遞迴式代理評估迴圈的說明。
- Gemini 3.8 Flash 模型頁面:已發布模型的官方上下文視窗、輸出限制、模態與 API 能力。
- Gemini API 發布說明:目前的 Gemini 官方發布歷史;截至 9 月 20 日,當中沒有列出 Gemini 4 發布資訊。
- Dream-RSI 論文:關於透過不斷演化的探索世界進行遞迴式自我改進的技術論文。
- Anthropic:Measuring the Pace of AI Development:官方報告,顯示 Claude 主導 26% 的已衡量 AI 研發工作,並參與超過 90% 的工作協作。
- Z.ai:How GLM Built Its Own Inference Infrastructure:Z.ai 關於由 GLM-5.3 驅動的 Infra Agent 協助最佳化 GLM-5.3-Flash 服務基礎設施的說明。
- OpenAI:Trustworthy Third-Party Evaluations:OpenAI 發布的獨立前沿模型評估框架。
摘要
一個標記為 gemini-3.8-flash、表現超出預期的模型出現在 Arena,社群測試者也產生了足夠多的異常輸出,使 Gemini 4 Pro 理論具有一定可信度。但具有可信度不等於已確認:Google 尚未宣布 Gemini 4 Pro,病毒式流傳的後端截圖未經驗證,網路流傳的基準測試表也沒有官方支持。
更持久的故事,是 AI 協助 AI 開發正在加速。Google 公開表示,Gemini 3.8 使用長時間運作的迴圈,遞迴式評估與改進其底層模型。Dream-RSI 將自我改進的探索迴圈形式化。Anthropic 表示,Claude 已主導其已衡量 AI 研發工作的 26%;Z.ai 則表示,由 GLM 驅動的基礎設施代理協助將 GLM-5.3-Flash 的服務吞吐量提升至原來的三倍以上。
這讓產業放緩辯論變得更困難,而不是更容易。前沿實驗室可以同意需要獨立評估與更強的防護措施,同時仍面臨持續推進的強大誘因。
Gemini 4 Pro 仍是傳聞;AI 系統協助建構下一代 AI 的轉變,已經成為現實。