For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/glm-legal-explained-harvey-lab-scores-leg-ebeccf7b.md.
Z.ai 推出 GLM-Legal,這是一款專為合約審閱、證據串聯與合規研究等工作打造的專用模型。它著重於從原始資料一路整理出可用草稿的完整流程,而非只回答單一法律概念問題。
Z.ai 推出 GLM-Legal,這是一款專為合約審閱、證據串聯與合規研究等工作打造的專用模型。它著重於從原始資料一路整理出可用草稿的完整流程,而非只回答單一法律概念問題。
提供的報告指出,GLM-Legal 在兩項法律基準測試中,於開放權重模型裡名列第一。比起標題,實際數字更有參考價值:在 Harvey 的 Legal Agent Benchmark 中,約有 19.2% 的任務完全通過;在 LegalBench 中,準確率為 86.23%。
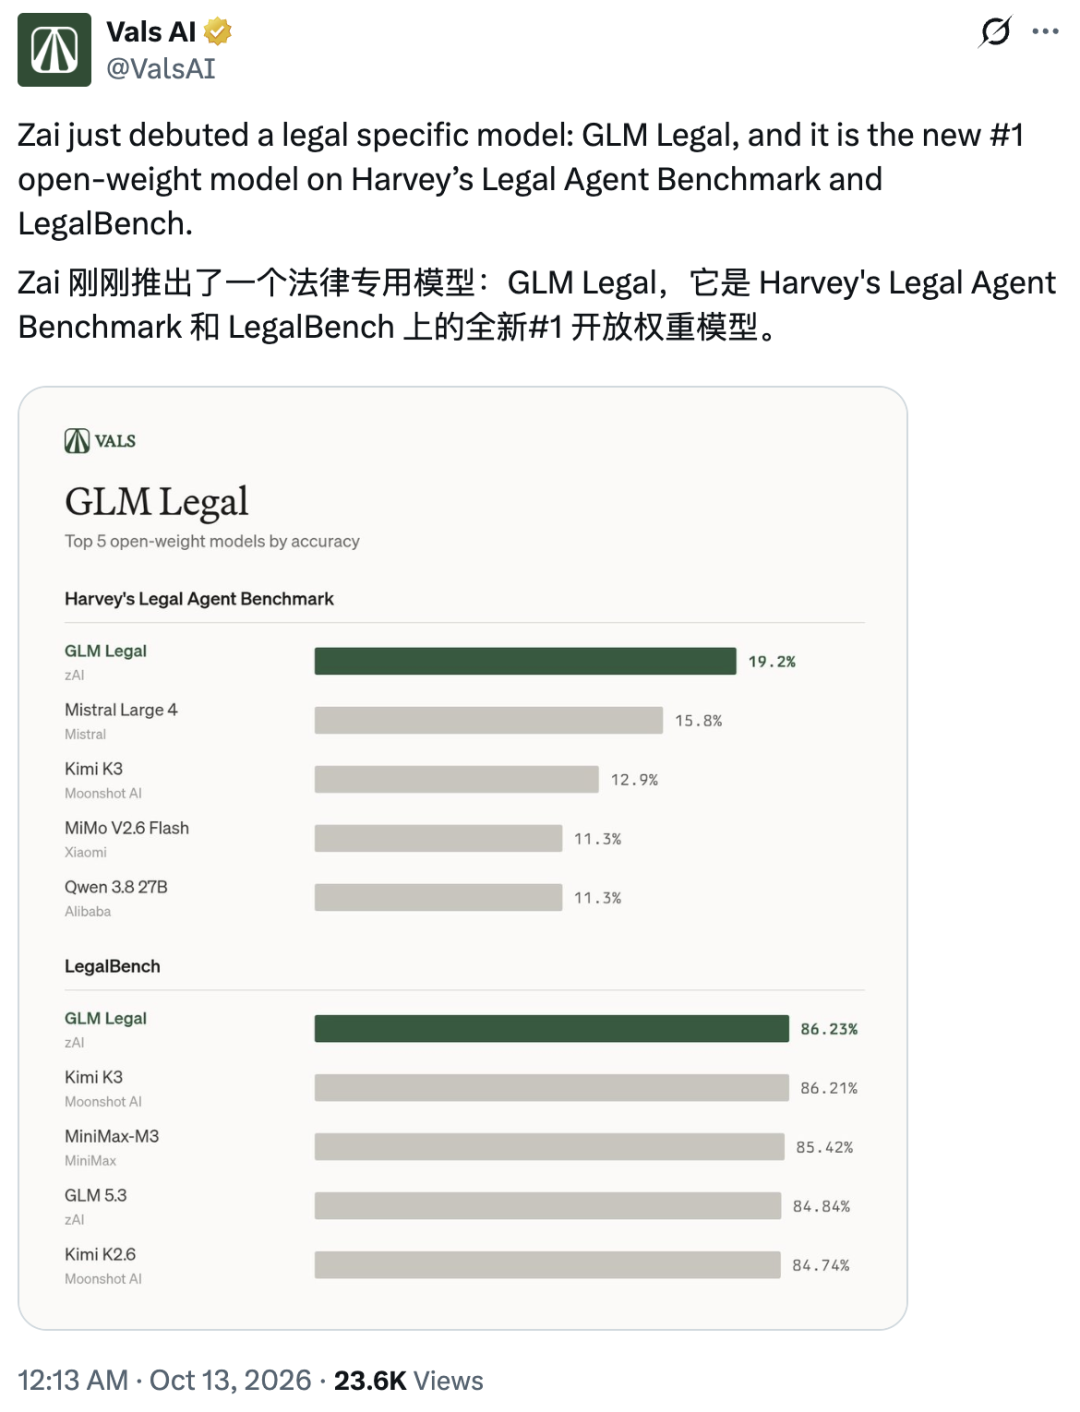
這些百分比衡量的是不同項目。它們不能證明此模型適用於所有司法管轄區,也不能證明它能獨立承擔法律事務責任。
官方公告說明,評估內容涵蓋複雜任務執行、專業法律推理,以及實務法律工作流程。中國法律實務的測試結果採用 PLawBench;其他案例則涉及英文資料與跨境隱私工作。
這個範圍回答了關於此模型的一個顯而易見的問題:它並非被定位為只能處理英文的法律聊天機器人。不過,這並不代表所有輸出在每個國家都符合現況或適用。草稿是否有用,仍取決於相關法律、事實、日期與專業審查。
第一個示範案例涉及客戶更換軟體服務供應商。任務是審閱終止與移轉條款,確保客戶能取回相關資料,並讓專案持續推進。
與基礎版 GLM-5.3-Flash 的回覆相比,專用模型提出了更具體的修改建議。在此案例中,它建議將任意終止通知期從 60 天縮短至 30 天、取消特定重大違約情況的補救期限,並加入最長 90 天的移轉協助。
模型也將交付成果返還建議,連結至合約既有的工作成果所有權條款,涵蓋未完成及未付款的工作,而不只限於已完成且已付款的交付成果。移轉範圍包括原始碼、文件、資料與知識移轉。
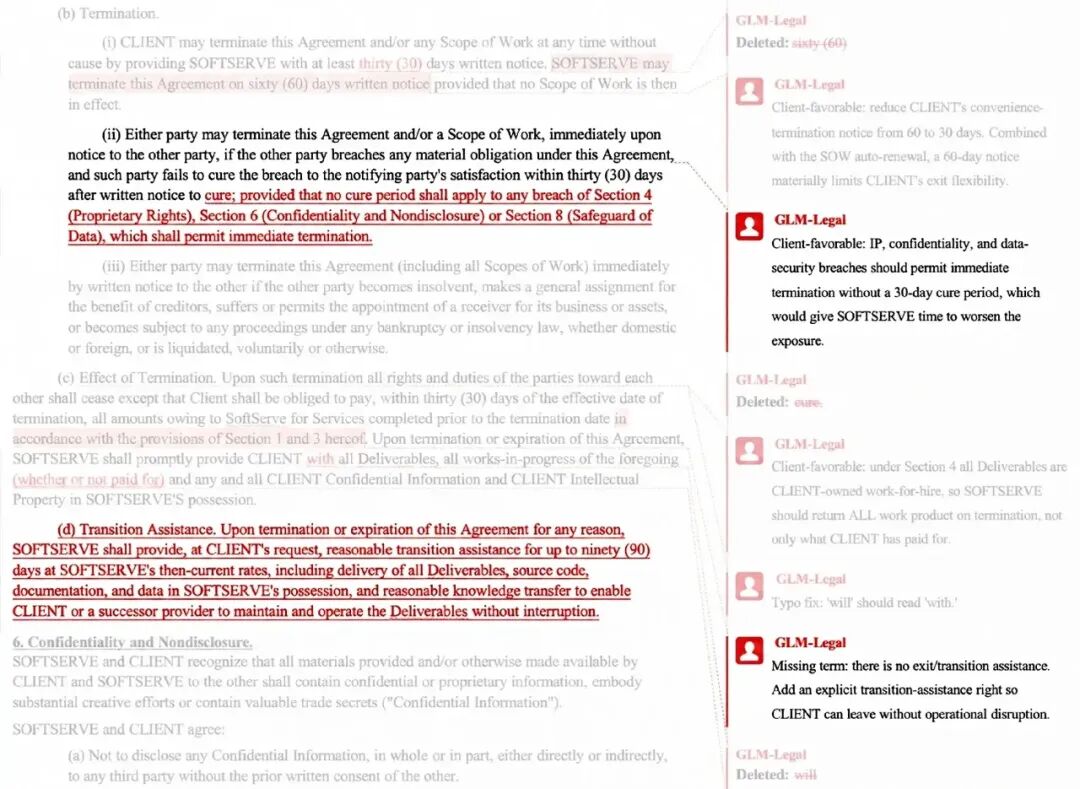
這些是針對所提供合約提出的談判立場建議。30 天通知期或 90 天交接期並非普遍適用的法律要求。其適切性取決於協議內容、客戶立場、定價與準據法。
第二個示範案例讓代理程式分析一起軟體專案爭議中的 40 份文件。提供給客戶的進度報告指出專案完成度為 60%,而內部快照則估計約為 41%。
基礎模型與專用模型都發現了這項差異。GLM-Legal 更進一步,將進度報告與先前對里程碑的警示、關於揭露與開立發票的內部指示,以及涉及付款與存續權利的合約條款連結起來。
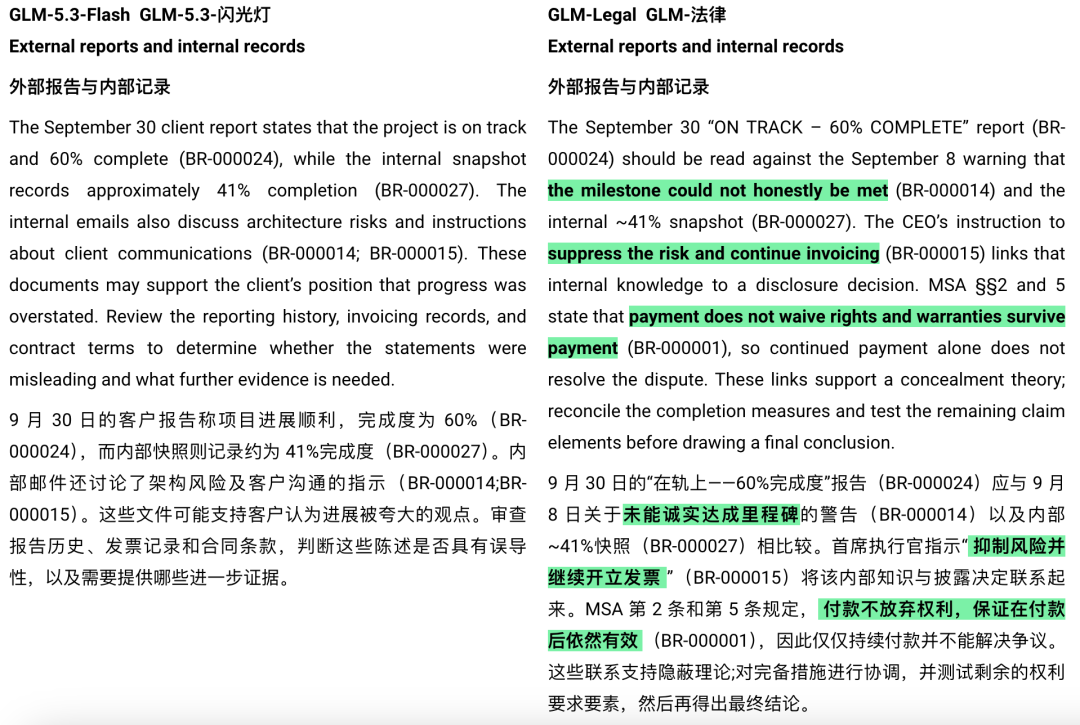
這讓調查方向更清楚:確認哪些原始文件支持各項主張、調和不同的完成度衡量方式,並檢視任何主張尚需具備的其他要件。輸出內容提出了一種可能的案件理論;僅憑互相矛盾的百分比,並不足以作出最終的詐欺或責任認定。
第三個案例涉及一個將在新加坡、馬來西亞與印尼上線的網站。工作流程包括追蹤、行銷電子郵件與海外雲端儲存。
GLM-Legal 整理出一系列上線前優先事項:隱私告知、同意紀錄、分開取得行銷許可、退訂名單抑制、供應商資料所在地圖,以及審查合約與資料傳輸保障措施。它也區分了較保守的共通基準,以及仍須按國家確認的問題。
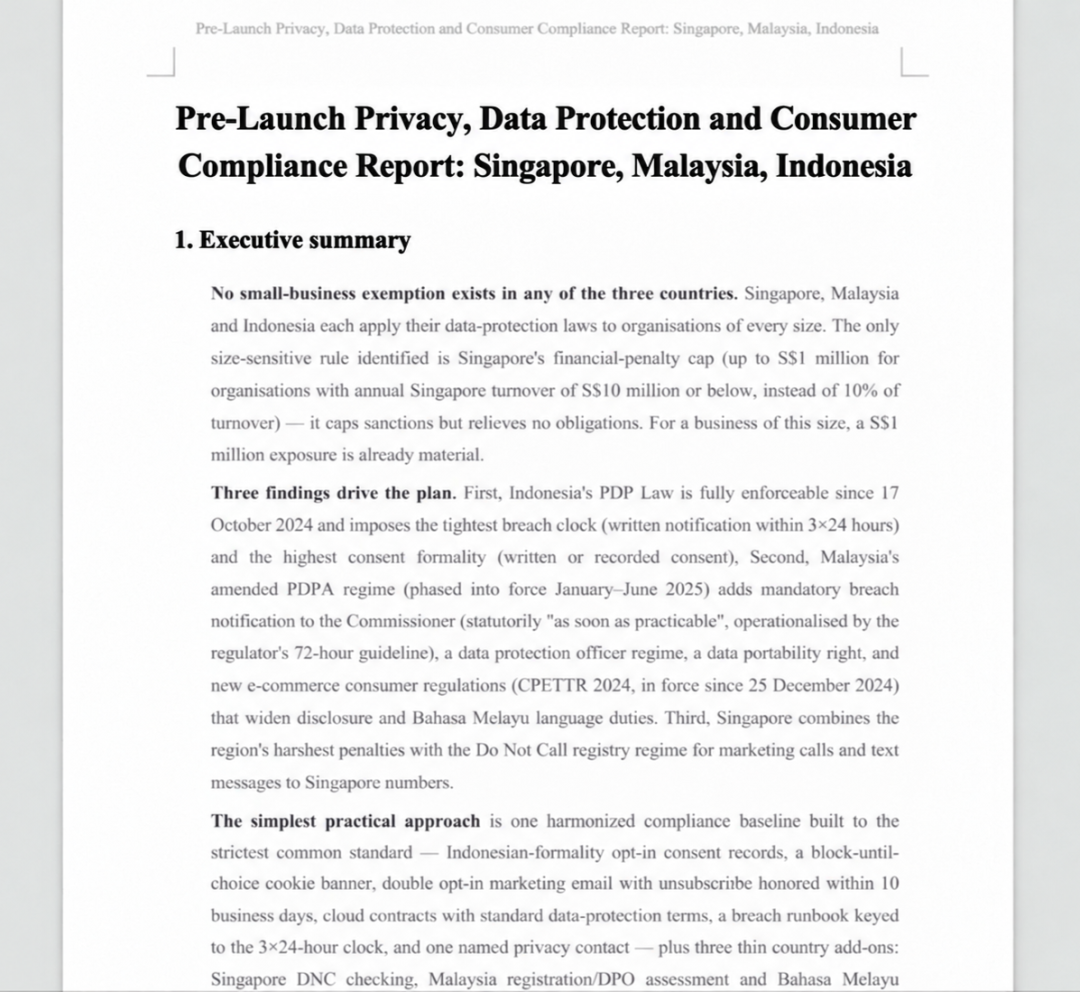
實際價值在於產出一份草稿,列出團隊可以分派並逐項檢查的行動。此示範並未取代對現行法規、監管機關指引、實際資料流,或特定服務在當地要求的查核。
Harvey 設計 LAB,模擬律師事務所助理可能接到的工作:合夥人提出需求、客戶案件附有佐證資料,以及一份可供他人審查的交付成果。其第一版包含 24 個執業領域、1,200 多項任務,以及超過 75,000 條由專家撰寫的評分標準。
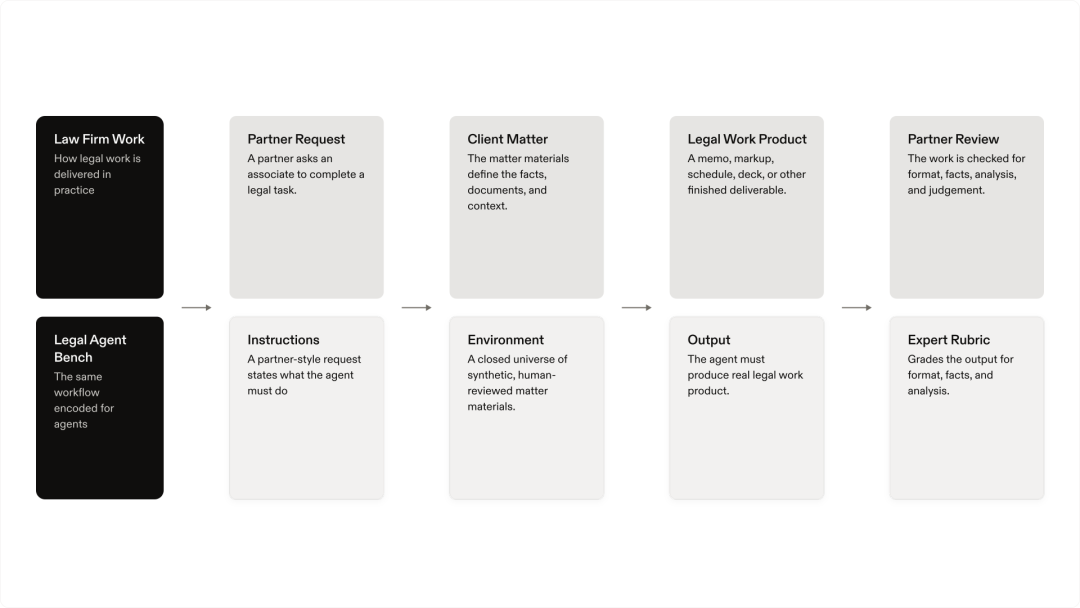
此基準測試採用全項通過評分。只有在所有必要評分標準都通過時,任務才會被計為完成。評分項目涵蓋事實、引註、結論、期限、金額與輸出格式等。只要漏掉一項重要要求,該任務就無法完全通過。
| 評估項目 | 查閱資料中的結果 | 衡量內容 |
|---|---|---|
| Harvey LAB | 19.17%,四捨五入為 19.2% | 符合所有必要評分標準的任務比例。 |
| LegalBench | Vals 目前模型頁面列出的數值為 86.23% | 另一組法律推理任務的準確率。 |
| PLawBench | Z.ai 表示與領先的前沿系統表現相當 | 中國法律實務評估;與 Vals 的兩項結果採用不同指標。 |
Vals 的原始公告稱,在當時的比較結果中,GLM-Legal 是 LAB 與 LegalBench 上表現領先的開放權重模型。整體排行榜也納入專有系統:本文查閱的 Vals 頁面將其列為 LAB 80 個模型中的第七名,以及 LegalBench 151 個模型中的第十五名。隨著新增評估,排名與樣本數可能有所變動。
19.2% 的全項通過率是在嚴格標準下取得的進展證據,但也表示絕大多數受評任務未能符合所有評分標準。這表示應檢視失敗案例並保留人工審查,而非將模型視為能自主運作的律師事務所。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
來源將 GLM-Legal 與 Harvey LAB 排行榜上的 Gemini 4 Argon 作比較。在該次資料快照中,兩者的任務通過結果相近,但 GLM-Legal 約多花半小時,且每次測試成本低得多;據報告,成本差距約為 70 倍。
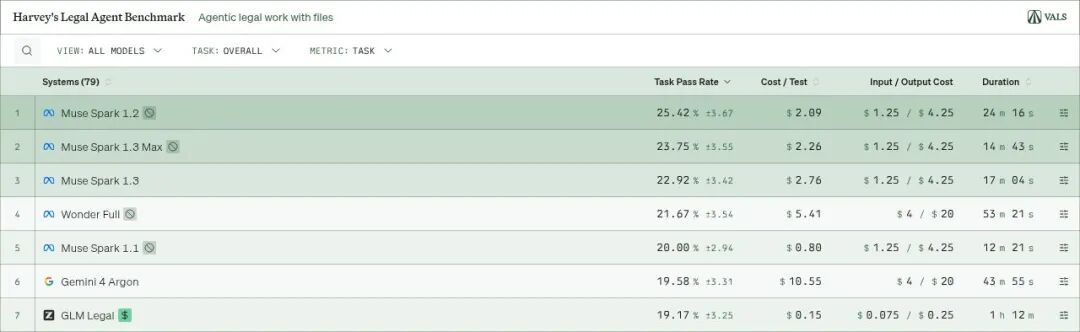
這些數據是基準測試執行時的測量結果,並不保證用於另一組文件或團隊每月帳單時也會相同。工具使用方式、測試框架設計、推理設定、任務長度與重試次數,都會影響實際成本效益。
官方訓練說明以 GLM-5.3-Flash 為基礎,並分階段加入專業化訓練:
測試框架本身也是持續改進的系統一部分。同一個模型放在不同工具環境中,未必能重現示範中的工作流程品質。
Z.ai 邀請律師事務所、法律科技企業、企業法務團隊與獨立實務工作者申請 GLM-Legal API Beta 測試。公告也表示,法律能力將整合至 AutoClaw,並在此脈絡下介紹 Word 編輯與研究案例。
Vals 將 GLM-Legal 標示為開放權重模型。然而,本文查閱的發布資料並未確認是否有可下載的檢查點、授權條款、支援的推論技術堆疊或硬體需求。因此,目前沒有經核實的 Docker 安裝指令,也沒有足夠根據宣稱本機部署已普遍開放。
若團隊目前正在評估,公告中明確提供的管道是官方諮詢與 Beta 申請。實際使用時,應確認 Beta 的具體使用條件與 AutoClaw 的可用狀況。
提供的報告將 GLM-Legal 與智譜 AI 先前於 2023 年和 PowerLaw 合作推出 PowerLawGLM 的工作並列,也提到 Harvey 的 Tenet,作為透過領域導向後訓練使通用模型專業化的另一個案例。
共同理念很明確:只有法律知識還不夠。實用的助理必須能整理原始資料、區分事實與推論、適當使用工具,並交付專業人士可檢視的成果。查閱的 GLM-Legal 版本為這種做法提供了證據,同時也顯示其完整任務可靠性仍有相當大的提升空間。
GLM-Legal 是 Z.ai 以 GLM-5.3-Flash 為基礎打造的法律專用模型。公告著重介紹合約審閱、證據分析與合規研究等代理工作流程。
提供的報告所稱的領先模型,是指特定基準測試中的開放權重模型比較。整體排行榜也納入專有系統,而基準測試排名並不能證明模型適用於所有法律任務。
不是。LAB 的全項通過分數衡量的是所有必要評分標準均符合的任務比例。LegalBench 的 86.23% 是另一項評估採用的不同指標。
Z.ai 表示,模型在 PLawBench 上取得了涵蓋中國法律諮詢、分析與起草工作的結果。這支持其面向中國法的預定用途,但特定答案仍須依據適用事實與現行法律查核。
本文查閱的資料未提供經核實的檢查點下載、授權、硬體規格或 Docker 部署流程。雖然 Vals 將其歸類為開放權重模型,但此處所述的官方發布管道是申請 API Beta 測試。
Z.ai 在公告中表示,GLM-Legal 將於後續導入 AutoClaw。示範案例呈現的是預期工作流程,並未證明所有使用者都能不受限制地使用。
GLM-Legal 結合法律領域訓練與代理工作流程最佳化,其示範著重於具體且可供審查的交付成果。基準測試結果在其所述比較範圍內值得關注,而嚴格的 LAB 分數也清楚呈現了可靠性方面仍待改善的空間。
運用 Beta 測試與基準測試證據評估特定工作流程;不要將排行榜名次擴大解讀為全面的法律能力或已具備部署條件。
從一句話開始,幾分鐘內拿到完整網站。



