For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/gpt-6-astra-unitree-g1-homebody-kitchen-r-56df14d6.md.
斯坦福大学与加州理工学院的 HomeBody 项目将 GPT Astra 与 Unitree G1 人形机器人连接起来,让机器人探索未知厨房、建立空间记忆、重建数字孪生,并通过调用可复用的导航与操作技能完成长时序任务。本指南介绍其三步工作流程、System 2/System 0 ...
具身智能的最新进展,并不是又一个桌面机器人手臂演示。
现在,Unitree G1 人形机器人已经被展示能够探索陌生厨房,记住物品所在位置,清理房间另一侧的物品,打开抽屉,取出已经不在视野中的药品,并将药品递给人类。
这个项目名为 HomeBody,由斯坦福大学和加州理工学院的研究人员共同开展。
它的核心理念其实非常简单:
让前沿视觉语言模型将机器人技能视为工具。
HomeBody 并不是让模型输出每一个关节指令,而是让 GPT Astra 理解任务、决定下一步应该做什么,并调用可复用的导航、抓取、放置、开抽屉和取物技能。
这使模型成为高层规划器,而不是底层电机控制器。
相比常见的“看到物体、抓取物体、停止”流程,这种方式能够支持更长时序的机器人工作流。
在厨房演示中,机器人首先探索环境并建立持久化空间记忆。随后,它重建一个数字孪生,将这一表示与真实房间对齐,并利用此前保存的观察结果完成后续指令。
例如,用户可以说:
“整理一下厨房。把咖啡袋放到中岛上,并把变质的纸盒扔掉。”
随后,G1 会在不同位置之间移动,收集咖啡袋,并丢弃指定的纸盒。
第二个任务更加能说明问题:
“我忘记拿药了,你能帮我取来吗?另外,顺便把坏掉的纸盒扔掉。”
用户提出请求时,药品并不在视野中。
HomeBody 会搜索已保存的空间记忆,回忆起此前观察到药品所在的抽屉,导航到那里,打开抽屉,取出药品,将其递给用户,同时继续完成丢弃纸盒的任务。
这正是关键变化。
机器人不再只对当前摄像头前方的内容做出反应,而是将当前感知、记忆中的观察、房间几何结构、导航、操作和跨越整个空间的任务排序结合起来。
HomeBody 的核心设计可以用一句话概括:
GPT Astra 通过结构化工具调用来选择并编排机器人技能。
模型负责理解用户目标,并决定下一步需要发生什么。
机器人技术栈负责处理物理执行细节。
简化后的流程如下:
用户指令
      ↓
GPT Astra / System 2
      ↓
选择技能 + 目标
      ↓
导航 / 抓取 / 放置 / 打开抽屉 / 从抽屉中取物
      ↓
感知 + 运动规划 + 底层控制
      ↓
执行结果
      ↓
将结果返回给 GPT Astra
      ↓
选择下一步动作
不过,在机器人能够从陌生厨房中取回物品之前,它需要的不只是技能库。
它还需要了解厨房的样子,以及记忆中的物品位于何处。
HomeBody 通过三个阶段建立这一上下文。
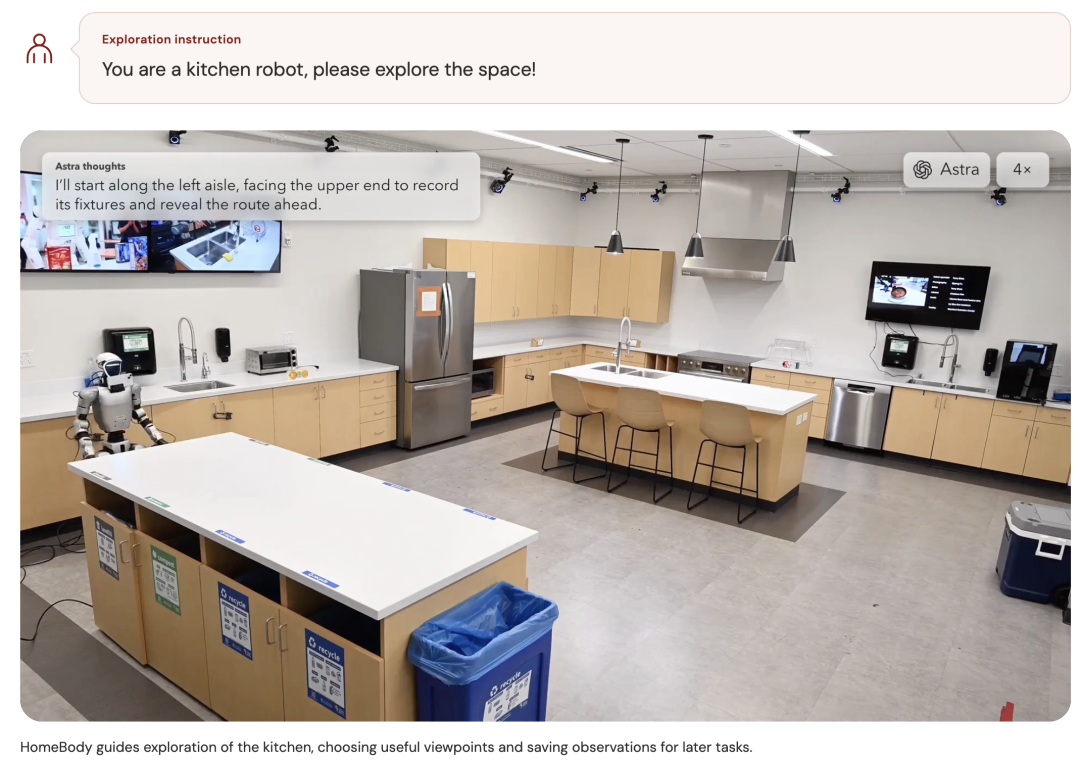
第一条指令经过刻意简化:
你是一台厨房机器人,请探索这个空间!
随后,GPT Astra 选择有用的观察角度,并引导 G1 穿过房间。
在探索过程中,HomeBody 会收集多种数据,包括:
摄像头展示房间中的内容。
LiDAR 和其他传感器提供经过测量的空间结构。
SLAM,即同步定位与建图,帮助机器人在估计自身在地图中位置的同时建立地图。
关键在于持久性。
当 G1 转身离开某个物体时,相关信息不会随着摄像头视野的消失而消失。
HomeBody 会保存观察结果,并将其与具体位置关联起来,以便后续任务检索。
因此,即使药品当前隐藏在抽屉里,或位于机器人的视野之外,机器人仍然可以完成“把我的药拿来”这样的请求。
仅仅探索还不够。
接下来,HomeBody 使用 GPT Astra 作为 Real2Sim 智能体,在 NVIDIA Isaac Sim 中创建环境的数字重建。
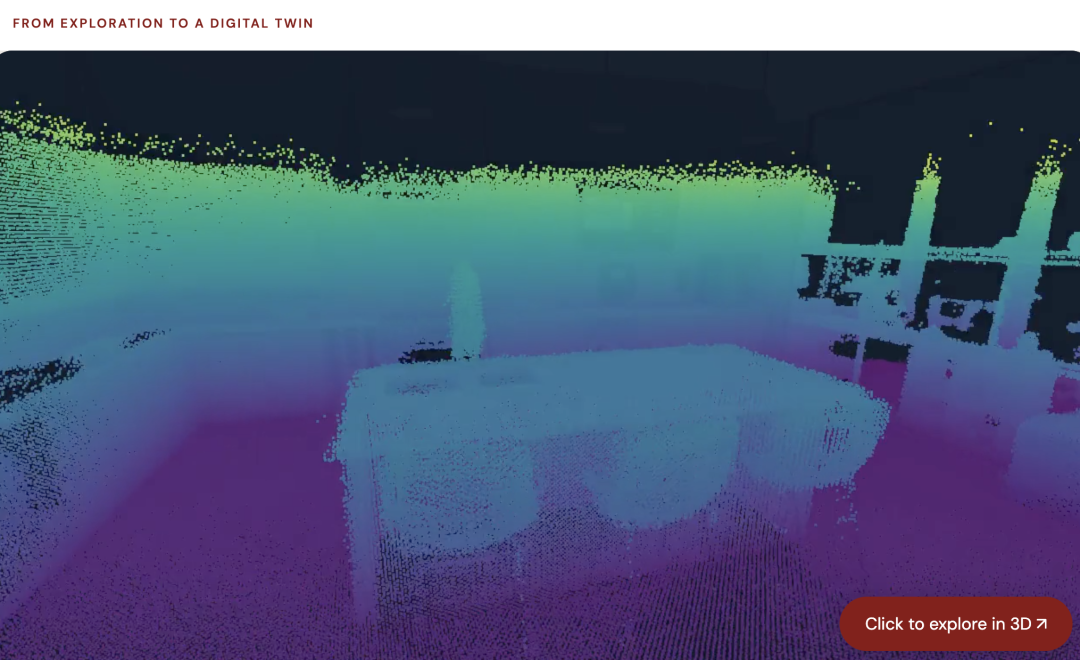
数字孪生充当厨房的空间模型。
它为系统提供以下内容的结构化表示:
重要的是,这一重建并不只基于外观。
HomeBody 还会将测量得到的 SLAM 几何信息输入 Real2Sim 流程。
这使重建结果受到真实世界尺寸约束。
这一点很重要,因为具有视觉吸引力的重建并不足以支持机器人工作。
机器人必须知道通道是否真的足够宽,身体是否能够足够靠近抽屉,以及手臂能否在不与环境碰撞的情况下够到目标。
随后,系统会将真实世界的 SLAM 地图与重建后的仿真环境对齐到同一个坐标系中。
保存的摄像头观察结果、语义描述和机器人位置,随后都可以与房间中的实际位置关联起来。
因此,HomeBody 保存的不只是:
我看到了一个药瓶。
它可以更接近于保存:
我在这个抽屉里看到了药品,
它位于这个已记忆的位置,
并处于共享的房间坐标系中。
这正是后续能够取回物品的原因。
完成探索和重建后,用户就可以下达日常任务。
例如:
整理一下厨房。
把咖啡袋放到中岛上,
并把变质的纸盒扔掉。
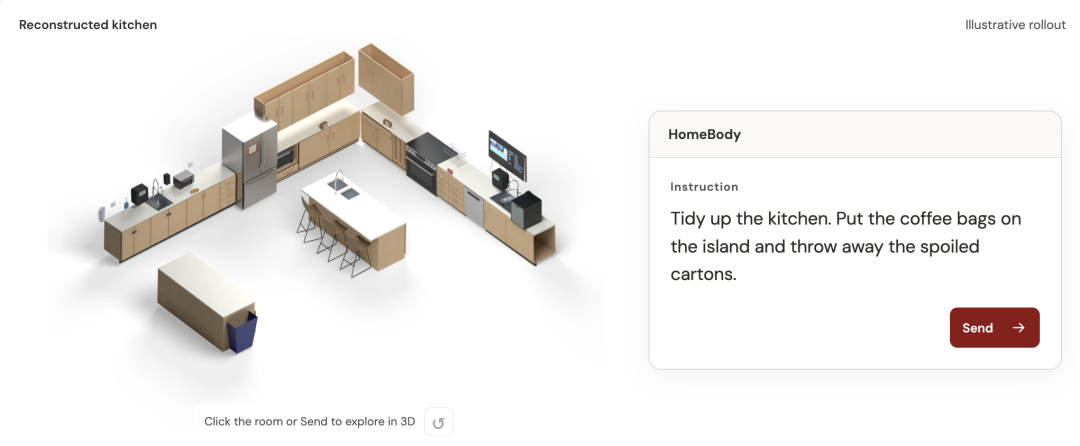
在每个阶段,GPT Astra 都可以考虑:
随后,它会选择下一项技能和目标。
药品演示说明了这一机制的价值。
用户并没有指定抽屉的位置。
模型可以回忆起此前的观察结果,导航回正确区域,打开抽屉,取出药瓶,将其递给用户,然后继续执行剩余的清理指令。
这个任务的时序足够长,任何单个摄像头画面都不包含完成任务所需的全部信息。
这正是持久化空间记忆发挥价值的地方。
这是 HomeBody 最重要的架构细节。
听到“GPT 控制人形机器人”时,人们很容易想象语言模型直接输出每个关节角度。
但 HomeBody 并不是这样工作的。
RoboCurve 等早期工作展示了前沿模型如何通过观察摄像头图像和机器人状态,使用指定夹爪位置、方向以及开合状态的工具来控制机械臂任务。
HomeBody 工作在更高的抽象层级上。
模型调用的是完整且可复用的技能。
该项目将常见的人形机器人技术栈解释为三个概念层级:
传统的学习型动作架构可能如下:
System 2 VLM
     ↓
System 1 VLA
     ↓
System 0 全身控制器
HomeBody 改变了这一流程的中间部分。
它不要求学习型 VLA 将高层意图转换为动作,而是让 VLM 直接调用可组合的技能库。
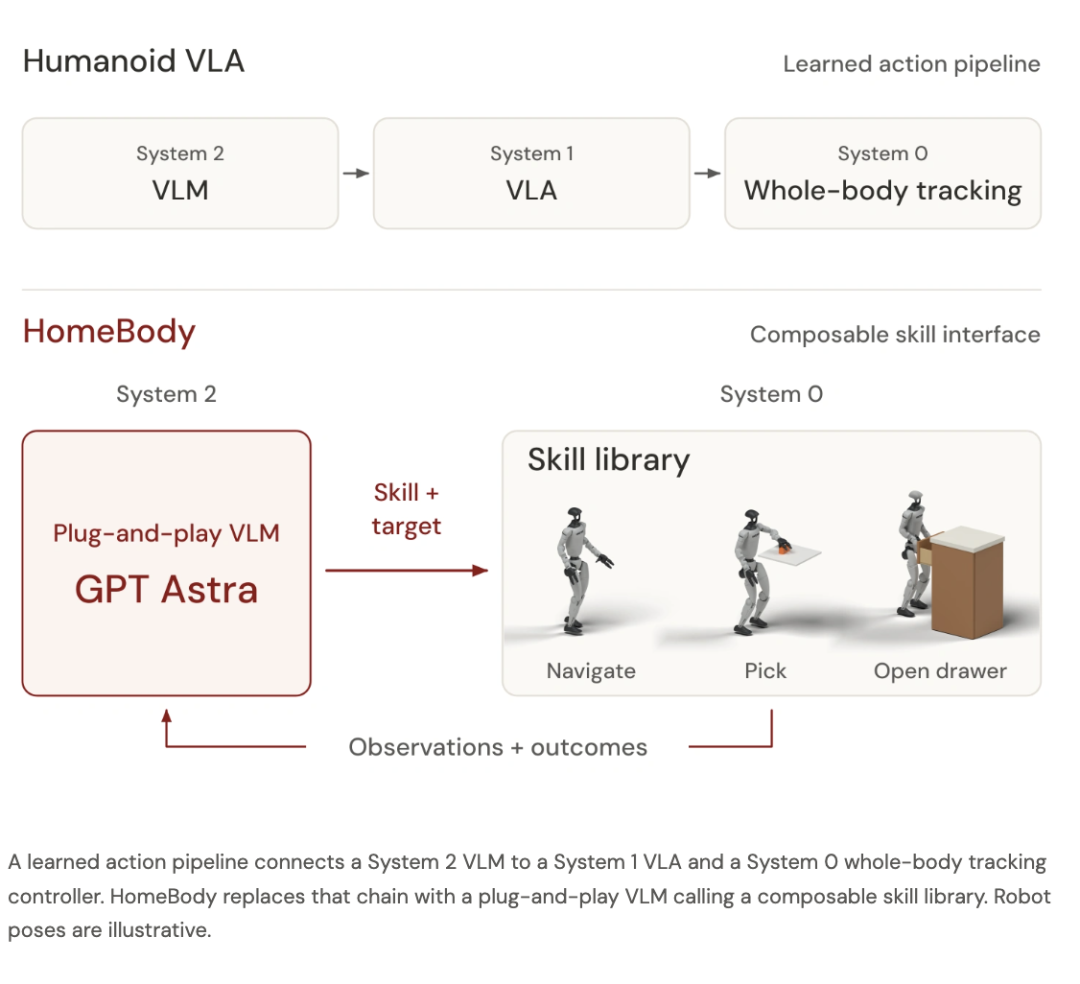
由此形成的结构更接近:
System 2 VLM
     ↓
技能库
     ↓
运动规划 + 感知
     ↓
System 0 全身控制
HomeBody 当前的技能词汇包括:
| 技能 | 高层模型提供的内容 | 技能负责的内容 |
|---|---|---|
| 导航 | 目标位置与方向 | 路径规划与行走执行 |
| 抓取 | 图像点与手部选择 | 分割、深度、抓取姿态、手臂轨迹与重试 |
| 放置 | 手部与三维释放目标 | 将手中的物体移动到目标位置并释放 |
| 打开抽屉 | 抽屉或把手目标 | 对齐、钩取姿态与向后拉动序列 |
| 从抽屉中取物 | 开启抽屉内的物体目标 | 伸手、抓取、抬起与局部重试逻辑 |
所有技能都共享目标与执行结果接口。
模型不需要理解每项技能内部的全部底层实现。
它只需要决定运行哪项技能,以及技能的目标是什么。
对于抓取动作,GPT Astra 会在第一视角摄像头图像中选择一个点,并选择使用哪只手。
接下来由技能栈接管。
根据 HomeBody 的实现:
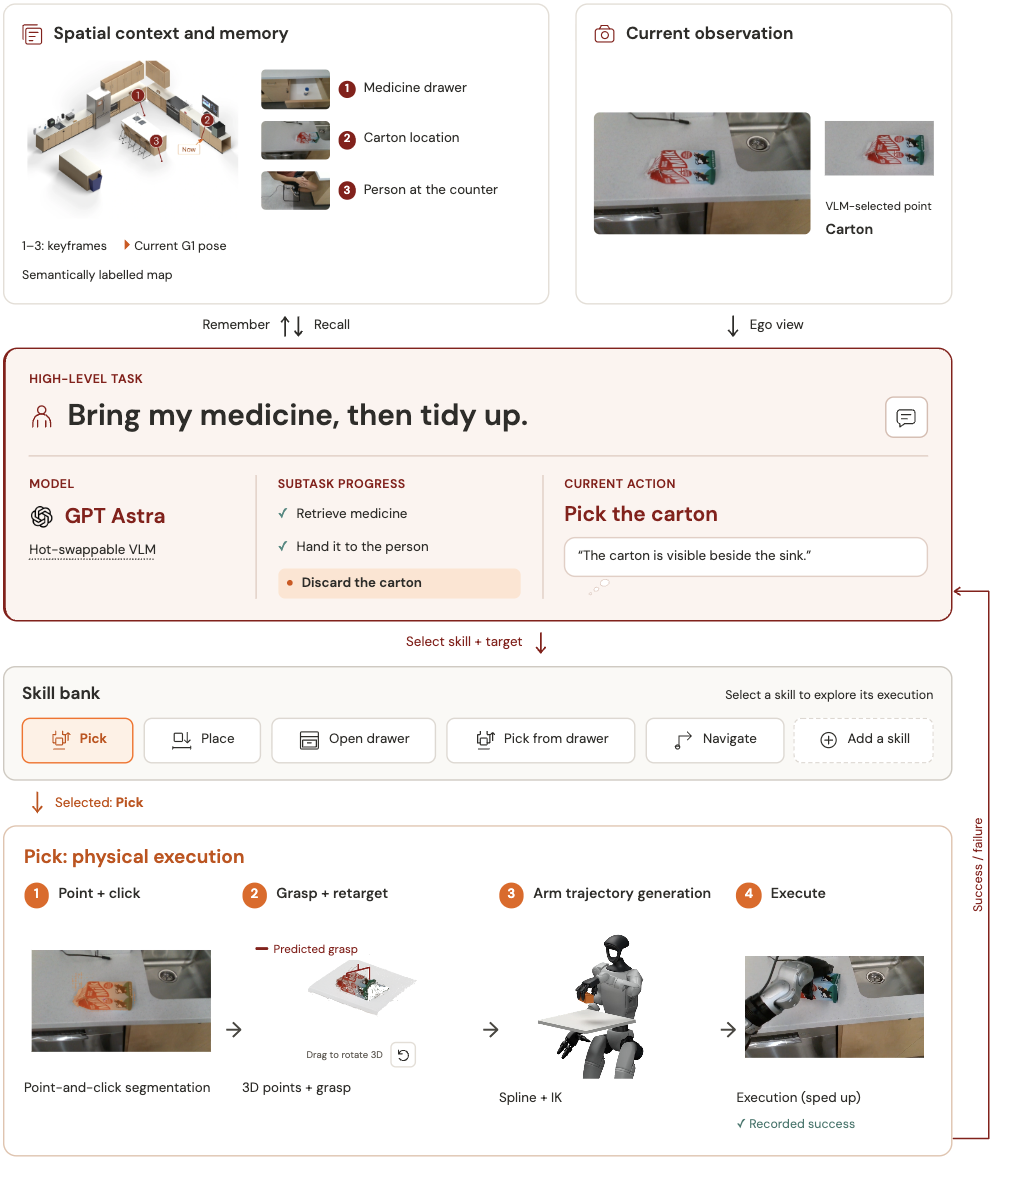
换句话说:
GPT 决定抓取什么
以及使用哪只手。

机器人技能决定
手在物理上如何到达那里。
这种分离让前沿模型可以专注于推理和任务排序,而不必负责实时电机控制。
物理世界充满噪声。
当机器人靠近物体时,物体可能会在摄像头图像中发生位移。
抓取动作可能在没有接触到物体的情况下闭合。
机器人可能需要调整站姿。
因此,HomeBody 不要求 GPT 为每一个微小的纠正动作做出新的决策。
项目使用分割,以及结合 SAMURAI 风格记忆选择的 SAM 2.1 跟踪,在不同帧之间跟踪目标。
随后,视觉伺服可以在局部修正对齐误差。
如果抓取失败,技能可以尝试另一个候选抓取点,或重新调整位置并再次规划。
这些局部重试受到边界限制。
当局部技能无法继续恢复时,它会将失败原因返回给 GPT Astra。
随后,VLM 可以选择另一个目标、重新定位机器人,或改变高层计划。
这一循环如下:
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
做出决策
  ↓
执行技能
  ↓
观察结果
  ↓
如果可能则局部重试
  ↓
将结果返回给 GPT Astra
  ↓
必要时重新规划
这就是多项技能如何被串联成更长任务序列的方式,例如:
导航到抽屉
→ 打开抽屉
→ 取出药品
→ 导航到用户身边
→ 将药品递给用户
→ 找到纸盒
→ 扔掉纸盒
即使高层规划器选择了正确技能,人形机器人在行走和伸手时仍然必须保持平衡。
HomeBody 使用预训练的 AMO(自适应运动优化),实现考虑上半身状态的下肢控制。
该控制器会在协调行走的同时考虑上半身目标。
根据项目页面,手臂和手部指令以 250 Hz 运行,而 AMO 策略每五个控制周期更新一次,即以 50 Hz 更新。
这也是为什么“无需额外训练”这一说法需要结合上下文理解。
新的厨房环境不需要重新训练特定环境的动作策略。
但系统底层仍然依赖此前训练和工程化的组件。
HomeBody 最有力的主张之一,是它能够进入此前未见过的厨房,而不必收集特定环境的训练数据,也不必为该房间学习新的动作策略。
这具有实际意义。
传统机器人部署通常需要示范数据、策略训练或针对环境的调试,之后机器人才能可靠执行任务。
而 HomeBody 将以下能力结合起来:
这将部分适应负担从重新训练转移到了推理 + 建图 + 可复用工具上。
完整的 HomeBody 流程可以概括为:
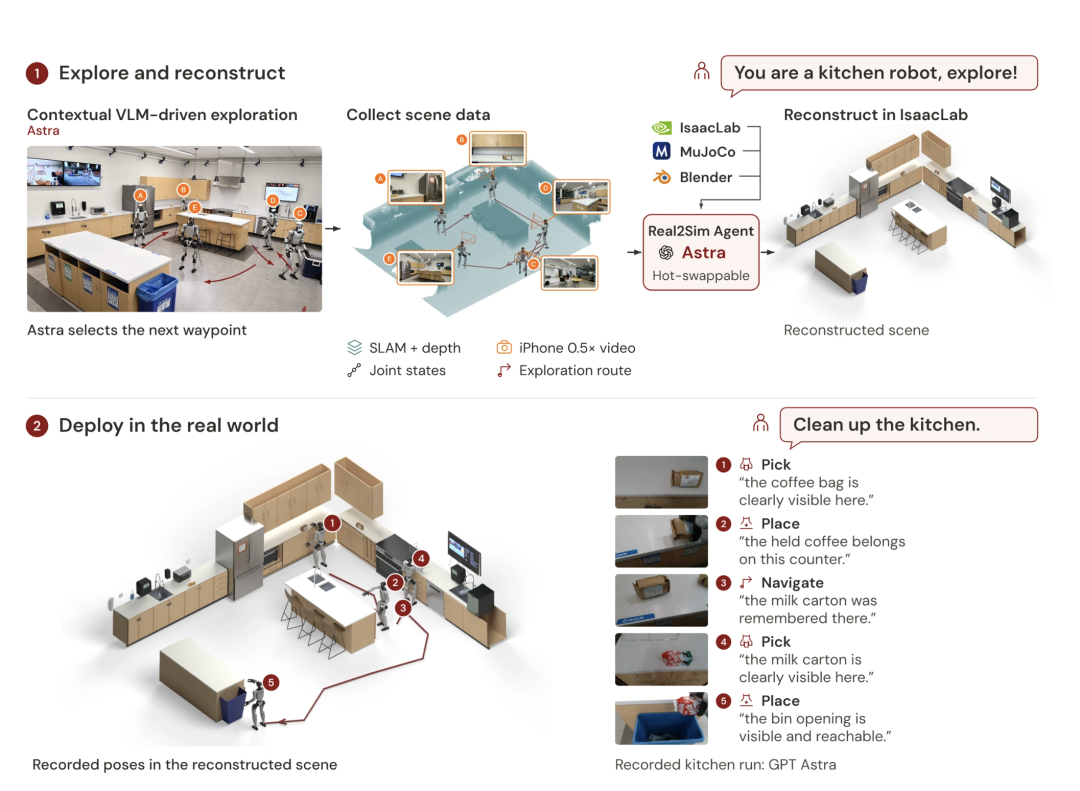
探索未知房间
        ↓
收集第一视角观察结果 + SLAM + 姿态
        ↓
使用 Real2Sim 建立数字孪生
        ↓
对齐真实与仿真的坐标系
        ↓
保存空间观察结果
        ↓
接收日常指令
        ↓
GPT Astra 选择技能 + 目标
        ↓
本地机器人技术栈执行
        ↓
返回结果
        ↓
持续执行直至任务完成
这项研究演示令人印象深刻,但它并不等同于购买一台 G1、输入 API 密钥,就能得到一台家用机器人。
当前的 HomeBody 技术栈仍然需要大量机器人基础设施。
研究人员报告称,感知、运动规划和技能执行运行在一台配备 RTX 4090 GPU 的 Razer Blade 笔记本电脑上。
GPT Astra 远程运行,并将技能请求和目标发送到本地机器。
这意味着该架构分布在两个计算环境中:
远程前沿模型
→ 高层推理与技能选择

本地 RTX 4090 系统
→ 感知、几何、规划、技能与执行
项目还列出了若干实际成本与限制。
在完整工作流使用空间表示之前,必须先创建数字孪生。
这会增加准备时间。
远程前沿模型会在规划和 Real2Sim 工作期间被调用。
这会产生 API 费用。
Astra 并不会即时响应。
研究人员指出,在高层推理完成期间,不同技能之间会出现停顿。
对于家务任务而言,这些停顿很重要,因为物理任务本身就比纯数字任务耗时更长。
长时间运行的人形机器人操作还会受到机械限制。
HomeBody 页面特别提到,长时间运行期间可能出现手指舵机过热。
机器人只能执行当前手部、触达范围、平衡能力、感知能力和已实现技能所支持的任务。
因此,该项目是长时序自主性的研究演示,而不是已经能够处理任意家务的通用家庭助理。
HomeBody 处于将前沿模型连接到物理机器人的更广泛浪潮之中。
原文重点介绍了三种日益常见的方法。
在类似 RoboCurve 的设置中,模型接收图像和机器人状态,然后调用指定以下目标的工具:
底层逆运动学或控制技术栈会将这些目标转换为机器人运动。
模型仍然处于频繁的观察—决策—行动循环中。
第二种方法使用前沿语言/视觉模型进行较慢的高层推理,并使用学习型 VLA 生成动作。
概念上如下:
VLM 规划器
→ VLA 动作模型
→ 底层控制器
这种方式让前沿模型继续处于电机层之上,同时使用学习型策略将计划转换为物理动作。
HomeBody 采用了不同的路径。
它去除了中间的学习型 VLA 要求,而是让前沿 VLM 直接调用可复用技能。
这些技能本身可以是经典算法、学习型策略或其他控制器。
HomeBody 项目明确支持通过共享接口添加新技能。
这使架构保持模块化:
替换 VLM
或
添加新技能
而无需重新设计整个机器人技术栈
更深层的理念并不只是“增加另一个 System 0 层”。
它改变了推理与物理执行之间的连接方式。
再结合空间记忆,这种连接让机器人能够跨越整个房间工作,而不只是围绕一张桌面工作。
原文最后考察了 RoboCurve 发布的第三方机器人控制评测结果。
这些结果应被理解为特定任务下的机器人基准测试数据,而不是关于模型整体智能水平的普遍结论。
在 Jay Chooi 分享的 RoboCurve 结果中,据报告,GPT-6 Sol 在机器人任务集上的得分约为 GPT-5.6 Sol 的 1.6 倍,而每次试验的成本约低 47%。
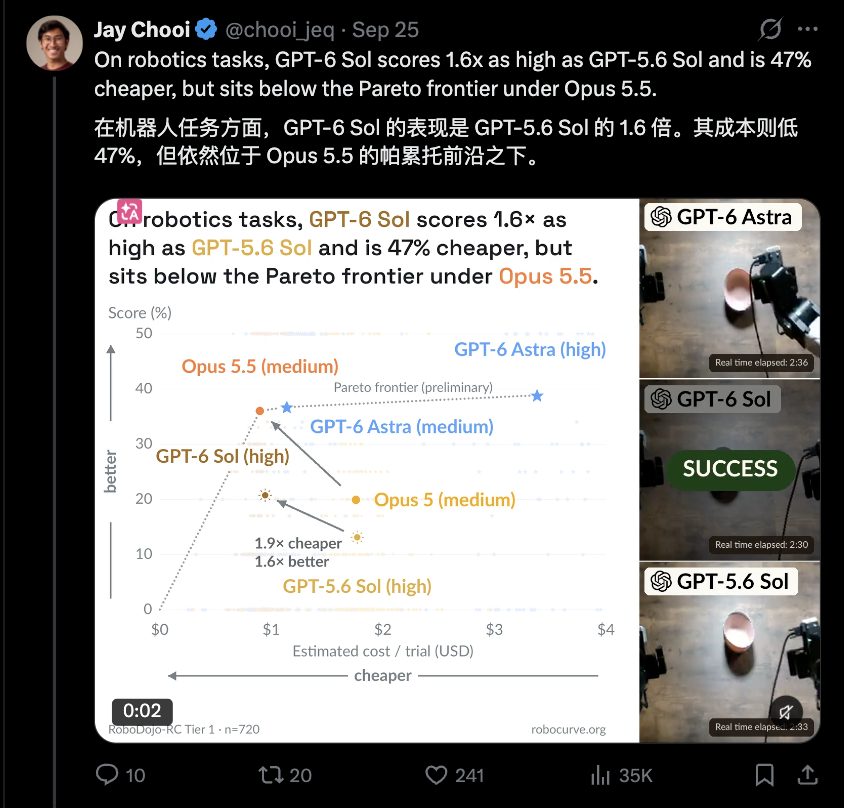
同一张图表还显示,在该评测中,GPT-6 Sol 的表现低于由更强的 Opus 5.5 配置建立的初步帕累托前沿。
这说明成本与机器人控制性能并不总是同步变化。
即使另一个模型仍然取得更高分数,成本更低的模型也可能是更好的运营选择。
另一项 RoboCurve 结果涵盖了 360 次机器人试验。
报告中的平均结果显示,Opus 5.5 的得分约为 Opus 5 的 1.8 倍,成本约为其一半;与此同时,它的平均得分与 Astra 大致相当,但成本约低 21%。
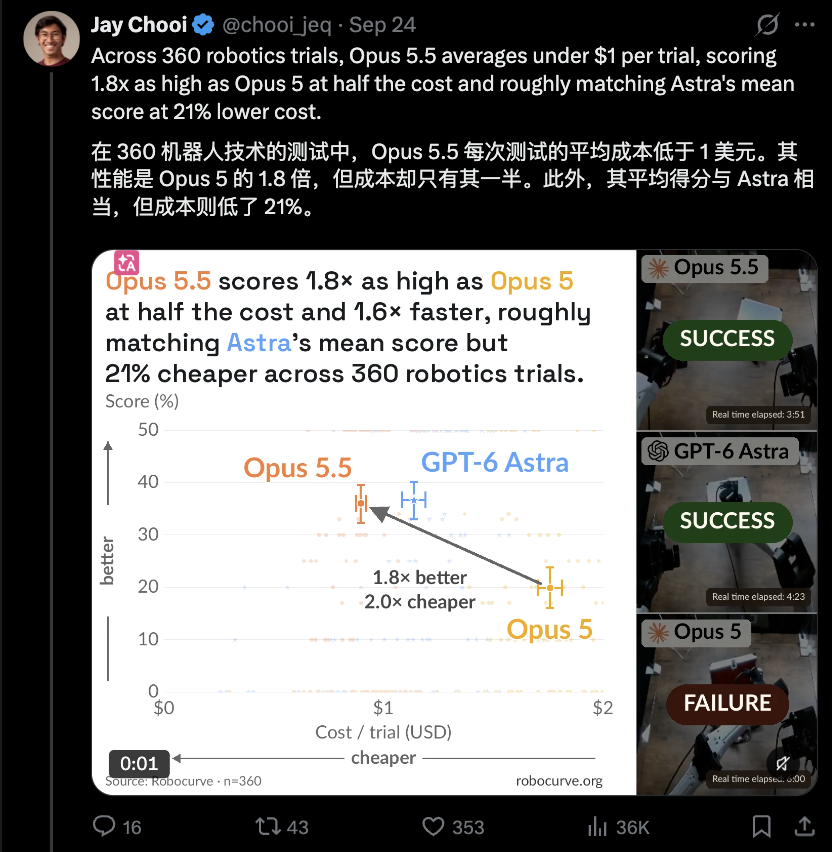
同样需要强调,这并不是 Anthropic 或 OpenAI 的通用基准测试。
这是由第三方开展的机器人控制评测,覆盖特定任务、硬件、提示词和试验条件。
这一点很重要,因为具身智能的表现取决于整个系统:
模型
×
提示词
×
机器人硬件
×
感知
×
控制技术栈
×
技能设计
×
任务定义
在编码基准测试中表现最好的模型,不一定是在控制机器人时具有最佳成本性能比的模型。
HomeBody 最有趣的地方,并不只是人形机器人移动了一个咖啡袋。
多年来,机器人一直在操作物体。
真正重要的是架构上的变化。
HomeBody 展示了一种切实可行的组合方式,将以下能力结合起来:
前沿模型不需要学习每一个电机细节。
机器人也不需要针对每个厨房重新训练新的端到端策略。
相反,一个通用模型在结构化环境上进行推理,并编排可复用能力。
这类似于软件智能体日益采用的工作方式:
模型进行推理
→ 调用工具
→ 读取结果
→ 选择下一个工具
HomeBody 将同样的模式带入了物理世界。
工具不再是网页搜索、Python 或数据库。
它们变成了:
导航
抓取
放置
打开抽屉
从抽屉中取物
这正是该项目对于具身智能体而言像是重要一步的原因。
HomeBody 是斯坦福大学与加州理工学院的一个研究系统,为人形机器人提供持久化空间记忆和可组合的运动技能库。前沿视觉语言模型负责规划长时序任务,并通过结构化工具接口调用这些技能。
不会。HomeBody 项目页面将规划器称为 GPT Astra,并将其作为高层 System 2 模型使用。导航、操作、感知、运动规划、重试和全身控制由底层机器人模块与预训练控制器负责。
研究人员表示,演示中的未知厨房不需要特定环境训练数据或额外的策略学习。不过,系统仍然依赖预训练感知模型、可复用技能、SLAM、规划软件以及预训练的 AMO 全身控制器。
在探索期间,HomeBody 会将第一视角摄像头观察结果、语义内容和位置保存在共享空间坐标系中。当后续请求涉及视野外物体时,GPT Astra 可以回忆保存的关键帧,并导航回记忆中的位置。
Real2Sim 阶段为高层规划器提供房间的结构化空间模型。HomeBody 还使用经过测量的 SLAM 几何信息校准重建结果,使导航和操作决策建立在真实尺寸上,而不仅仅是视觉外观上。
项目报告称,本地技能、感知和运动规划运行在配备 RTX 4090 GPU 的 Razer Blade 笔记本电脑上,而 GPT Astra 远程运行。当前设置还需要人形机器人硬件、摄像头、LiDAR/SLAM 组件、网络连接以及项目的机器人软件技术栈。
没有。该项目展示了有意义的长时序自主能力,但其自身列出的限制包括 Real2Sim 设置时间、API 成本、推理延迟、操作限制,以及手指舵机过热等硬件续航问题。
不是。原文讨论的数据来自独立第三方评测机构 RoboCurve,并且只适用于其机器人任务集和试验条件。不能将这些数据泛化为脱离该上下文的整体模型排名。
HomeBody 展示了前沿模型如何成为人形机器人的高层规划器,而不必直接生成每一个底层电机指令。GPT Astra 探索未知房间,利用 Real2Sim 重建和持久化空间记忆,然后组合导航与操作技能,完成长时序厨房任务。
其关键设计选择是模块化。模型决定下一步做什么,而感知、几何、运动规划、局部重试和全身控制决定机器人在物理上如何执行。这让系统能够进入新的厨房,而不必训练新的特定环境动作策略,同时仍然依赖大量预训练和工程化机器人基础设施。
当前实现仍然是研究系统,而不是即插即用的家用机器人:它需要 RTX 4090 级别的本地机器、远程模型推理、仿真设置、API 访问权限以及可靠的机器人硬件。研究人员还记录了在长时序现实任务中仍然重要的延迟与续航限制。
真正重要的进步并不只是“GPT 可以控制机器人”,而是通用模型现在能够利用空间记忆和可复用的物理技能,就像软件智能体使用工具一样。
從一句話開始,幾分鐘內拿到完整網站。



