For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/gpt-6-pro-parallel-agents-in-chatgpt-setu-69606eac.md.
ChatGPT 於 10 月 16 日推出的 GPT-6 Pro 更新,新增讓多個代理處理任務不同部分的方式。使用者可以在對話中查看代理進度,並開啟已完成的任務,檢查各代理產出的結果。
ChatGPT 於 10 月 16 日推出的 GPT-6 Pro 更新,新增讓多個代理處理任務不同部分的方式。使用者可以在對話中查看代理進度,並開啟已完成的任務,檢查各代理產出的結果。
OpenAI 也宣布回應速度更快,以及外掛程式和工具使用能力獲得改善。但在該公告中,OpenAI 沒有公布量化的速度提升幅度、代理數量上限,也沒有完整說明結果合併機制。
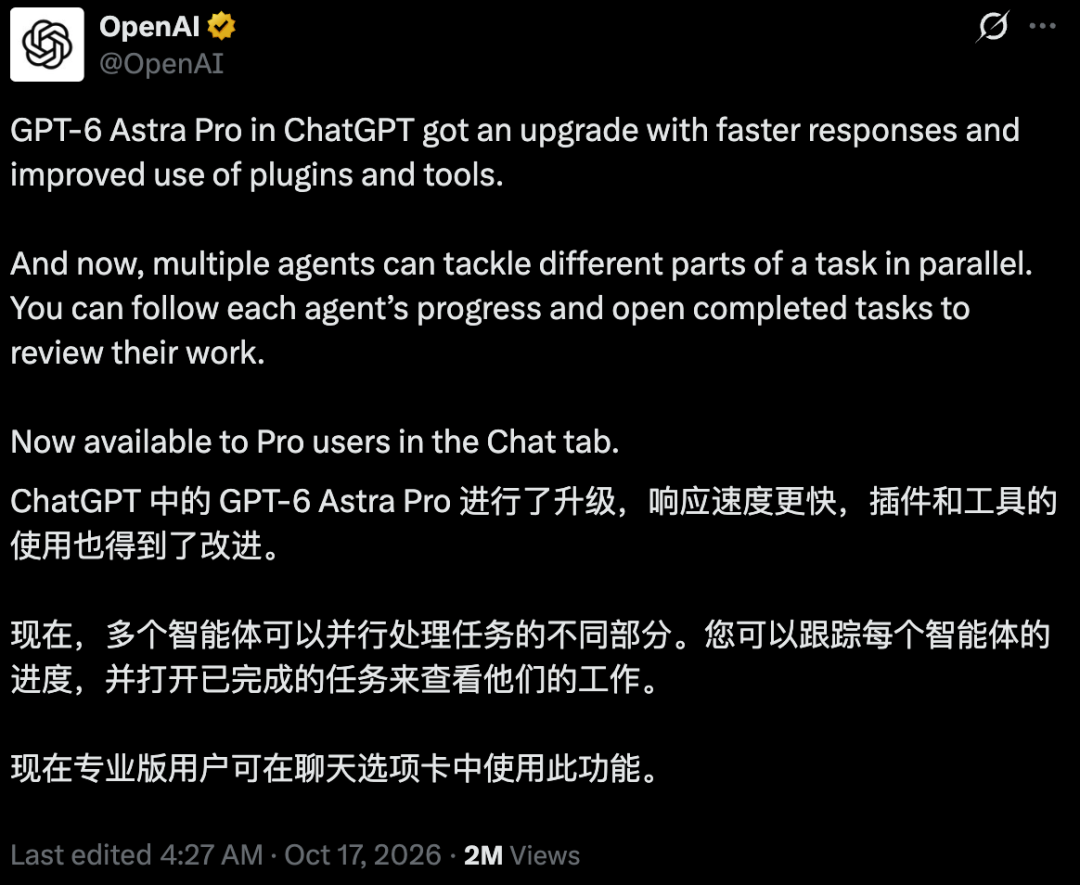
這項更新正向符合資格的 Pro 使用者推出。受管理工作區中的可用性,取決於設定與推出資格。可以使用多個代理,並不代表每項任務都會更快完成:使用者仍需要判斷合併後的結果。
來源描述的選擇路徑如下:
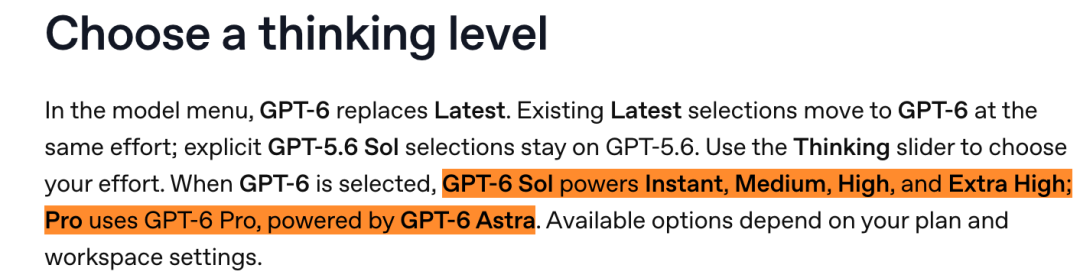
對 GPT-6 而言,從 Instant 到 Extra High 的設定使用 Sol,而 Pro 則使用由 Astra 驅動的 GPT-6 Pro。可用設定取決於方案與工作區存取權限。更新公告沒有說明能保證觸發特定代理數量的提示詞語法。
第一項是回應速度。「更快」是公告中所述的改善,但來源沒有提供受控的更新前後完成時間測量。
第二項是工具使用。模型通常需要搜尋、檢查檔案,或與外部服務互動,才能完成工作。更好的工具處理能力可能減少失敗呼叫與停滯迴圈,但個別使用者對迴圈問題的抱怨,並不能衡量這項更新的實際成效。
外部服務仍需要相應的帳戶連線與權限。委派工作本身不會授權模型存取新的系統。
第三項是平行工作。以三項產品的比較為例,任務可以先拆分為彼此獨立的調查,再依據價格、功能與限制整合研究結果。相較之下,閱讀文件、根據文件選擇方案,再依照該方案編輯檔案,則屬於相互依賴的階段。
來源提供了一個由研究產出產品需求文件和任務工單的使用者案例。這是一種具有潛力的工作流程:一項成果成為下一個階段的輸入。
其他使用者則指出了管理成本。如果每個代理都回傳一份冗長且格式不同的報告,使用者可能會把原本省下的等待時間,花在整合各項輸出上。進度指示器可以顯示工作正在進行,但不能證明結果正確。
開始之前,先定義何謂完成:需要回答的問題、日期範圍、所需來源,以及交付格式。能將證據與結論建立關聯的結果,比僅僅宣告成功的結果更容易檢查。
報告接著將這項更新與 Anthropic 的 Research 系統進行比較。Anthropic 於 2025 年 6 月發布的工程說明,描述了一個負責規劃研究、委派獨立搜尋、綜合回傳結果,並設有獨立引用階段的協調器。
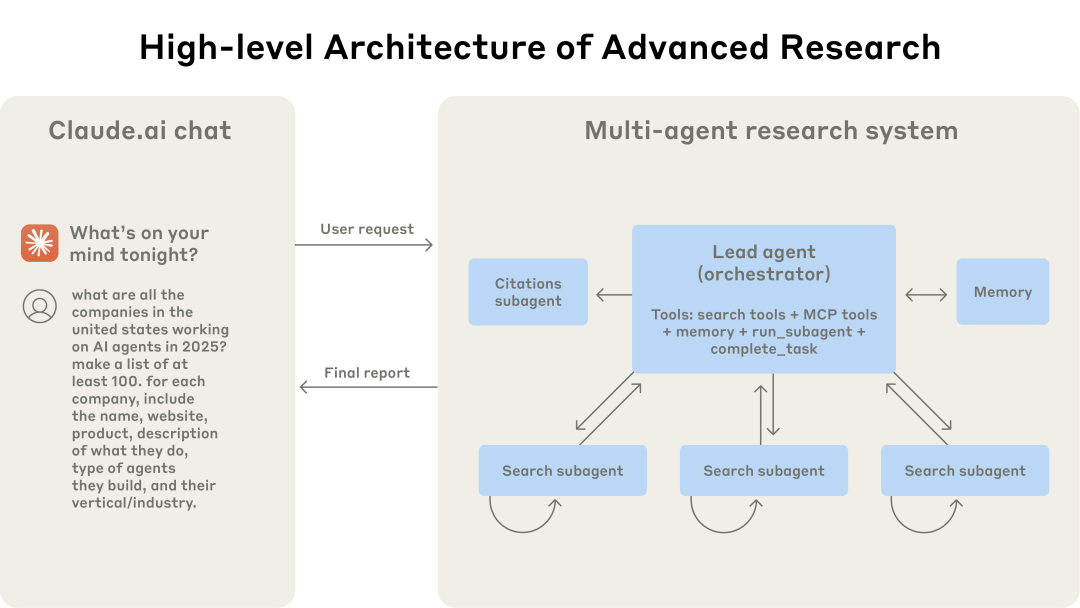
這種設計特別適合包含多個獨立研究方向的廣泛問題。Anthropic 也強調,更多代理會消耗更多 Token,而高度相依的工作可能不適合這種方式。
來源將比較延伸至 Claude Code Projects 和 Managed Agents 動態工作流程。來源引用了一項由公司進行的找錯示範:在 116,000 行程式碼中植入 70 個錯誤,單一代理執行時分別找出 14、15 和 27 個錯誤;動態工作流程執行時則每次都找出 66 個。這些是該設定下的回報結果,不代表普遍保證,也不是與 ChatGPT 新功能的直接比較。
不同系統會提供不同的委派方式、專案脈絡保存方式與背景工作執行方式。它們都使用多個代理,並不代表其存取權限、授權方式或執行時行為完全相同。
Anthropic 描述了一次早期的委派失敗案例:兩個代理調查重疊的最新資訊,而另一個代理研究不同年份的資料。問題在於任務邊界不夠具體。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
一份實用的委派簡報,應明確說明目標、來源、範圍與輸出格式,也應告訴每個工作者哪些內容屬於其他任務。缺乏這些邊界時,平行活動可能重複搜尋,也可能留下重要缺口。
合併結果同樣需要仔細處理。產品價格必須採用一致的計費週期與日期;研究結論必須區分互相衝突的證據;程式碼變更則必須在介面與命名上保持一致。即使兩項變更單獨看起來都合理,兩個代理修改同一個檔案仍可能造成衝突。
小型任務可能不值得投入設定與交接成本。當工作依賴前面的決策,或需要降低瀏覽器分頁等資源使用量時,採用循序方式通常更合適。
報告區分了 Work 或 Codex 中的 Astra 存取權,以及 Chat 中的 GPT-6 Pro 存取權。在其他體驗中擁有 Astra Plus 存取權,並不能證明使用者符合這項 Chat 功能的資格。
報告也區分了 Chat Pro 模型額度與 Work、Codex 的使用額度池。轉載的說明資訊指出,Pro 200 美元方案有每週 GPT-6 Pro 使用上限,而 Pro 100 美元方案則有共用的每週 Pro 模型使用額度。這些規則可能隨時間變化;規劃工作量前,應查看連結的官方模型文章與帳戶自身顯示的通知。
關於 Codex 額度突然下降的個人案例,不能用來證明 Chat 的平行代理工作如何計量。公告沒有提供按代理計費的公式。同樣地,付費 Pro 訂閱也不應被解讀為所有 Pro 模型都能無限使用。
有用的比較方式,是衡量取得可接受結果所需的總投入。應將協調成本、重複工具呼叫、消耗的使用額度,以及人員修正遺漏或不一致內容所花的時間納入考量。
對於研究工作,應檢查證據覆蓋範圍,以及結論是否與證據相符。對於程式碼,應檢查實際行為並執行適當的驗證。當輸出符合任務要求時,任務才算完成,而不只是每個代理都顯示完成狀態。
它可以讓多個代理處理任務的不同部分,同時讓使用者在對話中查看進度。已完成的任務可以開啟檢查。
在符合資格的帳戶中,於 Chat 中選擇 GPT-6,並在 Thinking 滑桿上選擇 Pro。如果選項不存在,方案存取權、工作區設定或功能推出狀態可能是原因。
彼此獨立的研究方向可以受益於並行工作。相互依賴的步驟、小型任務,以及涉及共用檔案的編輯,可能產生高於節省時間的協調成本。
目前檢視的更新公告沒有說明數量上限,也沒有發布能保證特定請求會觸發多少代理的規則。
來源與相關模型說明列出了適用的使用額度。使用者應查看相關體驗的限制通知,不應假設 Chat、Work 與 Codex 採用完全相同的限制。
完成狀態代表任務已回傳結果。使用者仍需根據要求驗證來源、檔案與結論,尤其是在必須合併多項輸出時。
GPT-6 Pro 的更新結合了平行工作、可見進度與可檢查的輸出。同時,更新也宣布回應速度與工具使用能力有所改善,但沒有公布完整的效能或計費細節。
只有在輸出準確、彼此相容且容易檢查時,良好的委派才能真正減少等待時間。
從一句話開始,幾分鐘內拿到完整網站。



