For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness²(也寫作 Harness2)探索了一種實用的遞迴改進形式:在語言模型權重保持不變的情況下,修改模型周圍的軟體。其可編輯的執行環境包括提示詞、防護規則、記憶、技能、工具指引、腳本、子代理與中介軟體。
Harness²(也寫作 Harness2)探索了一種實用的遞迴改進形式:在語言模型權重保持不變的情況下,修改模型周圍的軟體。其可編輯的執行環境包括提示詞、防護規則、記憶、技能、工具指引、腳本、子代理與中介軟體。
這項研究來自 Google Cloud AI Research 與 Northwestern University。系統不會在每次失敗後重新訓練模型,而是研究代理的執行過程、測試其執行框架的變更,並保留哪些變更有效的證據。
作者報告指出,在 OpenCode 環境下,一次改進步驟可將 GLM-5 的 WorkBuddy-Bench 平均分數從 64.2 提高至 75.7。這是在特定評估中的 11.5 分提升,並不代表任何模型或應用程式都一定能獲得相同改進。
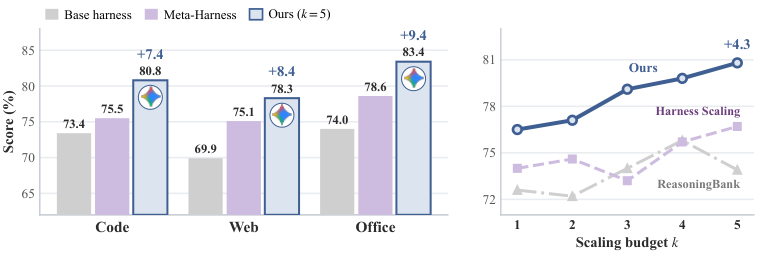
研究團隊圖表,轉載自 QbitAI/BAAI 報告。
這項工作的動機來自兩個問題。
Harness2 將目前的執行框架與改進執行框架的流程分開。後續任務會從共用的基礎執行框架開始;改進器會選擇性地取用過往證據,而不是盲目沿用先前的所有規則。
系統首先使用初始執行框架記錄一份參考執行結果,接著利用該追蹤記錄找出弱點並測試可能的修復方案。
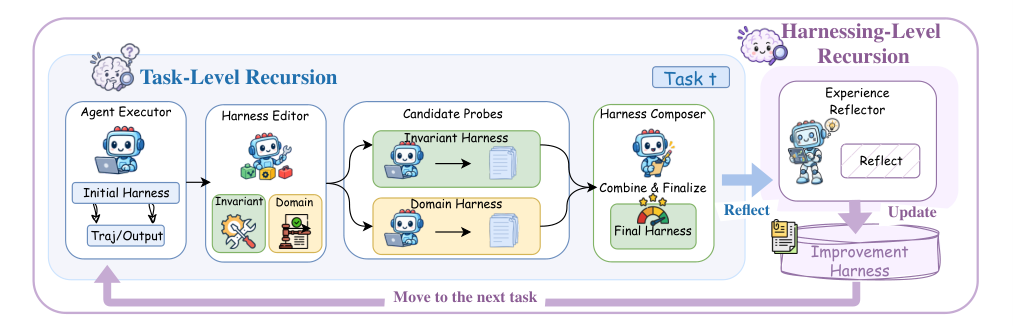
改進步驟分為三個階段:
在適應過程中,當無法取得真實答案回饋時,行為比較可作為替代方案。它並不是判斷最終正確性的萬無一失方法。在評估方法是否有效時,外部基準測試仍然十分重要。
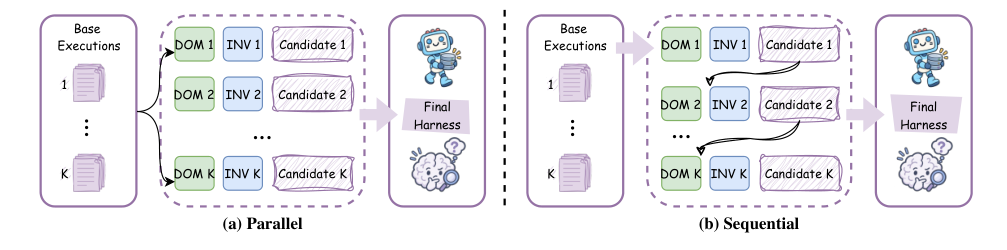
這種方法可以透過平行遞迴進行更廣泛的探索,也可以透過序列遞迴進行連續修訂。在平行預算 k 下,系統會探測 k 個通用候選方案與 k 個領域候選方案,然後產生 k 個組合結果。候選方案越多,所需的計算量也越大。
任務完成後,經驗反思器會檢查參考追蹤記錄、提出的編輯內容、探測證據與組合決策。它會記錄可重複使用的元件與經驗,包括 EXPERIENCE.md 中的備註。
下一個任務會取得基礎執行框架,但編輯流程可以檢索這些先前的經驗。持續保留的是關於某個修復何時有用的知識,而不是假設上一個任務的完整配置應永久沿用。
模型參數保持不變。這是透過檔案與執行證據進行的執行環境適應,而不是自主訓練模型權重的展示。
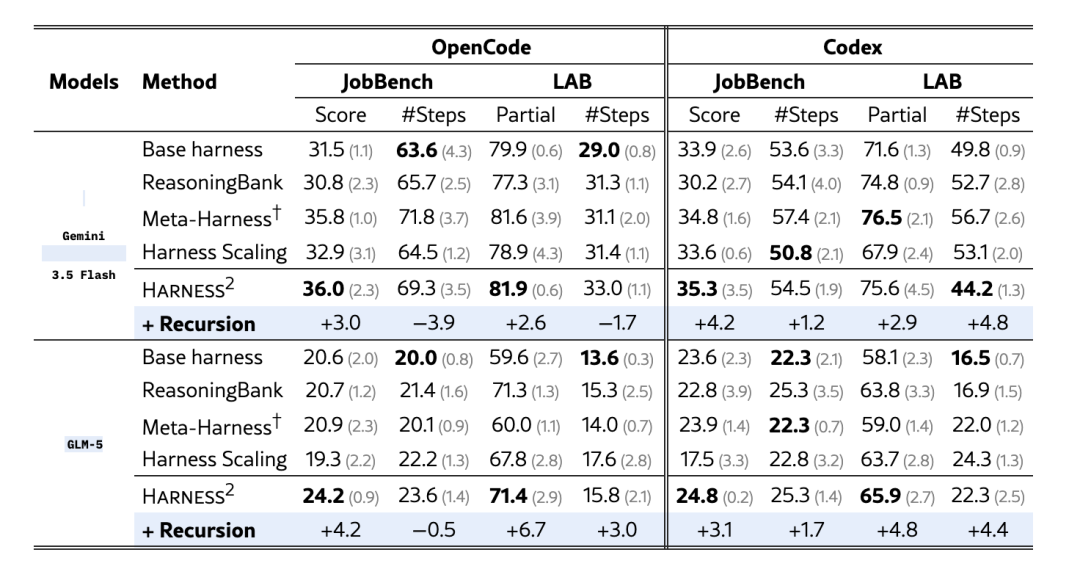
該研究評估了 WorkBuddy-Bench 的程式、網頁與辦公室交付成果、JobBench 的專業任務,以及 Harvey 的 Legal Agent Benchmark。研究使用 GLM-5 與 Gemini 3.5 Flash,並以 OpenCode 和 Codex 作為執行框架。
預設編輯器是在 OpenCode 上執行的 Claude Opus 4.8。因此,主要結果涉及圍繞執行器建立的改進系統;不應將其描述為執行器本身免費獲得的能力提升。
| 執行器模型 | 初始執行框架 | WorkBuddy 基礎平均分 | 一次 Harness2 步驟 | 提升 |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64.2 | 75.7 | 11.5 分 |
| GLM-5 | Codex | 64.4 | 75.3 | 10.9 分 |
| Gemini 3.5 Flash | OpenCode | 72.4 | 77.5 | 5.1 分 |
| Gemini 3.5 Flash | Codex | 74.5 | 77.5 | 3.0 分 |
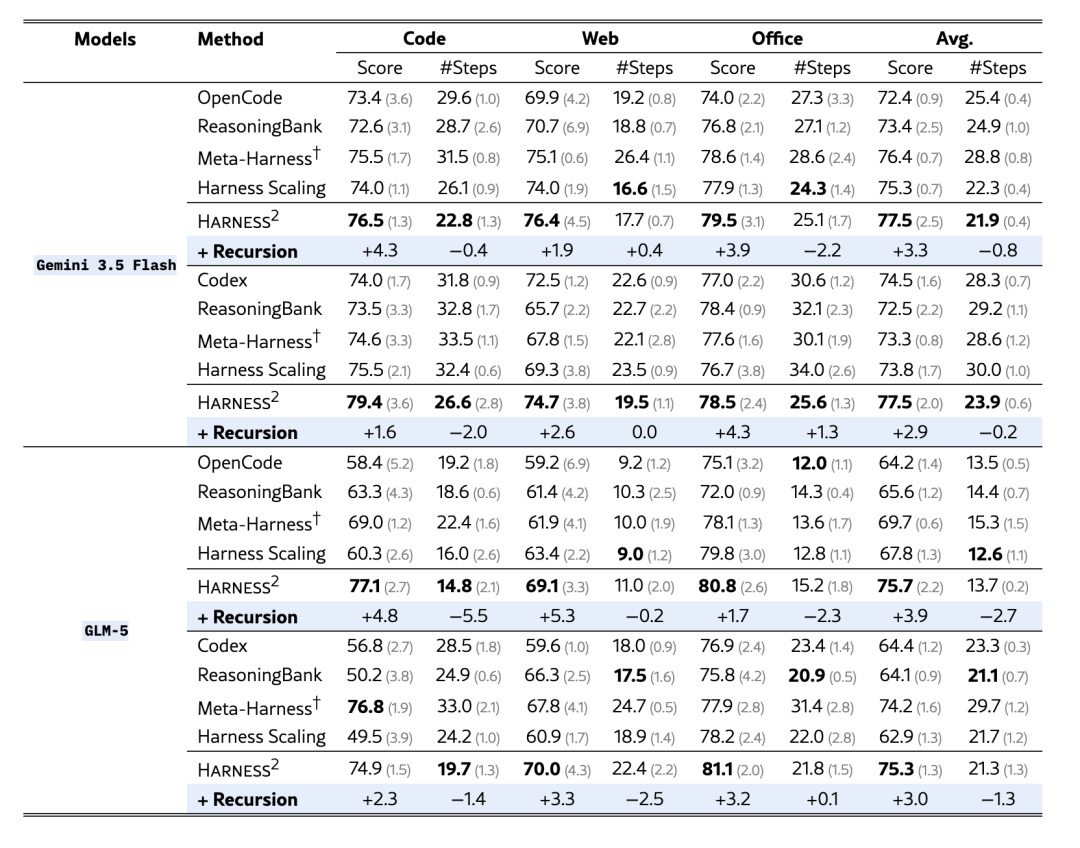
在這項比較中,採用改進執行框架的 GLM-5 超過了相應未修改 Gemini 基準線。這說明執行環境設計可能影響模型排名,但不代表 GLM-5 在所有任務上都更強。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
論文報告指出,JobBench 的單步提升最高達 4.5 分,LAB Partial 的提升最高達 11.8 個百分點;其中 Partial 指每項標準的通過率。Partial 與滿足所有標準的任務占比不同。
將平行預算提高至 k=5,相較於一次步驟,最多可額外增加 3.9 個 WorkBuddy 分數、4.2 個 JobBench 分數,以及 6.7 個 LAB Partial 百分點。主要表格報告了三次執行、任務順序經過打亂後的平均值與標準差。
轉移實驗同樣具有參考價值。在 JobBench 上累積的經驗庫,可在不為該比較增加額外探測的情況下,將 WorkBuddy 的單步改進幅度提高 0.6 分(程式)、0.5 分(網頁)與 2.9 分(辦公室)。
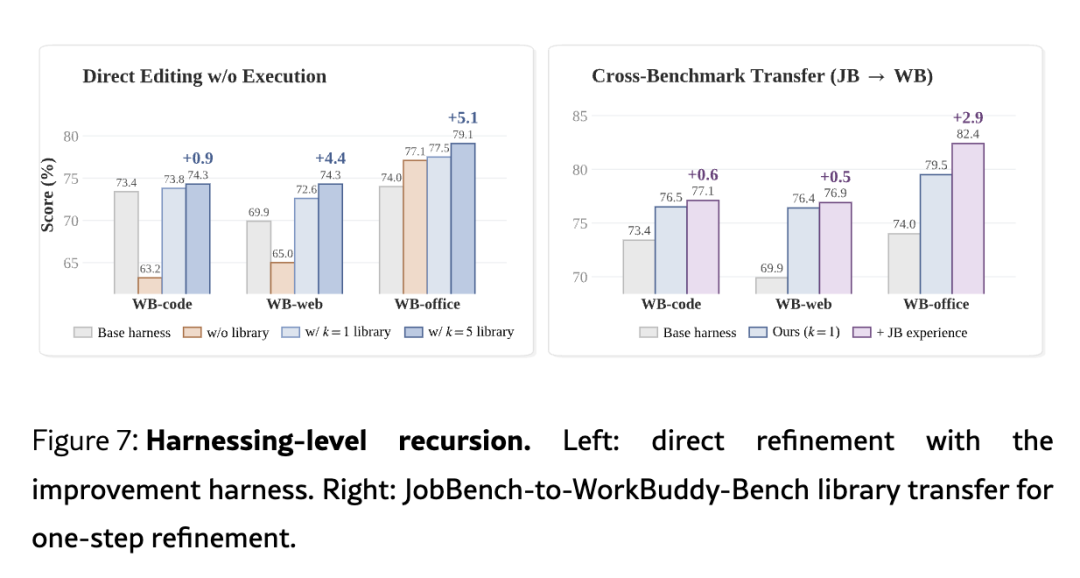
這些結果支持有選擇地重複使用改進經驗。但它們並未證明每條累積規則都能轉移,也沒有消除在實際任務分布上檢查採用的執行框架之必要。
論文列出九位作者:Ruiyao Xu、Yanfei Chen、Zhongying CuiZhu、Bhavana Dalvi Mishra、Yifei Ming、Han Yu、Rujun Han、Chen-Yu Lee 與 Tomas Pfister。來源資料介紹了 Northwestern 的博士生 Xu,以及 Google Cloud 研究人員 Chen 和 CuiZhu。
公開儲存庫支援兩種執行框架與兩種遞迴模式。其指定使用 Linux、Python 3.12 與 uv;以模型為基礎的基準測試還需要額外依賴套件與 API 費用。WorkBuddy 需要 Docker,而 LAB 需要 Pandoc 與 Poppler 等工具。
README 也提醒,執行器的網路存取不受限制,而且在該配置中 Codex 的執行沙箱已停用。基準測試使用者必須在評估結果前,針對存取答案與評分規則設定限制。評估論文中的執行改進時,也必須將這些執行與評估條件一併納入考量。
它會修改語言模型周圍的執行環境,包括提示詞、工具、記憶與技能。底層模型權重保持不變。
任務層級遞迴會針對目前任務測試並組合修復方案。執行框架層級遞迴則保留證據與可重複使用的經驗,以改進後續的編輯決策。
它的適應方法使用執行追蹤記錄之間的對比,而不是依賴真實答案驗證器。這使系統在缺少標籤時仍能取得證據,但不保證產出的成果正確。
不適用。這是研究中 GLM-5/OpenCode WorkBuddy 平均提升幅度的報告結果。其他模型、執行框架與基準測試組合會有不同的提升幅度。
會增加候選方案執行與改進工作的成本。論文會將效能與總計算量一併分析,其中包括執行與改進所使用的 token 數量。
儲存庫列出 WorkBuddy-Bench 需要 Docker。其本機確定性示範與其他基準測試有不同要求,因此應遵循所選工作流程的說明。
Harness2 將針對任務的實驗,與改進代理執行環境的經驗庫結合起來。其報告中的提升結果顯示,即使模型權重保持不變,提示詞、工具處理方式與執行結構仍可能實質改變結果。
證據支持在經過測試的條件下改進執行框架工程,但計算量、驗證與轉移限制仍必須清楚呈現。
從一句話開始,幾分鐘內拿到完整網站。



