For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/infinihand-streaming-3d-hand-motion-from-53c55163.md.
頭戴式相機能記錄人們如何操作物體,但要將這些錄影轉化為實用的 3D 動作資料並不容易。手部會移動、相機也會移動、手指會被物體遮擋,而且雙手可能彼此遮蔽。
頭戴式相機能記錄人們如何操作物體,但要將這些錄影轉化為實用的 3D 動作資料並不容易。手部會移動、相機也會移動、手指會被物體遮擋,而且雙手可能彼此遮蔽。
InfiniHand 在一個串流式框架中結合手部定位、精細手部重建與相機動作估計。其目標是將連續的手部姿態放置於共用的世界座標系統中,使這些動作更適合大規模標註,以及潛在的具身學習工作流程。
這項工作來自隸屬於上海人工智慧實驗室、上海交通大學及其他多所大學的研究人員。其專案頁面提供同步視覺比較與 3D 動作檢視器。
裁切後的手部影像有助於辨識手指關節活動,但其中包含的手部在周邊場景中所處位置資訊有限。同樣地,影像中的位移可能源自手部移動、頭部轉動,或兩者同時發生。
傳統流程通常會結合手部偵測器、姿態估計器、相機追蹤系統與對齊階段。任何一個階段的錯誤都可能傳遞:遺漏手部會改變重建結果,而不準確的相機路徑則會改變表面上的全域動作。
InfiniHand 在這些任務之間共享幾何脈絡。預訓練的 LingBot-Map 主幹網路會擷取全影格特徵,以支援左右手定位。手部重建元件則將這些特徵與以手部為中心的外觀資訊結合,以恢復更細緻的關節活動。
其手部表示使用 MANO 參數描述姿態、形狀與方向。輔助的 2D 關鍵點監督有助於約束預測的 3D 手部如何投影回影像中。接著,相機估計結果使重建手部能在不同時間點以同一個世界座標框架表示。
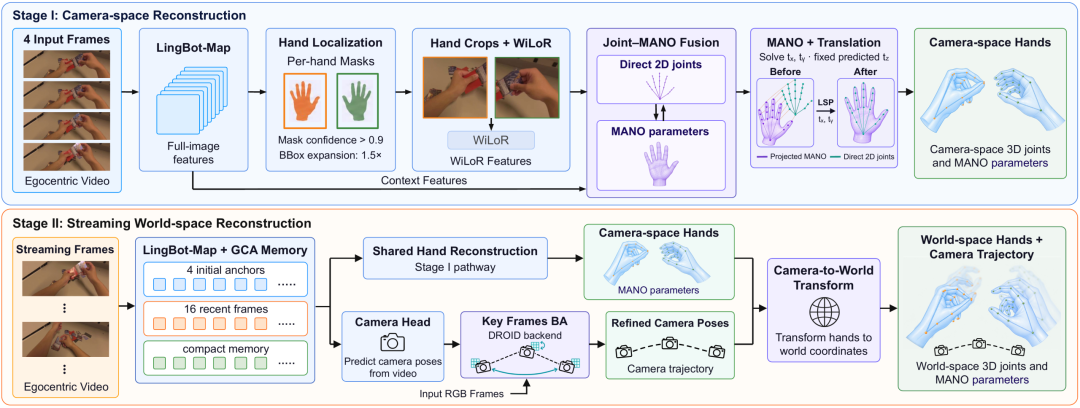
InfiniHand 方法示意圖,重製自 QbitAI/BAAI 報導。
研究人員從九個資料集蒐集約 5,000 小時的公開第一人稱影片,其中包括 ARCTIC、HOT3D 與 EgoDex。整合這些來源不只是將檔案串接起來:手部順序、座標慣例與標註類型都可能不同。
前處理流程會標準化可取得的影像、手部參數、關節、遮罩與邊界框。在可行的情況下,系統會從 3D 關節擬合缺失的 MANO 參數。具有相機軌跡的序列也能提供世界空間監督。
標註品質是另一項考量。團隊使用 Sapiens 2 預測 2D 手部關鍵點,並將其與原始標註投影至影像中的結果進行比較。持續存在的不一致可能代表錯誤關聯、不佳投影或不合理的姿態。
根據論文,這個流程會移除約 30–40% 的候選訓練資料,並將不確定案例保留供人工檢查。圖中描述的是候選資料清理流程;不應以此推斷作者未在此提供的精確保留小時數。
訓練接著分為兩個階段:
這樣的安排讓標註覆蓋程度不同的資料集,能對模型中其可監督的部分作出貢獻。
InfiniHand 以時間視窗處理輸入影片,同時保留幾何記憶。其脈絡包含初始參考資訊、近期的細節特徵,以及由較早觀測結果壓縮而成的資訊。
實作上會重疊兩項預測任務:一個工作程序會透過主幹網路處理即將到來的視窗,另一個則為前一個視窗解碼手部與相機預測。重複使用特徵並減少閒置時間,有助於提升吞吐量。
論文報告的預測吞吐量為 11.19 FPS,相較於 HaWoR 的 5.48 FPS,在其報告的比較條件下提升 2.04 倍。這並非宣稱在 30 FPS 下具有普遍即時運作能力,也不保證在任意硬體上的速度。
對於較長序列,另一個工作程序會執行稀疏束調整,以細化相機軌跡。二元關鍵影格池會保留近期觀測結果,以及選取的較早影格。該背景最佳化除了已報告的預測吞吐量外,還會帶來額外的運算成本。
相機空間評估涵蓋 34 個 ARCTIC 場景、10 個 HOT3D 場景、166 個 HOI4D 場景及 100 個 EgoDex 場景。研究人員將其與多種既有重建方法比較。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
報告特別指出 PA-p,這是一項結合姿態誤差與漏檢懲罰的指標。在報告的比較中,數值越低越好:
| 資料集與指標 | 比較方法 | InfiniHand | 報告的降低幅度 |
|---|---|---|---|
| ARCTIC PA-p | ViDiHand:9.82 mm | 7.72 mm | 21.4% |
| EgoDex PA-p | ViDiHand:17.22 mm | 7.29 mm | 57.7% |
| EgoDex 世界空間 W-MPJPE | Dyn-HaMR:78.41 mm | 28.77 mm | 63.3% |
這些列涉及不同的資料集與指標;不應將其平均為單一準確度主張。InfiniHand 也報告,在 ARCTIC、HOT3D 與 EgoDex 上,在所比較的方法中具有最低的 W-MPJPE。
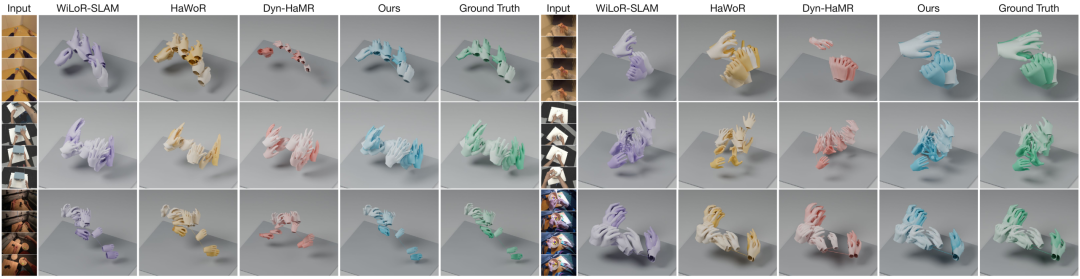
對齊後的定性比較:藍色代表 InfiniHand,綠色代表參考結果。對齊是視覺化的一部分,在解讀表面上的一致程度時應將此納入考量。
來源也討論了涉及遮擋與物體互動的自然場景 Ego4D 範例。一個展示的離線比較會為 InfiniHand 使用外部手部定位。讀者應將此設定與整合式模型本身的定位主張區分開來;互動式專案展示 提供了相關的視覺脈絡。
重建 3D 人體示範可協助準備靈巧操作、動作遷移與模仿學習研究所需的資料。將重建的手部資料轉化為機器人訓練資料,仍需要進行品質檢查,並適應機器人的實體結構。
作者指出數項限制。LingBot-Map 本身無法恢復公制尺度,因此需要輔助對齊模型,而這可能引入誤差。快速視角變化、嚴重遮擋與間歇性的手部可見性仍然困難,因為合適的訓練資料有限。
單目監督也可能將隨時間變化的尺度漂移帶入訓練。稀疏細化有所幫助,但不會讓每條恢復出的軌跡都成為精確的物理量測。
它會從第一人稱影片估計手部位置、MANO 手部參數與相機軌跡。這些估計結果支援以共用世界座標系統表示的手部動作。
相機空間中的手部動作會隨相機移動而改變。共用的世界座標框架在考量移動視角後,能更容易比較不同影格之間的手部軌跡。
所提出的框架包含自己的定位元件。然而,來源指出一個離線定性範例使用了外部手部定位,因此讀者應確認每項展示比較的設定。
不是。這是在作者所報告評估條件下的預測吞吐量。背景稀疏束調整會產生額外工作量,效能也取決於執行設定。
研究人員將投影後的標註與基於影像的 2D 手部關鍵點預測進行比較,並排除持續存在不一致的序列。他們報告移除了約 30–40% 的候選資料,並將模糊案例保留供人工檢查。
論文提出的是重建與標註研究,而非經驗證的直接機器人控制系統。機器人應用仍需要重定向、物理約束與任務特定驗證。
InfiniHand 結合場景幾何、精細手部外觀與相機估計,從第一人稱影片恢復手部動作。其串流式設計與資料清理流程,針對大規模影片集合標註的實務挑戰而設計。
所報告的準確度與吞吐量提升是具有前景的研究結果,但在尺度恢復與背景細化方面有重要條件。輸出結果是有用的重建估計,但用於下游實體任務前仍需要驗證。
從一句話開始,幾分鐘內拿到完整網站。
