For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
短短几周内,TypeSafe AI 从相对不为人知的初创公司,跃升为 AI 基础设施领域最受关注的企业之一。
短短几周内,TypeSafe AI 从相对不为人知的初创公司,跃升为 AI 基础设施领域最受关注的企业之一。
该公司如今宣布完成 8.7 亿美元 A 轮融资,投后估值达到 75 亿美元。
无论在什么情况下,这都足以成为一则重要消息。但真正让这起事件与众不同的,是推动这一增长势头的产品:Jev。它并不试图成为聊天机器人,不生成长篇 prose,也不是主要为编写代码而设计。
它的任务更加聚焦。
它负责做决策。
典型的 Jev 请求更接近:
给定当前状态,
软件应该选择哪个选项?
而不是:
请为我撰写一份详细解释。
TypeSafe 将 Jev 称为 System One 模型:一种专为快速、受约束、结构化决策而设计的模型,软件可以直接使用其结果。
Jev 不返回自由格式文本,而是返回以下类型的结果:
这种聚焦让 Jev 的成本和速度都足以满足高调用量软件工作流的需求。在这些场景中,使用传统前沿大模型可能会带来不必要的延迟或成本。
而市场反应十分强烈。
TypeSafe AI 于 2024 年在旧金山成立。
在 Jev 发布之前,该公司大约花了两年时间处于隐身运营状态。
TypeSafe 的公开突破发生在 2026 年 9 月 15 日。当日,该公司推出了首个 System One 模型,并解释了其背后的训练方法:面向校准决策的强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)。
原始来源提到,TypeSafe 此前曾在 Jev 发布前后宣布完成 4,000 万美元种子轮融资。不到一个月后,该公司又宣布了规模大得多的 A 轮融资。
TypeSafe 的官方融资公告确认了以下信息:
| 项目 | 已确认详情 |
|---|---|
| A 轮融资 | 8.7 亿美元 |
| 投后估值 | 75 亿美元 |
| 领投方 | Andreessen Horowitz |
| 其他已披露参与方 | Sequoia Capital、DCVC、天使投资人 |
| 新增董事会成员 | Martin Casado |
公司表示,新资金将用于:
关键在于,投资人押注的不只是又一个通用前沿模型。
他们押注的是一种不同的模型类别。
Jev 的核心理念很简单:许多软件系统并不需要段落。
它们需要的是一个决策。
示例包括:
传统大语言模型可以回答这些问题,但通常会通过自回归文本生成来完成。
TypeSafe 认为,当应用程序已经知道答案的结构时,这种方式就显得低效。
Jev 的设计则更接近以下流程:
结构化状态
      ↓
类型化问题
      ↓
并行决策计算
      ↓
概率 + 受约束输出
      ↓
应用程序根据结果分支处理
TypeSafe 将其描述为“面向机器的”智能:模型经过优化,可以直接接入代码,而不是生成供人类阅读的语言。
TypeSafe 目前列出的 Jev 价格为:
输入:每 100 万个 token 收费 0.042 美元
输出:免费 / 不计量
这一价格远低于大多数通用前沿模型。
原因在于其架构。
Jev 不会逐个 token 地生成任意文本。TypeSafe 表示,其采样器能够并行返回某项决策的受约束输出。
公司声称,其服务的端到端延迟约为 70–500 毫秒,并表示,对于相应的 System One 任务,Jev 的速度可以达到 40–200 倍。
这些数据来自 TypeSafe 自行发布的评估,应理解为供应商针对 Jev 所设计任务形态提出的声明。
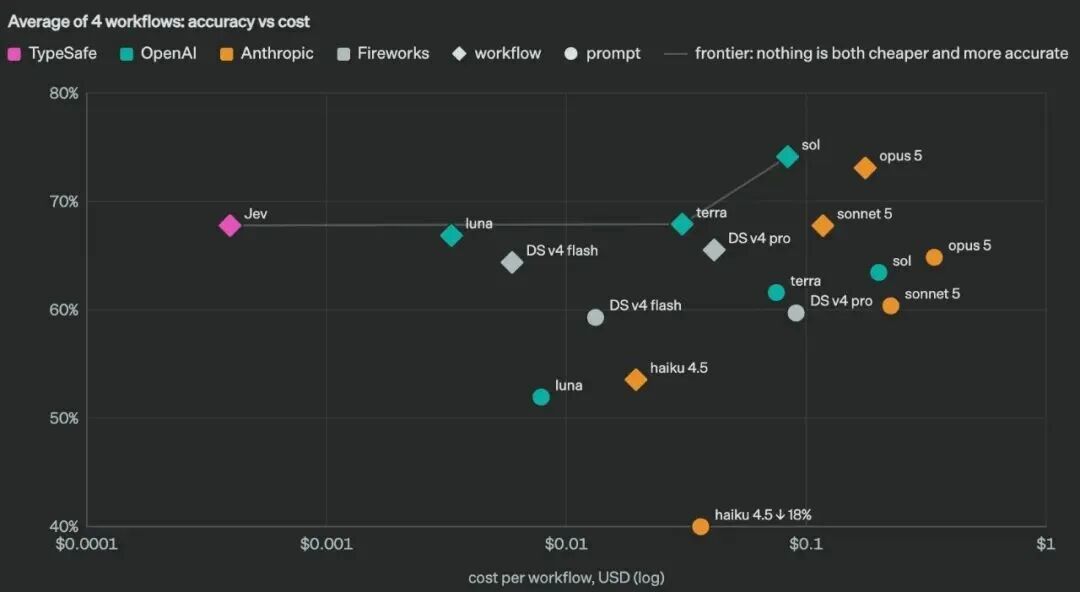
TypeSafe 最有力的主张之一,是 Jev 不会产生类型错误。
但这需要准确理解。
它的含义是:如果应用程序声明了一个受约束的输出架构,Jev 就会返回符合该输出契约的值。
例如:
允许的答案:
- 批准
- 审核
- 拒绝
Jev 不应该突然返回:
下面是一篇关于我的推理过程的五段式文章……
对于生产软件而言,这是一项重要的可靠性特征。
但类型安全 并不意味着语义决策始终正确。
模型可能返回一个有效的 reject 值,却仍然做出了错误的业务决策。
因此,Jev 还会返回概率和置信度信息,让应用程序能够定义如下阈值:
confidence >= 0.95
→ 自动处理

0.70 <= confidence < 0.95
→ 二次检查

confidence < 0.70
→ 人工审核
因此,模型的实用性同时取决于分类质量和校准水平。
原文中最有力的独立采用信号来自 Vercel。
Vercel 在 Jev 发布后不久将其加入 AI Gateway,并跟踪付费团队开始使用该模型的速度。
据 Vercel 称,Jev 在 24 小时内触达了近 13% 的付费团队。
当时,这一覆盖率超过 AI Gateway 历史上此前任何一次模型发布的两倍。
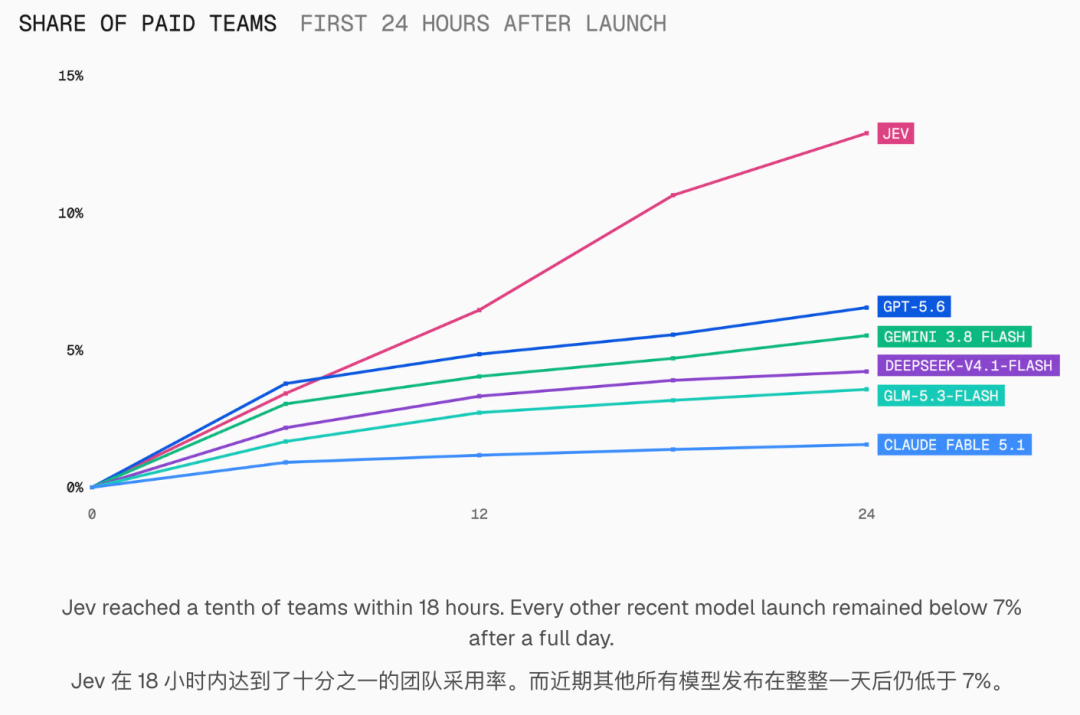
Vercel 还指出,Jev 在前 12 个小时内就超过了所有对比模型,并且在首日持续扩大领先优势。
这很重要,因为 Jev 的使用方式不同于普通聊天机器人的采用方式。
人类可能会尝试一个新聊天机器人几次,然后停止使用。
而嵌入软件中的模型则可以持续接收请求。
这会形成完全不同的使用模式:
人工聊天机器人:
用户打开应用
→ 发送消息
→ 等待
→ 关闭应用

软件中的决策模型:
请求到达
→ 运行决策模型
→ 应用程序进行分支处理
→ 全天重复
原文用一句简单的话概括了这一点:
人会睡觉。代码不会。
原文还引用 TypeSafe 及投资人的说法称,Jev 在发布后三天内处理的 token 数量约达到 一万亿个。
TypeSafe 后来表示,这种流量是持续性的,而不是一次性峰值。
该公司在 A 轮融资公告中还表示,约有 三分之一的《财富》世界 500 强企业正在使用或集成 Jev,并声称客户已经在生产成本方面节省了数百万美元。
这些是 TypeSafe 自己披露的业务指标,并非经过独立审计的数据,但它们有助于解释投资人为何将 Jev 视为不只是一个具有病毒传播力的开发者演示。
这种使用模式显示出机器对机器的需求。
一旦 Jev 被嵌入以下环节:
每当外围软件进入相应分支时,就可以调用它。
这正是 TypeSafe 为 Jev 设计的工作负载。
Jev 的起源故事具有不同寻常的对称性。
TypeSafe 联合创始人兼 CEO Diogo Almeida 此前曾在 Google Brain 和 OpenAI 工作。
TypeSafe 官方团队页面称,他是 RLHF 和 InstructGPT 的共同发明者之一;相关工作推动了 ChatGPT 和 GPT-4 的发展。
在 OpenAI 任职期间,Almeida 参与了帮助原始语言模型遵循指令并与人自然互动的方法研究。
离开 OpenAI 后,他越来越怀疑,聊天是否应该成为软件内部智能的默认接口。
他在 TypeSafe 的 Jev 发布文章中概括了这种转变:如果模型已经非常擅长对话,为什么自动化却没有以同样的速度发展?

聊天机器人针对灵活性进行了优化。
当人类需要阅读输出时,这种灵活性很有价值。
但生产软件通常需要相反的特性:
TypeSafe 的观点是,对于这些任务而言,通用语言生成往往是一种功能过强的抽象。
与其要求前沿模型先写出结构化答案,再对文本进行验证,不如让 Jev 直接完成受约束的决策。
公司的口号体现了这一理念:
构建生产系统,而不是上帝。
这句话的表达方式有意带有挑衅性,但其背后的理念很实际:优化能够可靠运行于生产环境的软件,而不是把每一个 AI 产品都当作通往某个全能模型的步骤。
TypeSafe 将其训练方法称为 面向校准决策的强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)。
公司将其与两种常见方法进行了对比:
| 训练方向 | 主要优化目标 |
|---|---|
| RLHF | 人类更偏好的回复 |
| RLVR | 可验证的推理结果 |
| RLCD | 经过校准的结构化决策 |
对于 Jev 而言,校准是核心。
如果模型给出 0.90,目标是让获得这一置信度的事件,在适当的评估分布中实际正确的比例约为 90%。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
与单独使用未经校准的标签相比,这对于自动化工作流设计更有价值。
应用程序随后可以将模型的不确定性转化为策略:
高置信度
→ 自动处理

中等置信度
→ 询问另一个模型或应用更多规则

低置信度
→ 转交人工处理
这也是决策模型对高调用量系统具有吸引力的原因之一。
它们并不会消除不确定性。
它们让软件更容易使用不确定性。
原文还强调了 Almeida 对公开基准竞争的怀疑态度。
TypeSafe 确实会发布评估结果,但其发布材料投入了不同寻常的篇幅来记录相关限制条件。
例如,公司明确指出:
这是一个有用的区分。
TypeSafe 仍然在积极推广其模型,但并没有声称 Jev 应该在所有场景中取代前沿大语言模型。
其官方文档对不同产品的定位如下:
生成式大语言模型
→ 写作、推理、解释、编码、对话

决策模型
→ 分类、路由、评分、验证、设闸、排序
两者可以在同一个系统中协同工作。
TypeSafe 的领导团队并不只有 Almeida。
官方团队页面列出了:
更广泛的团队成员来自 OpenAI、Google Brain、Meta/FAIR、Stripe、Airbnb、Plaid 和 Docker 等公司。
这些背景有助于解释产品为何如此重视生产环境。
Jev 并不专注于创建新的消费者界面,而更像是在创建一种开发者可以深度埋入基础设施的能力。
Jev 的快速采用还带来了第二个影响。
它对这一品类的快速验证,使主要基础设施和模型公司在几周内开始推出竞争产品。
原文正是在这一变化处结束全文。
Microsoft 宣布推出 Microsoft-Decision-1,这是一款专门用于结构化决策评分的模型。
该模型基于 Qwen3.5-9B,并通过 Microsoft Foundry 以公开预览版形式提供。
它支持以下任务:

当给定固定选项集合时,Microsoft-Decision-1 会返回这些选项经过校准的概率分数。
Microsoft 报告称,该模型在一项涵盖近 15 万个问题、包含 36 个基准的比较中取得最高准确率,并表示在其内部评估中,该模型的速度明显快于 GPT-6 Sol。
这些数据来自 Microsoft 自己的基准测试,因此开发者在将其视为普遍适用的性能排名之前,应先根据自身工作负载进行验证。
OpenAI 也朝着同一方向发展,于 2026 年 10 月 6 日发布了 Decisions API 公测版。
该 API 由 GPT-6 Luna 提供支持,可以接收文本、图像或两者。
它支持三种结构化问题类型:
| 类型 | 结果 |
|---|---|
| 谓词 | 某个条件为真的概率 |
| 选择 | 从所提供选项中选择一项,并返回相应概率 |
| 分数 | 对有序等级进行概率加权后的分数 |

OpenAI 表示,对于相关任务形态,专用 API 的决策返回速度约为通过 Responses API 使用 GPT-6 Luna 的 10 倍。
其公测版定价十分简单:
输入:每 100 万个 token 收费 0.10 美元
输出:不收取输出 token 费用
缓存读取:不收费
缓存写入:不收费
它与 Jev 的关键差异在于架构。
Jev 是 TypeSafe 专门构建的 System One 模型系列。
而 OpenAI 的 Decisions API 则是在 GPT-6 Luna 周围提供一个专用的决策接口。
不过,从应用开发者的角度来看,两者服务于相似的需求:
输入状态
→ 输出受约束的类型化决策
Cloudflare 更早加入了竞争,于 10 月 1 日宣布推出 Clef 和 Clef-flash。
两者都是可在 Workers AI 上使用的决策模型,Cloudflare 还根据 Apache 2.0 许可证开源了模型权重。
它们采用与 Jev 兼容的 API 形式,因此更容易被替换到围绕 System One 风格决策请求构建的工作流中。
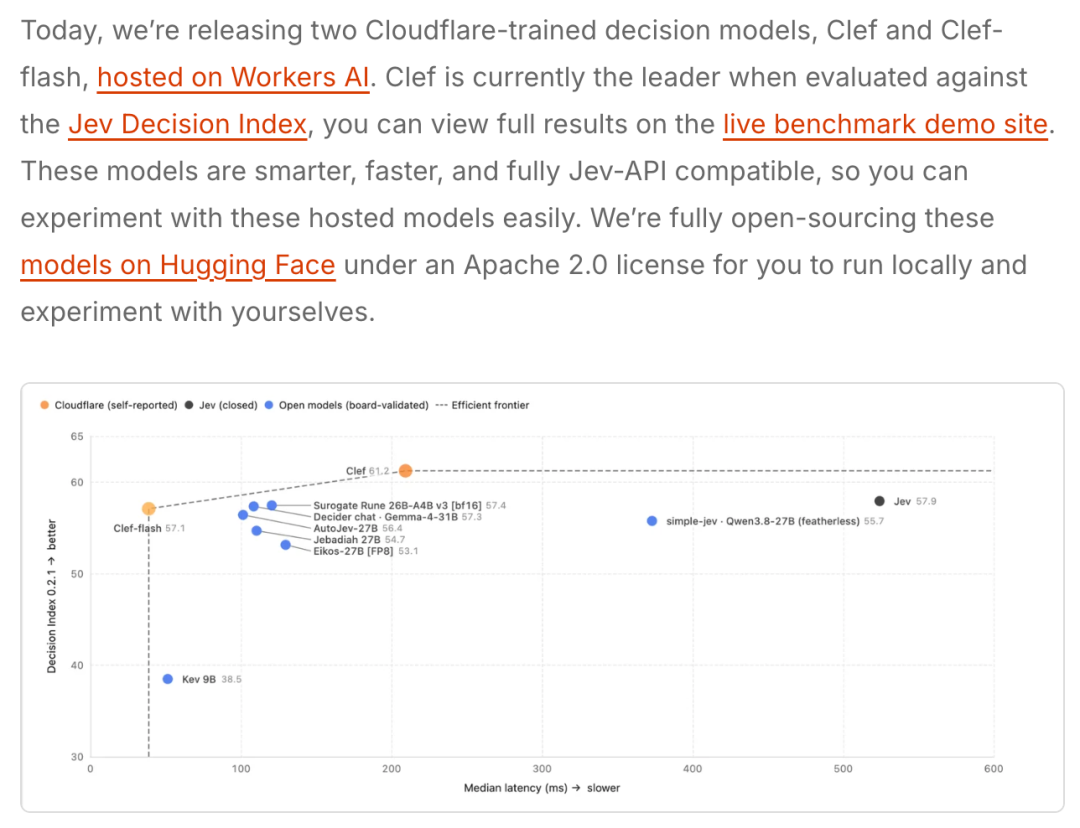
Cloudflare 报告如下:
| 模型 | 规模 | 上下文 | 目标重点 |
|---|---|---|---|
| Clef | 27B | 64K | 更高的决策质量 |
| Clef-flash | 9B | 64K | 极低延迟 |
在 Cloudflare 自己的测试套件中,Clef 或 Clef-flash 在 10 个重点决策基准中的 7 个领先,而 Jev 在 When2Call 和 BRIGHT 等部分单项任务上仍然更强。
Cloudflare 还报告了以下中位延迟:
Clef:       209.3 毫秒
Clef-flash:38.8 毫秒
Jev:        524.1 毫秒
同样,这些数字来自 Cloudflare 的评估环境。
它们可以作为有用的竞争证据,但不能被视为适用于所有部署环境的通用延迟保证。
原文的核心观点并不只是 Jev 获得了一笔巨额融资。
更重要的是,一种模型类别几乎在一瞬间从小众变得拥挤。
短短几周内,市场已经出现:
每种实现方式各不相同,但它们共享一个核心洞察:
并不是每个 AI 请求都需要生成文本。
许多生产任务更接近智能化的 if 语句。
例如:
if fraud_probability > 0.98:
    block()
elif fraud_probability > 0.70:
    review()
else:
    allow()
真正困难的不是编写分支,而是从复杂的现实世界上下文中生成有用且经过校准的概率。
决策模型正试图让这项能力变得足够便宜,从而可以在各处运行。
乍看之下,专用决策模型似乎会对通用大语言模型构成威胁。
但实际上,它们可能会增加 AI 的总使用量。
通用智能体可以在高频控制点使用决策模型:
用户请求
→ 决策模型选择路由
→ 仅在需要时由大语言模型处理复杂推理
→ 决策模型评估输出
→ 工作流继续或升级处理
这让开发者可以将成本更高的推理保留给真正需要它的环节。
其他任务则可以交给更便宜的受约束模型。
最终结果可能是总体 AI 调用次数增加,而不是减少。
这一理念也与 Jev 这一名称相呼应。TypeSafe 表示,该名称指向经济学家 William Stanley Jevons 以及杰文斯悖论:效率提升可能会增加总消费,因为更低的成本会解锁新的使用场景。
在 AI 基础设施中,同样的逻辑可能表现为:
更便宜的决策
→ 更多决策变得经济可行
→ 更多软件获得 AI 控制点
→ 机器智能的总使用量上升
Jev 是 TypeSafe AI 推出的首款 System One 模型,专为快速、结构化决策而设计,而不是用于自由格式文本生成。它接收应用程序状态和类型化问题,并返回带有概率和置信度信息的受约束答案。
TypeSafe 目前列出的 Jev 价格为每 100 万个输入 token 收费 0.042 美元,且不计量输出 token。这一定价适用于 Jev 的结构化决策接口,而不是通用文本生成模型。
TypeSafe 最强的正式主张涉及输出类型安全:受约束的架构可以防止模型输出任意格式错误的内容。但这并不意味着每个语义决策都正确,因此校准、阈值、评估和人工审核仍然十分重要。
Vercel 表示,Jev 在 AI Gateway 发布后的 24 小时内被近 13% 的付费团队使用。Vercel 称其为当时 AI Gateway 历史上采用速度最快的模型。
Decisions API 是 OpenAI 的公测接口,由 GPT-6 Luna 提供支持。它可以接收文本和图像证据,并返回谓词概率、选择或分数。OpenAI 声称,在这些决策任务中,其延迟约比通过 Responses API 使用 GPT-6 Luna 低 10 倍。
Microsoft-Decision-1 是一款可在 Microsoft Foundry 公共预览版中使用的结构化决策模型。它基于 Qwen3.5-9B,面向分类、路由、排序、评分、验证和工作流控制等任务。
Cloudflare 将 Clef 和 Clef-flash 描述为开源或开放权重的决策模型,并根据 Apache 2.0 许可证发布了它们。它们也通过 Workers AI 提供托管服务,并采用与 Jev 兼容的 System One API 风格。
通常不应该。决策模型更适合受约束、高调用量的决策,而通用大语言模型仍然更适合生成、解释、复杂推理和开放式工具调用。许多生产系统会同时使用两者。
TypeSafe AI 获得 8.7 亿美元 A 轮融资之所以重要,是因为它验证的不只是一家初创公司,也验证了一种模型类别:快速、受约束、机器可读的决策系统,能够深度嵌入生产软件。
Jev 在 Vercel 上的快速采用、较低的输入价格、结构化输出以及以校准为重点的设计,解释了开发者为何对此感兴趣。但其最强的性能主张仍然需要结合背景理解:其中一些数据直接来自 TypeSafe,而 Vercel、Cloudflare、Microsoft 和 OpenAI 也分别在不同条件下发布了自己的测量结果。
最重要的市场信号在于竞争者跟进的速度。在短短几周内,Microsoft、OpenAI 和 Cloudflare 都推出了针对同一基本问题的产品。
Jev 最大的成就可能不是某一项基准测试或某一轮融资,而是证明了很大一部分生产级 AI 根本不需要说话。
從一句話開始,幾分鐘內拿到完整網站。



