For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Meta 於 2026 年 10 月 12 日推出 **Muse Wonder** 與 **Muse Wonder Full**。這次發布鎖定個人與專業代理系統:此類系統預期能記住有用的脈絡、克服障礙,並完成不只需要一次回答的專案。
Meta 於 2026 年 10 月 12 日推出 Muse Wonder 與 Muse Wonder Full。這次發布鎖定個人與專業代理系統:此類系統預期能記住有用的脈絡、克服障礙,並完成不只需要一次回答的專案。
官方公告確認,Wonder 可透過 Meta Model API 與 Muse Code 使用,而 Full 則提供給 Muse Code 訂閱者。Meta 也計畫先從訂閱者開始,將 Wonder 導入其 Muse 助理。
模型卡列出 100 萬 Token 的推論脈絡長度,以及涵蓋文字、圖片、影片與音訊的輸入。列出的輸出模態為 文字。因此,多模態理解不應被混同為該模型承諾能自行生成每一種輸入媒介。
Meta 表示,這些模型是在其千兆瓦級 Prometheus 資料中心完成訓練,並伴隨其 AI 技術堆疊的全面重建。訓練基礎設施說明了此次發布的背景,但並不能證明每個應用程式都會有如基準展示般的表現。
提供的報告指出,Wonder Full 在 Artificial Analysis Intelligence Index 獲得 56 分,相較之下,Wonder 為 52 分,Muse Spark 1.3 為 48 分。Artificial Analysis 自身的評估也在最高推理強度下佐證了這些數字。這些數字反映的是報告中的評估快照,而非永久性的排名。
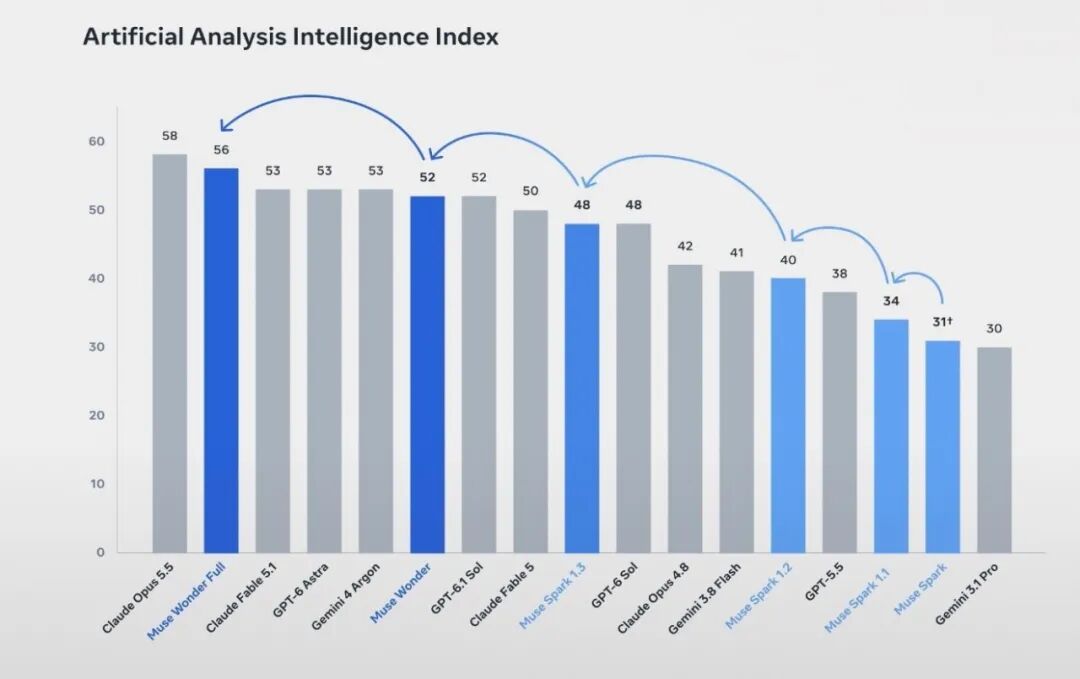
圖表由 BAAI 的新智元報告轉載;該報告將評估歸因於 Artificial Analysis。
就持續性的軟體工作而言,來源報告列出:
| 評估項目 | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57.5% | 53.1% | 46.3% | 42.5% |
| DeepSWE v1.1 | 79.0% | 78.8% | 74.2% | 74.1% |
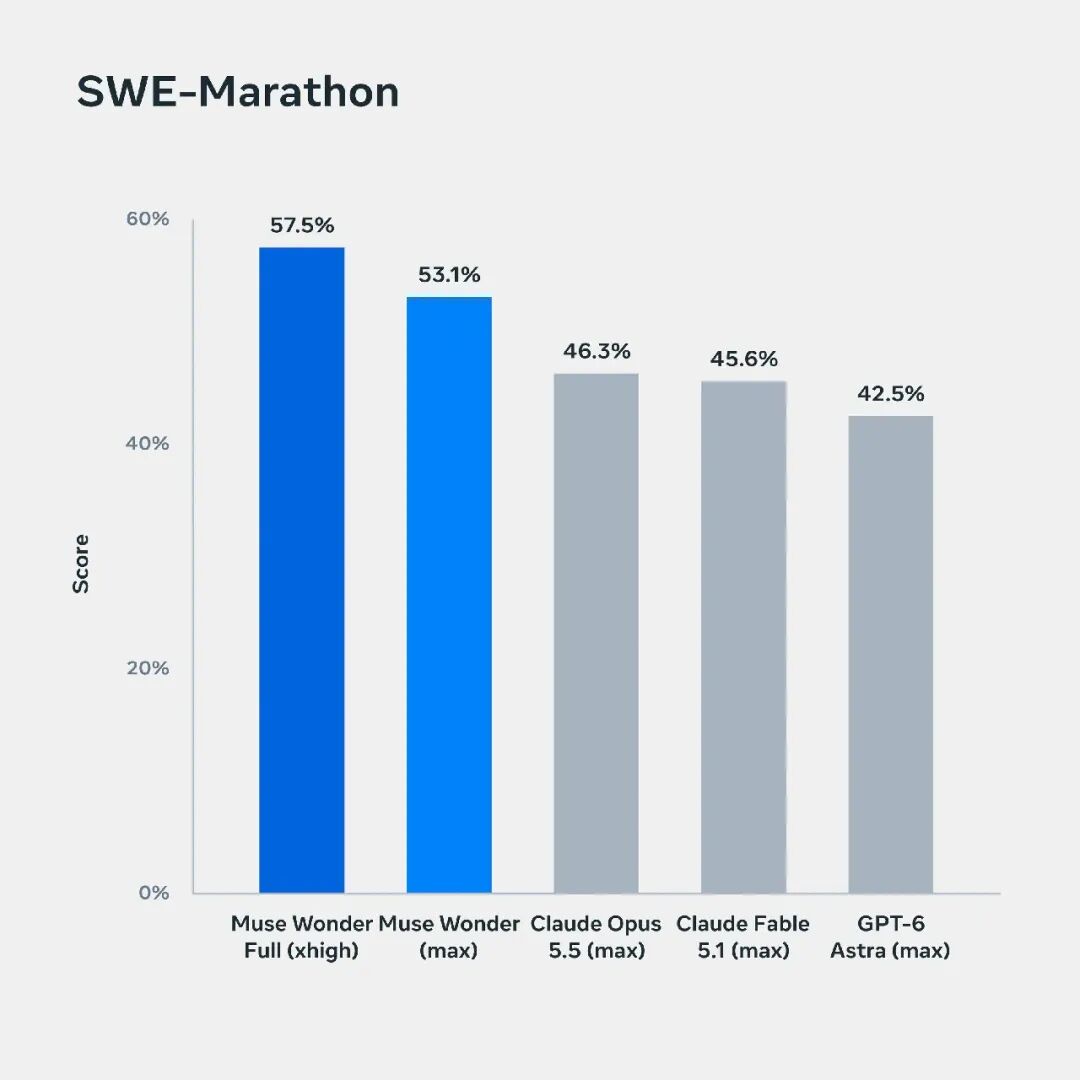
Meta 的基準測試圖表,由來源文章轉載。
模型卡提供了一項重要限定:SWE-Marathon 並非使用同一套通用測試框架進行的受控比較。部分競品結果使用 Codex 或 Claude Code,而 Wonder Full 報告的結果使用 xhigh 推理強度。DeepSWE 也結合了特定第三方與供應商自行報告的結果,因此讀者應查閱各基準測試的方法論。
整體情況較為複雜,而非全面勝出。文章指出,Full 在 ProgramBench 領先 GPT-6 Astra,但落後於 Opus 5.5;在所列的終端機程式設計比較中,則落後於兩者。模型選擇仍取決於實際工作內容、工具環境、預算,以及可接受的失敗率。
Meta 將 Active Memory 用於在對話之間保留重要脈絡,並在需要時擷取相關細節。它將 Active Focus 用於持續工作:嘗試其他方法、因應新資訊調整,並在遇到阻礙時繼續推進。
這些能力解決的是不同問題。記住一項需求,並不會自動確保代理可以完成困難的實作;如果代理遺失了關鍵限制條件,持續執行也無濟於事。
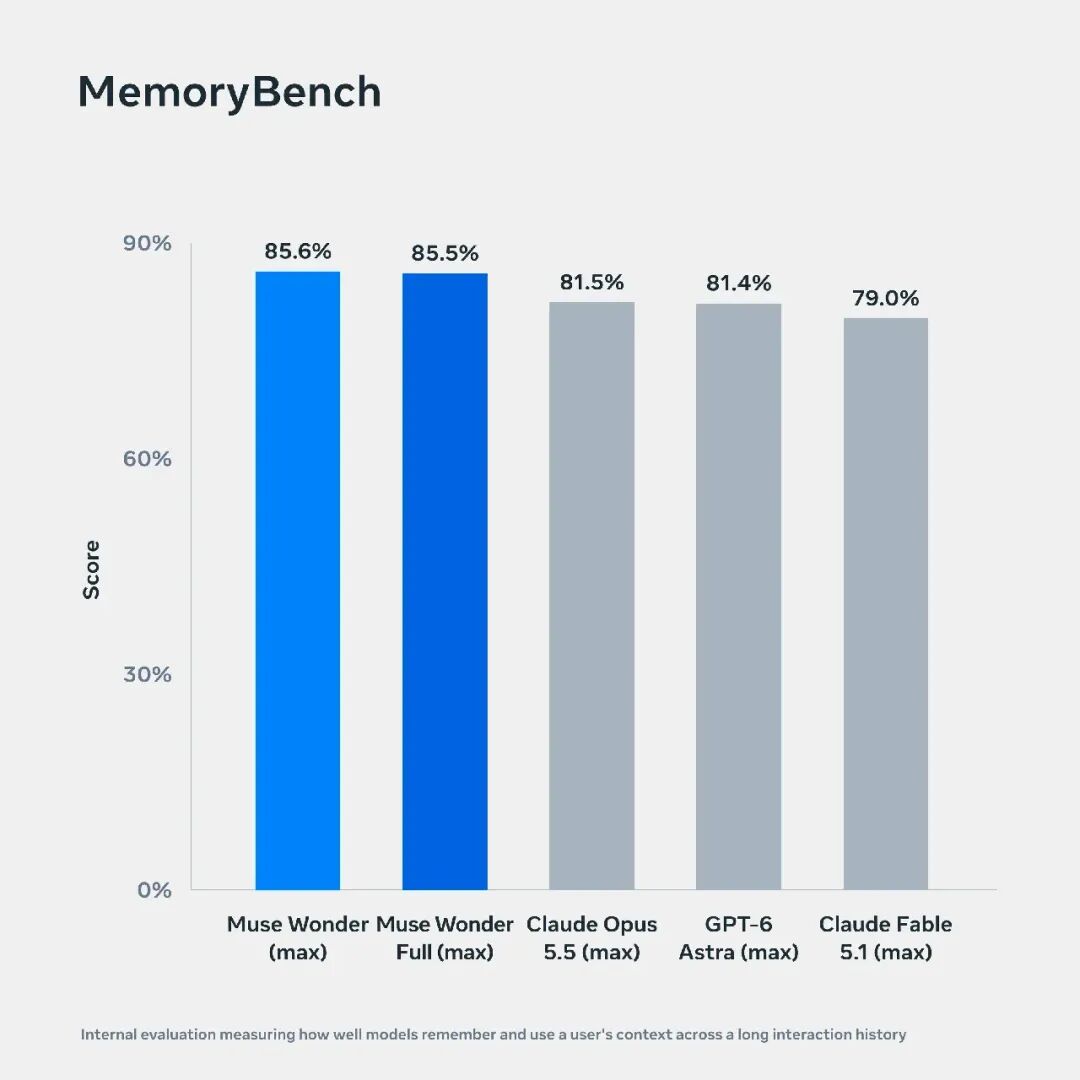
Meta 評估圖表,經由來源報告轉載。
模型卡將 MemoryBench 描述為一項內部評估,使用長度為 64,000 至 100,000 Token 的對話,其中包含分散注意力或彼此衝突的資訊。FocusBench 同樣是內部評估。這些評估有助於說明測試了什麼,但並不保證在已部署服務中能完美回憶,或能不受中斷地自主運作。
Meta 會在程式設計之外,針對涉及法律、金融、健康與專業文件的任務評估這些模型。這些測試針對特定工作產出與評分規則;分數不應被視為專業資格認證。
中文報告也強調了選擇性回答與知道更多之間的差異。該報告指出,Full 的幻覺衡量值較低,但其知識指數低於被比較的 Opus 與 Astra 模型。在該討論中,幻覺百分比以知識測試中回答錯誤或未回答的項目為條件;它並非所有真實世界回答中錯誤回答的百分比。
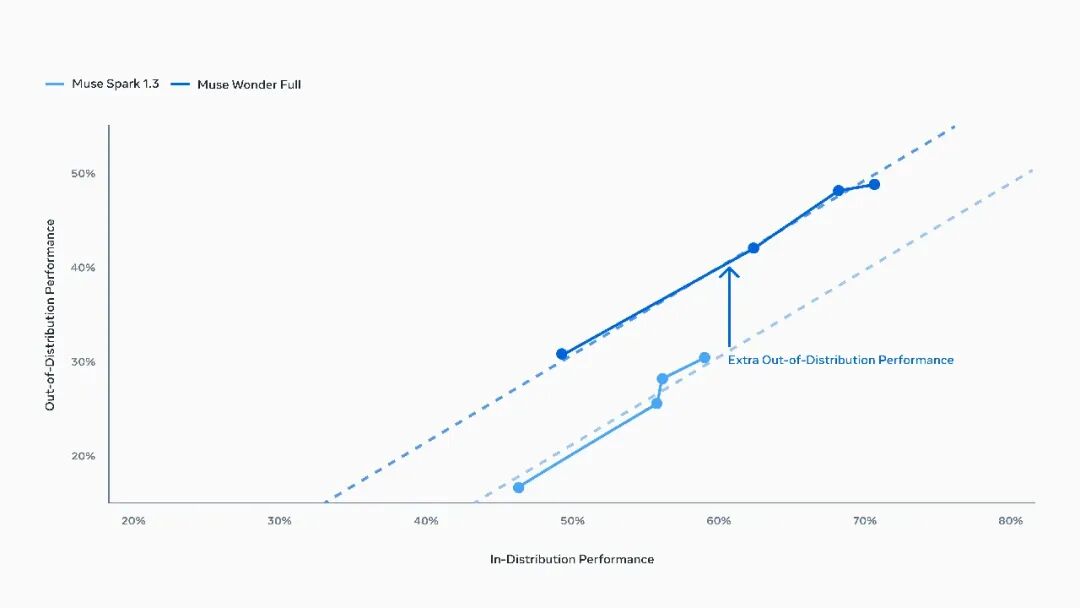
針對不熟悉的任務,Meta 提出證據顯示,在相近的分布內效能下,Full 相較於較早期的 Spark 模型具有更好的泛化能力。這項結論僅適用於測得的評估設定,並非無限制自我改進的證明。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
Meta 的泛化能力圖表,由來源文章轉載。
來源在其報告發布當時列出以下價格:
| 產品 | 報告價格 | 報告中的存取方式 |
|---|---|---|
| Wonder API 輸入 | 每 100 萬 Token 4 美元 | 按用量計費 API |
| Wonder API 輸出 | 每 100 萬 Token 20 美元 | 按用量計費 API |
| Wonder 快取輸入 | 每 100 萬 Token 0.20 美元 | 快取輸入 |
| Full:Power Usage | 每月 50 美元 | Muse Code 訂閱 |
| Full:Maximum Usage | 每月 200 美元 | Muse Code 訂閱 |
該報告稱,兩種 Full 訂閱方案分別提供基準用量的 20 倍與 80 倍。這些倍數不代表無限制用量,且來源並未證實每月可執行任務的通用數量。
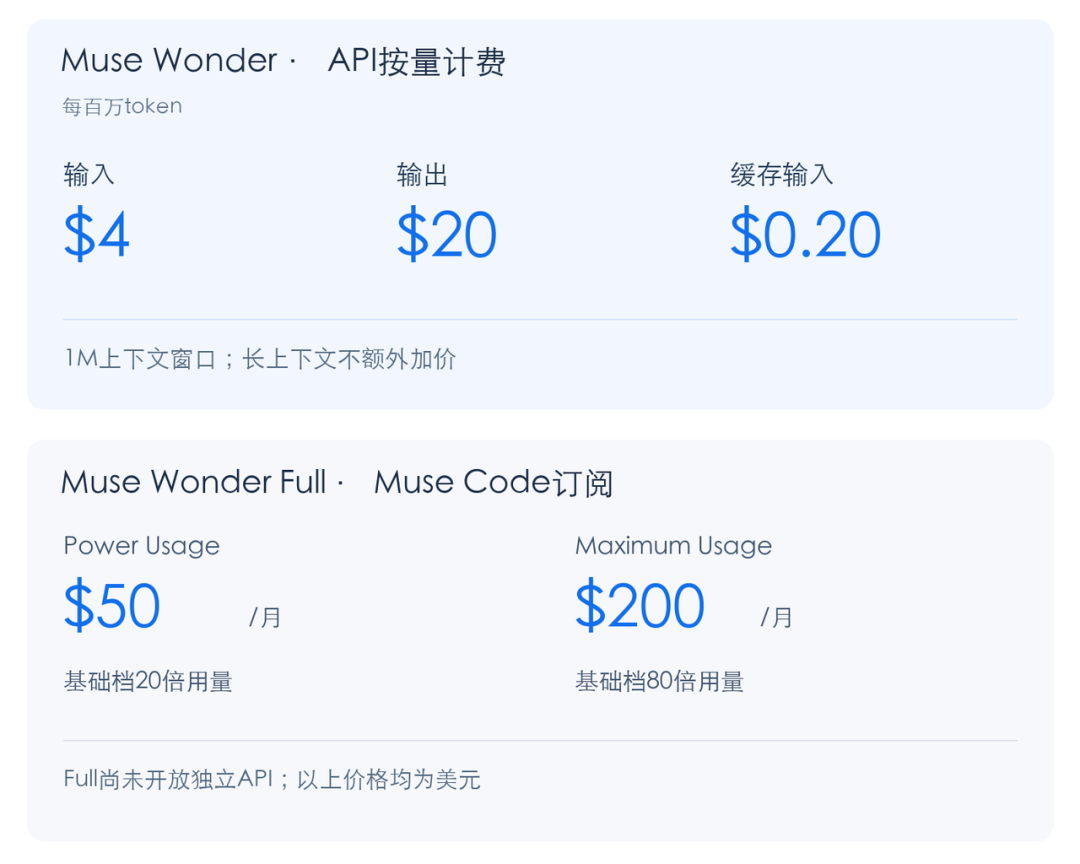
價格圖表歸屬於來源報告;目前無法獨立取得當前計費條款。
在公告發布時,Full 是透過 Muse Code 訂閱提供,而不是經由另行宣布的公開 API。考慮採用任一產品的團隊,應在投入工作負載前,確認自身帳戶的最新存取資格與價格。
Muse Wonder 是 Meta 於 2026 年 10 月 12 日推出的模型,適用於個人與專業代理任務。Meta 描述其在記憶、持續任務執行、程式設計與特定領域工作方面具有優勢。
在許多已報告的評估中,Full 是效能更高的版本。官方公告透過 API 與 Muse Code 提供 Wonder,而 Full 則提供給 Muse Code 訂閱者。
Meta 的模型卡列出推論時為 100 萬 Token。脈絡容量與可靠回憶、輸出限制,以及特定應用程式可提供的可用材料數量是不同概念。
模型卡列出文字、圖片、影片與音訊輸入,並列出文字輸出。因此,多模態輸入支援不應被解讀為原生音訊或影片生成能力。
不是;報告中的分數適用於特定任務、代理設定與推理設定。Meta 明確指出,SWE-Marathon 的結果並未在所有比較系統之間使用受控的通用測試框架。
Active Memory 涉及在對話之間保留並擷取相關脈絡。Active Focus 涉及在任務中克服障礙並進行調整,並在適當情況下提出澄清或確認。
10 月 12 日的公告描述 Full 可供 Muse Code 訂閱者使用。公告並未宣布獨立的公開 Full API,是否可用應以後續官方通知為準。
Muse Wonder 與 Full 透過 100 萬 Token 脈絡、多模態輸入、記憶與持續程式設計能力,擴展了 Meta 的代理產品布局。公告確認了不同的 API 與訂閱存取途徑,而來源報告則指出其相較 Muse Spark 1.3 有顯著改善。
最有價值的比較方式,是同時衡量基準分數與其測試框架、帳戶存取方式,以及完成自身任務的成本。
從一句話開始,幾分鐘內拿到完整網站。



