For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Meta 發布 Muse Wonder 時,出現了兩類截然不同的證據:一類是亮眼的基準測試結果,另一類則是有時說服力明顯較弱的開發者展示。一篇由新智元撰寫、並由 BAAI Hub 轉載的中文報導,將這種落差轉化為對以基準測試為導向的最佳化方式的強烈批評。
Meta 發布 Muse Wonder 時,出現了兩類截然不同的證據:一類是亮眼的基準測試結果,另一類則是有時說服力明顯較弱的開發者展示。一篇由新智元撰寫、並由 BAAI Hub 轉載的中文報導,將這種落差轉化為對以基準測試為導向的最佳化方式的強烈批評。
這項分歧值得審視,但一次表現不佳的展示並不能證明模型作弊。公允的解讀需要確認確切的模型版本、受測任務、模型周邊使用的 Agent 軟體,以及每項結果的來源。
來源文章描述,開發者比較瀏覽器或 3D 遊戲輸出後,認為 Wonder 相較於競爭模型表現令人失望。這些展示很容易檢視:觀眾可以直接觀察移動功能是否正常、鏡頭行為是否合理,以及場景是否接近要求的結果。
來源也引用 Meta 的 Alexandr Wang 表示,團隊並未專門針對 3D 展示遊戲進行訓練,並鼓勵開發者嘗試實際的程式設計工作。這一回應由新智元報導;不應將其延伸為對每一個失敗程式設計任務的籠統解釋。
遊戲展示仍是有關聯性的證據。它們測試了程式碼生成、視覺判斷、互動與除錯的真實組合能力。不過其限制也在於範圍:單一提示詞與單次執行,無法證明模型在程式碼庫維護、終端機工作或長期軟體專案中的整體表現。
Meta 的主要公告介紹 Muse Wonder 與 Muse Wonder Full,將其定位為適用於個人與專業 Agent 的模型。Wonder 可透過 Meta Model API 與 Muse Code 使用;Full 則提供給 Muse Code 訂閱者。
公告將 Active Memory 定義為:在不同對話中保留重要脈絡,並在相關時機檢索這些資訊。Active Focus 則描述模型持續朝目標推進的能力,包括嘗試替代方案、適應新資訊、要求澄清,以及在重要行動前進行檢查。
這些描述有助於理解 Meta 嘗試改善的方向。它們屬於產品與評估主張,並非保證 Agent 能完成所有被指派的任務。
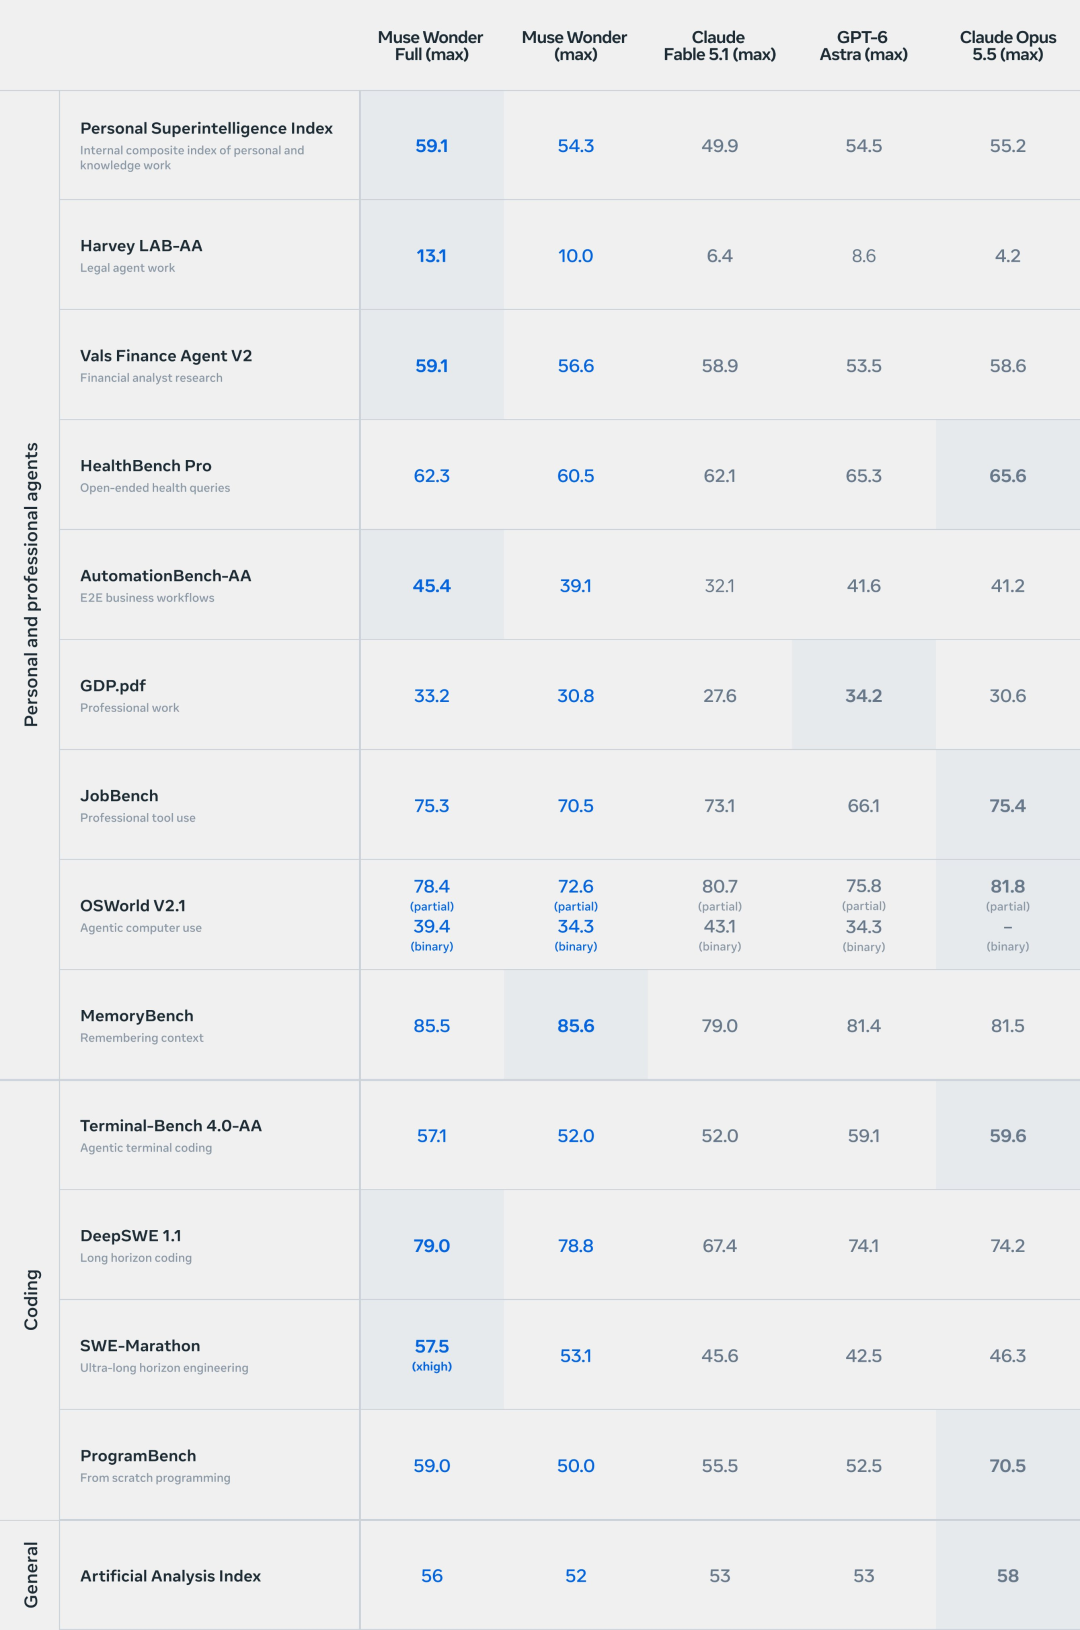
Meta 發布的比較表,由新智元在 BAAI Hub 轉載。數值屬於發布資料中所列的設定與評估條件。
該表並未顯示有一個全面勝出的模型。其程式設計結果會隨任務而有顯著差異:
| 評估項目 | Muse Wonder Full | Claude Opus 5.5 | 比較方向 |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full 分數較高 |
| SWE-Marathon | 57.5 | 46.3 | 在報告設定下 Full 分數較高 |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus 分數較高 |
| ProgramBench | 59.0 | 70.5 | Opus 分數較高 |
Meta 的配套資料也報告了模型在記憶與 Agent 工作流程上的優勢,同時指出其他模型領先的領域。在長時間軟體工作上取得強勁結果,並不代表它在從零開始生成應用程式時也具備最強表現。
評估條件對 SWE-Marathon 尤其重要。Meta 的模型卡指出,競爭模型透過 Codex 與 Claude Code 執行,而 Wonder Full 的重點結果採用 xhigh 設定。這些是具意義的產品層級結果,但並不是讓每個模型都在完全相同 Agent 框架中進行的單一受控實驗。
Meta 的發布部落格明確討論了熟悉的基準測試與陌生任務之間的落差。其分析比較隨著測試時計算量提高時,模型在分布內與分布外任務上的表現,並主張 Wonder Full 更強的基礎模型,可改善後訓練增益向其他任務遷移的效果。
這是支持 Meta 立場的相關技術證據。不過,這仍是模型開發者自行選擇與呈現的評估,無法解決針對某一次開發者輸出的所有質疑。
同樣地,令人失望的遊戲展示報告,並不能證明基準測試資料污染或結果造假。要確立這些主張,需要比來源文章所提供內容更直接的資料、方法或結果遭操控的證據。
來自 Artificial Analysis 的獨立報導指出,在最高推理強度下,Wonder Full 在 Intelligence Index v4.3 的分數為 56,Wonder 則為 52。因此,透過 API 測試一般 Wonder 的使用者,實際上評估的是不同於多張主打圖表中 Full 模型的發布產品。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
Artificial Analysis 列出兩個版本皆具備一百萬 Token 的上下文視窗。對 Wonder,其報導的價格為:每百萬輸入 Token 4 美元、快取輸入 Token 0.20 美元,以及輸出 Token 20 美元。其估算的每個 Intelligence Index 任務 4.52 美元,是特定評估情境下的成本,而不是任何使用者請求的固定價格。
來源文章也批評未公開發布開放權重。經查閱的發布公告與存取說明均未提供可下載的 Wonder 權重,因此開發者不應假設可以在本地自行部署。
Meta 表示,Wonder 在其吉瓦級 Prometheus 資料中心完成訓練。BAAI 文章將此次發布連結到 Mark Zuckerberg 與 Wang 對 AI 基礎設施投資規模及個人 Agent 在商業領域角色的評論。
這些評論描述的是更廣泛的策略,不應被轉化為此特定模型已獲驗證的訓練成本數字。同樣地,Agent 協商或購買服務的案例,是對產品行為的願景,而非每一項此類工作流程都已部署的證據。
下一步更有價值的做法是進行可重複的測試:保持需求一致、識別模型版本與推理設定、記錄環境,並衡量實際完成的工作。這比單一醒目的分數或單次引人注目的失敗,更能可靠地揭露模型的優勢與弱點。
不是。它們可能顯示模型在展示任務上的表現不佳,但要證明基準測試作弊,需要有關評估方法、資料或結果遭操控的獨立證據。
它們是該模型家族中不同的產品,具有不同的發布存取方式。Artificial Analysis 報告指出,在其 Intelligence Index v4.3 中,兩者於最高推理強度下的分數分別為 Wonder 52 分與 Full 56 分。
引用的表格在不同程式設計評估中給出了不同答案。Full 在 DeepSWE 1.1 與報告中的 SWE-Marathon 設定中領先,而 Opus 在 Terminal-Bench 4.0-AA 與 ProgramBench 中領先。
只有在附帶設定說明的情況下才可以。Meta 的模型卡指出,競爭模型使用其各自的程式設計產品,因此除了底層模型外,Agent 行為與工具差異也會影響結果。
Artificial Analysis 的發布報導指出,價格為每百萬輸入 Token 4 美元、每百萬快取輸入 Token 0.20 美元,以及每百萬輸出 Token 20 美元。在投入正式環境使用前,請確認供應商目前的計費條款。
從已查閱的發布資料中,尚未確認有公開權重下載。文件所述的存取方式為:Wonder 可透過 API 與 Muse Code 使用,Full 則可透過 Muse Code 訂閱存取。
Muse Wonder 的發布結果顯示,這是一個在 Agent 與軟體工程評分上表現強勁、但在不同程式設計類別中結果不均,且一般版與 Full 版具有不同存取路徑的模型家族。
有用的結論應以任務為準:在接受任何全面勝利的主張或作弊指控之前,請確認確切模型,並測試實際完成的工作。
從一句話開始,幾分鐘內拿到完整網站。