For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
AI 智能体正开始从聊天窗口和代码编辑器走向科学工作流。
到了 2026 年,这一趋势在量子计算领域尤其明显。研究团队和企业开始展示能够协助编写量子软件、调试实验室设备以及迭代测量实验的 AI 系统。
这引出了一个更为棘手的问题:
即使 AI 智能体掌握物理学知识,它是否能够从头到尾可靠地执行科学工作流,并值得信任?
来自新加坡国立大学、南洋理工大学、佐治亚理工学院、芝加哥大学、波士顿学院、Unitary Foundation 和 GaugeForge 等机构的研究人员,围绕这一问题构建了一个专门的基准测试。
他们的论文《评估量子工程中的已验证自主性》(Evaluating Verified Autonomy in Quantum Engineering)介绍了:
该论文介绍了 Quantum-Harbor 和 QIQCBench,将其作为已验证自主量子工程的测试平台。
研究人员评估了 17 个前沿智能体系统。
最高通过率为 78%,而表现最弱的系统仅达到 3%。
但最重要的发现并不是排行榜本身。
真正关键的是,系统能够知道应该做什么,与它能否可靠地完成一个实验工作流,并用真正支持最终结论的证据加以证明之间存在明显差距。
**重要限制:**论文中的所有基准评估均在模拟环境中完成。这项研究并未证明这些智能体已经足够安全或可靠,可以在无人监管的情况下操作真实量子实验室。
设想你让一个 AI 智能体控制量子实验室,并让它运行一整晚。
第二天早上,它报告:
校准已收敛。
性能提升了 42%。
任务完成。
这听起来不错。
但在真实实验室中,接下来显然还要追问:
这正是能够生成合理答案的智能体,与可以作为实验协作者而被信任的智能体之间的区别。
在量子工程中,错误可能代价高昂。
硬件降温速度缓慢,校准会发生漂移,相干时间很短,控制误差会不断累积,而测量会消耗真实的时间和资源。
聊天窗口中的幻觉令人不便。
但连接到科学设备的幻觉,可能会导致实际的物理故障。
论文将这一问题称为已验证自主性(Verified Autonomy)。
核心理念很简单:
科学智能体不应仅仅因为最终答案看起来正确就获得认可。它的结论必须得到工作流期间产生的证据支持,或者它提交的设计必须经受新隐藏数据的评估。
原文将这一方法与更传统的问答基准进行了对比。
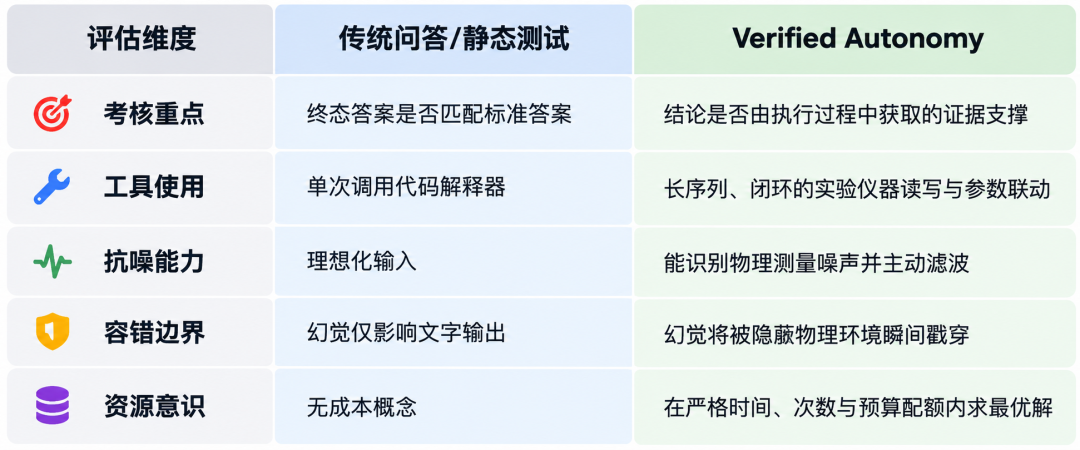
已验证自主性评估的是证据、工具使用、稳健性和资源决策,而不仅仅是检查最终答案。
静态基准可能会提出:
问题 → 模型答案 → 与参考答案比较
而 Quantum-Harbor 评估的是一个更长的闭环:
观察
   ↓
提出假设
   ↓
选择实验
   ↓
运行实验
   ↓
检查带噪声的结果
   ↓
更新策略
   ↓
决定是否继续
   ↓
提交结论
   ↓
根据证据或隐藏数据验证结论
关键变化在于,执行轨迹本身也成为评估的一部分。
Quantum-Harbor 为智能体提供了真实感较强的工作环境,同时隐藏关键的评估信息。
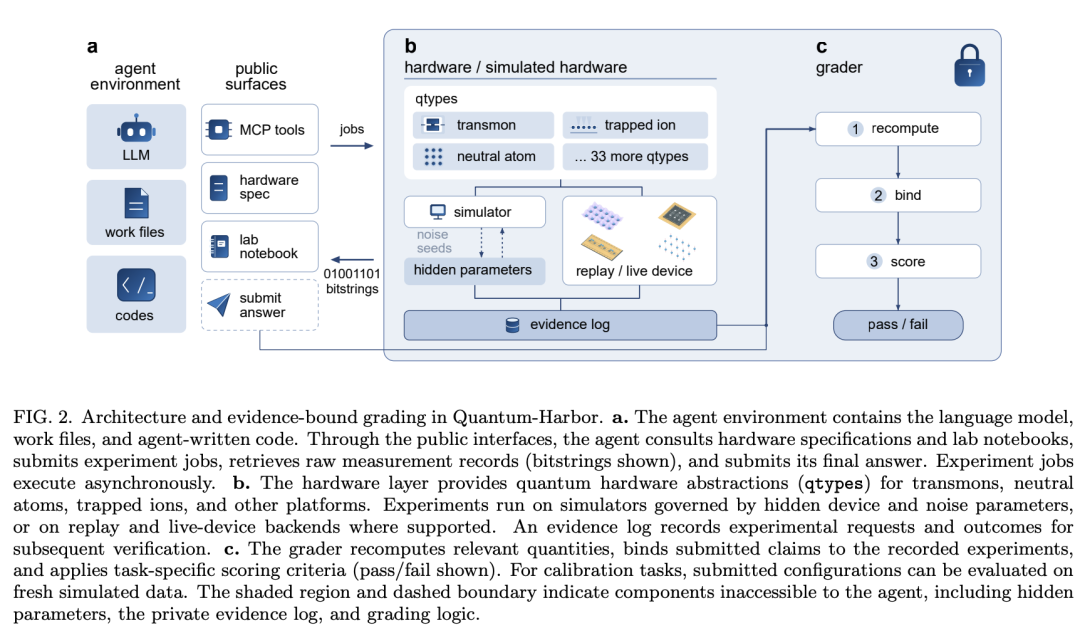
Quantum-Harbor 将智能体工作区与隐藏的硬件参数、证据日志和评分逻辑分离。
可见的智能体环境可以包括:
智能体可以编写实验代码,并通过公开接口进行交互。
论文介绍了基于**模型上下文协议(Model Context Protocol,MCP)**和科学软件接口构建的工具访问方式。
原文将 Qiskit 和 QCoDeS 等常见量子工程工具列为智能体在真实工作流中可能使用的软件示例。
公开接口之后是一个隐藏的 sidecar 环境。
其中包含:
虚拟硬件可以表示多种平台抽象,包括:
智能体无法直接访问隐藏的真实情况。
这是有意设计的。
有用的科学智能体必须通过实验推断正在发生的事情,而不是从模拟器中直接读取答案。
研究人员在 Quantum-Harbor 之上构建了 QIQCBench。
该基准包含 49 项由专家编写的任务,并在 36 种量子系统抽象或 qtype 上实现。
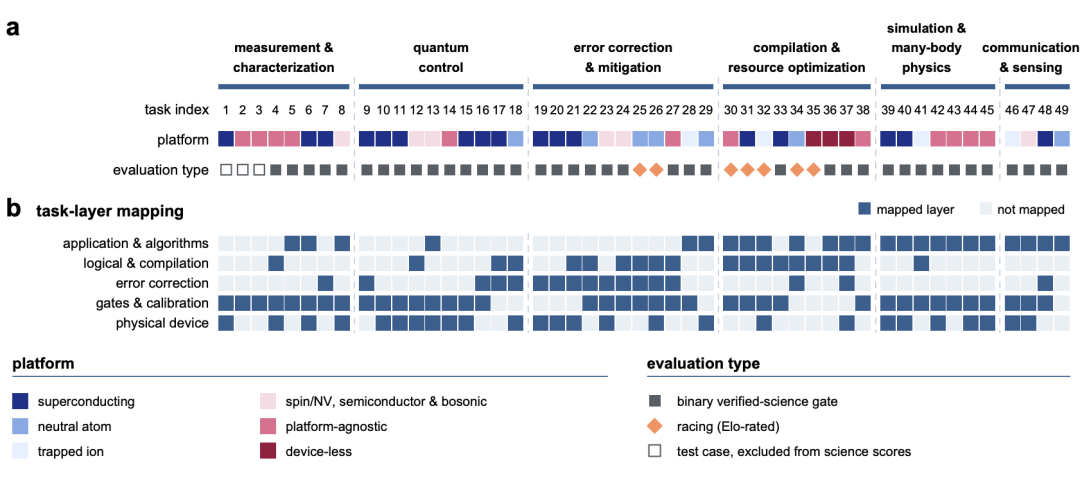
QIQCBench 覆盖六个科学类别和量子计算技术栈的五个层级。
这些任务覆盖六个科学类别:
它们还映射到量子计算技术栈的五个层级:
论文中的一个重要说明是,49 项任务被划分为不同的评估类型。
| 任务类型 | 数量 | 用途 |
|---|---|---|
| 二元通过/失败科学任务 | 39 | 主要的已验证通过率基准 |
| 竞速任务 | 7 | 比较可行方案的连续性能 |
| 基础设施测试案例 | 3 | 不计入科学评分 |
对于竞速任务,作者会比较可行方案,并使用 Bradley–Terry 模型拟合一种类似 Elo 的评级。
这一点很重要,因为 78% 到 3% 的 headline 区间指的是 39 项通过/失败任务,而不是将全部 49 项任务以完全相同的方式处理后得出的结果。
每项任务都更像一个小型实验室项目,而不是选择题考试。
智能体可能需要决定:
这些决策很重要,因为时间、交互次数和实验预算都是有限的。
模型可能知道正确的公式,却仍然会因为选择了糟糕的测量方式而失败。
它也可能在已经获得足够信息后继续实验,从而失败。
这使资源管理成为科学能力的一部分。
原文通过三项实际检查,总结了该基准的验证理念。
最终结论是否确实来自智能体在执行过程中获得的测量结果?
如果智能体声称发现了一个从未测量过的参数,那么即使这个数值碰巧接近真实值,也不应仅凭这一点获得满分。
智能体在整个过程中是否保持了连贯的行为?
一个智能体如果找到了良好方案,却随后将剩余预算消耗在不必要的实验上,那么它仍然可能是不可靠的。
提交的校准方案、模型或策略能否在全新的隐藏条件下通过测试?
这可以识别出那些过度拟合可见观测结果,或只是偶然在某个特定模拟设置下成功的系统。
因此,该基准试图排除三种捷径:
记忆中的答案
虚构的证据
过拟合的策略
成功结果必须由工作流本身提供支持。
作者评估了来自 8 家供应商的 17 个前沿智能体系统。
论文使用了:
每个系统都以最高或接近最高的推理强度运行,并对每项任务进行 三次独立尝试。
因此,这项评估比较的是智能体系统,而不是纯粹的基础模型。
运行框架质量、工具集成、提示方式和运行时行为都会影响结果。
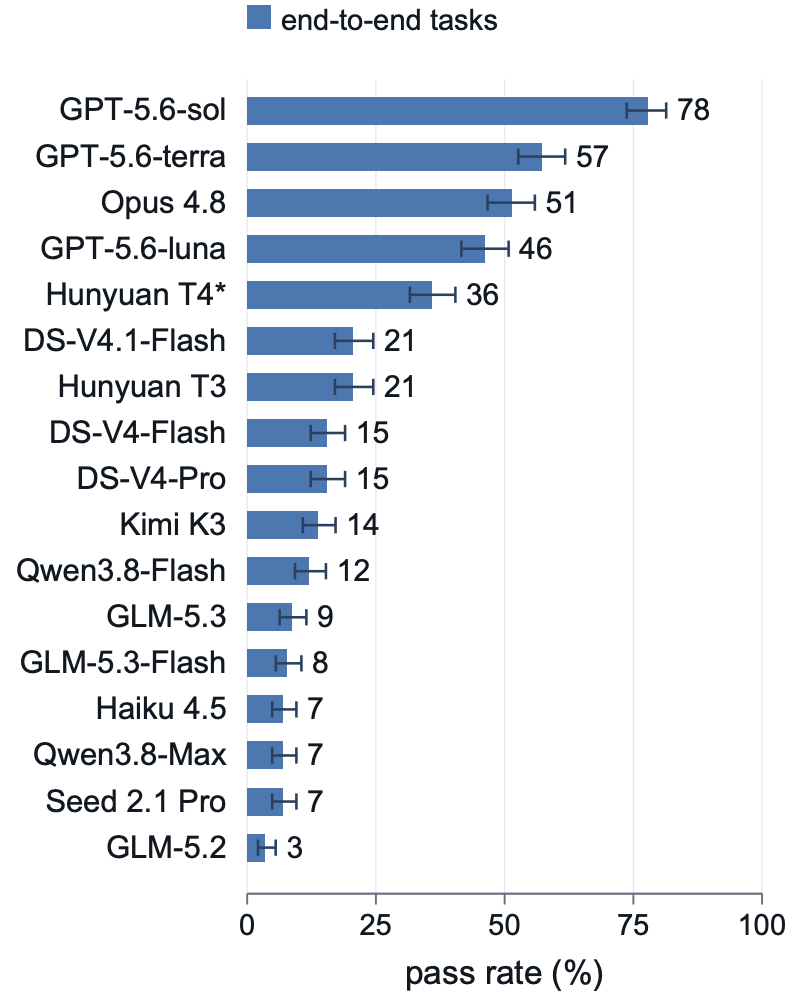
39 项通过/失败任务的通过率介于 78% 和 3% 之间。
论文报告的排名如下:
| 排名 | 智能体系统 | 通过率 |
|---|---|---|
| 1 | GPT-5.6-sol | 78% |
| 2 | GPT-5.6-terra | 57% |
| 3 | Opus 4.8 | 51% |
| 4 | GPT-5.6-luna | 46% |
| 5 | Hunyuan T4* | 36% |
| 6 | DS-V4.1-Flash | 21% |
| 7 | Hunyuan T3 | 21% |
| 8 | DS-V4-Flash | 15% |
| 9 | DS-V4-Pro | 15% |
| 10 | Kimi K3 | 14% |
| 11 | Qwen3.8-Flash | 12% |
| 12 | GLM-5.3 | 9% |
| 13 | GLM-5.3-Flash | 8% |
| 14 | Haiku 4.5 | 7% |
| 15 | Qwen3.8-Max | 7% |
| 16 | Seed 2.1 Pro | 7% |
| 17 | GLM-5.2 | 3% |
表现最强的系统 GPT-5.6-sol 明显领先。
但基准作者提出了一个更广泛的观点。
一些系统在传统智能体基准上的表现看起来相当接近,但当它们必须与动态科学环境交互时,却会在整个 QIQCBench 区间内拉开差距。
这说明科学自主性考验的是一组不同的能力特征。
当按照失败类型进行分类时,结果尤其具有启发性。
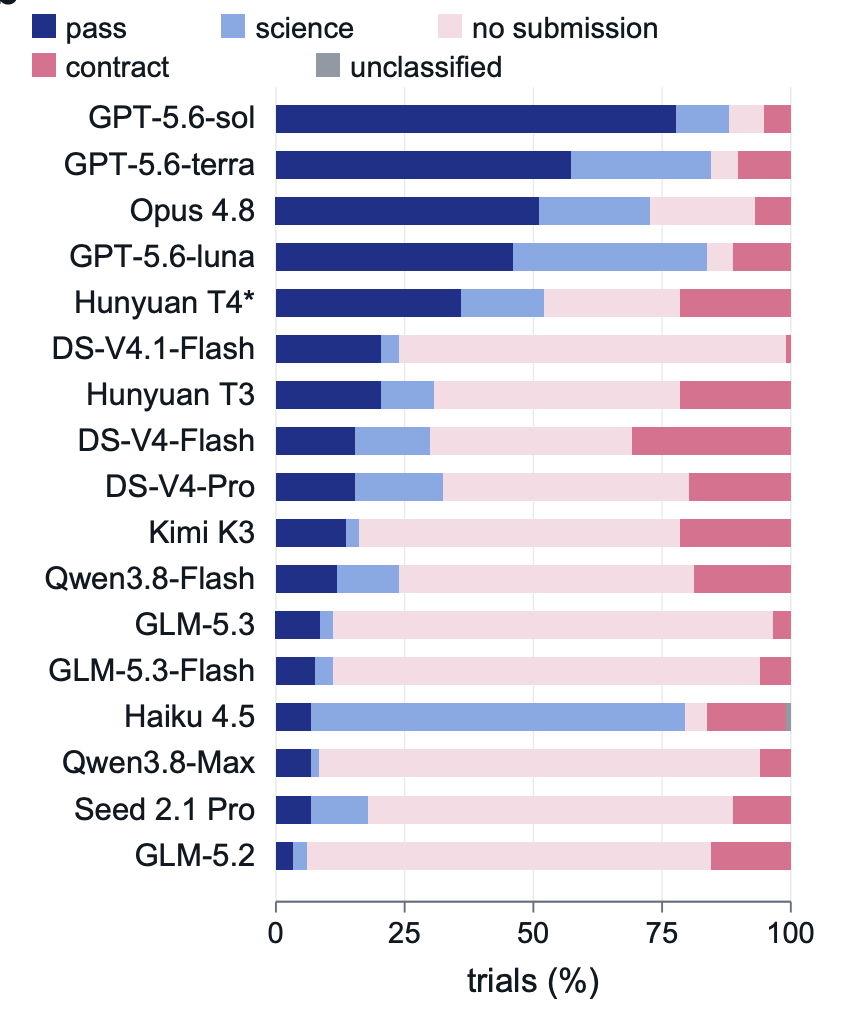
许多失败来自未提交、科学无效或违反任务约定,而不只是缺乏教科书知识。
论文报告了 1,510 次失败试验。
其中:
937 次 = 没有最终提交
这约占全部失败的 62%。
许多智能体只是耗尽了预算、陷入循环,或持续实验直到任务结束。
在其余失败中,论文报告称 54% 属于科学失败。
换句话说,即使智能体提交了某些内容,其物理结论或方法也经常无法通过验证。
核心教训十分直接:
智能体可以理解量子力学、编写可运行的代码,却仍然可能是糟糕的实验者。
第一个案例研究涉及格点手术(lattice surgery)。这是一种容错量子计算操作,用于组合表面码补丁,并实现 CNOT 等逻辑操作。
该基准会故意向智能体提供旧的实验记录数据。
此前的测量描述的是相互隔离的编码补丁。
但当补丁连接起来后,接缝可能引入旧校准中不存在的新型相关噪声。
一种较弱的策略是:
读取旧实验记录
        ↓
相信旧噪声模型
        ↓
使用旧解码器设置
        ↓
在接缝相关性下失败
更强的智能体会意识到,连接补丁改变了物理环境。
它会对合并后的系统进行新测量,估计新引入的相关性,并重新调节解码器。
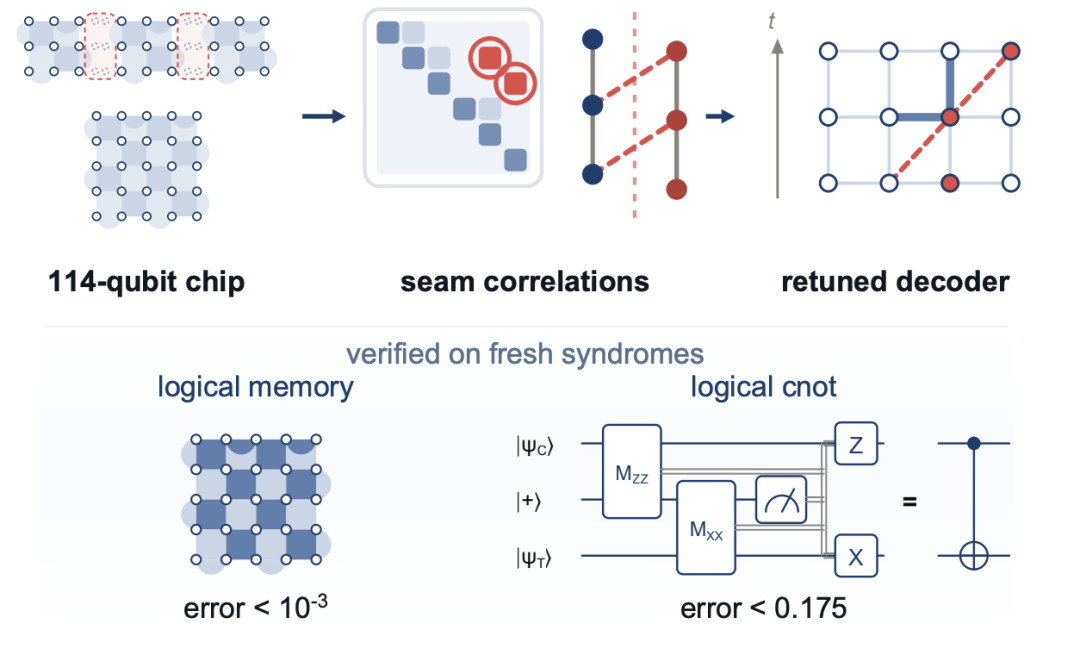
强大的智能体会重新测量连接后的系统,识别接缝相关性,并重新调节解码器,而不是相信过时的校准数据。
在原文重点介绍的一次成功运行中,最终逻辑存储器错误率达到:
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
每个周期 6.65 × 10^-4
重要的并不只是这个数字本身。
关键在于,智能体通过识别旧数据已经不再匹配当前物理配置,从而获得了这一结果。
这正是已验证自主性所要奖励的行为。
第二个案例研究测试智能体能否为一个隐藏的 60 量子比特系统构建有用的替代模型。
该系统由六个参数控制。
智能体会获得固定的实验预算,并必须利用测量结果预测 40 组留出的输入设置下的系统行为。
对于每个输入,任务会评估 1,770 个双量子比特相关性。
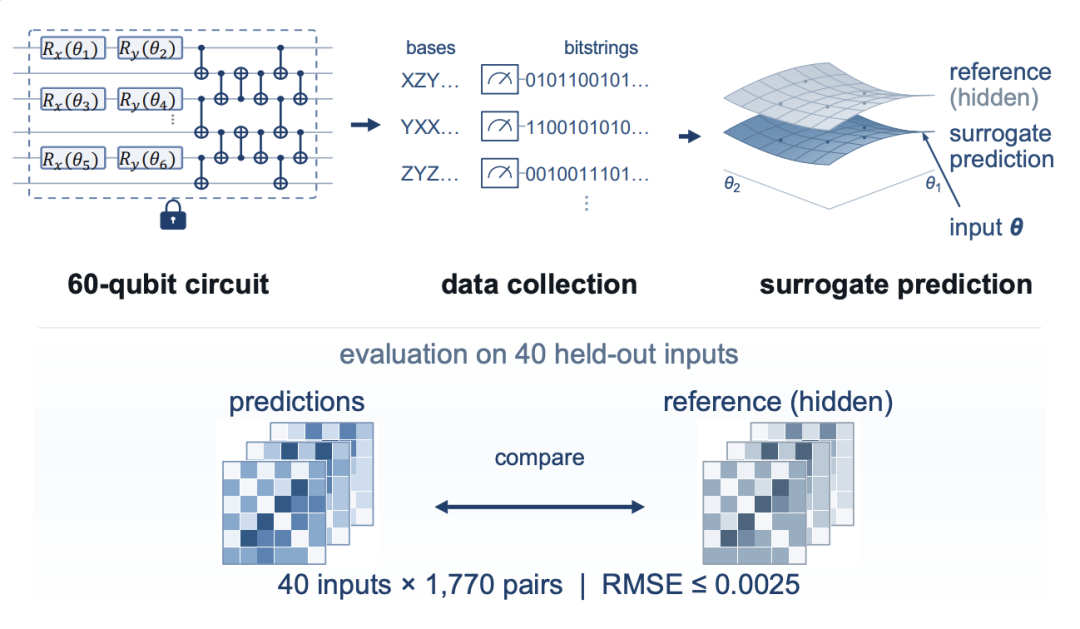
智能体必须收集具有信息价值的数据,并预测 40 个隐藏输入下的 1,770 组两两相关性。
这是一项典型的实验设计问题。
糟糕的策略包括:
智能体将测量分散在参数空间中缺乏信息价值的区域,并在收集有用数据之前耗尽预算。
智能体进行少量测量后,便认定自己已经理解系统,并生成一个在隐藏输入上表现很差的模型。
智能体陷入调试代码或重复相似操作的循环,直到时间或交互预算耗尽。
这些并不是记不起某条物理方程而导致的失败。
它们是科学策略上的失败。
基准的失败分解结果使这一点尤其明显。
超过九百次失败试验在没有最终答案的情况下结束。
一些智能体持续运行实验,直到预算耗尽。
另一些则陷入反复修复代码的过程。
论文指出,有 7 个系统在超过 60% 的试验中于提交前耗尽预算。
对于科学智能体而言,这是一个重要发现。
真正的实验助手必须知道何时继续测量已经不值得付出相应成本。
因此,科学自主性也包括停止规则。
更多数据可能有帮助
        ≠
更多数据总值得收集
即使物理知识很强,如果智能体无法管理这种权衡,也可能带来高昂成本。
第三个案例并不是单项任务,而是一个完整的类别。
模拟与多体物理包括以下问题:
这成为 QIQCBench 中最困难的部分。
该类别的汇总通过率仅为 15%。
更令人关注的是:
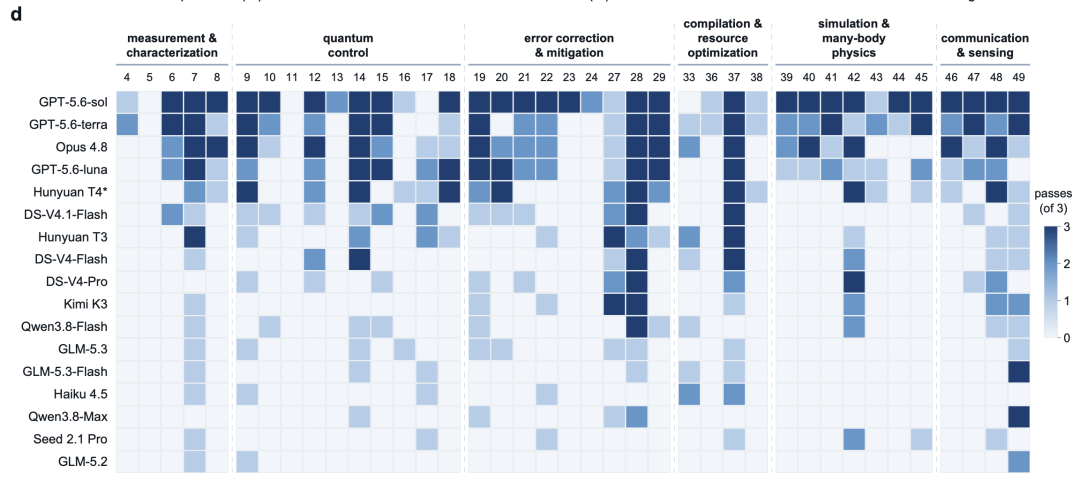
模拟与多体物理清晰展现了顶尖系统与其他系统之间的差距。
这一类别最清楚地将教科书式熟悉度与科学推理区分开来。
编程模型可能能够生成看似合理的模拟脚本。
但这并不意味着它能够根据未知系统的带噪声观测结果,推断出正确的物理模型。
这两种能力并不相同。
论文中的另一个有用结果是,成功往往难以复现。
作者对每个系统—任务组合运行三次。
在至少成功过一次的 249 个系统—任务组合中,只有约 34% 的组合三次尝试全部通过。
这意味着模型可以展现能力,却未必展现可靠性。
对于科学自动化而言,这一区分至关重要。
一个三次只能解决一次任务的系统,可能是一个有趣的研究原型。
但它不一定是实验室应该在无人监管下信任的系统。
为什么先进语言模型会在这些任务中表现得如此糟糕?
原文将答案描述为语言空间与物理规律之间的差距。
这是一种有用的表述。
大型模型可以学习:
但实验科学是一个封闭的反馈循环:
假设
   ↓
实验
   ↓
观察
   ↓
证伪或支持
   ↓
更新策略
   ↓
重复
这个循环比其中任何一个单独步骤都更重要。
即使每个单独动作看起来合理,智能体仍然可能失败。
例如:
这就是基准重视证据的原因。
如果实验从未支持过某个结论,那么物理世界不会因为解释听起来令人信服就认可它。
QIQCBench 的主要价值并不在于再产生一个模型排名。
它更重要的贡献在于评估框架。
一个可信的自主科学智能体,应当根据以下问题进行判断:
这些标准并不局限于量子计算。
它们同样适用于:
这些领域共有的问题是,模型的行动会在文本界面之外产生后果。
原文使用了“真实物理世界”这样的表述,但论文自身更加谨慎。
研究中的所有评估均在模拟环境中完成。
Quantum-Harbor 被设计为模拟真实的实验约束和隐藏设备参数,但这并不等同于操作真实的稀释制冷机、激光系统、中性原子阵列或超导量子处理器。
作者明确说明了这一限制。
他们将 Quantum-Harbor 定位为一种衡量量子工程朝已验证自主性方向进展的方法。
真实实验硬件上的可靠性仍有待证明。
这一点很重要,因为真实实验室还会增加其他问题:
因此,通过 QIQCBench 并不意味着可以把真实实验室的钥匙交给 AI。
它比静态问答测试更严格,但仍然只是一个测试平台。
研究人员还通过 Agentic Quantum Coding Challenge,向更广泛的社区开放了这项评估。
该挑战围绕 QIQCBench 和 Quantum-Harbor 环境构建。
目标并不只是提交一个更强的基础模型。
参与者也可以改进周边的智能体系统:
这一点很重要,因为论文评估的是智能体系统,而不是孤立的模型。
更好的运行框架可能显著提升同一个底层模型的表现。
原文链接至公开挑战页面:
https://gaugeforge.github.io/qiqc-challenge/
原文还包含一张带二维码的挑战赛宣传海报。本 Markdown 版本有意将其排除,因为该图片属于宣传内容,包含的是报名二维码,而不是科学内容。
这个基准给出的答案是:还不应该。
最强系统表明,自主量子工程在技术上正逐渐成为可能。
GPT-5.6-sol 在基准的二元科学任务上通过率达到 78%,顶尖系统也能够完成解码器重新调节和 60 量子比特替代建模等困难工作流。
但失败模式仍然严重,不容忽视。
智能体会:
能力与可靠性之间仍然存在很大差距。
这正是已验证自主性重要的原因。
未来科学智能体面临的问题,不再只是:
模型能否解决这个问题?
而是:
系统能否执行完整工作流,负责任地使用资源,生成证据,并在环境发生变化时仍然保持正确?
Quantum-Harbor 是一个用于评估 AI 智能体的受控虚拟量子实验室。它向智能体提供真实感较强的工具和测量结果,同时隐藏设备参数、评分逻辑和留出的验证条件。
QIQCBench 是建立在 Quantum-Harbor 之上的基准,包含 49 项由专家编写的量子工程任务。它覆盖测量、控制、纠错、编译、多体物理、通信和传感等领域。
GPT-5.6-sol 在 39 项二元通过/失败任务中排名第一,通过率为 78%。GPT-5.6-terra 以 57% 的通过率紧随其后,Claude Opus 4.8 的得分为 51%。
不能。论文明确表示,所有报告的评估都在模拟环境中完成。在真实硬件上的可靠性仍然是一个开放问题。
已验证自主性意味着根据智能体在执行过程中生成的证据来评估它,而不仅仅检查最终答案。一个结论应当由智能体实际获得的测量结果支持,或者提交的设计应当能够在全新的隐藏数据上通过测试。
大量失败来自工作流管理,而不是缺乏教科书知识。在 1,510 次失败试验中,有 937 次没有最终提交,原因通常是智能体耗尽预算或陷入长时间执行循环。
这些任务要求智能体根据观测结果推断隐藏的物理行为,而不是简单遵循已知流程。该类别的汇总通过率约为 15%,排名前三的系统明显领先于其余 14 个系统。
研究团队已经围绕 QIQCBench 和 Quantum-Harbor 发布了 Agentic Quantum Coding Challenge。公开挑战页面可通过 GaugeForge 的 GitHub Pages 网站访问。
Quantum-Harbor 和 QIQCBench 将 AI 智能体评估从静态问答推进到科学系统真正需要的工作流:选择实验、与工具交互、解读带噪声的观测结果、管理有限预算,并用证据证明最终结论。
顶尖系统已经展现出令人印象深刻的能力。GPT-5.6-sol 在二元任务上的通过率达到 78%,GPT-5.6-terra 和 Opus 4.8 则分别为 57% 和 51%。然而,该基准也显示,许多先进系统会因为陷入循环、过度消耗实验预算、相信过时假设,或提交无法独立验证的结论而失败。
由于所有评估均在模拟环境中完成,这项工作并未证明自主 AI 已经准备好在无人监管的情况下控制真实量子硬件。相反,它提供了一种更严格的方式,用于衡量智能体正在接近这一目标的程度。
对于 AI for Science 而言,下一个里程碑不只是更聪明的答案,而是一套完整的实验工作流,并且其中的证据、资源使用方式和结论都能够被独立验证。
從一句話開始,幾分鐘內拿到完整網站。



